

Разшифроване на доклада от 2020 г. на Брус Момжиан "Отваряне на мениджъра на заключвания в Postgres".
(Забележка: Всички SQL запитвания от слайдов можете да получите на този линк: )
Здравейте! Прекрасно е отново да бъда тук в Русия. Извинявайте, че не можах да дойда миналата година, но тази година Иван и аз имаме големи планове. Надявам се да съм тук много по-често. Обожавам да посетя Русия. Ще посетя Тюмен и Твер. Наистина се радвам, че ще имам възможност да бъда в тези градове.
Казвам се Брус Момжиан. Работя в EnterpriseDB и се занимавам с Postgres повече от 23 години. Живея в Филаделфия, САЩ. Пътувам около 90 дни в годината и посещавам около 40 конференции. Моят , който съдържа слайдовете, които ще ви покажа сега. След конференцията можете да ги изтеглите от личния ми сайт. Там също така има около 30 презентации. Освен това има видео и много записи в блога, над 500. Това е доста съдържателен ресурс. И ако ви интересува този материал, ви приканвам да се възползвате от него.
Преди бях преподавател, професор, преди да започна работа с Postgres. И много се радвам, че мога сега да ви разкажа онова, което съм подготвил. Това е една от най-интересните ми презентации. И тази презентация съдържа 110 слайда. Ще започнем с прости неща, а към края докладът ще стане все по-сложен и по-сложен.
Това е доста неприятен разговор. Заключването не е най-популярната тема. Искаме да изчезне. Това е като да ходиш на зъболекар.
- Заключването е проблем за много хора, които работят с бази данни и имат множество процеси, работещи едновременно. Те се нуждаят от заключване. Т.е. днес ще ви дам основни знания за заключването.
- Идентификационни номера на транзакциите. Това е доста скучна част от презентацията, но е необходимо да я разберете.
- Следващото ще говорим за типовете заключване. Това е достатъчно механична част.
- И после ще дадем някои примери за заключвания. И това ще бъде доста сложно за възприемане.
Нека говорим за заключванията.
Терминология у нас е доста сложна. Колко от вас знаят откъде е този откъс? Двама души. Това е от игра, която се нарича „Колосално приключение в пещерата“. Беше текстова компютърна игра от 80-те години, мисля. Трябваше да влезеш в пещера, в лабиринт и текстът се променяше, но съдържанието беше приблизително същото всеки път. Така помня тази игра.
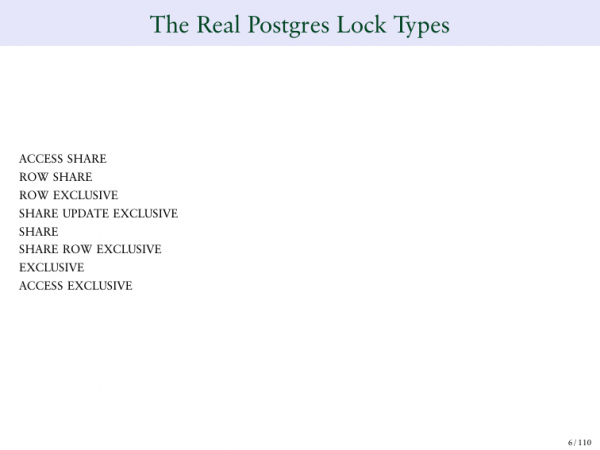
И тук виждаме наименования на блокировки, които дойдоха при нас от Oracle. Използваме ги.
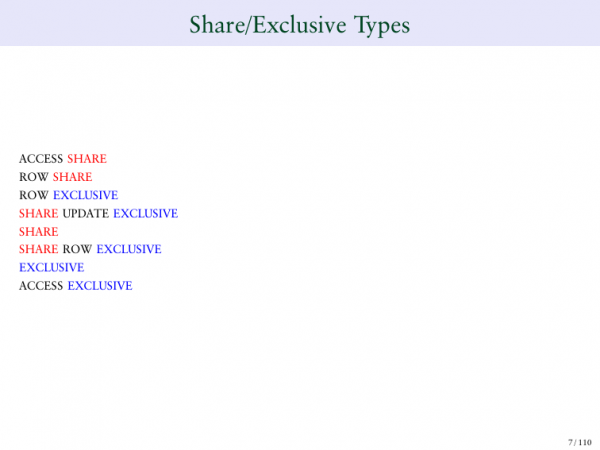
Тук виждаме термини, които ми създават съмнения. Например, SHARE UPDATE EXCLUSIVE. После SHARE RAW EXCLUSIVE. Честно казано, тези наименования не са много ясни. Ще се опитаме да ги разгледаме по-подробно. Някои съдържат думата „share“, което означава – отделям. Някои съдържат думата „exclusive“ — ексклузивен. В някои са дуите две думи. Искам да започна с това как работят тези блокировки.
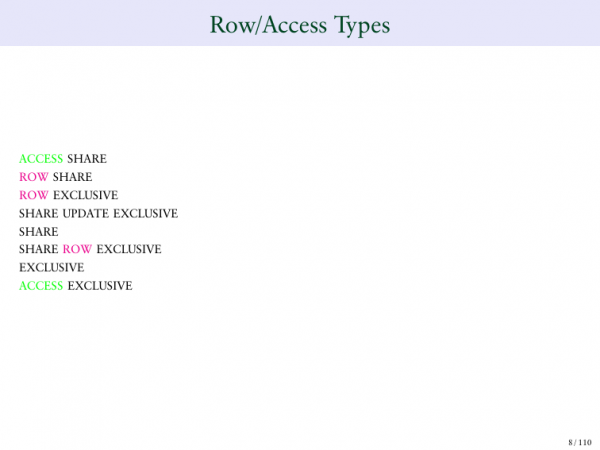
И също е много важно словото „достъп“ — access. И думата „row“ — ред. Т. е. разпределение на достъпа, разпределение на редовете.
Още един проблем, който трябва да разберем в Postgres, за съжаление не мога да говоря за него в моето представяне, това е MVCC. Имам отделна презентация по тази тема на моя уебсайт. И ако смятате, че тази презентация е сложна, то MVCC е, вероятно, най-сложната. И ако ви интересува, можете да я видите на сайта. Можете да гледате видеото.
Още един момент, който трябва да разберем – това са идентификаторите на транзакции. Много транзакции не могат да работят без уникални идентификатори. И тук имаме обяснение какво е транзакция. В Postgres има две системи за нумерация на транзакции. Знам, че това не е много красиво решение.
Също имайте предвид, че слайдовете ще бъдат доста сложни за възприемане, затова на това, което е подчертано с червен цвят, именно на него трябва да обърнете внимание.
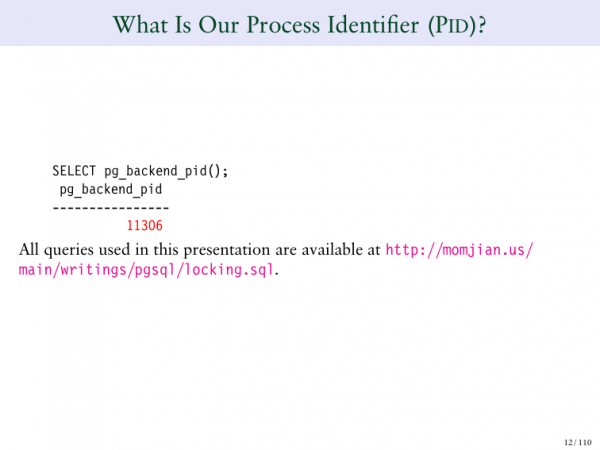
Гледаме. С червен цвят е подчертат номерът на транзакцията. Тук е показана функцията SELECT pg_back. Тя връща моята транзакция и ID на тази транзакция.
Още един момент, ако ви харесва тази презентация и искате да я стартирате в вашата база данни, можете да преминете по тази розова връзка и да изтеглите SQL за тази презентация. Можете просто да я стартирате в вашия PSQL и цялата презентация веднага ще се появи на екрана ви. Тя няма да съдържа цветове, но поне ще можем да я видим.
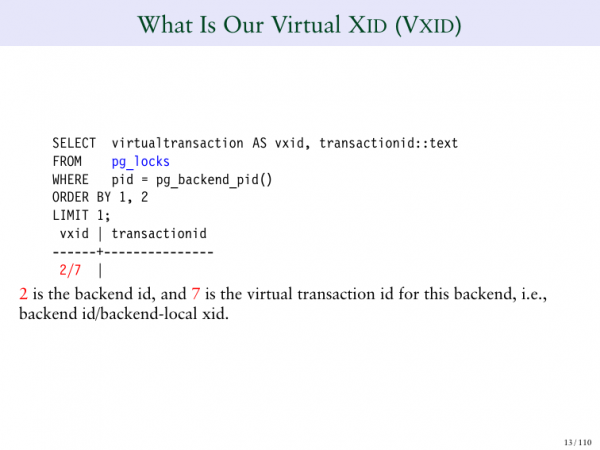
В този случай виждаме ID на транзакцията. Това е номерът, който сме му присвоили. И има още един тип ID на транзакция в Postgres, наречен виртуален ID на транзакция.
И трябва да разберем това. Много е важно, иначе няма да можем да разберем блокировката в Postgres.
Виртуален ID на транзакция е ID на транзакция, която не съдържа постоянни стойности. Например, ако стартирам команда SELECT, вероятно няма да променя базата данни, няма да блокирам нищо. Затова, когато стартирам прост SELECT, не даваме на тази транзакция постоянен ID. Даваме и само виртуален ID.
И това увеличава производителността на Postgres, подобрява възможностите за почистване, затова виртуалният ID на транзакцията се състои от две числа. Първото число пред слеша е ID на бекенда. А вдясно просто виждаме брояч.
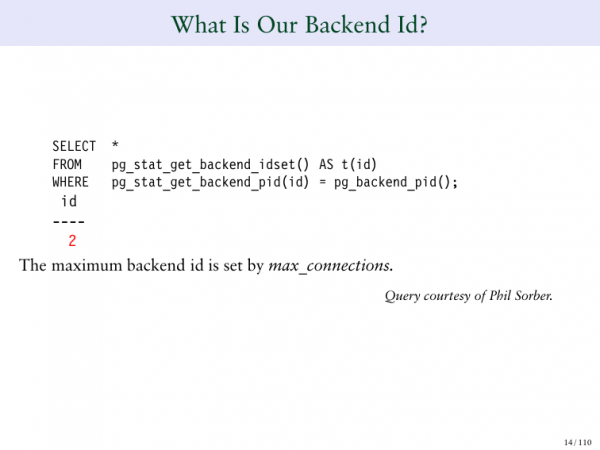
Затова, ако стартирам заявка, той казва, че ID на бекенда е 2.
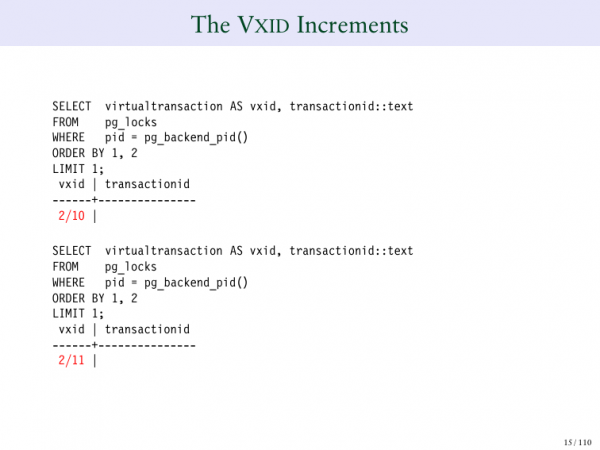
Ако стартирам серия от такива транзакции, виждаме, че броячът се увеличава всеки път, когато стартирам заявка. Например, когато стартирам заявка 2/10, 2/11, 2/12 и т.н.
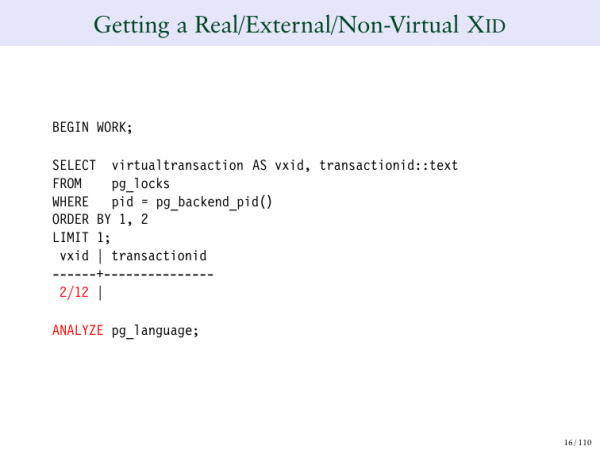
Имайте предвид, че тук има две колони. Вляво виждаме виртуалния ID на транзакцията – 2/12. А вдясно имаме постоянен ID на транзакцията. И това поле е празно. И тази транзакция не модифицира базата данни. Затова не й присвоявам постоянен ID на транзакцията.
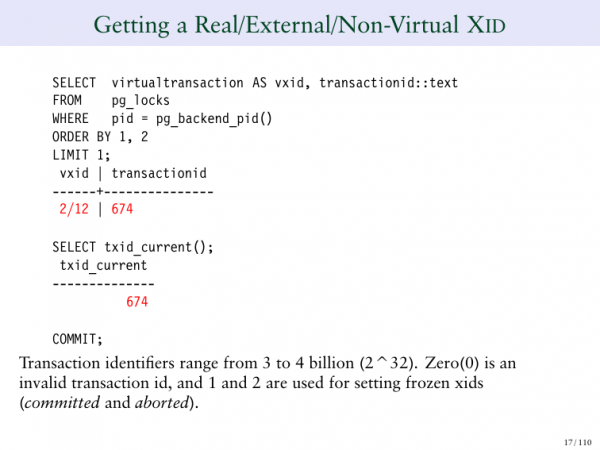
Веднага щом стартирам командата за анализ (ANALYZE), същата заявка ми издава постоянен ID на транзакцията. Вижте как се е променило. Преди нямах този ID, сега се появи.
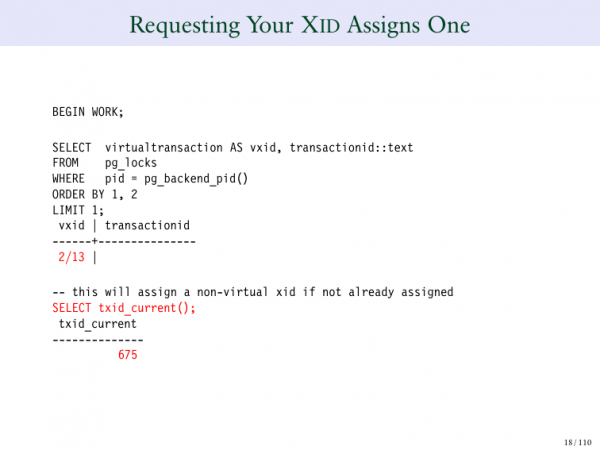
И така, тук имаме друга заявка, друга транзакция. Виртуалният номер на транзакцията е 2/13. И ако поискам постоянен ID на транзакцията, при стартиране на заявката, ще го получа.
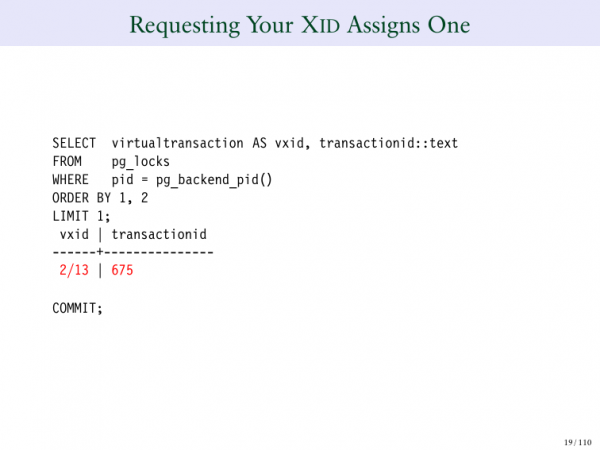
Така че, отново. Имаме виртуален ID на транзакцията и постоянен ID на транзакцията. Просто разберете този момент, за да разберете поведението на Postgres.
Преминаваме към третата част. Тук ще преминем през различните типове блокировки в Postgres. Това не е особено интересно. Последната част ще бъде много по-интересна. Но трябва да разгледаме основните неща, в противен случай няма да разберем какво следва.
Ще преминем през тази част, ще разгледаме всеки тип блокировки. И ще ви покажа примери как се задават, как работят, ще ви покажа някои заявки, които можете да използвате, за да видите как работи блокировката в Postgres.
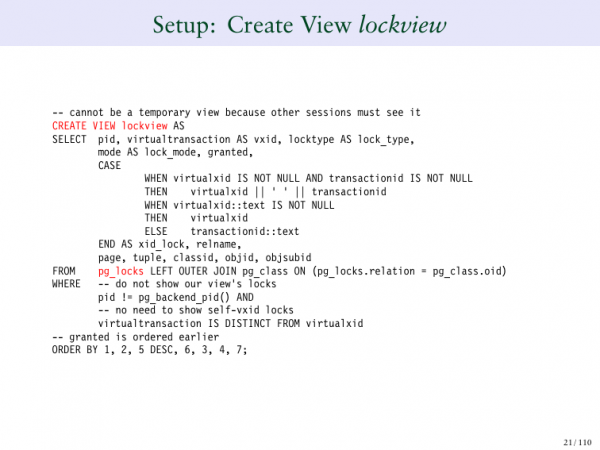
За да създадем заявка и да видим какво се случва в Postgres, трябва да издадем заявка в системния изглед. В този случай в червено е подчертан pg_lock. Pg_lock е системна таблица, която ни показва какви блокировки в момента се използват в Postgres.
Въпреки това, много ми е трудно да ви покажа pg_lock сам по себе си, защото е доста сложно. Затова създадох изглед, който показва pg_locks. И той също така изпълнява за мен известна работа, която ми позволява по-добре да разбера. Т.е. той изключва моите блокировки, моята собствена сесия и т.н. Това е просто стандартен SQL и той позволява по-добре да ви покаже какво се случва.
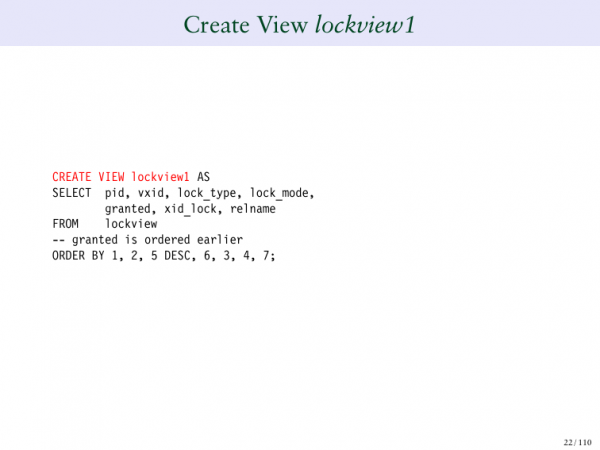
Още един проблем е, че този изглед е много широк, затова ми се налага да създам втори – lockview2.
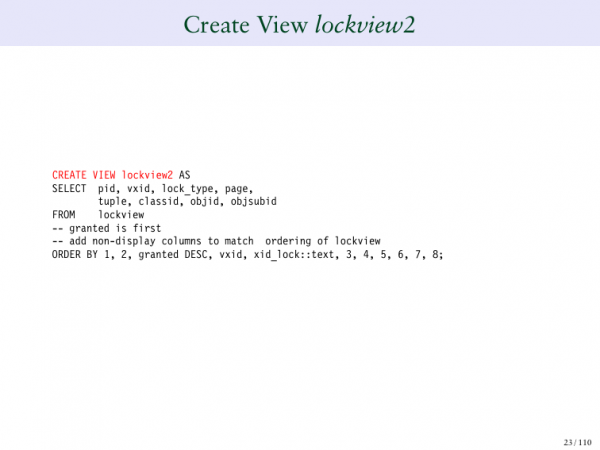 И той ми показва още колони от таблицата. И още един, който показва останалите колони. Това е достатъчно сложно, затова се опитах да го представя по най-простия начин.
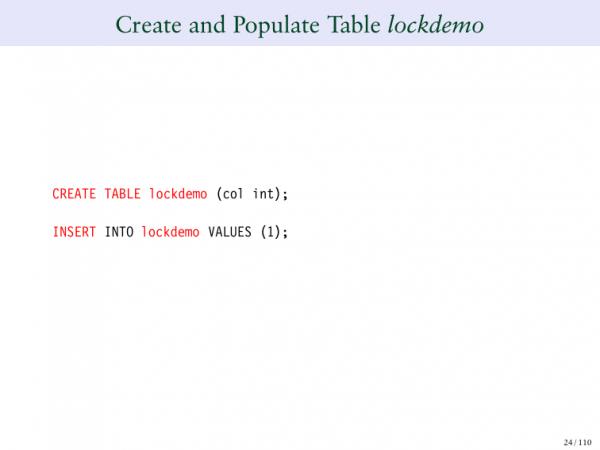
Така че, създадохме таблица, която се нарича Lockdemo. И създадохме там един ред. Това е нашата примерна таблица. И ще създадем секции, за да ви покажа примери за блокировки.
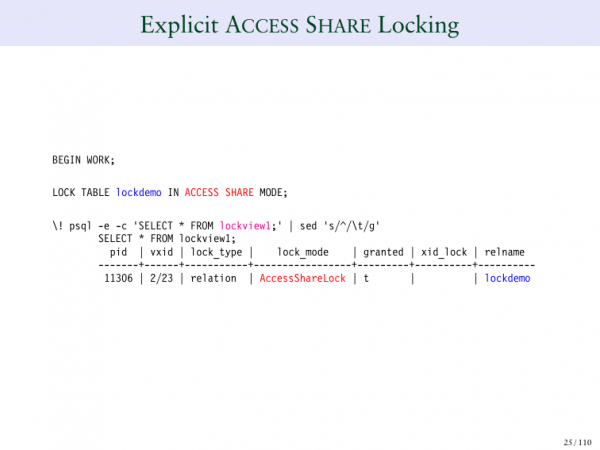
Така че, един ред, една колона. Първият тип блокировка се нарича ACCESS SHARE. Това е най-малко рестриктивната блокировка. Това означава, че почти не влиза в конфликти с другите блокировки.
Ако искаме експлицитно да определим блокировката, изпълняваме командата «lock table». Това явно ще блокира, т.е. в режим ACCESS SHARE изпълняваме lock table. И ако стартирам PSQL във фонов режим, така стартирам втора сесия от моята първа сесия. Какво ще направя тук? Преминавам към друга сесия и й казвам «покажи ми lockview за тази заявка». И тук имам AccessShareLock в тази таблица. Това е точно това, което поисках. И той казва, че блокировката е присвоена. Много просто.
Следващото, ако погледнем втората колона, там няма нищо. Те са празни.
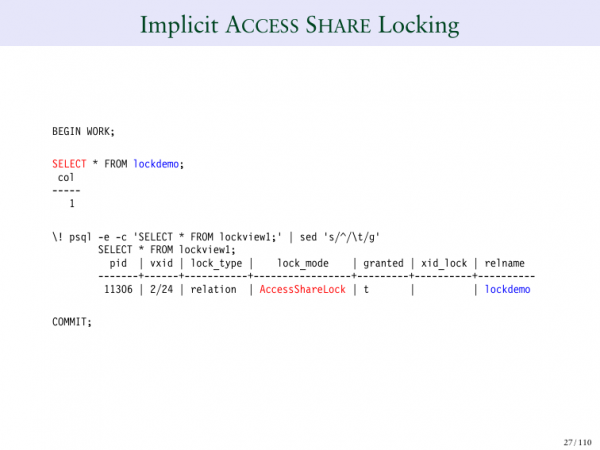
Ако изпълня командата «SELECT», това е имплицитен (явен) начин за заявяване на AccessShareLock. Затова освобождавам таблицата и изпълнявам запитването, и запитването връща няколко реда. В един от редовете виждаме AccessShareLock. Така SELECT предизвиква AccessShareLock в таблицата. И той не конфликтира практически с нищо, защото е блокировка с ниско ниво.
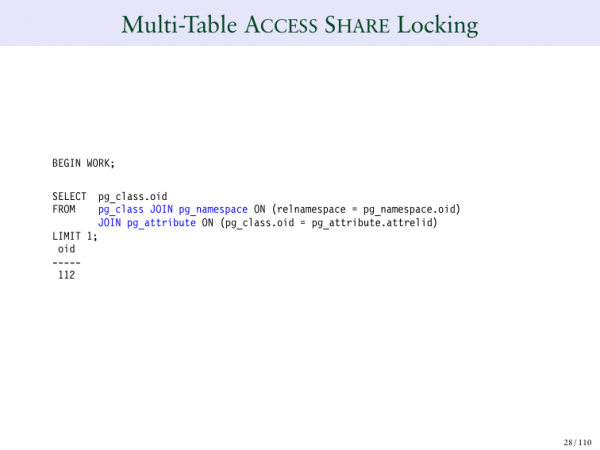
Какво ще стане, ако изпълня SELECT и имам три различни таблици? Преди изпълнявах само една таблица, сега изпълнявам три: pg_class, pg_namespace и pg_attribute.
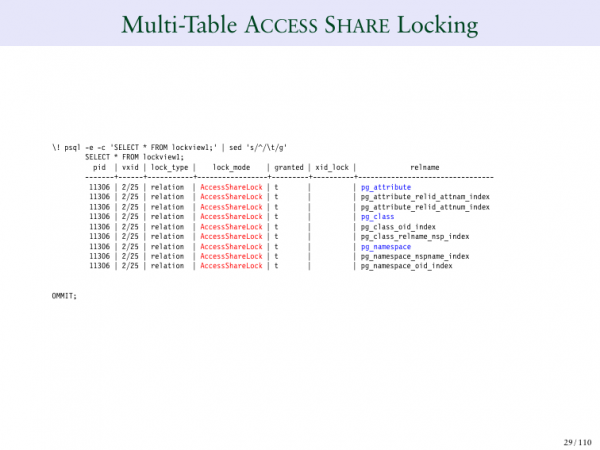
И сега, когато погледна запитването, виждам 9 AccessShareLocks в трите таблици. Защо? Синьо е оцветено трите таблици: pg_attribute, pg_class, pg_namespace. Но можете също да видите, че всички индекси, които са определени през тези таблици, също имат AccessShareLock.
И това е блокировка, която практически не конфликтува с другите. Всичко, което прави, е просто да не ни позволи да изтриваме таблицата, докато я избираме. Има смисъл. Т.е. ако избираме таблицата, тя в този момент изчезва, което е неправилно, затова AccessShare – това е блокировка с ниско ниво, която ни казва «не изтривайте тази таблица, докато работя». Всъщност, това е всичко, което прави.
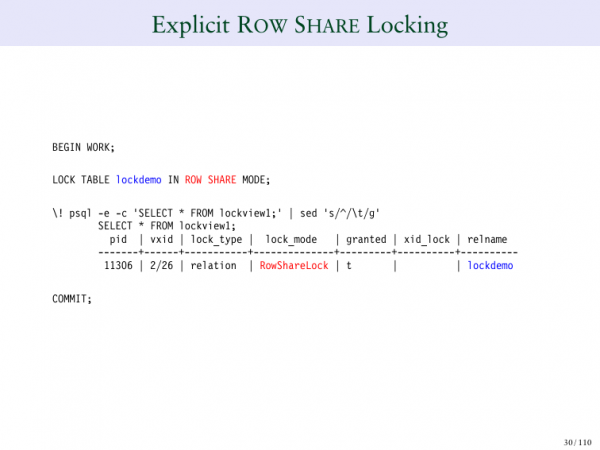
ROW SHARE – това е блокировка, която е малко различна.
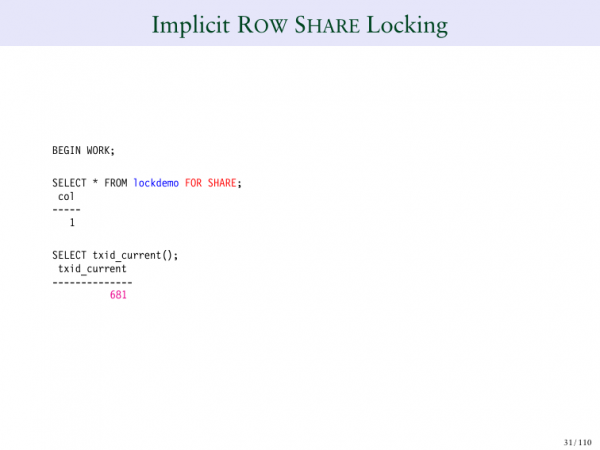
Да вземем пример. SELECT ROW SHARE е начин на блокиране на всеки ред поотделно. Така че никой не може да ги изтрива или променя, докато ги гледаме.
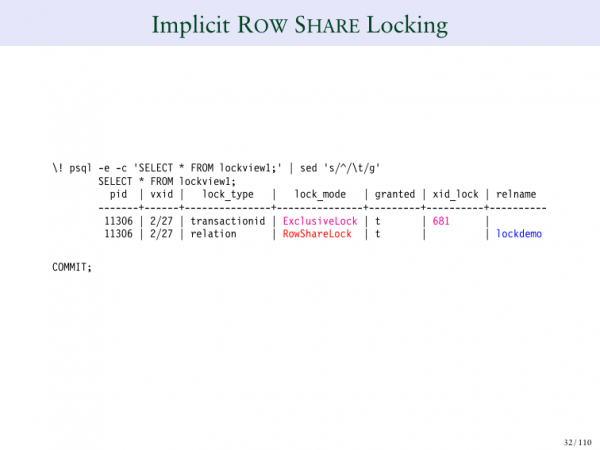 Така, какво прави SHARE LOCK? Виждаме, че ID на транзакцията е 681 за SELECT. И това е интересно. Какво се е случило тук? Първият път виждаме номер в полето "Lock". Вземаме ID на транзакцията и той казва, че я блокира в ексклузивен режим. Всичко, което прави, е, че казва, че имам ред, който технически е блокиран някъде в таблицата. Но не казва къде точно. По-късно ще разгледаме това по-подробно.
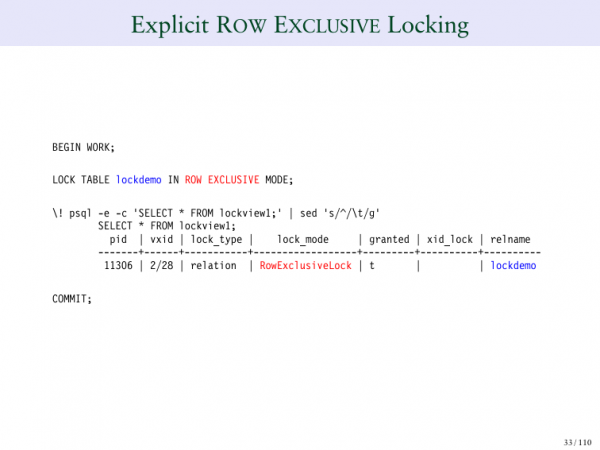
Тук казваме, че блокировката се използва от нас.
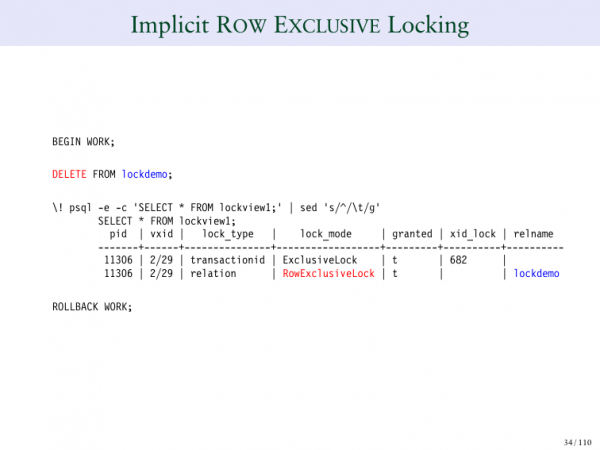
Така, ексклузивната блокировка изрично (ясно) казва, че е ексклузивна. И също ако изтривате ред в тази таблица, то това и ще се случи, както можете да видите.
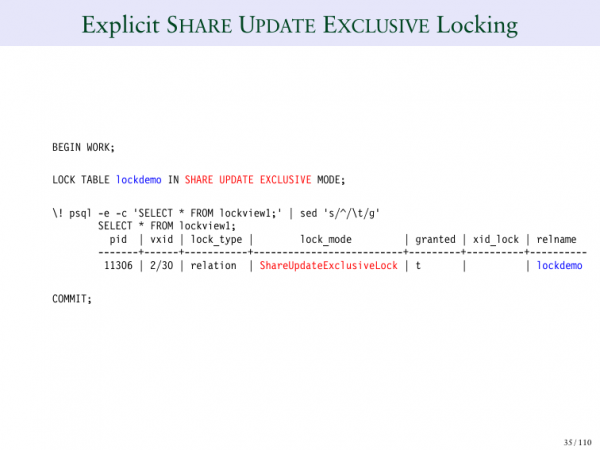
SHARE EXCLUSIVE – това е по-дълга блокировка.
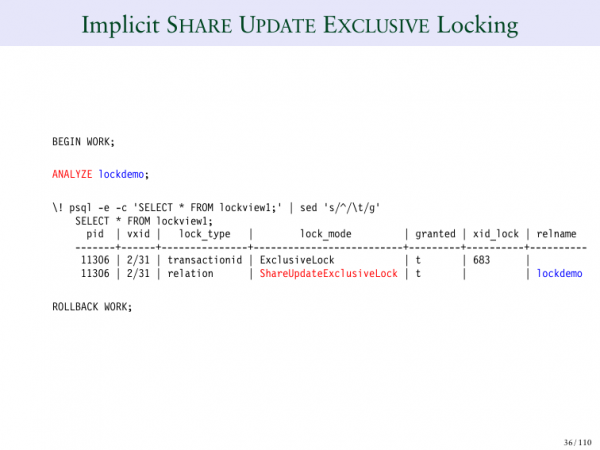
Това (ANALYZE) е команда на анализатора, която ще се използва.
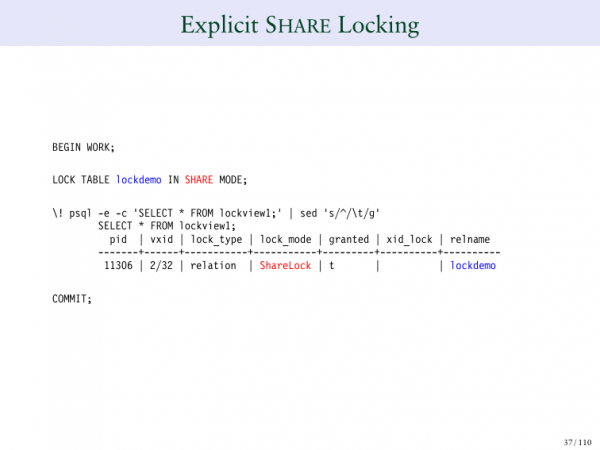
SHARE LOCK – можете изрично да блокирате в режим share.
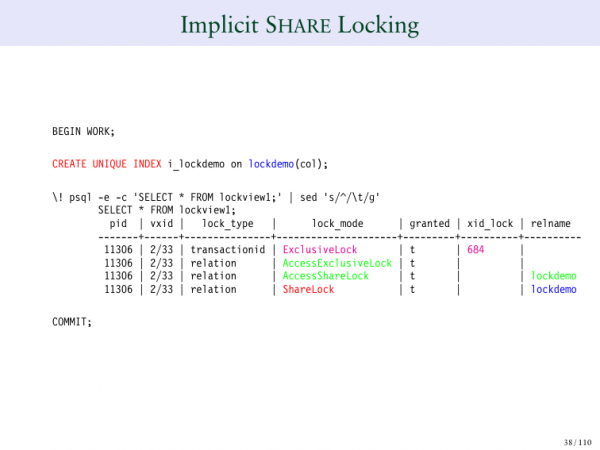
Можете също да създадете уникален индекс. И там можете да видите SHARE LOCK, който е част от тях. Той блокира таблицата и поставя на нея блокировка SHARE LOCK.
По подразбиране SHARE LOCK на таблицата означава, че другите хора могат да четат таблицата, но никой не може да я модифицира. И точно това се случва, когато създавате уникален индекс.
Ако създам уникален индекс concurrently, то ще имам друг тип блокировка, защото, както помните, използването на concurrently индекси намалява изискването за блокировка. И ако използвам нормална блокировка, нормален индекс, по този начин ще предотвратя записването в индекса на таблицата по време на неговото създаване. Ако използвам concurrently индекс, то трябва да използвам друг тип блокировка.
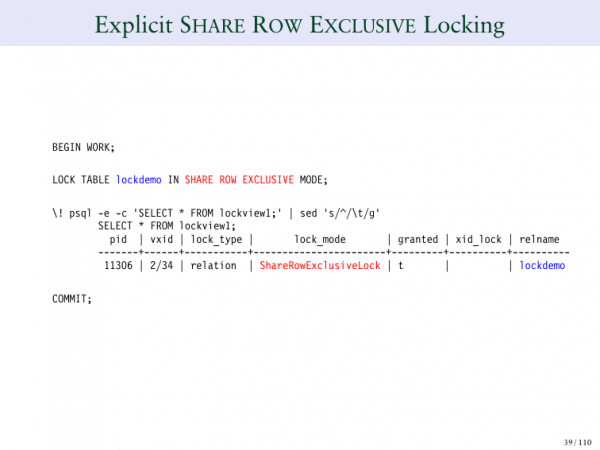
SHARE ROW EXCLUSIVE – отново може да бъде зададена изрично (ясно).
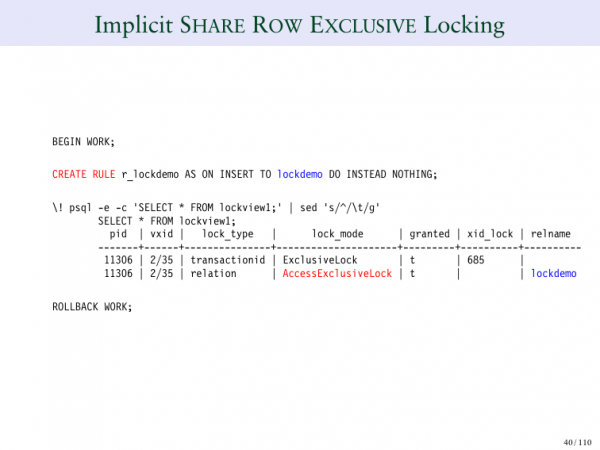
Или можем да създадем правило, т.е. да вземем конкретен случай, при който тя ще се използва.
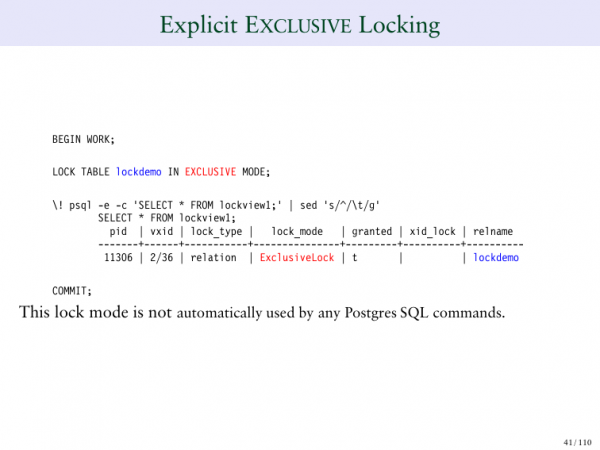
EXCLUSIVE блокировка означава, че никой друг не може да променя таблицата.
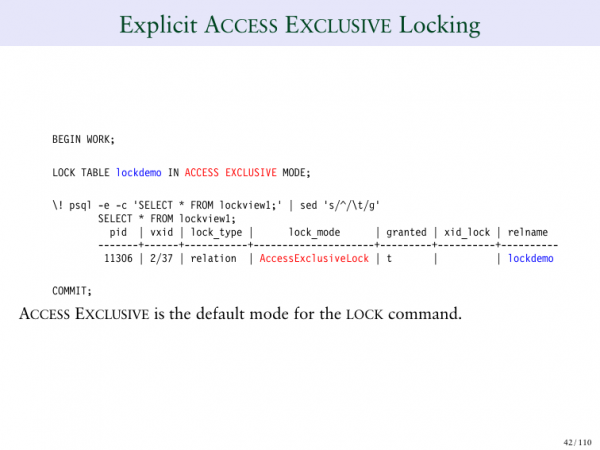
Тук виждаме различни типове блокировки.
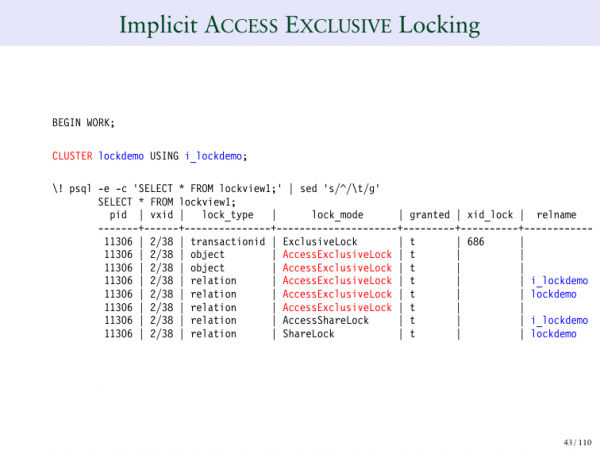
ACCESS EXCLUSIVE, например, това е команда за блокировка. Например, ако правите CLUSTER table, тогава това ще означава, че никой не може да записва там. И тя блокира не само самата таблица, но и индекси също.
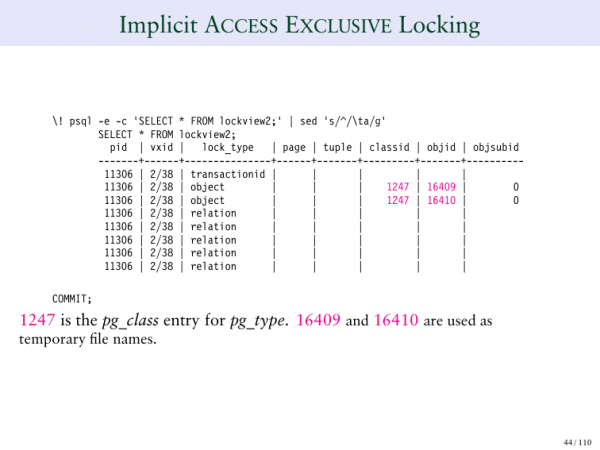
Това е втората страница на блокировката ACCESS EXCLUSIVE, където виждаме конкретно какво блокира в таблицата. Тя блокира отделни редове на таблицата, което е доста интересно.
Това е цялата основна информация, която исках да предоставя. Говорихме за блокировки, за идентификатори на транзакции, говорихме за виртуални идентификатори на транзакции, за постоянни идентификатори на транзакции.
Сега ще преминем през примери за блокировки. Това е най-интересната част. Ще разгледаме много интересни случаи. И моята задача в тази презентация е да ви дам по-добро разбиране за това, какво всъщност прави Postgres, когато се опитва да блокира различни неща. Струва ми се, че той много добре умее да блокира отделни части.
Нека да разгледаме конкретни примери.
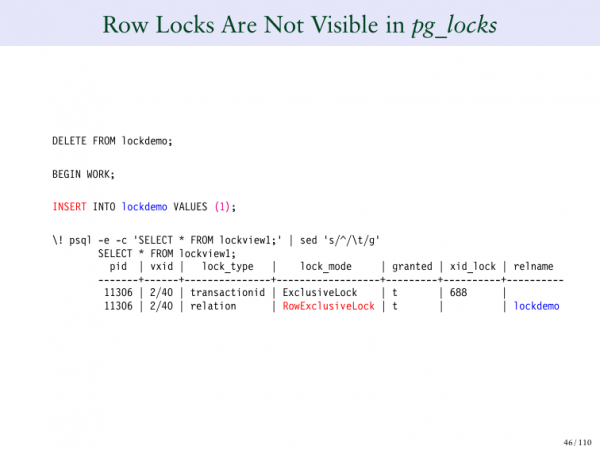
Започваме с таблици и с един ред в таблицата. Когато вмъкна нещо, ми се показва ExclusiveLock, идентификатор на транзакция и ExclusiveLock на таблицата.
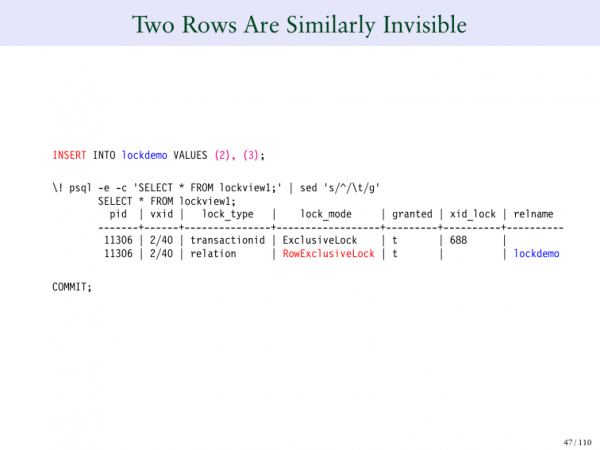
А какво ще се случи, ако вмъкна още два реда? И сега в нашата таблица има три реда. Вмъкнах един ред и получих това на изхода. И ако вмъкна още два реда, какво е странното тук? Има странност, защото добавих три реда в тази таблица, но все още имам два реда в таблицата за блокировки. И това по същество е основополагающо поведение на Postgres.
Много хора мислят, че ако в блокирането на базата данни блокирате 100 реда, то ще ви е необходимо създаването на 100 записи за блокировка. Ако блокирам веднага 1 000 реда, то тогава ще ми трябват 1 000 такива заявки. И ако трябва да блокира милион или милиард. Но ако правим така, няма да работи много добре. Ако сте използвали система, която създава записи за блокировка за всеки отделен ред, виждате, че това е сложно. Защото трябва да определите веднага табличка за блокировка, която може да се пренасити, но Postgres не прави така.
На този слайд е много важно, че тук ясно се демонстрира, че има още една система, която работи вътре в MVCC, която блокира отделни редове. Затова, когато блокирате милиарди редове, Postgres не създава милиард отделни команди за блокировка. И това оказва много добро влияние върху производителността.
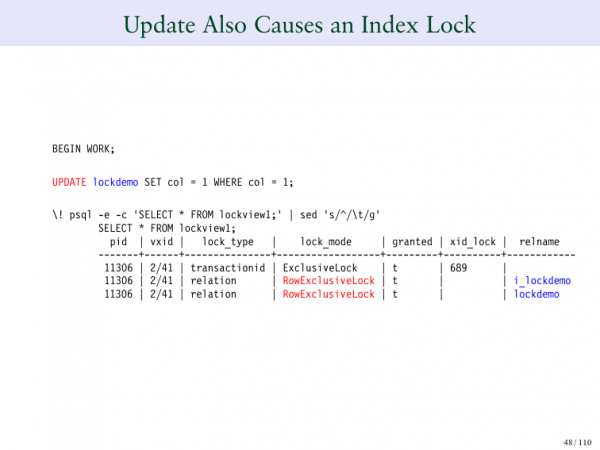
Какво ще кажете за обновлението? В момента обновявам ред, и може да забележите, че той веднага извърши две различни операции. Той едновременно блокира таблицата, но също така блокира и индекса. И трябваше да блокира индекса, защото има уникални ограничения за тази таблица. Искаме да сме сигурни, че никой не го променя, затова го блокираме.
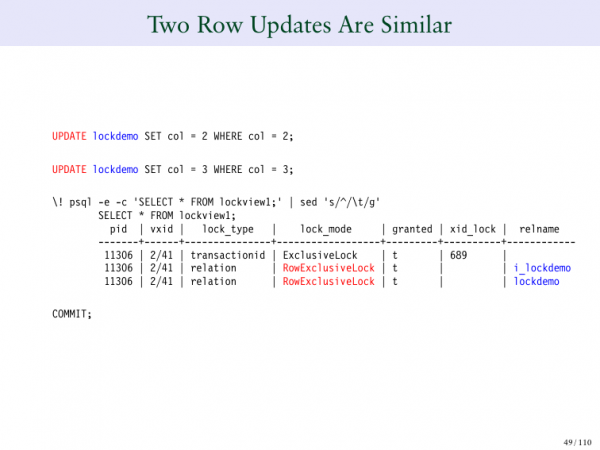
А какво ще се случи, ако искам да обновя два реда? И виждаме, че той се държи по същия начин. Правим два пъти повече обновления, но точно същото количество блокировки на редове.
Ако ви интересува как Postgres го прави, трябва да слушате моите лекции за MVCC, за да разберете как Postgres вътрешно маркира редовете, които променя. И Postgres има начин, по който го прави, но не го прави на ниво блокиране на таблици, а го прави на по-ниско и по-ефикасно ниво.
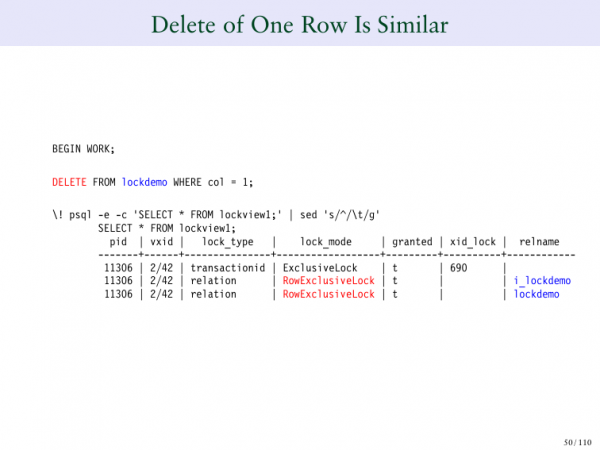
А какво ще стане, ако искам да изтрия нещо? Ако изтрия, например, един ред и все още имам моите две входни блокировки, дори и да искам да изтрия всичките им, те все още ще присъстват.
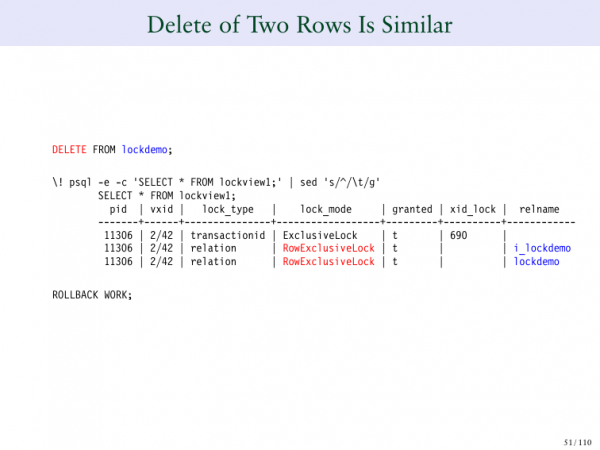
И, например, ако искам да вмъкна 1 000 реда, а след това или да изтрия, или да добавя 1 000 реда, то индивидуалните редове, които добавям или променям, не се записват тук. Те се записват на по-ниско ниво вътре в самия ред. И по време на лекцията за MVCC говорих подробно за това. Но е много важно, когато анализирате блокировките, да сте сигурни, че имате блокировка на ниво таблица и че тук не виждате как се записват отделни редове.
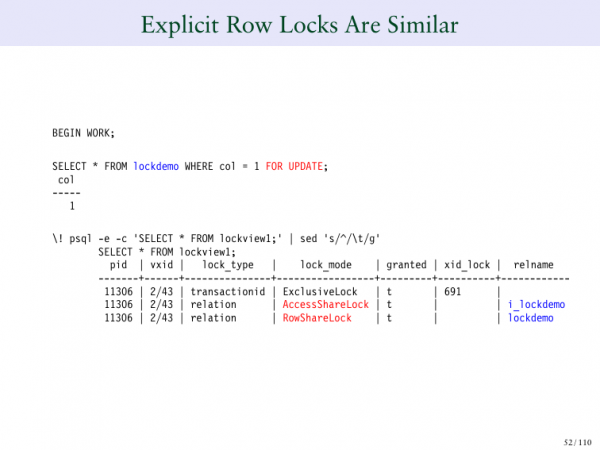
А какво ще кажете за експлицитната блокировка?
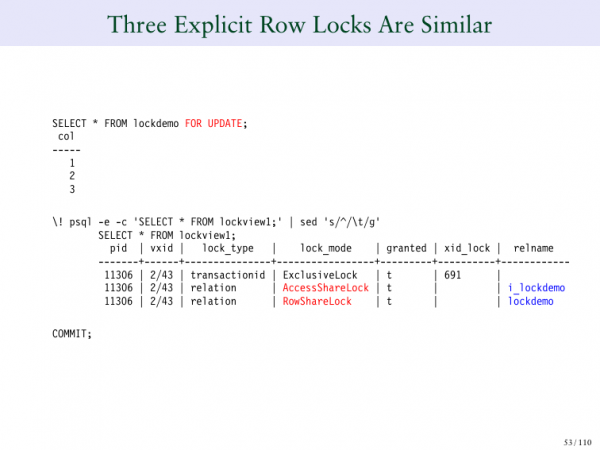
Ако натисна "обнови", тогава имам две блокирани реда. И ако ги маркирам всички и натисна "обнови навсякъде", все пак оставам с две записи за блокировка.
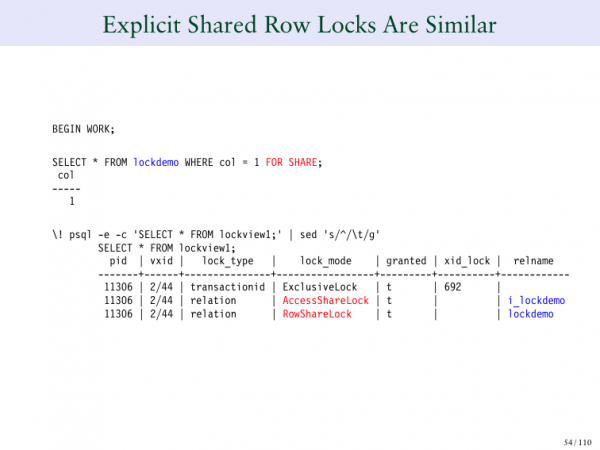
Не създаваме отделни записи за всеки отделен ред. Защото тогава производителността пада, и може да се окажем в неприятна ситуация.
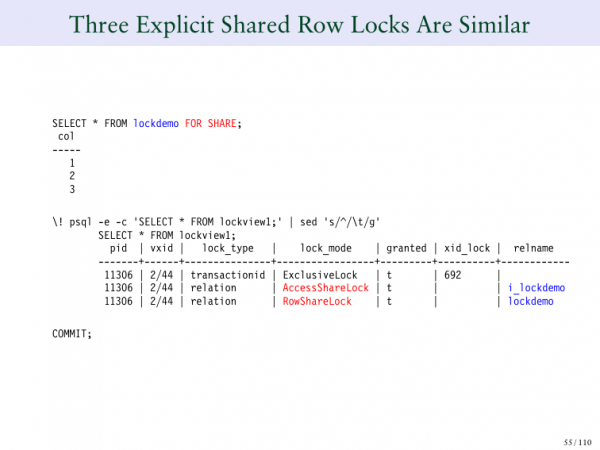
И същото важи, ако правим shared, можем да правим за всички 30 пъти.
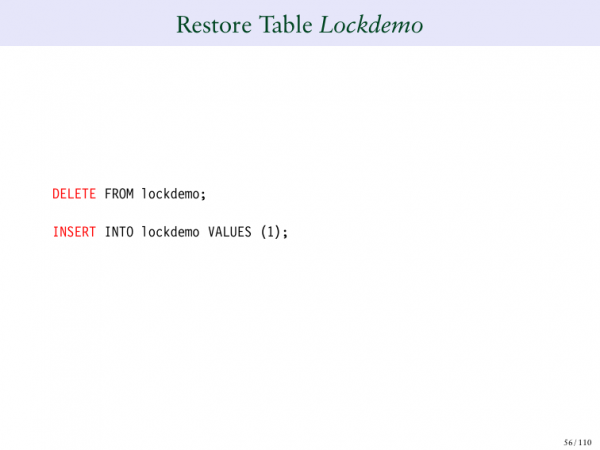
Възстановяваме нашата таблица, изтриваме всичко, после отново вмъкваме един ред.
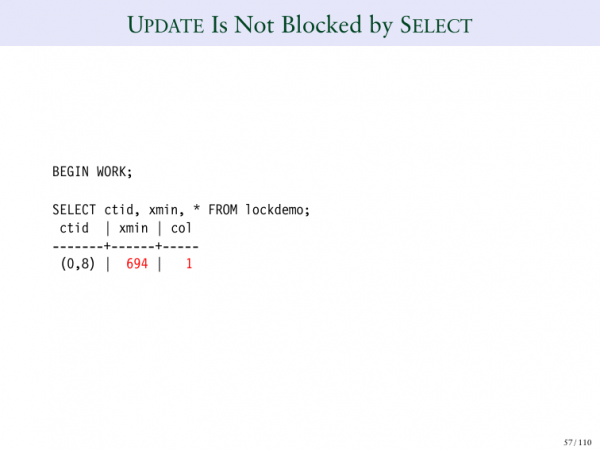
Още един вид поведение, което виждате в Postgres, е много добре известно и желано поведение – това е, че можете да извършвате update или select. И можете да го правите едновременно. И select не блокира update и също така обратното. Казваме на четящия да не блокира пишещия, а пишещият да не блокира четящия.
Ще ви покажа пример за това. Сега ще направя избор. После ще направим INSERT. И след това ще можете да видите – 694. Ще можете да видите ID на транзакцията, която е извършила това вмъкване. И това е как работи.
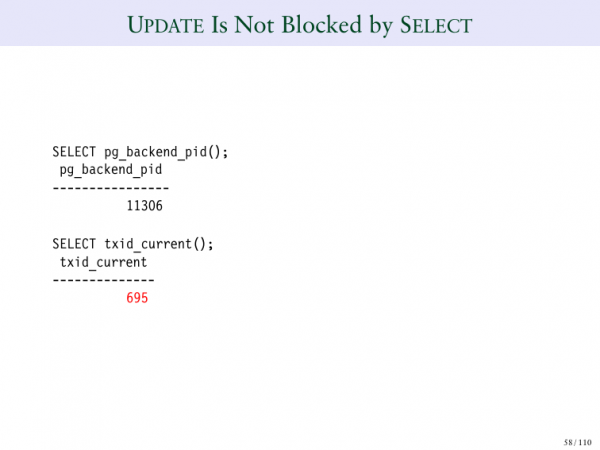
И ако сега погледна моя бекенд ID, то стана – 695.
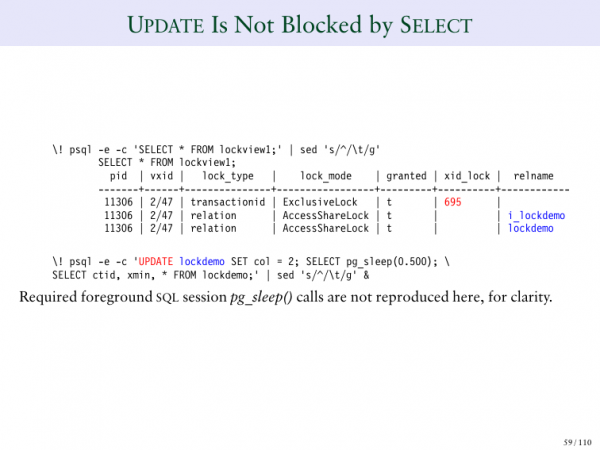
И мога да видя, че 695 се появява в моята таблица.
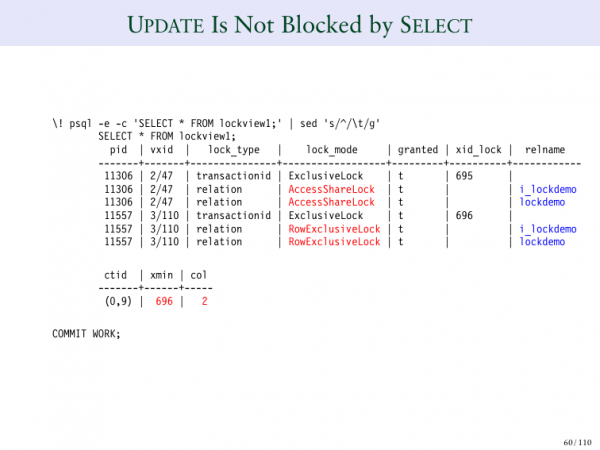
И ако извърша обновление тук така, получавам друг случай. В този случай 695 – е ексклузивна блокировка, а при update имаме същото поведение, но между тях няма конфликт, което е достатъчно необичайно.
И можете да забележите, че отгоре – това е ShareLock, а отдолу – ExclusiveLock. И двете транзакции са се получили.
И трябва да чуете моето представяне в MVCC, за да разберете как това става. Но това е илюстрация на това, че можете да правите това едновременно, т.е. едновременно да извършвате SELECT и UPDATE.
Нека нулираме и отново да направим една операция.
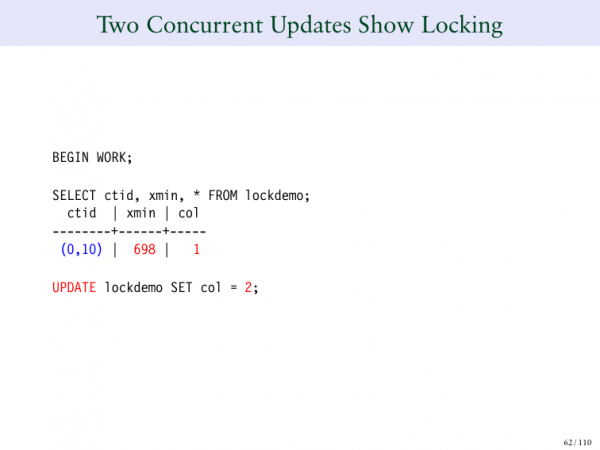
Ако опитате да стартирате едновременно два update на същия ред, то ще бъде блокирано. И помнете, казвах, че четящият не блокира пишещия, а пишещият блокира четящия, но един писател блокира другия писател. Т.е. не можем да направим така, че двама души едновременно да обновяват един и същ ред. Трябва да изчакате, докато единият от тях завърши.
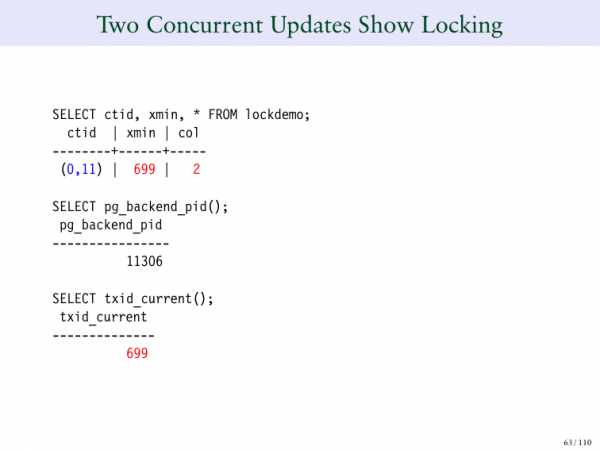
И за да илюстрирам това, ще разгледам таблицата Lockdemo. И ще погледнем един ред. На транзакция 698.
Обновихме го до 2. 699 – това е първото обновление. И то премина успешно или е в чакаща транзакция и очаква, когато ние потвърдим или отменим.
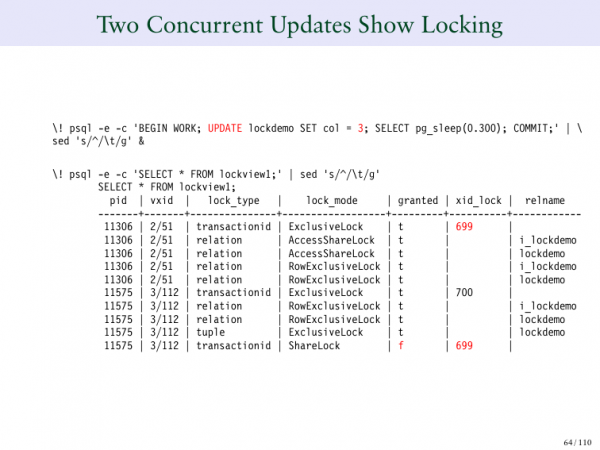
Но погледнете нещо друго – 2/51 – това е нашата първа транзакция, нашата първа сесия. 3/112 – това е втората заявка, която се появи отгоре и която промени тази стойност на 3. И ако забележите, горният блокира сам себе си, който е 699. Но 3/112 не предостави блокировка. В колоната Lock_mode пише, че очаква. Той очаква 699. И ако погледнете, къде е 699, той е по-горе. И какво направи първата сесия? Тя създаде ексклузивна блокировка на собствения си транзакционен ID. Това е начина, по който Postgres го прави. Той блокира собствения транзакционен ID. И ако искате да чакате, докато някой потвърди или отмени, трябва да чакате, докато има изчакваща транзакция. И затова можем да видим странен ред.
Да погледнем отново. Отляво виждаме нашето процесингово ID. Във втората колона виждаме нашето виртуално ID на транзакцията, а в третата виждаме lock_type. Какво означава това? По същество, тя казва, че блокира транзакционния ID. Но забележете, че във всички редове по-долу пише relation. И затова имате два вида блокировка в таблицата. Има блокировка relation. А също така има блокировка transactionid, където блокирате сами, това е точно това, което се случва в първия ред или в самия низ, където transationid, където чакаме 699 да завърши операцията си.
Гледам какво се получава тук. И тук едновременно се случват две неща. Вие гледате на блокировката по транзакционен ID в първия ред, която блокира сама себе си. И тя блокира сама себе си, за да накара хората да чакат.
Ако погледнете 6-ия ред, то това е същият запис, като първия. И затова транзакция 699 се блокира. 700 също се самоблокира. И после в долния ред ще видите, че чакаме 699 да завърши операцията си.
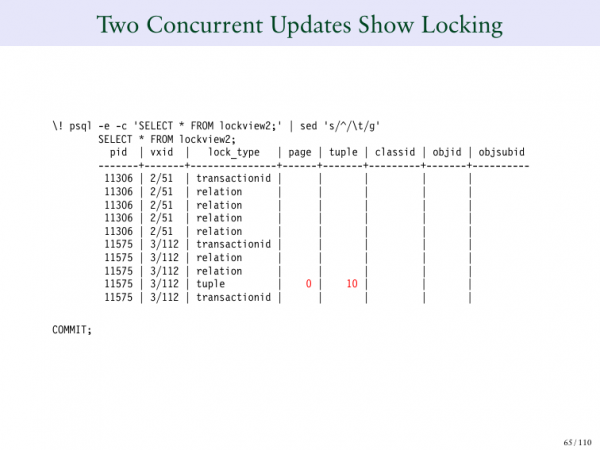
И в lock_type, tuple виждате числа.
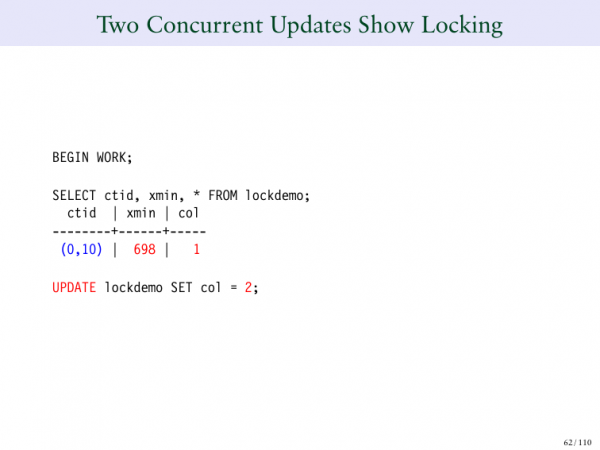
Можете да видите, че това е 0/10. И това е номерът на страницата, и също offset на този конкретен ред.
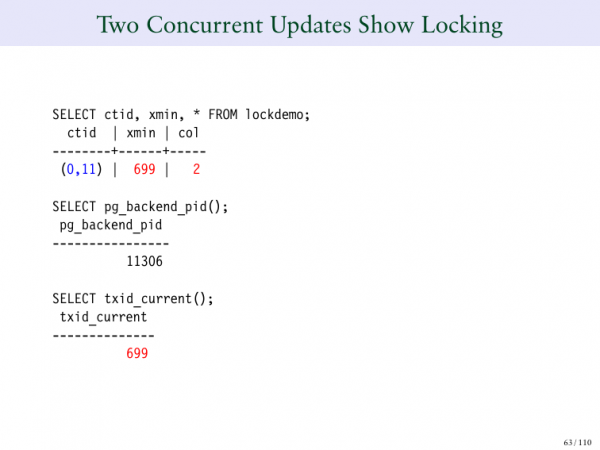
И виждате, че става 0/11, когато обновяваме.
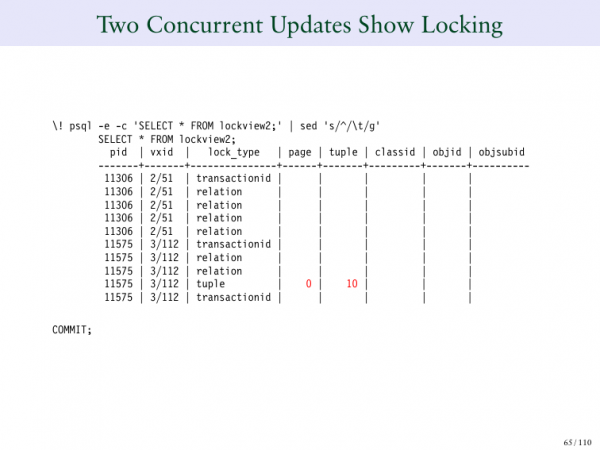
Но всъщност – това е 0/10, защото се случва чакане на тази операция. Имаме възможност да видим, че това е редът, който чакам, за да бъде потвърден.
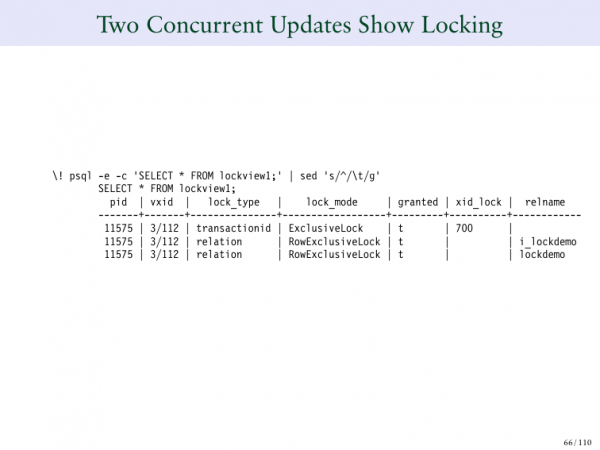
След като потвърдим и натиснем commit, и когато актуализацията приключи, получаваме следното. Транзакция 700 е единствената блокировка, която не чака никого, защото е закомитвана. Тя просто чака да приключи транзакцията. След като 699 завърши, вече не чакаме нищо. И сега транзакцията 700 казва, че всичко е наред, че има всички необходими блокировки във всички разрешени таблици.
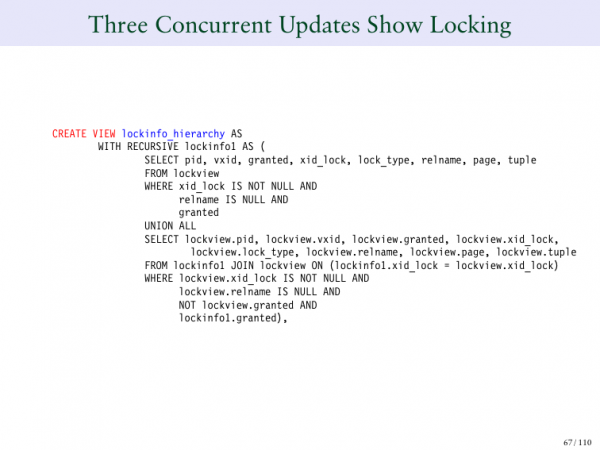
И за да усложним всичко, създаваме още един view, който този път ще ни предостави йерархия. Не очаквам да разберете този запитване. Но това ще ни даде по-ясна представа за това, което се случва.
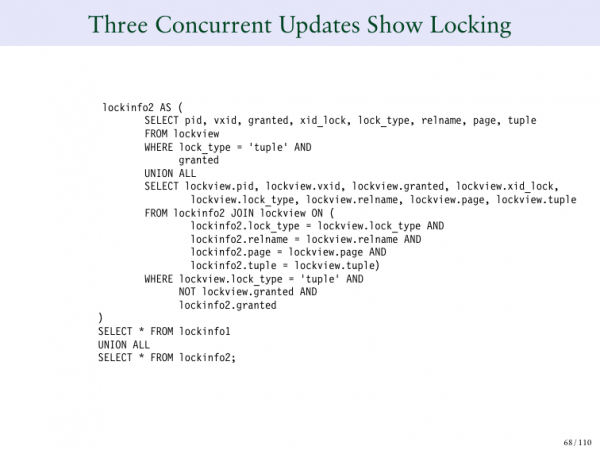
Това е рекурсивен view, който има и още една секция. И след това отново се събира всичко. Нека го използваме.
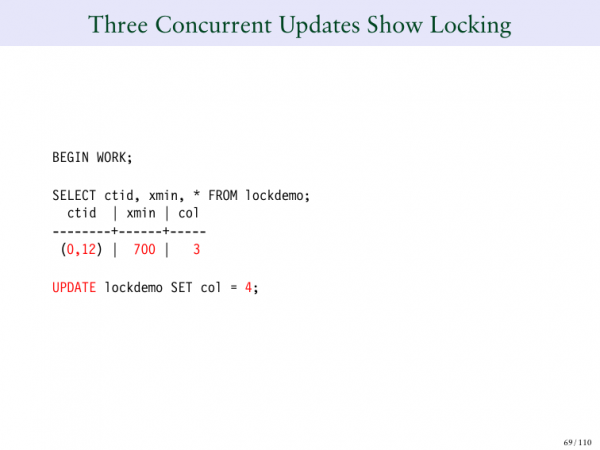
Какво ще стане, ако направим три едновременни актуализации и кажем, че редът в момента е 3. И ние променим 3 на 4.
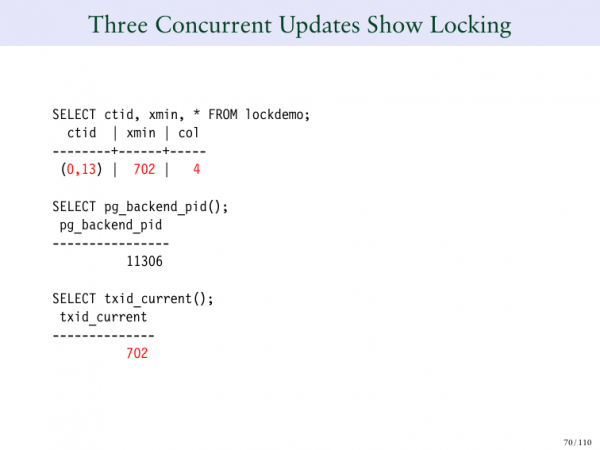
И ето ни виждаме 4. И транзакционният ID 702.
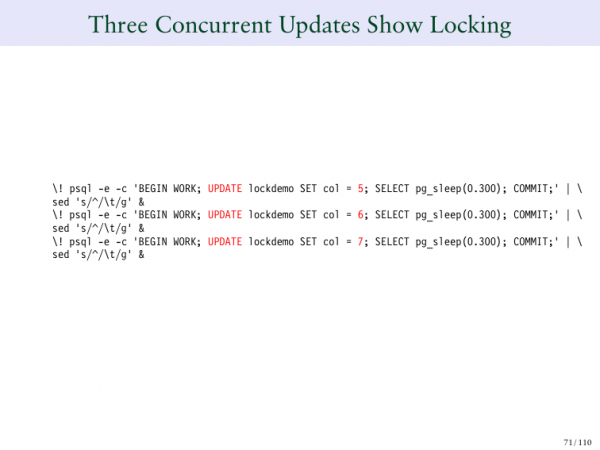
След това аз променям 4 на 5. А 5 на 6, а 6 на 7. И опашвам редица хора, които ще чакат да приключи тази една транзакция.
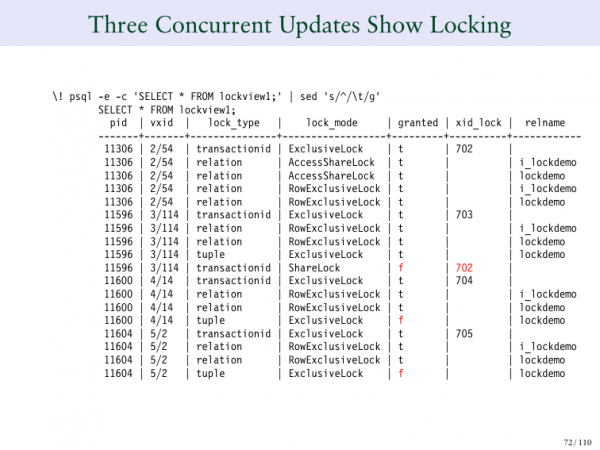
И всичко става ясно. Какъв е първият ред? Това е 702. Това е транзакционният ID, който първоначално зададе това значение. А какво имам написано в колоната Granted? Имам отметки f. Това са моите актуализации, които (5, 6, 7) не могат да бъдат одобрени, защото чакаме да завърши транзакционният ID 702. Там имаме блокировка на транзакционния ID. И в момента имаме 5 транзакционни блокировки ID.
Ако погледнете 704, 705, там още нищо не е написано, защото те все още не знаят какво се случва. Те просто пишат, че нямат представа какво става. И просто ще заспят, защото чакат някой да завърши и да ги събуди, когато се появи възможност да променят реда.
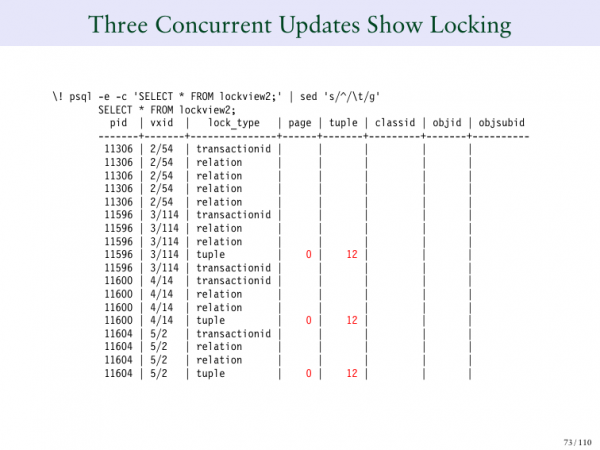
Така изглежда. Ясно е, че всички чакат 12-ия ред.
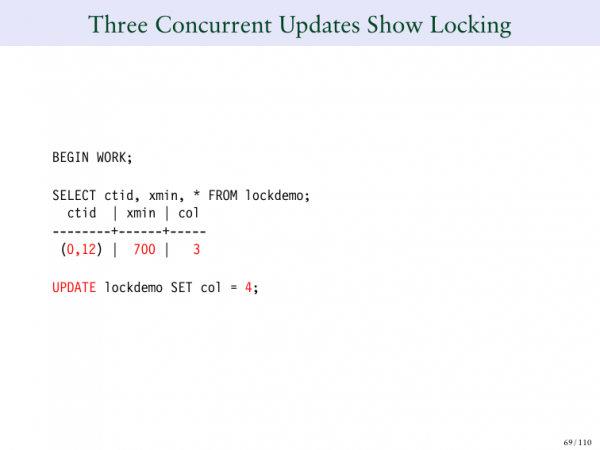
Това е, което видяхме тук. Ето 0/12.
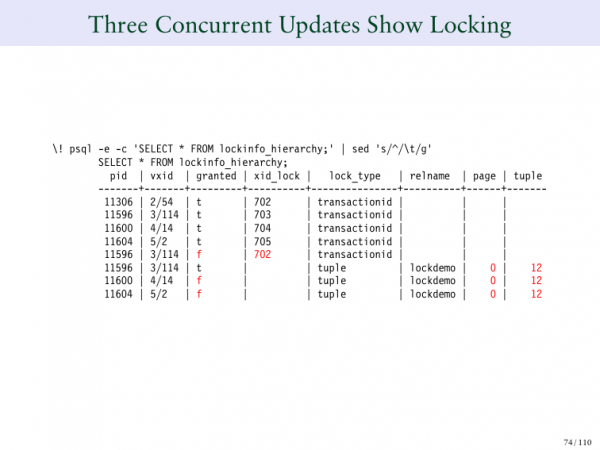
И така, след като първата транзакция бъде одобрена, можете да видите как работи йерархията. И сега всичко става ясно. Всички те стават чисти. И всъщност те все още чакат.
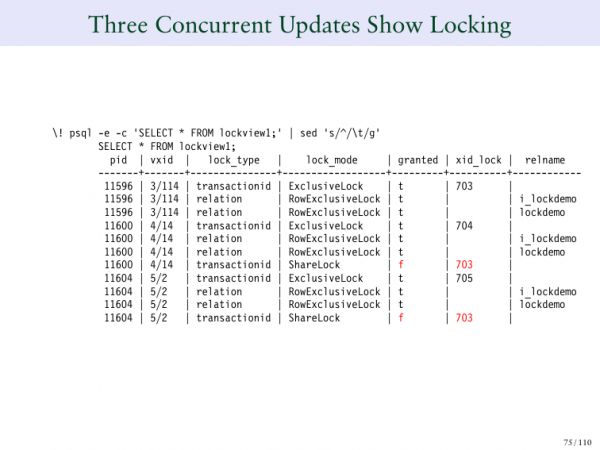
Това, което се случва. 702 записва. И сега 703 получава блокировката на реда, а после 704 започва да чака, докато 703 запише. И 705 също го очаква. И когато всичко приключи, те самите се освобождават. Искам да подчертая, че всички се подреждат в опашка. Много е подобно на ситуацията с задръстването, когато всички чакат първата кола. Първата кола спира и всички се подреждат в дълга линия. След това тя се движи, следващата кола може да премине напред и да получи своята блокировка и т.н.
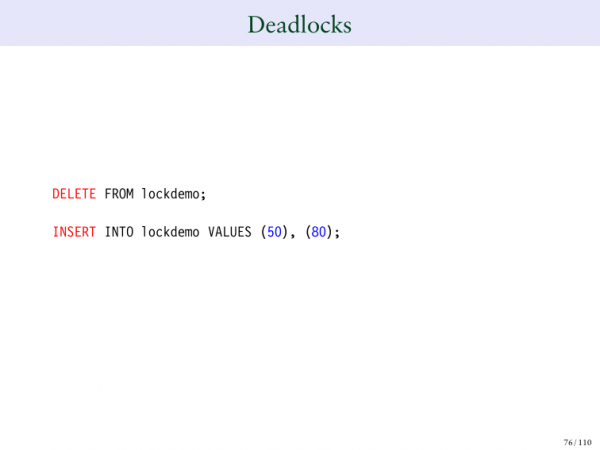
И ако това ви се е сторило недостатъчно сложно, сега ще поговорим за deadlocks. Не знам кой от вас е срещал с тях. Това е доста разпространен проблем в базите данни. Но deadlocks е случаят, когато една сесия чака, за да изпълни нещо, което друга сесия трябва да извърши. В същия момент другата сесия чака, за да завърши първата сесия нещо.
Например, ако Иван каже: „Дай ми нещо“, а аз отговоря: „Не, ще ти дам това само ако ми дадеш нещо друго“. А той казва: „Не, няма да ти дам, ако не ми дадеш“. И попадаме в ситуация на мъртва блокировка. Сигурен съм, че Иван няма да направи така, но разбирате смисъла, двама души искат нещо, но не са готови да го дадат, докато другият не им предостави това, което желаят. И тук няма решение.
И по същество вашата база данни трябва да открива това. След това е необходимо да се премахне или затвори една от сесиите, защото в противен случай те ще останат там завинаги. Ние виждаме това в базите данни, виждаме го в операционните системи. И на всяко място, където имаме паралелни процеси, това може да се случи.
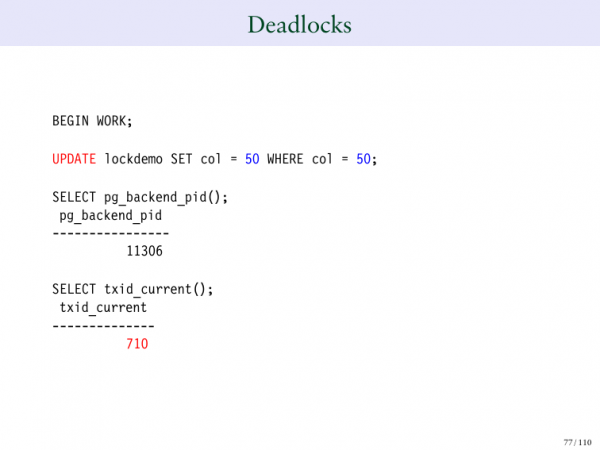
Сега ще предизвикаме две deadlocks. Ще използваме 50 и 80. В първия ред ще направя актуализация от 50 на 50. Ще получа номер на транзакцията 710.
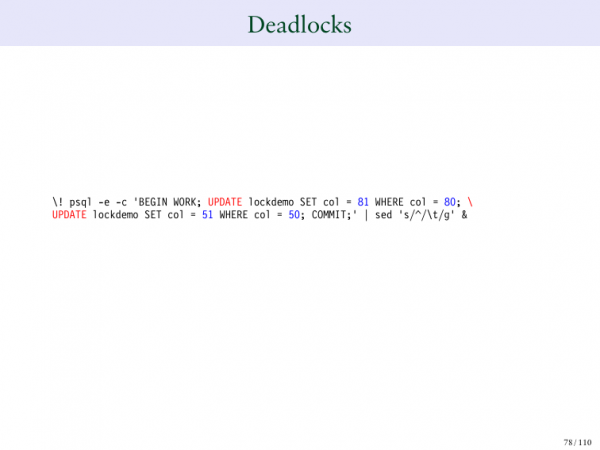
След това ще сменя 80 на 81, а 50 на 51.
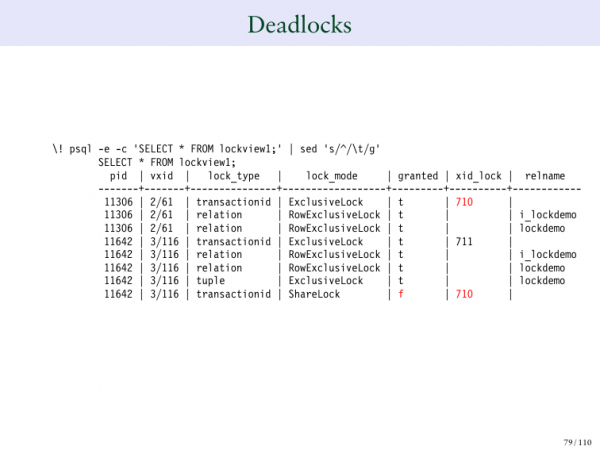
Ето как ще изглежда. Затова 710 има блокировка на реда, а 711 очаква потвърждение. Виждали сме това, когато актуализирахме. 710 е собственик на нашия ред. А 711 чака, за да завърши 710 транзакцията.
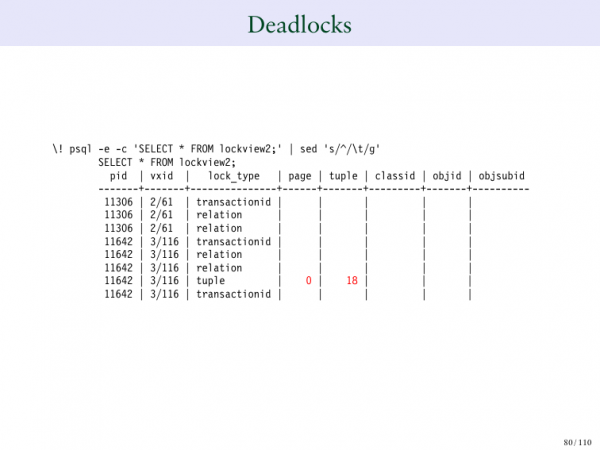
Там дори е написано на кой точно ред имаме deadlocks. И тук започва да става странно.
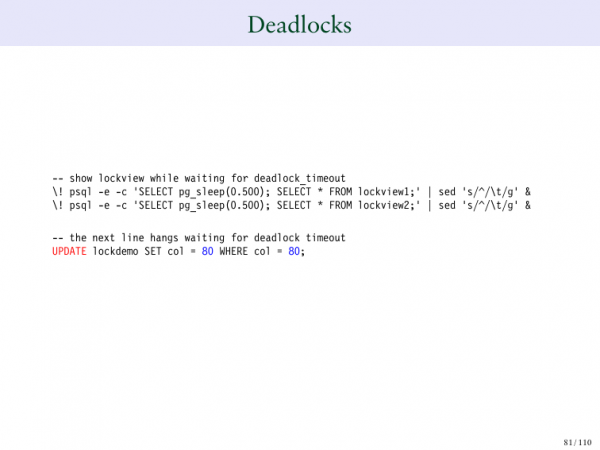
Сега актуализираме 80 на 80.
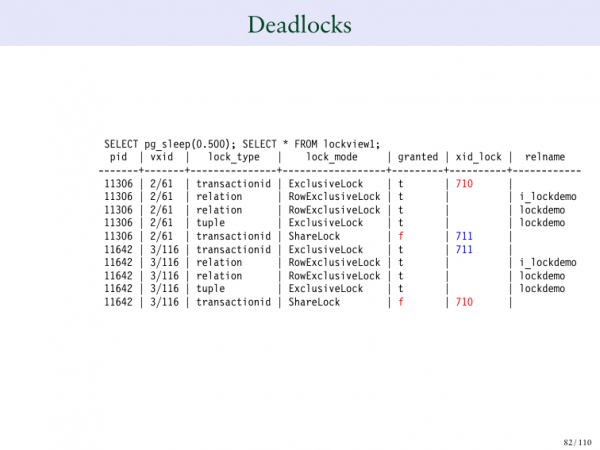
И тук започват мъртвите блокировки. 710 чака отговор от 711, а 711 чака от 710. И това няма да завърши добре. И няма изход от това. Те ще чакат отговор един от друг.
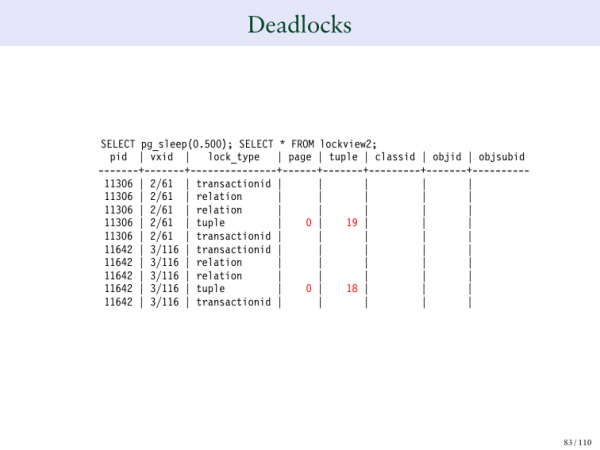
И това просто ще започне да забавя всичко. А ние не го искаме.
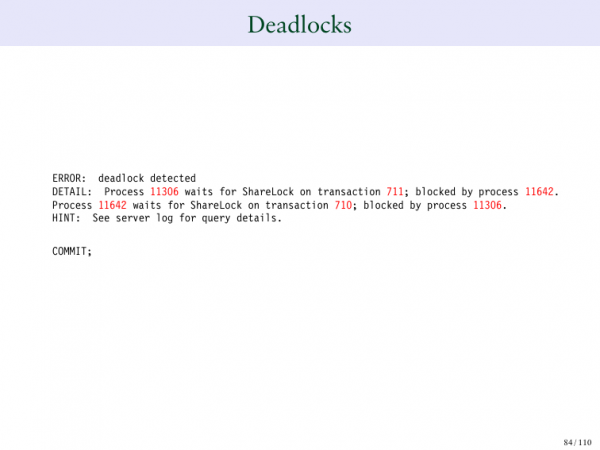
И в Postgres има начини да се забележи, когато това се случва. И когато това стане, ще получите следната грешка. И от това е ясно, че такъв процес чака SHARE LOCK от друг процес, т.е. който е блокиран от процес 711. А този процес е чакал да бъде предоставен SHARE LOCK на определен идентификатор на транзакцията и е бил блокиран от конкретен процес. Следователно, тук имаме ситуация на мъртва блокировка.
А има ли тройни мъртви блокировки? Възможно ли е това? Да.
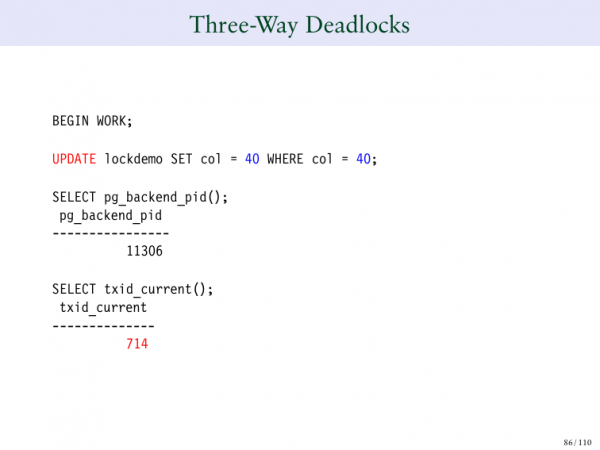
Въвеждаме тези числа в таблицата. Променяме 40 на 40, правим блокировка.
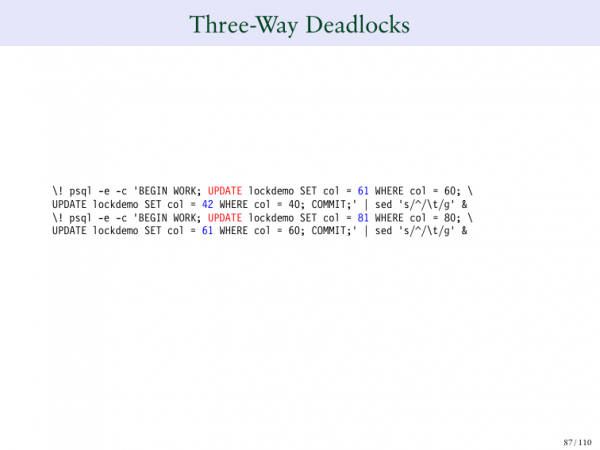
Променяме 60 на 61, 80 на 81.
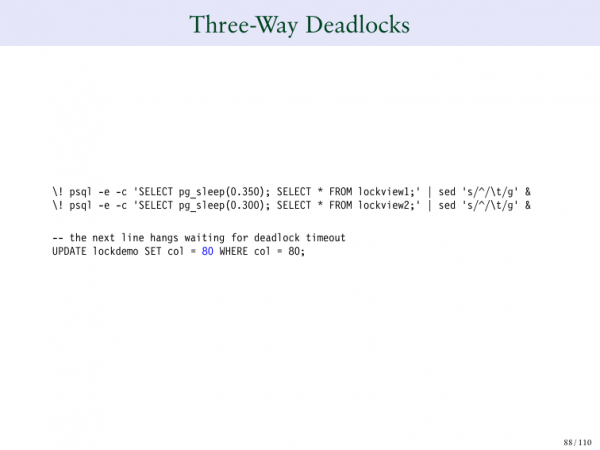
А след това променяме 80, а след това – бум!
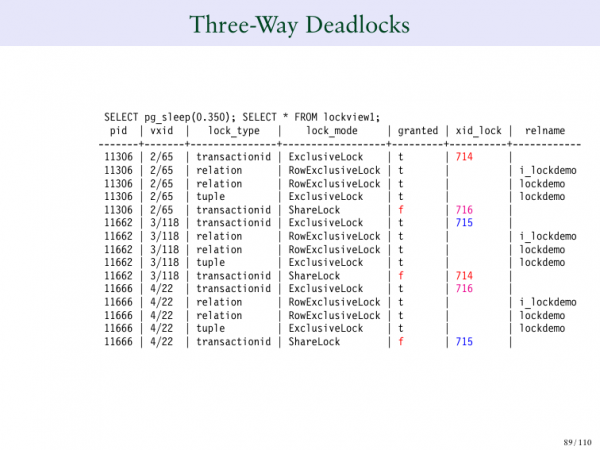
И 714 сега чака 715. 716-ти чака 715-ти. И с това вече нищо не може да се направи.
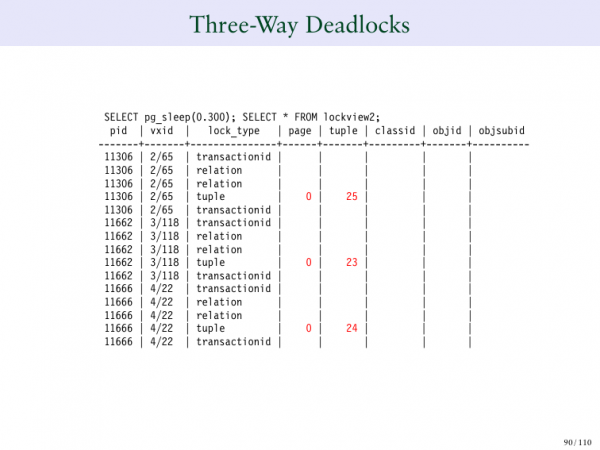
Тук вече не са двама души, тук вече са трима души. Искам нещо от теб, този иска нещо от третия човек, а третият човек иска нещо от мен. И попадаме в тройно изчакване, защото всички чакаме, докато другият завърши това, което трябва да направи.
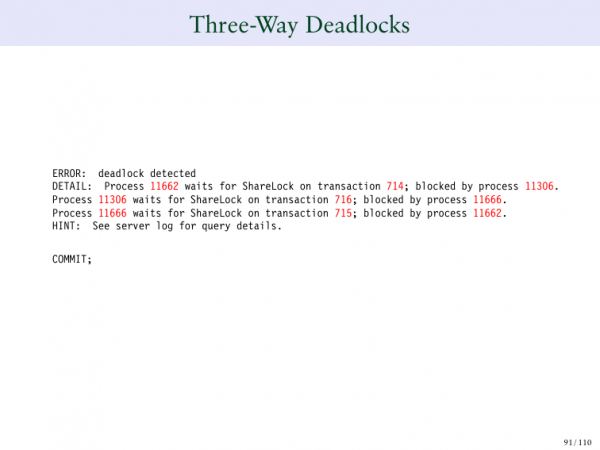
И Postgres знае на кой ред това се случва. И затова той ще ви предостави следното съобщение, което показва, че имате проблем, при който трите входа блокират един друг. И тук няма ограничения. Това може да стане, когато 20 записа блокират един друг.
Следващият проблем – това е сериализуемост.
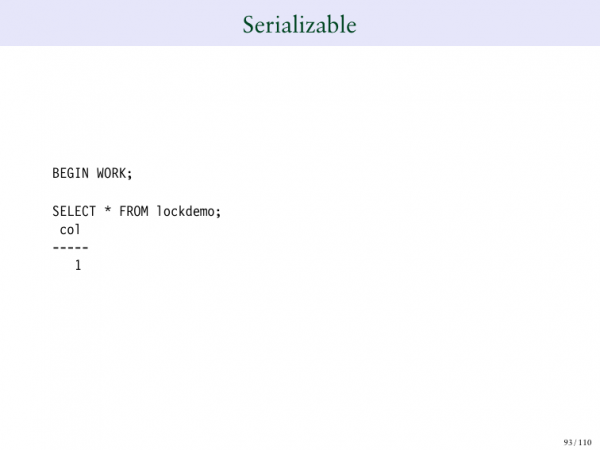
Ако има специална сериализуема блокировка.
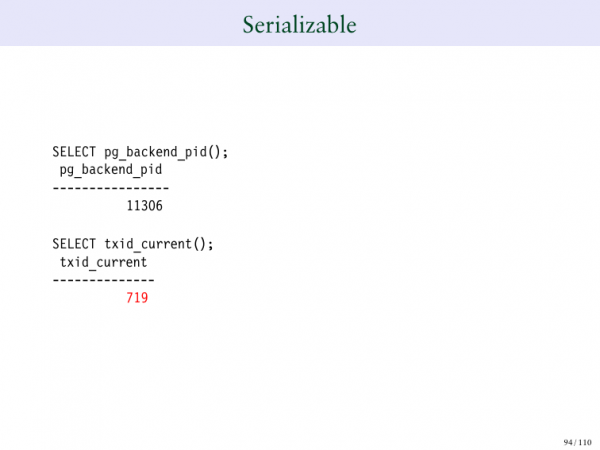
И се връщаме към 719. Той има напълно нормален изход.
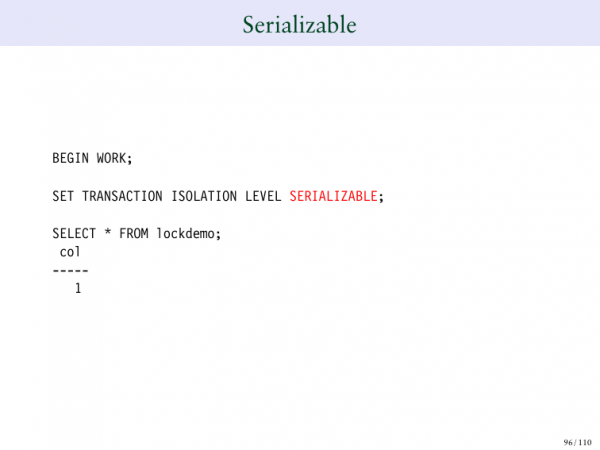
И можете да натиснете, за да направите транзакция от сериализуема.
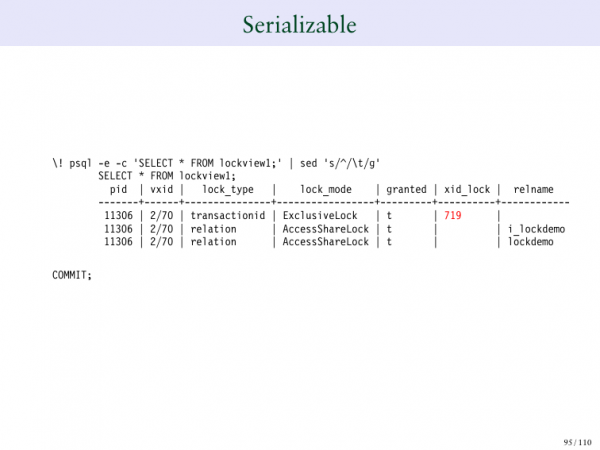
И разбирате, че сега имате друг вид блокировка SA – това означава сериализуемо.
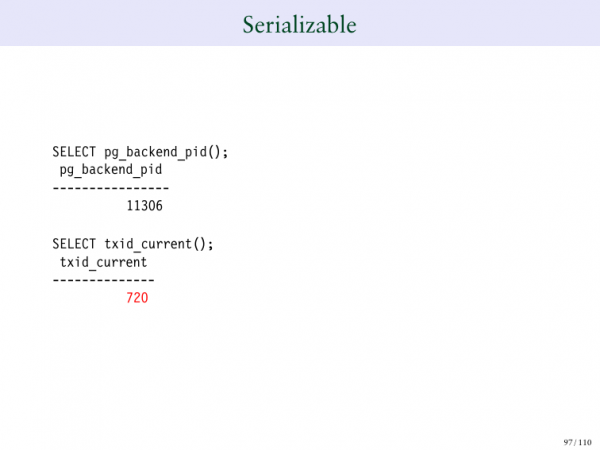
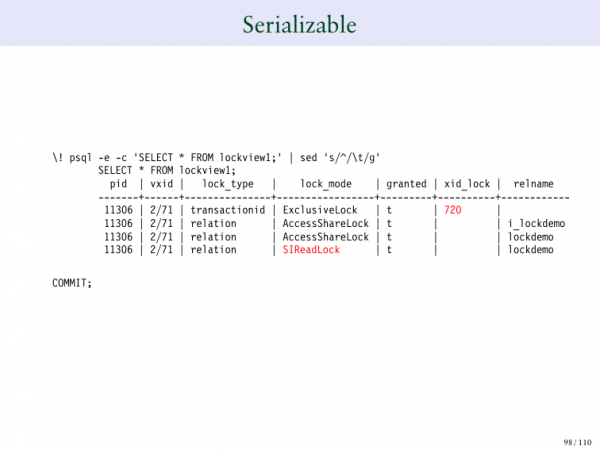
И затова имаме нов вид блокировка, наречена SARieadLock, която е серийна блокировка и позволява въвеждане на серии.
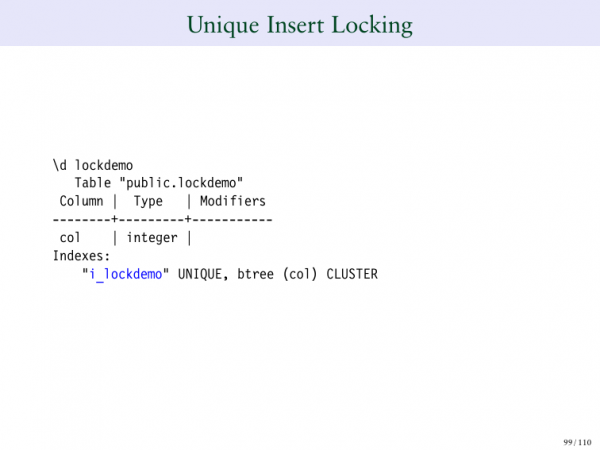
И също така можете да въвеждате уникални индекси.
В тази таблица имаме уникални индекси.
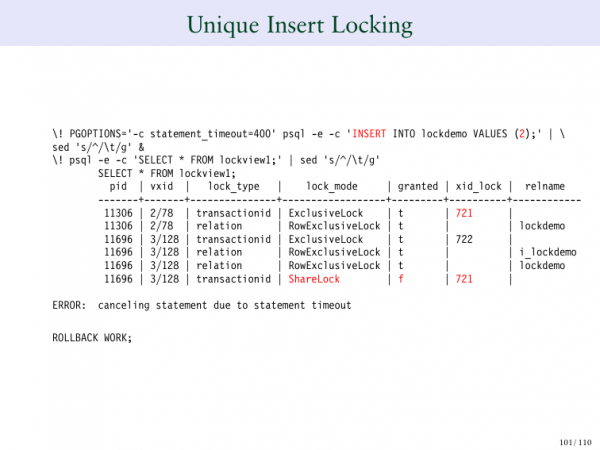
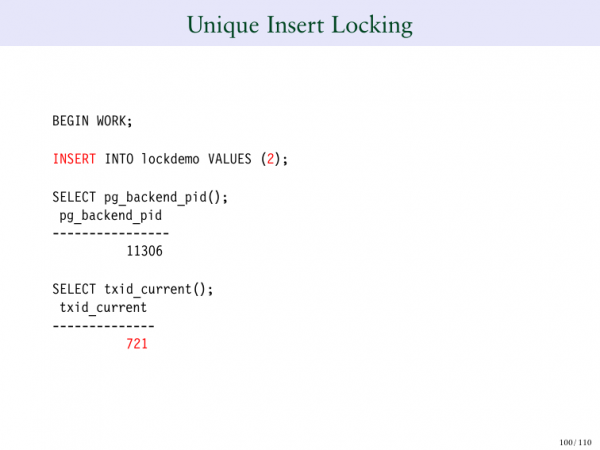
Следователно, ако въведа число 2 тук, следователно имам 2. Но в най-горната част въвеждам още едно 2. И можете да видите, че 721-ви има ексклузивна блокировка. Но сега 722 чака, за да 721 завърши операцията си, защото не може да въведе 2, докато не знае какво ще се случи с 721.
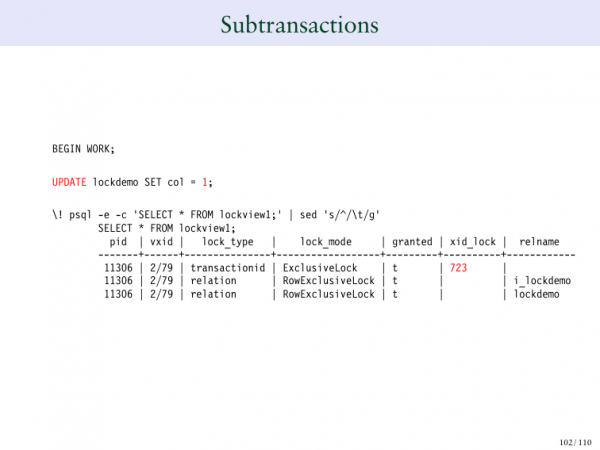
И ако правим субтранзакция.
Ето ни 723.
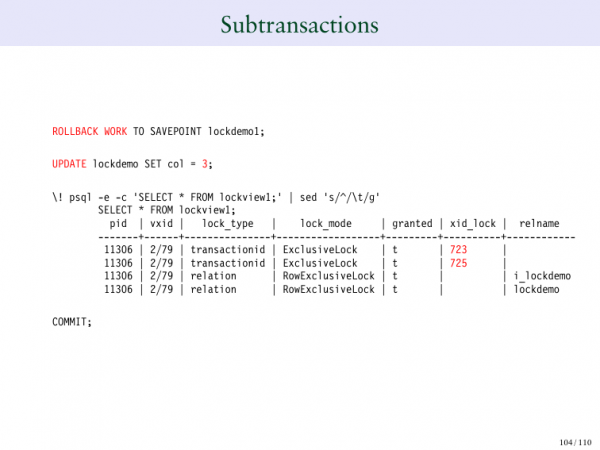
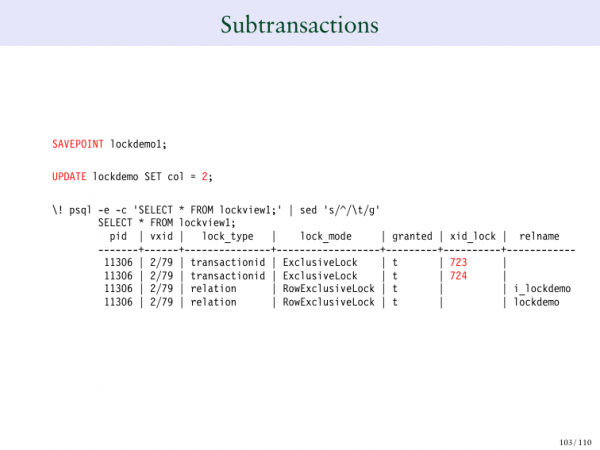
Ако запазим точка и след това я актуализираме, получаваме нов транзакционен ID. Това е още един аспект на поведението, който е важно да знаете. Ако го върнем, транзакционният ID ще изчезне. 724 ще изчезне. Но сега получаваме 725.
Какво се опитвам да направя тук? Опитвам се да ви покажа примери за необичайни блокировки, които можете да срещнете: независимо дали става въпрос за блокировки с serializable или SAVEPOINT - това са различни видове блокировки, които ще се появят в таблицата с блокировки.
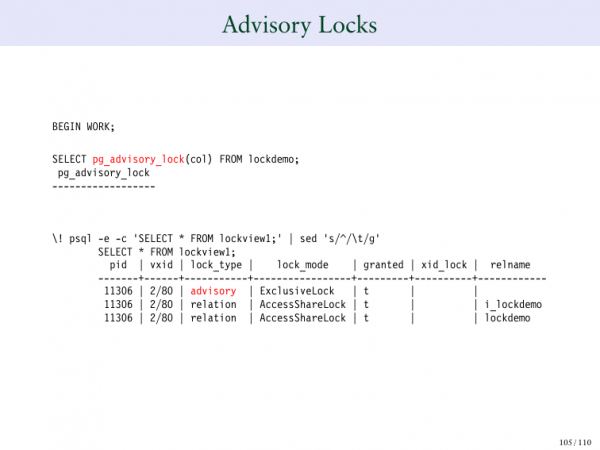
Това е създаването на експлицитни (явни) блокировки, при които имаме pg_advisory_lock.
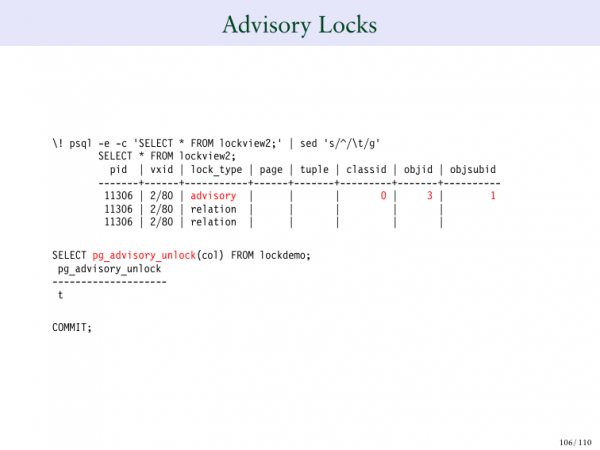
Виждате, че типът на блокировката тук е посочен като advisory. И тук червено е написано «advisory». Можете едновременно да блокирате с pg_advisory_unlock.
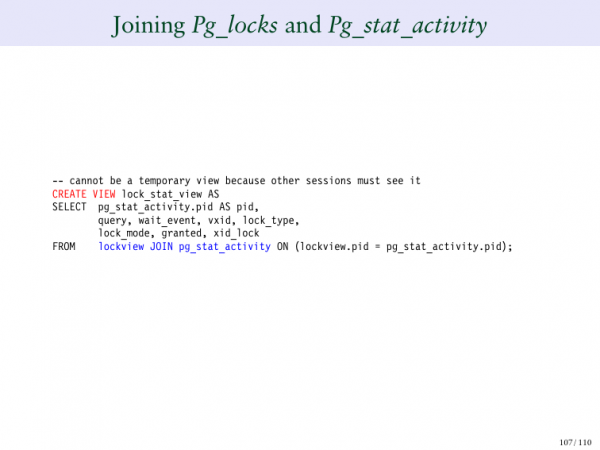
Искам да завърша, като ви покажа още нещо удивително. Ще създам още един вид. Но ще свържа таблицата pg_locks с таблицата pg_stat_activity. Защо искам да направя това? Защото това ми позволява да видя всички текущи сесии и да видя какви точно блокировки очакват. Това е доста интересно, когато комбинираме таблицата с блокировки и таблицата с заявки.
Тук създаваме pg_stat_view.
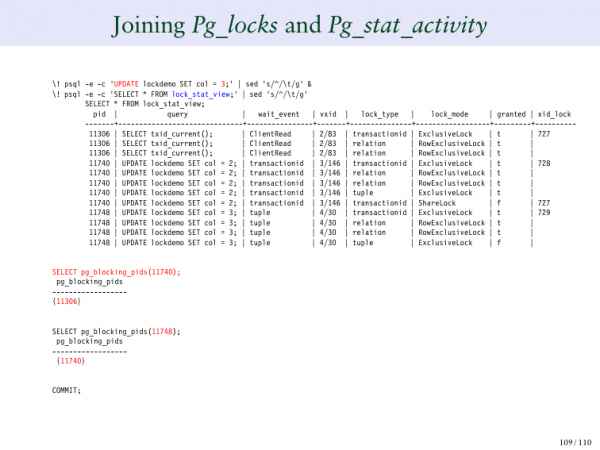
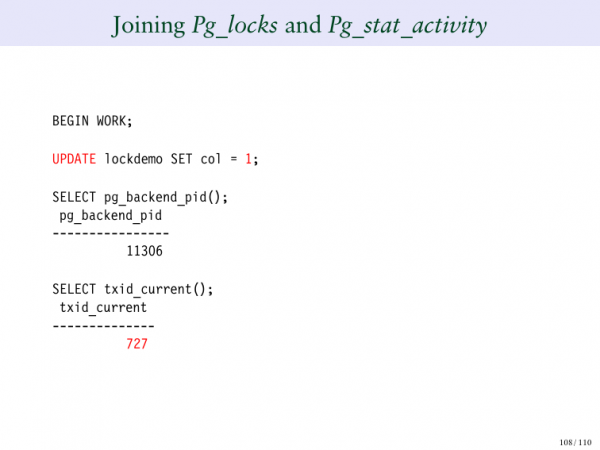
Актуализираме реда с едно. Виждаме 724. След това актуализираме нашия ред до три. Какво виждате тук сега? Това са заявки, т.е. виждате целия списък с заявки, които са изброени в лявата колона. А след това от дясната страна можете да видите блокировките и какво създават. Това може да бъде по-разбираемо за вас, за да не е нужно да се връщате всеки път към всяка сесия и да проверявате – дали трябва да се присъедините или не. Точно това прави.
Още една функция, която е много полезна – е pg_blocking_pidsВероятно, вы никогда о ней не слышали. Что она делает? Она позволяет нам указать, какие именно ID процессов ожидаются для сессии 11740. Вы можете видеть, что 11740 ожидает 724, и 724 находится на самом верху. А 11306 — это ваш ID процесса. По сути, эта функция просматривает вашу таблицу блокировок. Я понимаю, что это немного сложно, но вам удается это понять. Эта функция проходит через таблицу блокировок и пытается найти ваш процесс ID, учитывая блокировки, которые она ожидает. Она также пытается вычислить, какой именно процесс ID у процесса, ожидающего блокировку. Поэтому вы можете запустить эту функцию. pg_blocking_pids.
Это действительно полезно. Мы добавили эту функцию только с версии 9.6, поэтому ей всего 5 лет, но она очень и очень полезна. То же самое касается второго запроса. Он показывает именно то, что нам нужно увидеть.
Это то, о чем я хотел поговорить с вами. Как я и ожидал, мы исчерпали все наше время, поскольку было так много слайдов. Слайды доступны для скачивания. Я хотел бы поблагодарить вас за то, что вы были здесь. Я уверен, вам понравится оставшаяся часть конференции, большое спасибо!
Вопроси:
Например, если я пытаюсь обновить строки, а другая сессия пытается удалить всю таблицу. Насколько я понимаю, в этом случае должен быть какой-то intent lock. Есть ли он в Postgres?
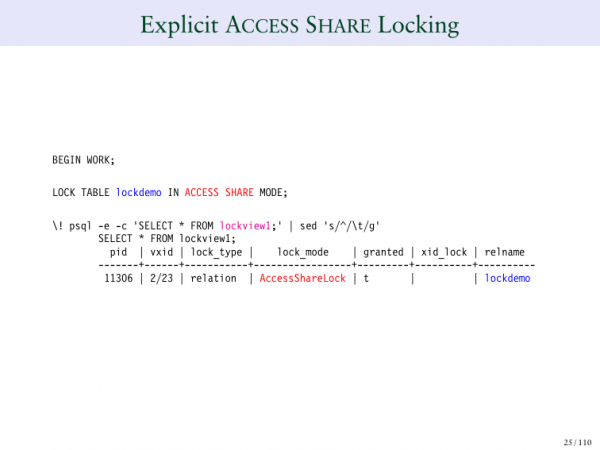
Вернемся к началу. Возможно, вы помните, что когда вы выполняете что-либо, например, делаете SELECT, мы выдаем AccessShareLock. Это предотвращает удаление таблицы. Поэтому если вы хотите обновить строку таблицы или удалить строку, кто-то не сможет удалить всю таблицу одновременно с этим, потому что вы удерживаете AccessShareLock над всей таблицей и строкой. Как только вы закончили, они могут удалить. Но пока вы что-то меняете, они не смогут это сделать.
Давайте повторим. Рассмотрим пример с удалением. Вы видите, что на строке есть эксклюзивный lock над всей таблицей.
Это будет выглядеть как exclusive lock, правильно?
Да, това изглежда така. Разбирам какво казвате. Казвате, че ако направя SELECT, ще имам ShareExclusive, а след това го превеждам в Row Exclusive, дали това ще създаде проблем? Но учудващо, не създава проблем. Изглежда като увеличаване на степента на блокиране, но по същество имам lock, който предотвратява изтриването. И сега, когато правя този lock по-силен, той все още предотвратява изтриването. Така че не е така, че аз се повишавам. Т.е. той предотвратява това и когато е на по-ниско ниво, така че когато увеличавам нивото му, той все още предотвратява изтриването на таблицата.
Разбирам какво казвате. Тук няма случай на увеличение на степента на блокиране, където се опитвате да се откажете от една блокировка, за да вкарате по-мощна. Тук просто глобално увеличава това предотвратяване, така че това не предизвиква никакъв конфликт. Но това е добър въпрос. Благодаря, че го зададохте!
Какво трябва да направим, за да избегнем ситуация на deadlock, когато имаме много сесии, голямо количество потребители?
Postgres автоматично забелязва ситуации на deadlock. И автоматично ще изтрива една от сесиите. Единственото решение, което може да помогне да избегнете ситуация с мъртви блокировки, е да блокирате хората в една и съща последователност. Така че, когато погледнете приложението си, често причината за deadlocks... Нека си представим, че искам да блокирам две различни неща. Едно приложение блокира таблица 1, а друго приложение блокира таблица 2, а след това таблица 1. Най-простият начин да избегнете deadlocks е да прегледате приложението си и да се опитате да се уверите, че блокировката става в една и съща последователност във всички приложения. И това обикновено отстранява 80% от проблемите, защото много различни хора пишат тези приложения. И ако ги блокирате в една и съща последователност, не срещате ситуация на deadlock.
Благодаря ви много за вашето представяне! Говорехте за vacuum full и, ако разбирам правилно, vacuum full деформира реда на записите в отделното хранилище, така че текущите записи остават непроменени. А защо vacuum full взема достъп до ексклузивна блокировка и защо конфликтира с операциите по запис?
Това е добър въпрос. Причината е, че vacuum full взима таблицата. Всъщност създаваме нова версия на таблицата. И таблицата ще бъде нова. Така се получава, че това ще бъде напълно нова версия на таблицата. Проблемът е, че когато го правим, не искаме хората да я четат, защото трябва да видят новата таблица. И затова това се съчетава с предишния въпрос. Ако можехме да четем едновременно, не бихме могли да я преместим и да насочим хората към новата таблица. Щеше да се наложи да изчакаме, за да завършат всички с четенето на тази таблица, и затова всъщност това е ситуация на lock exclusive.
Просто казваме, че блокираме от самото начало, защото знаем, че в края ще ни трябва эксклузивна блокировка, за да преместим всички на новата копия. Така че потенциално можем да разрешим това. И правим това с едновременно индексиране. Но това е много по-сложно за изпълнение. И много от това се отнася до предишния ви въпрос за lock exclusive.
Възможно ли е да добавим locking timeout в Postgres? В Oracle мога, например, да напиша „избери за обновление“ и да изчакам 50 секунди преди обновлението. Това беше добро за приложението. Но в Postgres или трябва да го направя веднага и изобщо да нечакам, или да изчакам до някакво време.
Да, можете да изберете таймаут за вашите блокировки. Можете също така да издавате команда no way, която ще бъде ..., ако не можете веднага да получите блокировка. Така че или lock timeout, или нещо друго, което да ви позволи да го направите. Това не се прави на синтактично ниво. Прави се като променлива на сървъра. Понякога не може да се използва.
Можете ли да отворите 75-ти слайд?
Да.
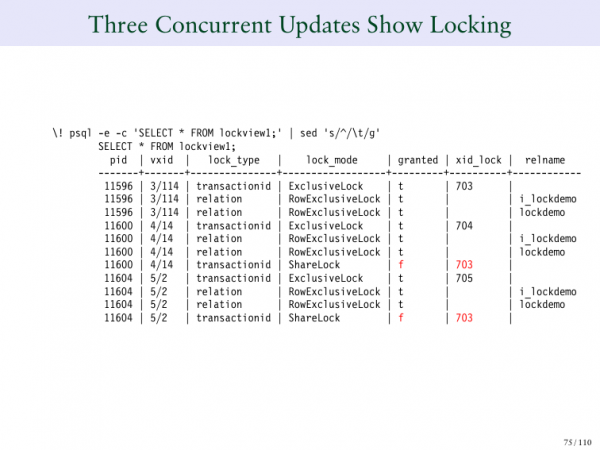
И моят въпрос е следният. Защо двата обновителни процеса чакат 703?
И това е чудесен въпрос. Всъщност не разбирам защо Postgres го прави. Но когато 703 е създаден, той е очаквал 702. И когато се появят 704 и 705, изглежда, че не знаят какво чакат, защото там все още няма нищо. И Postgres го прави така: когато не можете да получите заключване, той пише "Какъв е смисълът да ви обработвам?", защото вие и така чакате някого. Затова просто го оставяме да виси във въздуха, той изобщо не актуализира това. Но какво се случи тук? Веднага щом 702 завърши процеса и 703 получи заключването си, системата се върна обратно. И каза, че сега имаме двама, които чакат. А след това нека да ги актуализираме заедно. И да посочим, че и двамата чакат.
Не знам защо Postgres го прави. Но има проблем, който се нарича f…. Мисля, че това не е термин на български. Това е, когато всички чакат едно заключване, дори когато има 20 инстанции, които чакат за заключване. И изведнъж всички те се събуждат едновременно. И всички започват да се опитват да реагират. Но системата прави така, че всички чакат 703. Защото те всички чакат и ние веднага ги подреждаме на опашка. И ако се появи всяко ново искане, което е било генерирано след това, например 707, то отново ще има празнота.
И ми изглежда, че това се прави, за да може да се каже, че в този момент 702 очаква 703, а всички, които дойдоха след това, нямат никаква записка в това поле. Но щом първият чакащ напусне, всички, които чакали в момента до актуализацията, получават същия маркер. И затова ми се струва, че това е направено, за да можем да обработваме по ред, за да бъдат правилно подредени.
Винаги съм гледал на това като на доста странен феномен. Защото, например, тук изобщо не ги изброяваме. Но ми се струва, че всеки път, когато даваме ново заключване, гледаме на всички, които са в чакателния процес. Тогава всички те се подреждат на опашка. А след това, всеки нов, който идва, попада на опашка само когато следващият човек завърши обработката. Много добър въпрос. Благодаря ви много за въпроса!
Мисля, че е много по-логично, когато 705 очаква 704.
Но проблемата тук е следната. Технически можете да събудите или този, или онзи. И затова ще събудим този или онзи. Но какво се случва в работата на системата? Виждате, как 703 в самия връх блокира собственото си трансакционно ID. Това е начинът, по който работи Postgres. И 703 се блокира от собственото си трансакционно ID, затова, ако някой иска да чака, той ще чака 703. И по същество, 703 завършва. И само след завършването му, някой от процесите се събужда. И не знаем кой точно ще бъде този процес. След това постепенно обработваме всичко. Но не е ясно кой точно процес се събужда първи, защото това може да бъде всеки от тези процеси. По същество, имахме планировчик, който каза, че сега можем да будим всеки от тези процеси. Просто избираме един на случаен принцип. Затова и двата трябва да бъдат отбелязани, защото можем да събудим всеки от тях.
И проблемата е, че имаме CP-безкрайност. И затова е напълно вероятно да можем да събудим по-късен. И ако, например, събудим по-късен, то ще чакаме този, който току-що е получил блокировка, затова не определяме кой точно ще бъде събуден първи. Просто създаваме такава ситуация, и системата ще ги буди в произволен ред.
Има . Вижте, те също са интересни и полезни. Темата, разбира се, е ужасно сложна. Благодаря много, Брюс!
Източник: habr.com
