

Скъпи читатели, добър ден. Днес ще говорим малко за Apache Spark и неговите перспективи за развитие.
В съвременния свят на Big Data, Apache Spark е де факто стандарт при разработването на задания за пакетна обработка на данни. Освен това, той се използва и за създаване на стрийминг приложения, които работят в концепцията на micro batch, обработващи и зареждащи данни на малки порции (Spark Structured Streaming). Традиционно той е част от общия стек Hadoop, използваща YARN като мениджър на ресурсите (или, в някои случаи, Apache Mesos). До 2020 година използването му в традиционния вид за повечето компании е под голямо съмнение поради липсата на добри дистрибуции на Hadoop — развитието на HDP и CDH е спряно, CDH е недостатъчно развит и има висока цена, а останалите доставчици на Hadoop или прекратиха съществуването си, или имат неясно бъдеще. Затова все по-голям интерес от общността и големите компании предизвиква стартирането на Apache Spark с помощта на Kubernetes — с него стандарт в оркестрация на контейнери и управление на ресурси в частни и публични облаци, решава проблема с неудобното планиране на ресурсите на задачите Spark в YARN и предоставя стабилно развиваща се платформа с множество търговски и отворени дистрибуции за компании от всякакъв размер и профил. Освен това, по време на популярността, повечето вече са успели да се сдобият с по една-две инсталации и да натрупат експертиза в използването му, което улеснява преминаването.
Започвайки от версия 2.3.0, Apache Spark получи официална поддръжка за стартиране на задачи в кластера Kubernetes и днес ще говорим за текущата зрялост на този подход, различните варианти на неговото използване и подводните камъни, с които ще се сблъскате при внедряването.
Първо, нека да разгледаме процеса на разработка на задачи и приложения на базата на Apache Spark и да подчертаем типични случаи, при които е необходимо да се стартира задача в клъстер Kubernetes. За подготовката на този пост се използва дистрибуцията OpenShift и ще бъдат посочени команди, актуални за нейния команден инструмент (oc). За други дистрибуции на Kubernetes могат да се използват съответните команди на стандартния команден инструмент Kubernetes (kubectl) или техните аналози (например, за oc adm policy).
Първият вариант на използване — spark-submit
В процеса на разработка на задачи и приложения разработчикът трябва да стартира задачи за отстраняване на проблеми с трансформации на данни. Теоретично за тези цели могат да се използват модули, но разработката с участие на реални (макар и тестови) инстанции на крайни системи е показала, че е по-бърза и качествена в този клас задачи. В случай, че извършваме отстраняване на проблеми на реални инстанции на крайни системи, възможни са два сценария на работа:
- разработчикът стартира Spark задача локално в режим standalone;

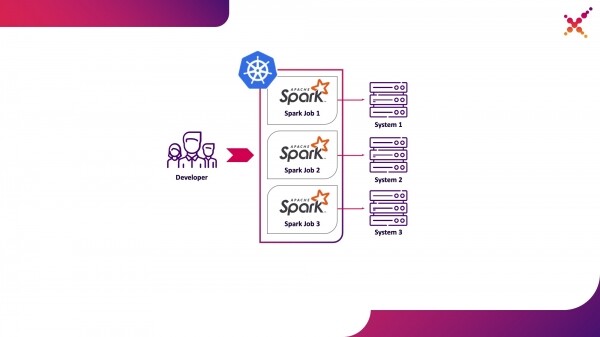
- разработчикът стартира Spark задача в клъстера Kubernetes в тестов контур.
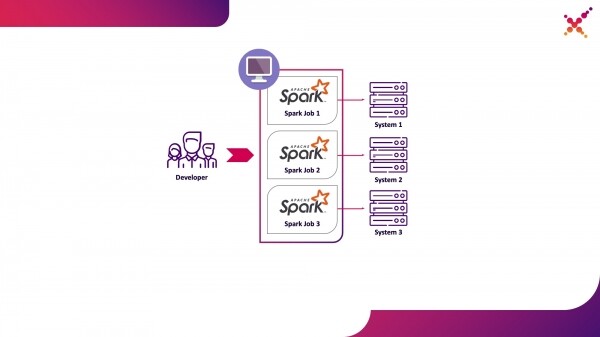
Първият вариант е допустим, но има редица недостатъци:
- всеки разработчик трябва да осигури достъп от работното си място до всички необходими му инстанции на крайни системи;
- на работната машина е необходимо да има достатъчно ресурси за стартиране на разработваната задача.
Вторият вариант няма тези недостатъци, тъй като използването на клъстер Kubernetes позволява да се отдели необходимия пул ресурс за стартиране на задачи и да се осигури необходимият достъп до инстанциите на крайни системи, гъвкаво предоставяйки достъп с помощта на ролевата модел на Kubernetes за всички членове на екипа за разработка. Нека го подчертаем като първия вариант на използване — стартиране на Spark задачи от локалната машина на разработчика в клъстера Kubernetes в тестов контур.
Нека да разгледаме по-подробно процеса на конфигуриране на Spark за локално стартиране. За да започнете да използвате Spark, необходимо е да го инсталирате:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Събираме необходимите пакети за работа с Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
Пълното изграждане отнема много време, но за да се създадут образи Docker и да се стартират на клъстера Kubernetes, в действителност са необходими само jar файлове от директорията «assembly/», затова можем да изградим само този подпроект:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
За да стартирате задачи Spark в Kubernetes, трябва да създадете образ Docker, който да се използва като базов. Тук са възможни 2 подхода:
- Създаденият образ Docker включва изпълнимия код на задачата Spark;
- Създаденият образ включва само Spark и необходимите зависимости, изпълнимият код се разполага на далечно място (например, в HDFS).
Нека първо изградим образ Docker, съдържащ тестов пример на задача Spark. За създаване на образи Docker, Spark разполага с подходяща утилита, наречена «docker-image-tool». Нека разгледаме документацията за нея:
./bin/docker-image-tool.sh --help
С нея можете да създавате образи Docker и да ги качвате в отдалечени хранилища, но по подразбиране тя има редица недостатъци:
- винаги създава 3 образа Docker — за Spark, PySpark и R;
- не позволява да се зададе името на образа.
Затова ще използваме модифицирана версия на тази утилита, представена по-долу:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
С нея ще изградим основния образ Spark, който съдържа тестова задача за изчисляване на числото Пи с помощта на Spark (тук {docker-registry-url} — URL на вашето хранилище Docker, {repo} — името на хранилището вътре в хранилището, съвпадащо с проекта в OpenShift, {image-name} — името на образа (ако се използва трирівнево разделение на образите, например, както в интегрираното хранилище на образи Red Hat OpenShift), {tag} — етикет на тази версия на образа):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Авторизирайте се в клъстера OKD с помощта на конзолната утилита (тук {OKD-API-URL} — URL на API на клъстера OKD):
oc login {OKD-API-URL}
Ще получим токен на текущия потребител за авторизация в Docker Registry:
oc whoami -t
Авторизирайте се във вътрешния Docker Registry на клъстера OKD (като парола използвайте токена, получен от предишната команда):
docker login {docker-registry-url}
Ще качим създадения образ Docker в Docker Registry на OKD:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Нека проверим, дали събраният образ е наличен в OKD. За целта ще отворим в браузъра URL адреса със списъка с образи на съответния проект (тук {project} е името на проекта в клъстера OpenShift, а {OKD-WEBUI-URL} е URL адресът на уеб конзолата на OpenShift) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
За да стартираме задачи, трябва да бъде създаден сервисен акаунт с привилегии за стартиране на подове под root (в следващите глави ще обсъдим този момент):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Ще изпълним командата spark-submit за публикуване на Spark задача в клъстера OKD, указвайки създадения сервисен акаунт и Docker образ:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Тук:
—name — името на задачата, което ще участва в формирането на имената на подовете в Kubernetes;
—class — класът на изпълняемия файл, извикван при стартиране на задачата;
—conf — конфигурационни параметри за Spark;
spark.executor.instances — броят на стартираните екзекютори Spark;
spark.kubernetes.authenticate.driver.serviceAccountName — името на служебния акаунт на Kubernetes, използван при стартиране на подовете (за определяне на контекста на сигурност и възможности при взаимодействие с API на Kubernetes);
spark.kubernetes.namespace — пространството на имена на Kubernetes, в което ще се стартират подовете на драйвера и екзекюторите;
spark.submit.deployMode — начинът на стартиране на Spark (за стандартното spark-submit се използва «cluster», за Spark Operator и по-нови версии на Spark — «client»);
spark.kubernetes.container.image — Docker образът, използван за стартиране на подовете;
spark.master — URL на API Kubernetes (задължително се посочва, когато достъпът е от локалната машина);
local:// — пътят до изпълняемия файл Spark в Docker образа.
Преминаваме към съответния проект в OKD и проучваме създадените подове — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
За опростяване на процеса на разработка може да бъде използван още един вариант, при който се създава общ базов образ на Spark, използван от всички задачи за стартиране, а моментни снимки на изпълняемите файлове се публикуват в външно хранилище (например, Hadoop) и се указват при извикване на spark-submit под формата на линк. В този случай можете да стартирате различни версии на Spark задачи без повторно изграждане на Docker образи, използвайки за публикуване на образи, например, WebHDFS. Изпращаме заявка за създаване на файл (тук {host} е хостът на услугата WebHDFS, {port} е портът на услугата WebHDFS, {path-to-file-on-hdfs} е желаната пътека към файла на HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE"
След това ще получите отговор от вида (тук {location} е URL, който трябва да се използва за качване на файла):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Качваме изпълнимия файл Spark в HDFS (тук {path-to-local-file} е пътят до изпълнимия файл Spark на текущия хост):
curl -i -X PUT -T {path-to-local-file} "{location}"
След това можем да направим spark-submit, използвайки файла Spark, качен в HDFS (тук {class-name} е името на класа, който трябва да се стартира за изпълнение на задачата):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Следва да се отбележи, че за достъп до HDFS и осигуряване на работата на задачата може да се наложи да промените Dockerfile и скрипта entrypoint.sh — да добавите в Dockerfile директива за копиране на зависимите библиотеки в директорията /opt/spark/jars и да включите конфигурационния файл HDFS в SPARK_CLASSPATH в entrypoint.sh.
Вторият вариант за използване е Apache Livy
След това, когато задачата е разработена и се нуждае от тест на получения резултат, възниква въпросът за нейното стартиране в рамките на процеса CI/CD и проследяване на статусите на нейното изпълнение. Разбира се, можем да я стартираме и чрез локален извикване на spark-submit, но това усложнява инфраструктурата CI/CD, тъй като изисква инсталация и конфигурация на Spark на агентите/изпълнителите на CI сървъра и настройки за достъп до API Kubernetes. За този случай е избрано използването на Apache Livy като REST API за стартиране на Spark задачи, разположено вътре в клъстера Kubernetes. С него можете да стартирате Spark задачи на клъстера Kubernetes, използвайки обикновени cURL заявки, което е лесно реализируемо на базата на всяко CI решение, а разположението му вътре в клъстера Kubernetes решава проблема с аутентификацията при взаимодействие с API Kubernetes.
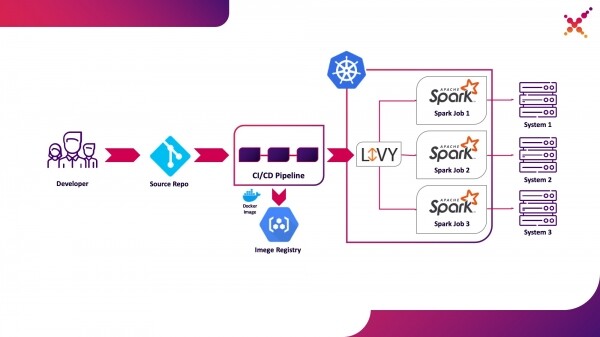
Ще го отделим като втори вариант за използване — стартиране на Spark задачи в рамките на процеса CI/CD на клъстера Kubernetes в тестови контури.
Няколко думи за Apache Livy — той работи като HTTP сървър, предоставящ уеб интерфейс и RESTful API, позволяващ отдалечено стартиране на spark-submit, предавайки необходимите параметри. Традиционно той се предлагаше в състава на дистрибуцията HDP, но също така може да бъде разположен в OKD или всяка друга инсталация на Kubernetes чрез съответния манифест и набор от Docker образи, например този — . За нашия случай беше събран аналогичен Docker образ, включващ Spark версия 2.4.5 от следния Dockerfile:
ОТ java:8-alpine

ENV SPARK_HOME=\/opt\/spark
ENV LIVY_HOME=\/opt\/livy
ENV HADOOP_CONF_DIR=\/etc\/hadoop\/conf
ENV SPARK_USER=spark

WORKDIR \/opt

RUN apk добави --update openssl wget bash &&
    wget -P \/opt https:\/\/downloads.apache.org\/spark\/spark-2.4.5\/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s \/opt\/spark-2.4.5-bin-hadoop2.7 \/opt\/spark

RUN wget http:\/\/mirror.its.dal.ca\/apache\/incubator\/livy\/0.7.0-incubating\/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s \/opt\/apache-livy-0.7.0-incubating-bin \/opt\/livy &&
    mkdir \/var\/log\/livy &&
    ln -s \/var\/log\/livy \/opt\/livy\/logs &&
    cp \/opt\/livy\/conf\/log4j.properties.template \/opt\/livy\/conf\/log4j.properties

ADD livy.conf \/opt\/livy\/conf
ADD spark-defaults.conf \/opt\/spark\/conf\/spark-defaults.conf
ADD entrypoint.sh \/entrypoint.sh

ENV PATH="\/opt\/livy\/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["\/entrypoint.sh"]
CMD ["livy-server"]
Създаденият образ може да бъде събран и качен във вашия съществуващ репозиторий Docker, например, вътрешния репозиторий OKD. За разгръщането му се използва следният манифест ({registry-url} — URL на репозитория на образи Docker, {image-name} — име на образа Docker, {tag} — етикет на образа Docker, {livy-url} — желан URL, на който ще бъде достъпен сървърът Livy; манифестът „Route“ се прилага в случай, че дистрибуцията на Kubernetes е Red Hat OpenShift, в противен случай се използва съответният манифест Ingress или Service тип NodePort):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
След прилагането му и успешно стартиране на пода, графичният интерфейс на Livy е достъпен на следния линк: http://{livy-url}/ui. С помощта на Livy можем да публикуваме нашата Spark задача, използвайки REST заявка, например от Postman. Примерна колекция с заявки е представена по-долу (в масива «args» могат да бъдат предадени конфигурационни аргументи с променливи, необходими за работата на стартираната задача):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Изпратете работа с jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}\nn}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Изпратете работа без jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Нека изпълним първия заявка от колекцията, да отидем в интерфейса на OKD и да проверим, че задачата е стартирана успешно — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. В интерфейса на Livy (http://{livy-url}/ui) ще се появи сесия, в която чрез API Livy или графичния интерфейс можем да следим изпълнението на задачата и да проучваме логовете на сесията.
Сега ще покажем механизма на работа на Livy. За целта ще проучим журналите на контейнера Livy в пода със сървъра Livy — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. От тях е видно, че при извикване на REST API на Livy в контейнера с името „livy“ се изпълнява spark-submit, аналогичен на използвания по-горе (тук {livy-pod-name} е името на създадения под със сървъра Livy). В колекцията е представен и втори заявка, позволяваща стартиране на задачи с отдалечено разполагане на изпълнимия файл на Spark с помощта на сървъра Livy.
Трети вариант за използване — Spark Operator
Сега, когато задачата е тествана, възниква въпросът за нейното редовно стартиране. Нативният начин за редовно стартиране на задачи в клъстера Kubernetes е сущността CronJob и може да се използва, но в момента нарастващата популярност на операторите за управление на приложения в Kubernetes и за Spark съществува достатъчно зрял оператор, който се използва, включително в решения на ниво Enterprise (например, Lightbend FastData Platform). Препоръчваме да го използвате — текущата стабилна версия на Spark (2.4.5) има достатъчно ограничени възможности за конфигуриране на стартиране на задачи Spark в Kubernetes, докато в следващата мажорна версия (3.0.0) е обявена пълна поддръжка на Kubernetes, но датата на нейното излизане остава неизвестна. Spark Operator компенсира този недостатък, добавяйки важни параметри за конфигурация (например, монтиране на ConfigMap с конфигурация за достъп до Hadoop в подовете на Spark) и възможност за редовно стартиране на задачи по график.
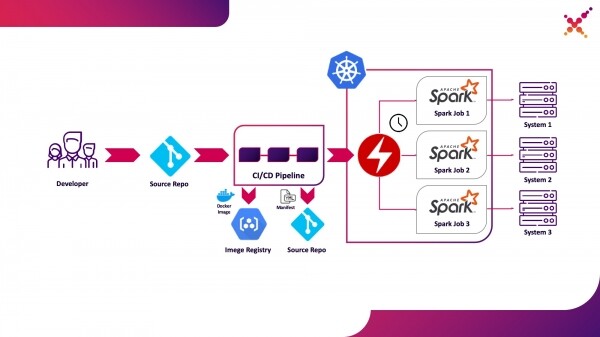
Нека го изведем като трети вариант за използване — редовно стартиране на задачи Spark в кластер Kubernetes в продуктивна среда.
Spark Operator е с отворен код и се разработва в рамките на Google Cloud Platform — . Инсталацията му може да бъде извършена по 3 начина:
- В рамките на инсталацията на Lightbend FastData Platform/Cloudflow;
- С помощта на Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Използването на манифести от официалното хранилище (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). Важно е да се отбележи, че в Cloudflow влизат оператори с версия на API v1beta1. Ако се използва този тип инсталация, описанията на манифестите на приложенията Spark трябва да се основават на примери от таговете в Git с съответната версия на API, например, „v1beta1-0.9.0-2.4.0“. Версията на оператора може да се види в описанието на CRD, включен в оператора в речника „versions“:
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Ако операторът е инсталиран правилно, в съответния проект ще се появи активен под с оператора Spark (например, cloudflow-fdp-sparkoperator в пространството Cloudflow за инсталация на Cloudflow) и ще се появи съответният тип ресурси Kubernetes с името „sparkapplications“. Съществуващите приложения Spark могат да бъдат проучени с помощта на следната команда:
oc get sparkapplications -n {project}
За стартиране на задачи с помощта на Spark Operator е необходимо да се направят 3 неща:
- да се създаде Docker образ, включващ всички необходими библиотеки, както и конфигурационни и изпълними файлове. В целевия случай това е образ, създаден на етапа CI/CD и тестван на тестовия клъстер;
- да се публикува Docker изображение в регистър, достъпен от клъстера Kubernetes;
- да се формулира манифест с тип „SparkApplication“ и описание на стартираната задача. Примери за манифести са налични в официалното хранилище (например, ). Важно е да се отбележат важни моменти относно манифеста:
- в речника „apiVersion“ трябва да бъде посочена версия на API, съответстваща на версията на оператора;
- в речника „metadata.namespace“ трябва да бъде посочено името на пространството, в което приложението ще бъде стартирано;
- в речника „spec.image“ трябва да бъде посочен адресът на създадения Docker образ в достъпен регистър;
- в речника „spec.mainClass“ трябва да бъде посочен класът на задачата Spark, който трябва да бъде стартиран при стартиране на процеса;
- в речника „spec.mainApplicationFile“ трябва да бъде посочен пътят до изпълнимия jar файл;
- в речника „spec.sparkVersion“ трябва да бъде посочена използваната версия на Spark;
- в речника „spec.driver.serviceAccount“ трябва да бъде посочена сервисна учетна записка в съответното пространство на Kubernetes, която ще се използва за стартиране на приложението;
- в речника „spec.executor“ трябва да бъде посочено количеството ресурси, отделяни на приложението;
- В речника «spec.volumeMounts» трябва да бъде посочена локална директория, в която ще се създават локалните файлове на Spark задачата.
Пример за съставяне на манифест (тук {spark-service-account} е сервисен акаунт в Kubernetes клъстера за стартиране на Spark задачи):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:////opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
В този манифест е посочен сервисен акаунт, за който е необходимо преди публикуването на манифеста да се създадат необходими роли, които осигуряват необходимите права за взаимодействие на приложението Spark с Kubernetes API (ако е нужно). В нашия случай приложението изисква права за създаване на Pod’ове. Ще създадем необходимата роля:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Също така е важно да отбележим, че в спецификацията на този манифест може да бъде посочен параметърът «hadoopConfigMap», който позволява да се укаже ConfigMap с конфигурацията за Hadoop без необходимост от предварително поставяне на съответния файл в Docker образа. Той също е подходящ за редовно стартиране на задачи — чрез параметъра «schedule» може да бъде указано разписание за стартиране на тази задача.
След това запазваме нашия манифест в файл spark-pi.yaml и го прилагаме към нашия Kubernetes клъстер:
oc apply -f spark-pi.yaml
При това ще бъде създаден обект от типа «sparkapplications»:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
При това ще бъде създаден pod с приложението, чийто статус ще бъде показан в създаденото «sparkapplications». Може да бъде проверен следващата команда:
oc get sparkapplications spark-pi -o yaml -n {project}
След завършване на задачата POD ще премине в статус «Completed», който също ще се обнови в «sparkapplications». Логовете на приложението могат да бъдат прегледани в браузъра или с помощта на следната команда (тук {sparkapplications-pod-name} е името на pod на стартирания задача):
oc logs {sparkapplications-pod-name} -n {project}
Управлението на задачите Spark може да се осъществи и с помощта на специализирания инструмент sparkctl. За да го инсталираме, клонираме хранилището с изходния код, инсталираме Go и компилираме инструмента:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go -version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Нека да разгледаме списъка с активни Spark задачи:
sparkctl list -n {project}
Нека да създадем описание за Spark задача:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "\/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "\/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "\/tmp"
Нека да стартираме описаната задача с помощта на sparkctl:
sparkctl create spark-app.yaml -n {project}
Нека да разгледаме списъка с активни Spark задачи:
sparkctl list -n {project}
Нека да разгледаме списъка с събития от активната Spark задача:
sparkctl event spark-pi -n {project} -f
Нека да проверим статуса на активната Spark задача:
sparkctl status spark-pi -n {project}
Накрая, нека да разгледаме недостатъците при експлоатацията на текущата стабилна версия на Spark (2.4.5) в Kubernetes:
- Първият и, вероятно, най-значим недостатък е липсата на локализация на данни. Въпреки недостатъците на YARN, имаше и предимства при използването му, например, принципът на доставка на кода до данните (вместо данните до кода). Благодарение на него задачите на Spark се изпълняваха на възлите, където се намираха данните, участващи в изчисленията, и значително намаляваше времето за пренос на данни през мрежата. При използването на Kubernetes се сблъскваме с необходимостта от преместване на данни по мрежата, които са част от изпълнението на задачата. В случай че те са достатъчно големи, времето за изпълнение на задачата може да се увеличи значително, а също така ще е необходимо значително количество дисково пространство, предоставено на екземплярите на задачите Spark за временно съхранение. Този недостатък може да бъде намален чрез използването на специализирани софтуерни средства, осигуряващи локализация на данните в Kubernetes (например, Alluxio), но това фактически означава необходимостта от съхраняване на пълна копия на данните на възлите на клъстера Kubernetes.
- Вторият важен недостатък е сигурността. По подразбиране функциите, свързани с осигуряване на сигурността при стартиране на задачите на Spark, са деактивирани, опцията за използване на Kerberos в официалната документация не е спомената (въпреки че съответните параметри се появиха в версия 3.0.0, което ще изисква допълнителна работа), а в документацията относно осигуряване на сигурността при използване на Spark (https://spark.apache.org/docs/2.4.5/security.html) като хранилища на ключове са посочени само YARN, Mesos и Standalone Cluster. В този контекст потребителят, под който се изпълняват задачите на Spark, не може да бъде указан директно — ние само задаваме служебна сметка, под която ще работи пода, а потребителят се избира в зависимост от настроените политики за сигурност. Въз основа на това се използва или потребителят root, което не е безопасно в продуктивна среда, или потребител с произволен UID, което е неудобно при разпределянето на правата за достъп до данни (което може да се реши чрез създаване на PodSecurityPolicies и тяхното привързване към съответните служебни акаунти). В момента проблемът се решава или чрез поставяне на всички необходими файлове директно в образа на Docker, или чрез модифициране на скрипта за стартиране на Spark за използване на механизма за съхранение и получаване на секрети, приет във вашата организация.
- Стартирането на Spark задачи с Kubernetes все още е в експериментален режим и в бъдеще е възможно значително да се променят използваните артефакти (конфигурационни файлове, основни Docker изображения и стартерни скриптове). И действително — при подготовката на материала бяха тествани версии 2.3.0 и 2.4.5, които показаха значителни разлики в поведението.
Очакваме обновления — наскоро излезе нова версия на Spark (3.0.0), която донесе осезаеми промени в работата на Spark на Kubernetes, но запази експерименталния статус на поддръжката на този мениджър на ресурси. Възможно е следващите обновления действително да позволят напълно да се препоръча отказване от YARN и стартиране на Spark задачи на Kubernetes, без да се притеснявате за безопасността на вашата система и без необходимост от самостоятелно доработване на функционалните компоненти.
Край.
Източник: habr.com
