

В SQL описвате «какво» искате да получите, а не «как» да бъде изпълнено. Затова проблемът с разработването на SQL заявки в стил „както звучи, така и се пише“ заема своето почетно място, наред с .
Днес ще разгледаме на крайно прости примери до какво може да доведе това в контекста на използването на GROUP/DISTINCT и LIMIT заедно с тях.
Ако например в заявката сте написали «първо свържи тези таблици, а след това премахни всички дубликати, трябва да остане само един екземпляр за всеки ключ» — точно така и ще заработи, дори ако свързването изобщо не е било нужно.
И понякога се случва и това «просто работи», понякога — неочаквано се отразява на производителността, а понякога дава напълно неочаквани ефекти от гледна точка на разработчика.
Ами, да, може би не толкова зрелищни, но…
«Сладката двойка»: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Както изглежда, е ясно, че искат да изберат записи X, за които в Y има свързани с изпълняващото се условие. Написали сте заявка през JOIN — получили сте някакви стойности pk по няколко пъти (точно колкото подходящи записи в Y се оказали). Как да ги премахнете? Разбира се DISTINCT!
Особено „радва“, когато за всяка X-запис се намират по няколко стотин свързани Y-записи, а после героично се премахват дубликатите…
Как да го поправите? Първо, осъзнайте, че задачата може да бъде модифицирана до «да изберат записи X, за които в Y има ПОНЕ ЕДИН свързан с изпълняващото се условие» — тъй като от самата Y-запис не ни трябва нищо.
Вложен EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Някои версии на PostgreSQL разбират, че в EXISTS е достатъчно да се намери първата попаднала запис, по-старите — не. Затова предпочитам винаги да указвам LIMIT 1 вътре EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Тази опция позволява при нужда веднага да върне някои данни от намерената свързана Y-запис. Подобен вариант е разгледан в статията .
«Защо да плащате повече»: DISTINCT [ON] + LIMIT 1
Дополнительным преимуществом подобных преобразований запроса является возможность легко ограничить перебор записей, если нужно только одна/несколько из них, как в следующем случае:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Теперь читаем запрос и пытаемся понять, что предлагается сделать СУБД:
- соединяем таблички
- уникализируем по X.pk
- из оставшихся записей выбираем какую-то одну
То есть получили что? «Какую-то одну запись» из уникализованных — а если брать эту одну из неуникализованных результат разве как-то изменится?.. «А если нет разницы, зачем платить больше?»
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- сюда можно подсунуть подходящих условий
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
И точно такая же тема с GROUP BY + LIMIT 1.
«Мне только спросить»: неявный GROUP + LIMIT
Подобные вещи встречаются при разных проверках непустоты таблички или CTE по ходу выполнения запроса:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Агрегатные функции (count/min/max/sum/...) успешно выполняются на всем наборе, даже без явного указания GROUP BY. Только вот с LIMIT они дружат не очень.
Разработчик может думать «вот если там записи есть, то мне надо не больше LIMIT». Но не надо так! Потому что для базы это:
- посчитай, что хотят по всем записям
- отдай столько строк, сколько просят
В зависимости от целевых условий тут уместно совершить одну из замен:
(count + LIMIT 1) = 0наNOT EXISTS(LIMIT 1)(count + LIMIT 1) > 0наEXISTS(LIMIT 1)count >= Nна(SELECT count(*) FROM (... LIMIT N))
«Сколько вешать в граммах»: DISTINCT + LIMIT
SELECT DISTINCT
  pk
FROM
  X
LIMIT $1
Наивный разработчик может искренне полагать, что выполнение запроса остановится, как только мы найдем $1 первых попавшихся разных значений.
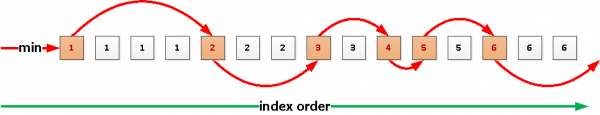
Когда-то в будущем это может так и будет работать благодаря новому узлу Index Skip Scan, реализация которого сейчас прорабатывается, но пока — нет.
Пока что сначала будут извлечены все-все записи, уникализированы, и только уже из них вернется сколько запрошено. Особенно грустно бывает, если мы хотели что-то вроде $1 = 4, а записей в таблице — сотни тысяч…
Чтобы не грустить попусту, воспользуемся рекурсивным запросом :
Източник: habr.com
