

от Санкт Петербург
Здравейте на всички! Аз съм Mons Anderson, архитект на платформата , ще ви разкажа как изградихме нашето S3 хранилище, как работи, какви решения се оказаха успешни и какви бихме променили, ако сега започнем такъв проект от нулата.
Статията е подготвена на основата на доклад на от Mail.ru Cloud Solutions & Tarantool. В статията ще поговорим за:
- как беше организирано хранилището на Mail.ru, върху което изградихме S3 хранилището;
- какво добавихме, за да създадем Mail.ru Cloud Storage;
- как работи обектната модел на хранилото и кои стъпки бяха предприети за пускане в продукция;
- за доработките на производствената система: failover и мащабиране;
- как реализирахме шардирование и решардинг;
- както и за работата с SSL сертификати.
Ако не искате да четете, можете .
Как беше организирано хранилището Mail.ru, върху което изградихме S3 хранилището
Разработката на нашето S3 започна върху хранилището на Mail.ru Cloud, затова е уместно първо да разкажем как е организирано и какви функции предлага.
Облачното хранилище на Mail.ru се състои от сървъри с дискове. В средно модерният storage сървър има 36 диска с по 12–14 терабайта. По-рано дисковете бяха по-малки, но през последните три години капацитетът на дисковете нарасна и днес те разполагат с почти половин петабайт сурови данни.
Диските от различни сървъри в хранилището се комбинират в така наречените „пара“ (pair). Пара е единичен unit за съхранение на файлове. По същество, това е диск, монтиран в определена дяла по определен път, където могат да бъдат съхранявани файлове, идентифицирани с хешове.
Пара е историческо наименование, което е запазено до днешния ден, въпреки че сега в пара не е задължително да има само два диска. Могат да бъдат три диска, а също така могат да съществуват различни хибридни хранилища, например 3/2.
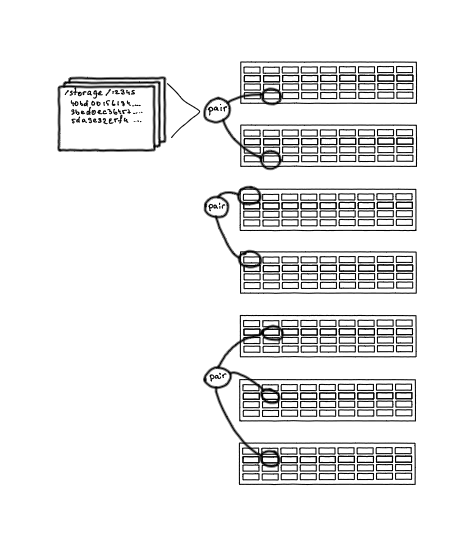
Пара (pair) — единици за съхранение на обекти
Всички пара са съхранени в PairDB — приложение, базирано на Tarantool. Всички бази в нашето хранилище, започвайки от първите, са Tarantool, не използваме други бази.
PairDB съхранява всичките пара, тяхното състояние, свободно място, възможности за отказ, последни грешки. Тя може сама да комуникира с парите, актуализиращу състоянието им, да проверява дали работят или не. Тоест PairDB — обща снимка на състоянието на всички дискове в нашата система.
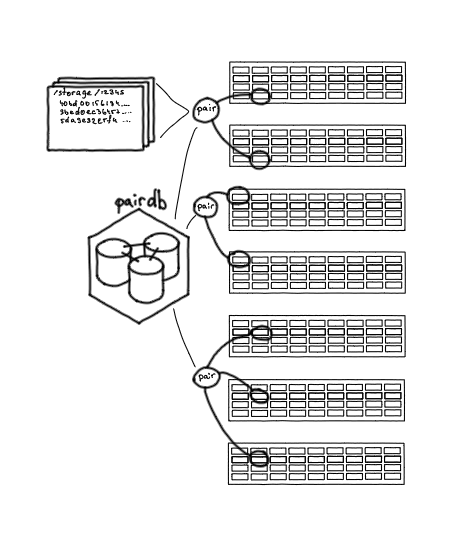
Pair DB: база данни със състоянието на парите
На двойки се съхраняват файлове и, за да знаем на коя двойка се намира кой файл, е нужна още една база – FileDB. Тя съхранява мапинг, определение на съответствието: файл такъв-то се съхранява на двойка такава-то, както и малко количество нужни атрибути.
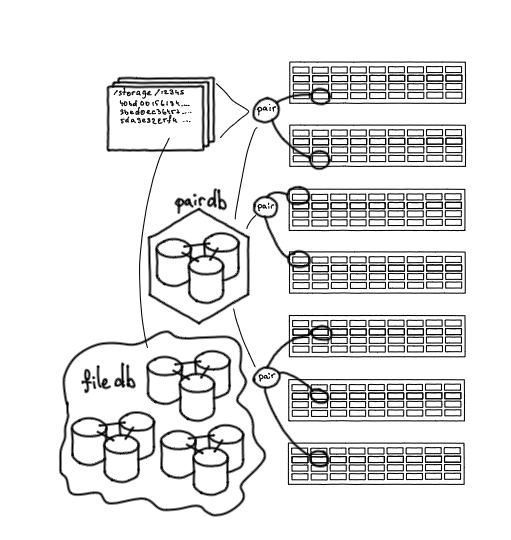 File DB: мястото, където се съхранява файл
Още едно важно звено – услугата Nylon, рутер за работа с бази данни. Той е единна точка за достъп, позволяваща работа чрез единен интерфейс както с PairDB, така и с FileDB. Това е stateless услуга, която извършва балансировка на заявките, разбира на коя шард FileDB трябва да отиде, знае кои двойки са активни, а кои не.
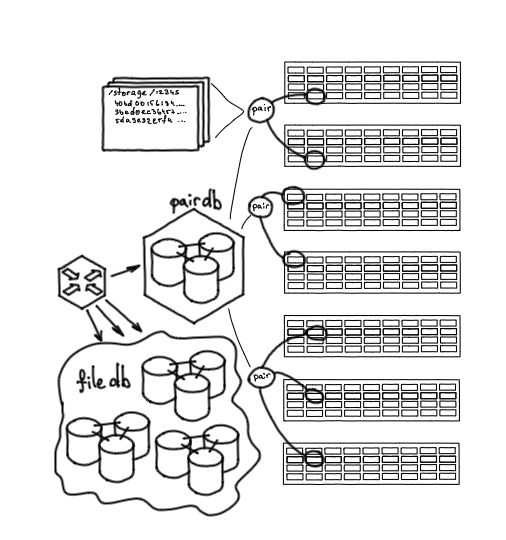
Nylon: рутер за работа с бази данни
Също така в хранилището трябва по някакъв начин да се помещава съдържанието. За това има услуга – Streamer. Тя предоставя два HTTP метода: метод PUT, за да качим съдържание в хранилището, и метод GET, за да го вземем оттам. HTTP е доста популярен и удобен протокол за предаване на данни.
Когато се обърнем към Streamer, той чрез Nylon се обръща към PairDB, установява на коя двойка може да се качи файл, след което предава данните по WebDAV на тази двойка.
В същността си, всеки storage сървър е nginx плюс дискове, които са монтирани на зададени пътища. Можем от Streamer да качим файл в хранилището, да го изтрием, да го променим или да проверим за целостност. Тоест, това е удобен интерфейс за нискоуровнево взаимодействие с хранилището.
Streamer: точка за достъп до хранилището
Какво добавихме, за да направим S3 хранилище
И така, разгледахме общата базова структура на хранилището в момента, когато се подготвяхме за стартиране на S3 хранище. Чрез метода PUT можехме да поставим произволно съдържание там и да получим хеш код като идентификатор на тези данни. С този идентификатор в последствие можеше да се дойде и да се вземе оригиналния файл. Но това не е достатъчно за реализиране на S3. В протокола S3, освен самото съхранение на обекти, има:
- съхранение на метаданни – допълнителни свойства на обектите;
- организация на достъпа до обектите чрез HTTP;
- групиране на обекти в колекции – бакети;
- HTTP-S3 Endpoint. S3 организира данните в определени структури – бакети, всеки от които предоставя точка за достъп за съхранение на файлове.
За реализирането на тази логика беше необходим отделен сервис. Също така искахме веднага да предвидим архитектура за по-нататъшен растеж на сервиса с линейна мащабируемост.
Първоначални компоненти
Демон, реализиращ S3 API. Това е стандартният S3 API на Amazon, който поддържа работа с XML за метаданни и позволява пряко предаване на съдържание. Не ни се наложи да изобретяваме нещо ново, всичко е описано и документирано.
Също така пред сървиса поставихме Nginx. Използвахме го за терминала на SSL, балансиране на натоварването, както и за някои логики на Lua (метрики, логиране и проследяване).
За съхранение на метаданните S3 също избрахме Tarantool. В първата версия демонът S3 прехвърляше метаданните към тази база, а самото съдържание се съхраняваше в голямо хранилище чрез Streamer.
Nginx + S3 API + метаданни
Обектна модел на съхранение
Нека видим как работи S3. Потребителят може да създаде кофа — колекция от обекти. Кофата се адресира с името на хоста и е поддомен на сервиса. В рамките на кофата потребителят може да създава обекти. Идентификаторът на обекта ще бъде URL. Съдържанието на обекта е blob, масив от двоични данни, който ще съхраняваме в хранилището. Също така обектът има атрибути: име — този същия URL, ACL (списък за контрол на достъпа), както и други допълнителни или произволни атрибути — всичко това се запазва в метаданните.
Нормализираната схема на тези данни може да изглежда така: има проекти, на които принадлежат кофите, на които принадлежат обектите, и обектите могат да бъдат съставни. Тъй като един от начините за зареждане на обект е по части, за зареждането има две спомагателни таблици: uploads и chunks. Също така проектите разполагат с автентификационни данни за достъп и фактуриране.
Схема на данните
Тъй като създадохме B2B сервис с платен достъп, то в тази схема беше необходима фактуризация.
Сервизът за фактуриране също реализирахме на Tarantool.
Подобрения на S3 хранилището: стъпки към продукция
Вече направихме работещ модел, който може да се използва: обекти и метаданни бяха съхранявани, но за излизане в продукция липсваха няколко моменти.
Първо, системата за ограничаване на рейт. Ако пуснем услугата без нея, по време на пикова натовареност можем непредсказуемо да пренатоварим някакъв участък от системата. Ограничаването на рейт трябва да работи така: всяко S3-запитване пристига на конкретен хост, този хост е идентификатор на бакета, а бакетът принадлежи на конкретен клиент. Трябва да определим някаква функция от бакета, която да позволи да се изчисли ограничаването на рейт.
Освен това, системата за ограничаване на рейт трябва да бъде достатъчно производителна, за да издържи натоварването, което идва на S3.
Тук отново използвахме Tarantool. Ограниченията на рейт са клъстер от 21 инстанции, инстанциите са разпределени в групи, разнесени на три физически узла и обединени в голям топологичен клъстер. Конфигурационните промени автоматично се разпространяват по него: задават се ограничения на рейт, дефолтни настройки и конфигурация. Всеки бакет се обслужва строго от една инстанция. Когато идва запитване за конкретен бакет, се изчислява инстанцията, отговорна за този бакет. В рамките на този узел се извършва броене на текущия рейд по алгоритъм, подобен на Token Bucket. След това системата за ограничаване на рейт, на базата на текущите показатели на натоварване и свойствата, установени за конкретния бакет, казва дали заявката може да бъде извършена или не. Проверката на ограниченията се извършва в най-ранния етап на изпълнение на S3-запитването, като така се защитава всичките останали елементи на системата от прекомерно натоварване.
Също така под натоварване е доста трудно да се мине без кеш. В S3 се подразбира многократно обръщение към едни и същи обекти, тоест това е горещо хранилище. В обичайния случай обръщението към един файл се обслужва от пълната верига: Streamer, FileDB, PairDB, Storage. Но при многократното обръщение към файла оптимизираме достъпа до съдържанието с помощта на локален кеш.
Кешът е многослоен и е реализиран с помощта на nginx, локални SSD и RAM-дискове. Тук не използвахме Tarantool, защото е по-удобно да се дават обектите от файловата система, така можем да направим тиринг на кеша. Освен това, имаме крупни обекти с максимален размер от 32 гигабайта, а в Tarantool могат да се кешират само малки обекти.
Тази първа система, с която стартирахме, имаше определена капацитет, който бе достатъчен за изследване, разбиране на продукта и осъзнаване, че той ще работи.
Подобрения на системата: фейловер и скалиране
Системата вече беше в употреба, но при старта пропуснахме нещо — нужно бе да добавим фейловер и скалиране.
Нашият S3 демон извличаше метаданни по протокол Tarantool. На мястото на оригиналната база поставихме Tarantool, който служеше като прокси рутер за заявки за метаданни. От гледна точка на приложението, реализирало API, нищо не се промени — то продължи да се свързва с базата по протокол Tarantool, но рутерът успя да осигури активен фейловер. Тоест, успяхме да проверяваме наличността на възела, да изчакваме при превключвания и откази и така нататък. Приложението самото ние не модифицирахме.
Повече за това как реализирахме шардированието
Следващият въпрос, с който трябваше да се заемем, е шардированието. Системата растеше, увеличаваше се количеството на обектите и трябваше да осигурим възможности за бъдещ растеж.
Да се върнем към схемата на данните: имаме проекти, има кошчета, кредити и фактуриране. Това са обекти, които с голяма вероятност в обозримо бъдеще няма да надхвърлят един инстанс нито по обем, нито по заявки. Така че, няма смисъл да ги шардировани, и ние ги изнесохме в отделен инстанс, който ще остане нешердизиран. Това позволява по-консистентно управление на проектите и кошчетата, тъй като има единна нешердизирана точка.
Също така в схемата има обекти, които растат линейно — първоначално имаха стотици хиляди, а в момента количеството им се измерва в няколко милиарда. Такива обекти заедно с техните части трябваше да бъдат преместени в шардирован клъстер.
Схемата я разделихме, но на обектите им трябва да работят с кошчетата: обектът винаги принадлежи на конкретно кошче, плюс на кошчето работи ACL. Поради това за всеки шард с обекти поддържаме сянка на всяко кошче. Освен това, по време на модификация на обектите и изпълнение на заявки, е необходимо да се отчита обем за извършване на фактуриране, затова на всеки шард има брояч от фактурироването.
Също така добавихме още няколко таблици и компоненти:
- коши за унищожаване на стари проекти, които се изтриват или замразяват;
- опашка за фонови задачи, тъй като основното хранилище може да изпълнява фонова работа, която трябва да бъде извършена в клъстера;
- поддръжка на lifecycle — механизъм, който позволява работа с обекти и управление на техния жизнен цикъл.
Тъй като част от данните преместихме на шардове, се появи необходимост от шардирещ прокси. Можеше да се използва рутерът за тази роля, но отделният шардирещ прокси, който отговаря само за шардирването на данни, позволява на рутера да извършва заявки за данни цялостно, без да се беспокои за шардирването.
Поотделно ще обясня защо не избрахме готово решение, а решихме да направим персонализирана функция за шардирване.
Нека разгледаме как е структурирана. Имаме 256 налични шардове. За всеки бакет предвиждаме диапазон с помощта на някаква консистентна функция. Това е просто — както с помощта на консистентна функция определяте принадлежността към един шард, така определяте началния шард и разпределяте диапазона:
f(bucket, shards) = subset
Тоест, можем да кажем, че бакетът и неговите данни винаги ще бъдат в конкретно подмножество от всички шардове. Това позволява да се намали влиянието на един бакет върху другите и да се улесни работата на map-reduce запитванията, когато е необходимо например да направите листинг на обектите в бакета. За целта е нужно да се запитат всички шардове, където се съхраняват тези обекти. Ако обектите бяха разположени на всички шардове, всеки листинг би засегнал цялата система, а тук засяга само конкретно подмножество.
Следва — всеки обект принадлежи на конкретен бакет, така че когато искаме да достъпим обект, го правим по име в конкретен бакет. Тоест можем да определим функция за обекта не от целия наличен диапазон шардове, а само от подмножество на неговия бакет:
f(object, subset) = shard
Вземаме конкретен обект, предаваме подмножество на неговия бакет като аргументи на функцията — и получаваме конкретен шард.
И така, шардирването е реализирано, имаме шардирещ прокси. Остава само да извършваме заявки от рутера и базата с метаданни към шардирещия прокси. Например, за създаване на обекти на тенекии — когато създаваме бакет, основното хранилище трябва да създаде представител на този бакет на всички шардове, на които той трябва да присъства.
Как реализирахме решардирането
Най-големият проблем на шардинга е повторното шардиране. Беше важно да го направим без временно спиране на системата, тъй като тя вече работеше в продукция. Ще покажа как решихме проблема на базата на подобна задача с живата миграция на данни от един проект в друг.
По-долу е схемата на нашия кластер, който получихме след внедряването на шардинг. Имаме nginx, S3 API, рутер, основна база с проекти, шардирующ прокси и самите шардове.
По-горе пропуснах да спомена, че на определен етап от проекта имаше продуктова задача: "Да стартираме още едно хранилище, Icebox, - като Hotbox, но за студени данни". По същество, същото хранилище, но на различни URL адреси и без кеширане.
Icebox се използваше по-малко от Hotbox, затова доста дълго време работеше без никакво шардиране. В крайна сметка решихме да се откажем от него и да комбинираме Hotbox и Icebox в един сервис, просто разделяйки класовете на съхранение.
Контейнерите в хранилищата не взаимодействаха, лесно можеха да бъдат слети и прехвърлени, но клиентите ползваха и двете хранилища, така че трябваше да решим проблема с отсъствието на временно спиране. Не можеше просто да изключим и копираме. Направихме миграция на няколко етапа.
Първо синхронизирахме основните хранилища. Имахме Tarantool и можехме при създаване на обект да направим следното:
- към базата постъпва заявка за създаване на контейнер, например в Hotbox;
- Tarantool проверява в друга база (в случая - в Icebox), дали такъв контейнер не съществува;
- ако контейнерът съществува, базата казва, че не може да бъде създаден и той е синхронизиран като съществуващ.

Синхронизация на контейнерите
В хранилището, което трябваше да приема всички данни, добавихме за проектите и контейнерите признак, който показва къде се съхранява този обект. Той можеше да се съхранява локално, тоест в Hotbox, в Icebox - в такъв случай няма данни от него в новото хранилище, или можеше да бъде в състояние на миграция.
Ако проектът или контейнерът имаше признак Migrating, то по време на миграцията заявката се изпълняваше първо в новото хранилище, в което данните трябва да се намират, а ако ги нямаше там, заявките бяха пренасочвани към алтернативното хранилище.
След това прехвърлихме трафика. Тъй като API можеше да обслужва и заявки от Icebox, и от Hotbox, успяхме без временно спиране да прехвърлим трафика, просто прехвърляйки хостовете и добавяйки съответните записи в Nginx.
След като трафикът беше пренасочен, Nginx и ICEBOX API можеха да бъдат премахнати.
След това премахнахме Icebox nginx и S3 API — и всичко проработи:
След това стартирахме фонов процес на миграция, който работи вътре в базата — обходи елемент по елемент всички проекти и техните бакети, зададе им статус Migrating, премести данните и след завършване на прехвърлянето зададе статус Local.
След прехвърлянето на данните вече не ни е необходимо старото хранилище, и така премахваме останалите части от старата система, както и премахваме поддръжката на статус на миграция от кода.
По същите принципи беше извършено и решардирането от старото хранилище в шардировното:
- Пометихме всички бакети като
Non-sharded. Всички заявки към тях отиваха в оригиналното, нешардировано хранилище. - Новите бакети се създаваха веднага в статус
Sharded. - . Взимахме бакетите един по един, задавахме статус
Migratingи прехвърляхме данните.
Заявките се обслужваха по принципа:
- Четем от новото, след това от старото.
- Създаваме само в новото.
- Актуализираме двуфазно: ако в новото няма, прехвърляме от старото в новото, след това актуализираме.
Работа с SSL сертификати
На фронтенда използваме Nginx. В нашия случай това не е обикновен Nginx, а OpenResty, Nginx с поддръжка на LuaJIT.
Още един компонент от системата — работа с SSL сертификати. В S3 хранилището можете да зададете собствен домейн за достъп до конкретен бакет, просто с помощта на CNAME. Но без HTTPS днес не може: собствен домейн предполага собствен SSL сертификат.
Както вече споменах, за балансировката и терминацията на SSL отговаря Nginx. В нашия случай това не е обикновен Nginx, а OpenResty, Nginx с поддръжка на LuaJIT.
Това ни позволи доста лесно да научим нашия Nginx да предоставя произволни сертификати. Важно е да се отбележи, че трябваше да предоставяме сертификати динамично (без необходимост от записването им в конфигурационен файл). Използвахме разширението ssl_certificate_by_lua, което позволява прочитане на сертификат от произволен източник директно по време на TLS хендшейк. Като хранилище за сертификати също така използвахме Tarantool: това позволява управление на сертификатите отвън и осигурява изключително бърза отдача.
Също така беше реализиран отделен демон, чиято задача е редовно обновяване на сертификатите, които са издадени с помощта на Let’s Encrypt.
Какво бих запазил и какво бих направил по-различно, ако трябваше да разработя хранилище от нулата.
Какво трябваше да се използва от самото начало.
Шардинг от самото начало.. Донесохме доста проблеми с решардинга. Лесно е да се направи, но, в крайна сметка, ако стартирате проекти, които трябва да се мащабират, е по-добре веднага да се вземе шардируем клъстер, дори и с минимален брой възли. Реализацията на шардинга от самото начало е почти безплатна в сравнение с внедряването на шардинга в работеща система.
Работа с Tarantool чрез балансириции.. В момента свързваме всички нови бази директно в работа чрез балансириции. Това позволява разширяване на функционалността и постигане на по-висока устойчивост на отказ.
Автофейловер.. Би инсталирал всички инструменти, необходими за автофейловера, тъй като първоначалните неуспехи след старта бяха свързани с липсата му. След опита с S3, всички следващи продукти бяха стартирани с оглед на това.
Функция S3 „Версиониране”.. Първоначално изглеждаше, че това не е много търсена функционалност. Интегрирането на тази възможност в архитектурата на работеща система е изключително трудно.
Отделно фактуриране.. Начинът, по който интегрирахме фактурирането в нашата система, показа добри резултати в началото, но впоследствие то започна да пречи; по-добре щеше да е да го направим като напълно отделна услуга.
Какво беше удачно решение.
Модел на данни.. Историята показа, че с развитието на услугата се съвпадахме доста точно с модела на данни на Amazon, така че можем да реализираме функциите, които съществуват там.
Схема на шардироване.. Щях да поддържам същите диапазонни шардове по кошнички, тъй като това позволява добре да се разпределят заявките от различни кошнички по голям клъстер.
Използване на Tarantool.. Tarantool много помогна при развитието на услугата и модификацията й, лесно работихме с данните, трансформирахме и шардированных хранилища, без да е нужно да преминаваме на слоя на приложението.
Тази презентация за първи път прозвуча на от Mail.ru Cloud Solutions&Tarantool. Вижте други изказвания и се абонирайте за анонсите на събитията в Telegram .
Също така можете да видите моя стар доклад за S3 или да прочетете статията на моя колега за блочната памет.
- .
- .
Източник: habr.com
