

Здравейте! Аз съм Николай Голов. По-рано работих в Авито и шест години ръководих Data Platform, т.е. се занимавах с всички бази: аналитични (Vertica, ClickHouse), поточни и OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). През това време се запознах с множество бази данни — най-различни и необичайни, и със нестандартни случаи на тяхното използване.
Сега работя в ManyChat. По същество това е стартъп — нов, амбициозен и бързо растящ. Когато за първи път пристигнах в компанията, възникна класическият въпрос: „Какво е най-добре да избере младият стартъп от пазара на СУБД и бази данни?“
В тази статия, основана на моята презентация на , ще отговоря на този въпрос. Видеоверсията на презентацията е налична на .
Общеизвестни бази данни от 2020 година
В момента е 2020 година, огледах се и видях три типа БД.
Първи тип — класически OLTP бази: PostgreSQL, SQL Server, Oracle, MySQL. Те са написани отдавна, но все още са актуални, защото са добре познати на разработчиците.
Втори тип — бази от „нулевите“ години.Те се опитваха да избягат от класическите шаблони, като се отказаха от SQL, традиционни структури и ACID, чрез добавяне на вградени шардирни и други привлекателни функции. Например, това са Cassandra, MongoDB, Redis или Tarantool. Всички тези решения искаха да предложат нещо ново на пазара и намериха своята ниша, защото в определени задачи се оказаха изключително удобни. Тези бази ще обознача с обобщаващия термин NOSQL.
„Нулевите“ години свършиха, нотс SQL базите станаха познати, и светът, от моя гледна точка, направи следващата стъпка — към управлявани бази. Основата им е същата като при класическите OLTP бази или новите NoSQL. Но те нямат нужда от DBA и DevOps и работят на управляван хардуер в облаците. За разработчика това е „просто база“, която работи някъде, а как е инсталирана на сървъра, кой е конфигурирал сървъра и кой го обновява, никого не интересува.
Примери за такива бази:
- AWS RDS — управлявана обвивка над PostgreSQL/MySQL.
- DynamoDB — AWS аналог на документна база, подобен на Redis и MongoDB.
- Amazon Redshift — управлявана аналитична база.
В основата си това са стари бази, но разположени в управлявана среда, без необходимост от работа с хардуер.
Забележка. Примерите са взети за среда AWS, но техните аналози съществуват и в Microsoft Azure, Google Cloud или Yandex.Cloud.
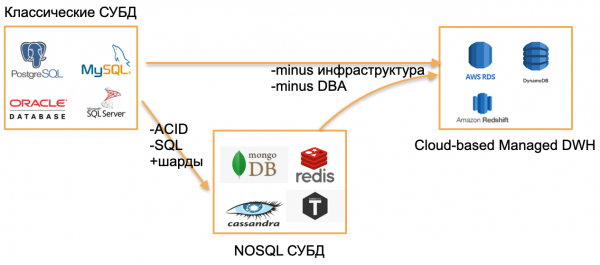
Какво е новото в това? През 2020 година нищо от това.
Концепция Serverless
Наистина ново на пазара през 2020 година — това са serverless или безсървърни решения.
Ще се опитам да обясня какво означава това с примера на обикновен сервис или бекенд приложение.
За да разположим обикновено бекенд приложение, купуваме или наемаме сървър, копираме кода на него, публикуваме навън endpoint и редовно плащаме за наем, електричество и услуги на дата центъра. Това е стандартната схема.
Има ли друг начин? С безсървърни услуги е възможно.
В чем е трикът на този подход: няма сървър, няма дори наемане на виртуален инстанс в облака. За да разположим услугата, копираме кода (функции) в репозитория и публикуваме навън endpoint. След това просто плащаме за всеки извик на тази функция, напълно игнорирайки хардуера, на който тя се изпълнява.
Ще се опитам да илюстрирам този подход с картинки.
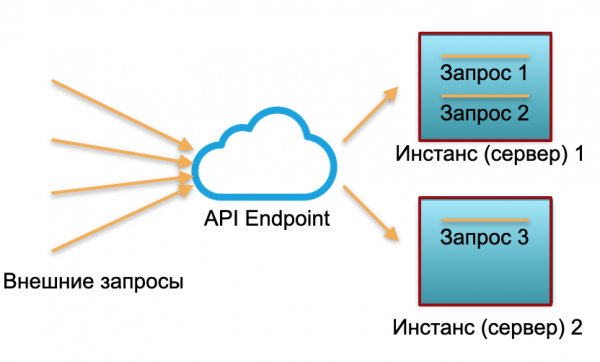
Классически деплой. Имаме сервис с определено натоварване. Повдигаме два инстанса: физически сървъри или инстанси в AWS. Външните заявки се насочват към тези инстанси, които ги обработват.
Както се вижда на картинката, сървърите са използвани неравномерно. Един е използван на 100%, там имаме две заявки, а един е само на 50% — частично просто стои. Ако дойдат не три заявки, а 30, цялата система не може да се справи с натоварването и започва да забавя.
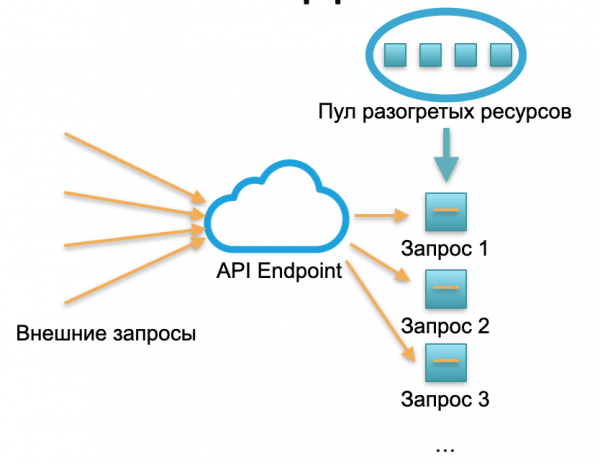
Безсървърен деплой. В безсървърна среда, подобен сервис няма инстанси и сървъри. Има някакъв набор от загряти ресурси — малки подготвени Docker контейнери с разположен код на функцията. Системата получава външни заявки и за всяка от тях безсървърният фреймворк повдига малък контейнер с кода: обработва точно тази заявка и убива контейнера.
Една заявка — един повдигнат контейнер, 1000 заявки — 1000 контейнера. А разполагане на железни сървъри — това е вече работа на облачния доставчик. То е напълно скрито от безсървърния фреймворк. В тази концепция плащаме за всеки извик. Например, ако дойде един извик на ден — плащаме за един извик, ако дойде милион за минута — плащаме за милион. Или за секунда, и такова също се случва.
Концепцията за публикуване на безсървърна функция е подходяща за stateless услуга. Но ако ви е необходим (state) statefull сервиз, добавяме база данни към услугата. В такъв случай, когато става въпрос за работа с state, всяка statefull функция просто записва и чете от базата данни. А базата данни може да бъде от който и да е от трите описани типа в началото на статията.
Какво е общото ограничение на всички тези бази? Това са разходите за постоянно използван облачен или физически сървър (или няколко сървъра). Няма значение дали използваме класическа база или managed, независимо дали имаме Devops и администратор, все пак 24 на 7 плащаме за оборудването, електричеството и наема на дата центъра. Ако имаме класическа база, плащаме за master и slave. Ако е силно натоварена шардирна база — плащаме за 10, 20 или 30 сървъра и плащаме постоянно.
Наличието на постоянно резервирани сървъри в структурата на разходите преди се възприемаше като неизбежно зло. Обикновените бази имат и други сложности, като лимити на броя на свързванията, ограничения за мащабирането, георазпределен консенсус — някои от тях могат да бъдат решени в определени бази, но не всички наведнъж и не идеално.
Serverless база данни — теория
Въпросът от 2020 година: може ли и база данни да бъде serverless? Всички чуха за serverless бекенд… а да пробваме и базата данни да я направим serverless?
Това звучи странно, защото базата данни е statefull услуга, не много подходяща за serverless инфраструктура. Въпреки това, и state на базата данни е доста голям: гигабайти, терабайти, а в аналитичните бази дори петабайти. Не е лесно да се управлява в леки Docker контейнери.
От друга страна, почти всички съвременни бази са огромно количество логика и компоненти: транзакции, споразумяване за целостта, процедури, релационни зависимости и много логика. Достатъчно голяма част от логиката на базата данни изисква само малък state. Гигабайти и терабайти се използват само от малка част от логиката на базата данни, свързана с непосредственото изпълнение на запитвания.
Съответно, идеята е: ако част от логиката допуска stateless изпълнение, защо да не разделим базата на Stateful и Stateless части.
Serverless за OLAP решения
Нека видим как може да изглежда разделяне на базата данни на Stateful и Stateless части с практически примери.
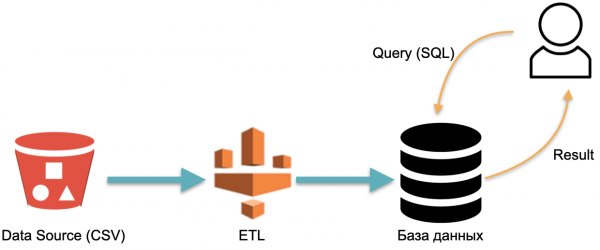
Например, имаме аналитична база данни: външни данни (червен цилиндър вляво), ETL-процес, който зарежда данни в базата, и аналитик, който изпраща SQL заявки към базата. Това е класическата схема на работа на хранилището на данни.
В тази схема, условно, ETL се изпълнява веднъж. След това трябва постоянно да плащаме за сървърите, на които работи базата с данни, заредени чрез ETL, за да имаме къде да изпращаме заявки.
Нека разгледаме алтернативен подход, реализиран в AWS Athena Serverless. Тук няма постоянно резервирано оборудване, на което да се съхраняват заредените данни. Вместо това:
- Потребителят изпраща SQL заявка към Athena. Оптимизаторът на Athena анализира SQL заявката и търси в хранилището на метаданни конкретните данни, нужни за изпълнението на заявката.
- Оптимизаторът, въз основа на събраните данни, извежда нужните данни от външни източници в временно хранилище (временна база данни).
- Във временното хранилище се изпълнява SQL заявка от потребителя, резултатът се връща на потребителя.
- Временото хранилище се изчиства, ресурсите се освобождават.
В тази архитектура плащаме само за процеса на изпълнение на заявката. Няма заявки — няма разходи.
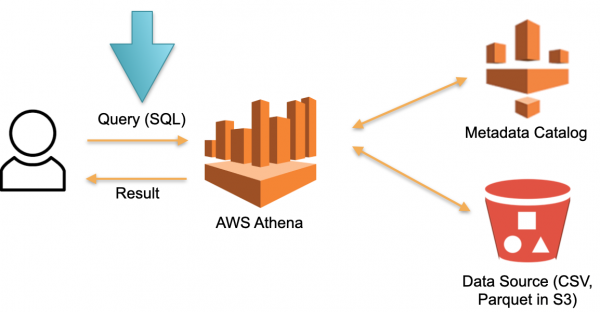
Това е работещ подход и той се реализира не само в Athena Serverless, но и в Redshift Spectrum (в AWS).
На примера на Athena се вижда, че безсървърната база данни работи на реални заявки с десетки и стотици терабайти данни. За стотици терабайти ще са нужни стотици сървъри, но не е нужно да плащаме за тях — плащаме само за заявките. Скоростта на всяка заявка е (много) ниска в сравнение с специализираните аналитични бази като Vertica, но за сметка на това не плащаме за периоди на простои.
Такава база данни е приложима за редки аналитични ad-hoc запитвания. Например, когато спонтанно решим да проверим хипотеза върху огромен обем данни. За тези случаи Athena е идеална. За редовни запитвания такава система става скъпа. В такъв случай кеширайте данните в някакво специализирано решение.
Безсървърни решения за OLTP
В предишния пример разгледахме OLAP задачи (аналитични). Сега ще разгледаме OLTP задачи.
Представете си мащабируем PostgreSQL или MySQL. Нека стартираме обикновен управляван инстанс на PostgreSQL или MySQL с минимални ресурси. Когато инстансът получава повече натоварване, ще свържем допълнителни реплики, на които ще разпределим част от четящото натоварване. Ако няма заявки и натоварване — изключваме репликите. Първият инстанс е майстор, а останалите — реплики.
Тази идея е реализирана в базата, наречена Aurora Serverless AWS. Принципът е прост: proxy fleet приема заявки от външни приложения. Когато забележи ръст в натоварването, той разпределя изчислителни ресурси от предварително прогрети минимални инстанси — свързването се извършва максимално бързо. Изключването на инстансите също става по същия начин.
В рамките на Aurora съществува понятието Aurora Capacity Unit, ACU. Това (в условен смисъл) — инстанс (сървър). Всеки конкретен ACU може да бъде майстор или слейв. Всеки Capacity Unit разполага със собствена оперативна памет, процесор и минимален диск. Съответно, един майстор, останалите са само за четене реплики.
Броят на тези работещи Aurora Capacity Units е конфигурируем параметър. Минималният брой може да бъде едно или нула (в такъв случай базата не работи, ако няма заявки).
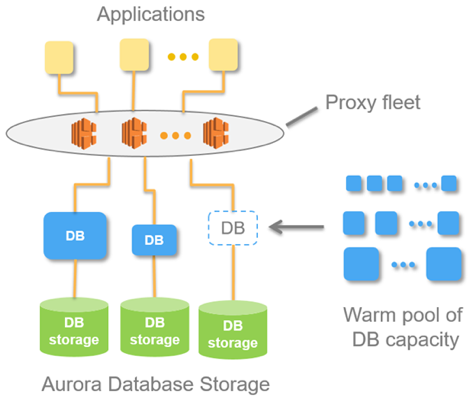
Когато базата получава заявки, proxy fleet стартира Aurora Capacity Units, увеличавайки производителните ресурси на системата. Възможността да се увеличават и намаляват ресурсите позволява на системата да "жонглира" с ресурсите: автоматично да изключва отделни ACU (замествайки ги с нови) и да прилага върху изключените ресурси всички актуални обновления.
Базата Aurora Serverless може да мащабира четящото натоварване. Но в документацията това не е споменато директно. Може да възникне усещането, че могат да поднимат multi-master. Няма никаква магия.
Тази база е подходяща, за да не харчите огромни суми за системи с непредсказуем достъп. Например, при създаването на MVP или маркетингови сайтове-визитки, обикновено не очакваме стабилно натоварване. Съответно, при липса на достъп не плащаме за инстанции. Когато внезапно настъпва натоварване, например след конференция или реклама, тълпи хора влиза в сайта и натоварването рязко нараства, Aurora Serverless автоматично поема това натоварване и бързо свързва липсващите ресурси (ACU). След това конференцията приключва, всички забравят за прототипа, сървърите (ACU) се спират и разходите падат до нула — удобно.
Това решение не е подходящо за стабилно високо натоварване, защото не може да мащабира писменото натоварване. Всички тези свързвания и отключвания на ресурси се случват в момента на така наречената „точка на мащабиране“ — момент, в който базата не е задържана от транзакция, не задържат временни таблици. Например, през седмица точката на мащабиране може и да не се случи, и базата работи на одни ресурси и просто не може нито да се разшири, нито да се свие.
Няма магия — това е обикновен PostgreSQL. Но процесът по добавяне на машини и отключване е частично автоматизиран.
Serverless по замисъл
Aurora Serverless е стара база, пренаписана за облаците, за да използва отделните предимства на Serverless. А сега ще ви разкажа за база, която е написана от самото начало за облаците, по serverless подход — Serverless-by-design. Тя е разработена без предположение, че работи на физически сървъри.
Тази база се нарича Snowflake. В нея има три ключови блока.
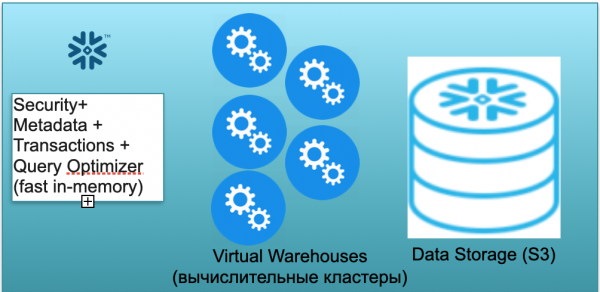
Първият — е блокът с метаданни. Това е бърз in-memory сервис, който решава въпросите със сигурността, метаданните, транзакциите, оптимизацията на заявките (на илюстрацията отляво).
Вторият блок — е множеството виртуални изчислителни клъстери за изчисления (на илюстрацията — набор от сини кръгове).
Третият блок — е система за съхранение на данни на база S3. S3 е безразмерно обектно хранилище в AWS, нещо като безразмерен Dropbox за бизнеса.
Нека разгледаме как работи Snowflake, при предположение за студен старт. Тоест, базата е налична, данните са заредени в нея, няма активни запитвания. Следователно, ако към базата няма запитвания, ние поддържаме бърз in-memory Metadata сървис (първият блок). И имаме S3 хранилище, където се съхраняват данните от таблиците, разделени на така наречените микропартиции. За простота: ако в таблицата има сделки, микропартициите са дни на сделките. Всеки ден е отделна микропартиция, отделен файл. И когато базата работи в такъв режим, плащате само за мястото, заето от данните. Цената за място е много ниска (особено като се вземе предвид значителното компресиране). Сървисът за метаданни също работи постоянно, но за оптимизация на запитванията не се нуждае от много ресурси и сървисът може да се счита условно безплатен.
Сега да представим, че към нашата база е дошел потребител и е отправил SQL запрос. SQL-запросът веднага постъпва за обработка в Metadata сървиса. Следователно, получавайки запитването, този сървиз анализира запитването, наличните данни, правомощията на потребителя и, ако всичко е наред, съставя план за обработка на запитването.
След това сървисът инициира старта на изчислителен клъстер. Изчислителният клъстер е клъстер от сървъри, които извършват изчисления. Тоест, това е клъстер, който може да съдържа 1 сървър, 2 сървъра, 4, 8, 16, 32 — колкото поискате. Изпращате запитване и веднага започва старта на този клъстер. Това наистина отнема секунди.
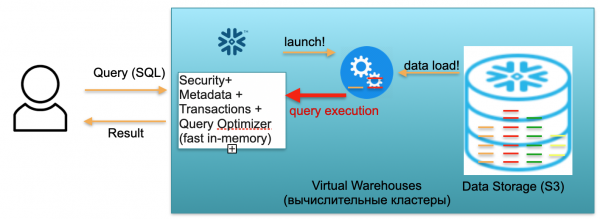
След това, след като кластерът стартира, в кластера от S3 започват да се копират микропартиции, необходими за обработката именно на вашето запитване. Тоест, да предположим, че за изпълнението на SQL запитването са необходими две партиции от едната таблица и едната от втората. В такъв случай ще бъдат копирани само трите нужни партиции в кластера, а не всички таблици накуп. Именно поради това и заради факта, че всичко се намира в рамките на един дата център и е свързано с много бързи канали, целият процес на прехвърляне е много бърз: за секунди, много рядко — за минути, ако не става въпрос за някакви чудовищни запитвания. Съответно, микропартициите се копират в изчислителния клъстер, и, след приключването, в този изчислителен клъстер се изпълнява SQL запитването. Резултатът от това запитване може да бъде един ред, няколко реда или таблица — те се изпращат навън на потребителя, за да ги изтегли, да ги визуализира в BI инструмента си или да ги използва по друг начин.
Всяко SQL запитване може не само да изчислява агрегати от преди заредените данни, но и да зарежда/формира нови данни в базата. Тоест, това може да бъде запитване, което, например, извършва вмъкване на нови записи в друга таблица, което води до появата на нова партиция в изчислителния клъстер, която, от своя страна, автоматично се запазва в единственото S3 хранилище.
Описаният по-горе сценарий, от идването на потребителя до стартирането на клъстера, зареждането на данни, изпълнението на запитвания, получаването на резултати, се заплаща по тарифа за минути използване на активирания виртуален изчислителен клъстер, виртуален warehouse. Тарифата варира в зависимост от зоната на AWS и размера на клъстера, но, в средно, е няколко долара на час. Клъстерът от четири машини е два пъти по-скъп от този с две машини, а клъстерът с осем машини е още два пъти по-скъп. Достъпни са варианти от 16, 32 машини, в зависимост от сложността на запитванията. Но плащате само за онези минути, когато клъстерът наистина работи, защото, когато няма запитвания, вие като че ли слагате ръце настрана, и след 5-10 минути изчакване (настраиваем параметър) той сам ще се изключи, освободи ресурси и ще стане безплатен.
Съвсем реален е сценарият, при който отправяте заявка, клъстерът се активира, условно казано, за минута, следваща минута той изчислява, след това пет минути за изключване, и в крайна сметка плащате за седем минути работа на този клъстер, а не за месеци и години.
Първият сценарий описваше използването на Snowflake в единичен потребителски режим. Сега нека си представим, че има много потребители, което е вече по-близо до реалния сценарий.
Да предположим, че имаме много анализатори и отчети в Tableau, които постоянно бомбардират нашата база с голямо количество несложни аналитични SQL-заявки.
Освен това, да предположим, че имаме изобретателни Data Scientists, които се опитват да правят чудовищни неща с данните, работейки с десетки терабайти, анализирайки милиарди и трилиони реда данни.
За описаните по-горе два типа натоварване Snowflake позволява да се активират няколко независими изчислителни клъстера с различна мощност. И тези изчислителни клъстери работят независимо, но с общи последователни данни.
За голямо количество леки заявки можете да активирате 2-3 малки клъстера, размером условно по 2 машини всеки. Тази функционалност е реализируема, в това число, чрез автоматични настройки. Тоест казвате: «Snowflake, активирай малък клъстер. Ако натоварването му се увеличи над определен параметър, активирай аналогичен втори, трети. Когато натоварването започне да спада — изключи излишните». За да може, независимо от броя на анализаторите, които идват и започват да гледат отчетите, на всички да им стигат ресурсите.
При това, ако анализаторите спят и никой не гледа отчетите — клъстерите могат напълно да спрат работа и вие спирате да плащате за тях.
При това, за тежки заявки (от Data Scientists), можете да активирате един много голям клъстер на условни 32 машини. Този клъстер също ще се заплаща само за тези минути и часове, когато там работи вашият гигантски заявка.
Описаната по-горе възможност позволява да разделяте по клъстери не само 2, но и повече видове натоварвания (ETL, мониторинг, материализиране на отчети,…).
Нека обобщим Snowflake. Базата съчетава красивата идея с работеща реализация. В ManyChat използваме Snowflake за анализ на всички налични данни. Клъстерите ни не са три, както в примера, а между 5 и 9, с различни размери. Имаме условно 16-машинни, 2-машинни и супер-малки 1-машинни за някои задачи. Те успешно разпределят натоварването и ни позволяват да спестяваме значително.
Базата успешно мащабира четящото и пишещото натоварване. Това е огромно предимство и пробив в сравнение с „Аврора“, която само поддържаше четящото натоварване. Snowflake позволява мащабиране на писателското натоварване с тези изчислителни клъстери. Тоест, както споменах, в ManyChat използваме няколко клъстера, малките и супер-малките клъстери се използват основно за ETL, за зареждане на данни. А аналитиците работят на средни клъстери, които не са засегнати от ETL натоварванията, затова работят много бързо.
Съответно, базата е добре пригодена за OLAP задачи. За съжаление, обаче, за OLTP натоварвания тя все още не е приложима. Първо, тази база е колонна, с всичките произтичащи последствия. Второ, самият подход, при който за всяко запитване при необходимост активирате изчислителен клъстер и го запълвате с данни, за съжаление, все още не е достатъчно бърз за OLTP натоварвания. Очакването от секунди за OLAP задачи е нормално, а за OLTP задачи е неприемливо, би било по-добре 100 мс, а още по-добре — 10 мс.
Резюме
Базата данни без сървър е възможна благодарение на разделянето на базата данни на Stateless и Stateful части. Със сигурност сте забелязали, че във всички дадени примери, Stateful частта — това е, условно казано, съхранението на микропартиции в S3, а Stateless — това е оптимизаторът, работа с мета-дата, обработка на въпроси за сигурност, които могат да бъдат активирани като независими леки Stateless услуги.
Изпълнението на SQL запитвания също може да се възприеме като услуги с лек state, които могат да се активират в безсървърен режим, като изчислителните клъстери Snowflake, да изтеглят само нужните данни, да изпълнят запитването и да "угаснат".
Серверлес бази от продакшън клас вече са на разположение и работят. Тези серверлес бази вече са готови да се справят с OLAP задачи. За съжаление, за OLTP задачи те се прилагат... с нюанси, тъй като имат ограничения. От една страна, това е недостатък. Но от друга страна, това е възможност. Може би някой от читателите ще намери начин как OLTP база да стане напълно серверлес, без ограничения Aurora.
Надявам се, че беше интересно. За серверлес бъдещето 🙂
Източник: habr.com
