

Когато става въпрос за продукт, който се развива повече от десет години, напълно нормално е да се срещнат остарели технологии. Но какво става, ако след половин година трябва да поддържате натоварване 10 пъти по-високо, а цената на паденията нараства стотикратно? В този случай ви е необходим страхотен Highload Engineer. Но тъй като такъв не се намери, решаването на проблема беше поверено на мен. В първата част на статията ще разкажа как се преместихме от Redis на Redis-cluster, а във втората част ще дам съвети как да започнете да използвате кластер и на какво да обърнете внимание при експлоатацията.
Избор на технология
Наистина ли е толкова лош отделен Redis (standalone redis) в конфигурация 1 майстор и N слейва? Защо го наричам остаряла технология?
Не, Redis не е толкова лош… Въпреки това, има някои недостатъци, които не могат да бъдат игнорирани.
Първо, Redis не поддържа механизми за аварийно възстановяване след падение на майстора. За решаване на този проблем използвахме конфигурация с автоматично прехвърляне на VIP адреси на нов майстор, промяна на ролята на един от слейвовете и превключване на останалите. Този механизъм работеше, но не можеше да се нарече надеждно решение. Първо, имаше фалшиви срабатывания, а второ, той беше еднократен, и след срабатыването бяха необходими ръчни действия за активиране.
На второ място, наличието само на един майстор водеше до проблема с шардироването. Налагаше се да се създават няколко независими кластера "1 майстор и N слейва", след което ръчно да разпределяме базите по тези машини и да се надяваме, че утре няма да се случи така, че една от базите да порасне толкова, че да се наложи да бъде преместена на отделен инстанс.
Какви са вариантите?
- Най-скъпото и обширно решение е Redis-Enterprise. Това е кутийно решение с пълна техническа поддръжка. Въпреки че изглежда идеално от техническа гледна точка, не ни подхождаше по идеологически причини.
- Redis-cluster. От кутията има поддръжка за аварийно превключване на майстора и шардирование. Интерфейсът почти не се различава от обикновената версия. Изглежда обещаващо, за подводните камъни ще говорим по-късно.
- Tarantool, Memcache, Aerospike и други. Всички тези инструменти извършват приблизително същите функции. Но всеки има свои недостатъци. Решихме да не поставяме всичките си яйца в една кошница. Memcache и Tarantool използваме за други задачи и, преди да продължа, ще кажа, че в практиката ни имаше повече проблеми с тях.
Специфика на използването
Нека разгледаме какви задачи исторически решавахме с Redis и каква функционалност използвахме:
- Кеш преди заявките към отдалечени услуги като 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Кеш преди MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Основно хранилище за услугата за работа със сесии и координати на шофьори | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Както виждате, тук няма нищо сложно. Каква е тогава трудността? Нека разгледаме всеки метод поотделно.
Методът
Описание
Характеристики на Redis-cluster
Решение
GET SET
Записване/четене на ключ
MGET MSET
Записване/четене на няколко ключа
Ключовете ще се намират на различни възли. Готовите библиотеки могат да извършват Multi-операции само в рамките на един възел.
Да заменим MGET с pipeline от N GET операции.
SELECT DB
Да изберем базата, с която ще работим.
Не поддържа няколко бази данни.
Всичко да се съхранява в една база. Да добавяме префикси към ключовете.
SCAN
Да преминем през всички ключове в базата.
Тъй като имаме само една база, преминаването през всички ключове в клъстера е твърде разходно.
Да поддържаме инварианта в рамките на един ключ и да извършваме HSCAN по този ключ. Или да се откажем напълно.
GEO
Операции с геоключа.
Геоключът не се шардиризира.
KEY BY PATTERN
Търсене на ключ по шаблон.
Тъй като имаме само една база, ще търсим по всички ключове в клъстера. Твърде разходно.
Да се откажем или да поддържаме инварианта, както в случая със SCAN.
Redis vs Redis-cluster
Какво губим и какво печелим при прехода към кластер?
- Недостатъци: губим функционалност на няколко бази.
- Ако искаме да съхраняваме логически несвързани данни в един клъстер, ще трябва да правим импровизации с префикси.
- Губим всички операции „по база“, като SCAN, DBSIZE, CLEAR DB и т.н.
- Multi-операциите станаха значително по-сложни за реализация, защото може да изискват достъп до няколко възла.
- Предимства:
- Отказоустойчивост под формата на аварийно превключване на мастера.
- Шардирване на страната на Redis.
- Прехвърляне на данни между възлите атомарно и без престои.
- Добавяне и преразпределение на ресурси и натоварвания без престои.
Бих направил извода, че ако не е необходимо да осигурявате висок уровень на отказоустойчивост, преместването на клъстера не си струва, тъй като това може да бъде сложна задача. Но ако първоначално трябва да изберете между отделна версия и клъстерна, то е по-добре да изберете клъстера, тъй като той не е по-лош и освен това ще свали част от главоболието ви.
Подготовка за преместване
Нека започнем с изискванията за преместването:
- То трябва да бъде безпроблемно. Пълното спиране на услугата за 5 минути не ни устройва.
- То трябва да бъде възможно най-сигурно и постепенно. Искаме да имаме известен контрол над ситуацията. Не желаем да прехвърляме всичко наведнъж и да се молим на бутона за възстановяване.
- Минимални загуби на данни при преместване. Разбираме, че преместването атомарно ще бъде много трудно, затова допускаме известна несъгласуваност между данните в обикновения и клъстерния Redis.
Поддръжка на клъстера
Преди самото преместване трябва да помислим дали можем да поддържаме клъстера:
- Графици. Използваме Prometheus и Grafana за графици на натоварването на процесорите, заета памет, брой клиенти, брой операции GET, SET, AUTH и т.н.
- Експертиза. Представете си, че утре под вашето управление ще бъде огромен клъстер. Ако се повреди, никой освен вас не може да го поправи. Ако започне да забавя — всички ще дойдат при вас. Ако трябва да добавите ресурси или да преразпределите натоварването — отново при вас. За да не почнете да побелявате на 25, е желателно предварително да предвидите тези случаи и да проверите как технологията ще реагира на различни действия. Нека обсъдим това по-подробно в раздела „Експертиза“.
- Мониторинг и уведомления. Когато клъстерът се повреди, искате да разберете първи. Тук се ограничихме до уведомление, че всички възлови точки връщат еднаква информация за състоянието на клъстера (да, понякога е и по друг начин). А останалите проблеми бързо се забелязват по уведомленията на клиентските услуги на Redis.
Пренос
Как ще преместим:
- На първо място, трябва да подготвим библиотеката за работа с клъстера. Като основа за версията на Gо взехме go-redis и направихме малки изменения. Реализирахме Multi-методите чрез pipeline-и и малко коригирахме правилата за повторение на заявки. С версията за PHP се сблъскахме с повече проблеми, но в крайна сметка спряхме на php-redis. Наскоро те внедриха поддръжка на клъстера и според нас това изглежда добре.
- Следващата стъпка е да развернем самия клъстер. Това става буквално с две команди на базата на конфигурационния файл. По-подробно ще обсъдим настройките по-долу.
- За постепенното преместване използваме dry-mode. Тъй като имаме две версии на библиотеката с идентичен интерфейс (една за обикновената версия, друга за клъстера), не е трудно да направим обвивка, която да работи с отделната версия и паралелно да дублира всички заявки в клъстера, да сравнява отговорите и да записва несъответствията в логовете (в нашия случай в NewRelic). По този начин, дори ако версията за клъстера се счупи при внедряването, нашето производствено приложение няма да бъде засегнато.
- При разгръщането на клъстера в dry-режим, можем спокойно да наблюдаваме графиката на несъответствията в отговорите. Ако делът на грешките бавно но сигурно се приближава до някаква малка константа, значи всичко е наред. Защо все пак има несъответствия? Защото записът в отделната версия става малко по-рано, отколкото в клъстера, и заради микроложа данните могат да се разминават. Остава само да проверим логовете за несъответствия, и ако всичките те са обясними с неатомарността на записа, можем да продължим.
- Сега можем да превключим dry-mode в обратна посока. Ще пишем и четем от клъстера, а ще дублираме в отделната версия. Защо? През следващата седмица искаме да наблюдаваме работата на клъстера. Ако случайно се окаже, че при пикова натовареност има проблеми, или сме пропуснали нещо, винаги имаме аварийно връщане към стария код и актуални данни благодарение на dry-mode.
- Остава само да изключим dry-mode и да демонтираме отделната версия.
Експертиза
Първо накратко за устройството на клъстера.
На първо място, Redis е key-value хранилище. Като ключове се използват произволни низове. Като стойности могат да се използват числа, низове и сложни структури. Последните са в голямо количество, но за разбирането на общата структура това не е важно.
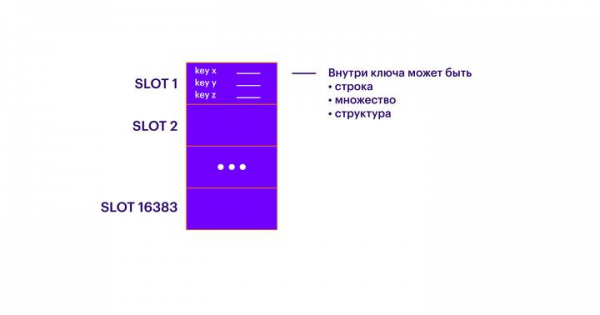
Следващото ниво на абстракция след ключовете са слотите (SLOTS). Всеки ключ принадлежи на един от 16 383 слота. Вътре в всеки слот може да има неограничен брой ключове. По този начин всички ключове се разделят на 16 383 несъединяващи се множества.
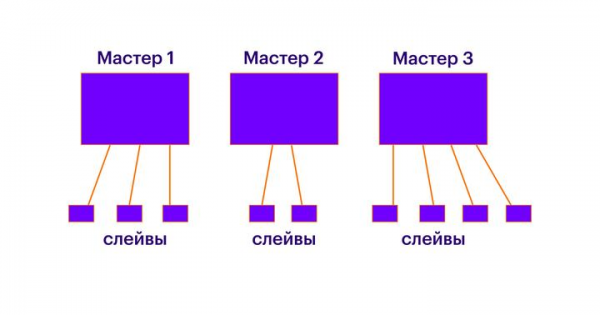
Следващо, в клъстера трябва да има N главни възела. Всеки възел може да се представя като отделен инстанс на Redis, който знае всичко за другите възли в клъстера. Всеки главен възел съдържа определен брой слотове. Всеки слот принадлежи само на един главен възел. Всички слотове трябва да бъдат разпределени между възлите. Ако някои слотове не са разпределени, ключовете, съхранявани в тях, ще бъдат недостъпни. Има смисъл да стартирате всеки главен възел на отделна логическа или физическа машина. Също така, трябва да помните, че всеки възел работи само на едно ядро и ако искате да стартирате няколко инстанса на Redis на една логическа машина, уверете се, че те ще работят на различни ядра (не сме пробвали това, но теоретично всичко би трябвало да работи). По същество главните възли осигуряват обичайно шардирване и по-голямото количество главни възли позволява мащабиране на записите и четенето.
След като всички ключове са разпределени по слотовете, а слотовете по главните възли, към всеки главен възел може да се добави произволен брой слейв възли. Вътре в всяка такава връзка "мастер-слейв" ще работи обикновена репликация. Слейвите са необходими за мащабиране на заявките за четене и за аварийно превключване в случай на повреда на главния възел.
Сега да говорим за операциите, които е хубаво да знаем как да извършваме.
Към системата ще се обръщаме през Redis-CLI. Тъй като Redis няма единна точка на вход, следващите операции могат да се изпълняват на който и да е от възлите. Във всяка точка отделно подчертавам възможността за изпълнение на операцията под натоварване.
- Първото и най-важно, от което ще имаме нужда: операцията cluster nodes. Тя връща състоянието на клъстера, показва списък на възлите, техните роли, разпределението на слотите и т.н. Допълнителни сведения могат да се получат с помощта на cluster info и cluster slots.
- Би било добре да можете да добавяте и премахвате ноди. За това има операции cluster meet и cluster forget. Обърнете внимание, че cluster forget трябва да се прилага на ВСЯКА нода, както на майсторите, така и на репликите. А cluster meet е достатъчно да се извика само на една нода. Това различие може да обезкуражи, затова е по-добре да се запознаете с него преди да стартирате клъстера в експлоатация. Добавянето на нода безопасно се извършва в действие и не засяга работата на клъстера (което е логично). Но ако планирате да премахнете нода от клъстера, трябва да се уверите, че на нея не са останали слотове (в противен случай рискувате да загубите достъп до всички ключове на тази нода). Също така не премахвайте майстор, който има слейвове, иначе ще се извърши ненужно гласуване за нов майстор. Ако на нодите вече няма слотове, това не е голям проблем, но защо да имаме излишна сложност, ако можем първо да премахнем слейвовете.
- Ако трябва насилствено да смените местата на майстор и слейв, можете да използвате командата cluster failover. Извиквайки я в действие, трябва да знаете, че в течение на операцията майсторът ще бъде недостъпен. Обикновено превключването става за по-малко от секунда, но не е атомарно. Можете да се доверите, че част от заявките към майстора в това време ще завършат с грешка.
- Преди да премахнете нод от клъстера, трябва да се уверите, че на нея не остават слотове. Най-добре е да ги преразпределите с помощта на командата cluster reshard. Слотовете ще бъдат пренесени от един майстор на друг. Цялата операция може да отнеме няколко минути, в зависимост от обема на пренасяните данни, но процесът е безопасен и не влияе на работата на клъстера. По този начин, можете да пренесете всички данни от една нода на друга, докато системата е натоварена, без да се притеснявате за техния достъп. Има обаче и тънкости. Първо, пренасянето на данни създава определено натоварване на нодата получател и изпращач. Ако нодата получател е вече силно натоварена по процесор, не трябва да я натоварвате допълнително с прием на нови данни. Второ, веднага щом на майстора-изпращач не останат слотове, всички негови слейвове незабавно ще преминат към майстора, на който тези слотове са били пренесени. Проблемът е, че всички тези слейвове веднага ще искат да синхронизират данните. И ще имате късмет, ако това е частична, а не пълна синхронизация. Вземете това под внимание и съчетавайте операциите по пренос на слотове и изключване/пренос на слейвове. Или се надявайте, че имате достатъчна резервна мощност.
- Какво да правите, ако по време на преноса установите, че някъде сте изгубили слотове? Надявам се, този проблем да не ви засегне, но ако се случи, има операция cluster fix. Тя недохранително разпределя слотовете по нодите на случайна основа. Препоръчвам да проверите функционирането ѝ, преди да премахнете нода с разпределени слотове от клъстера. Тъй като данните в неразпределените слотове така или иначе не са достъпни, вече е късно да се притеснявате за проблеми с достъпа до тези слотове. От своя страна операцията няма да повлияе на разпределените слотове.
- Още една полезна операция е monitor. Тя ви позволява да виждате в реално време целия списък от заявки, които постъпват към нодата. Още повече, по нея можете да направите grep и да проверите дали има необходимия трафик.
Също така следва да споменем за процедурата по аварийно превключване на майстора. Накратко, такава има и, според мен, работи отлично. Въпреки това, не бива да се мисли, че ако извадите щепсела от контакта на машината с майсторския нод, Redis веднага ще превключи и клиентите няма да заметят загуба. От моя опит, превключването отнема няколко секунди. През това време част от данните ще бъдат недостъпни: открива се недостъпност на майстора, нодите гласуват за нов, слейвите превключват, данните се синхронизират. Най-добрият начин да се уверите сами, че схемата работи, е да проведете локални учения. Създайте клъстер на лаптопа си, задайте минимално натоварване, симулирайте срив (например, затваряйки портовете), оценете скоростта на превключването. Според мен, само след като играете по този начин ден-два, можете да бъдете уверени в работата на технологията. Или, или да се надявате, че софтуерът, който ползва половината интернет, със сигурност работи.
Конфигурация
Често, конфигурацията е първото, което трябва да направите, за да започнете работа с инструмента. А когато всичко заработи, не искате да се пипа конфигурацията. Необходима е определена воля, за да се накарате да се върнете към настройките и внимателно да ги прегледате. От моето опит имаме поне два сериозни провала заради невнимание към конфигурацията. Обърнете особено внимание на следните точки:
- timeout 0
Времето, след което неактивните връзки се затварят (в секунди). 0 — не се затварят
Не всяка наша библиотека умееше правилно да затваря връзки. Изключвайки тази настройка, рискуваме да достигнем лимита на броя на клиентите. От друга страна, ако има подобен проблем, автоматичното прекъсване на загубените връзки ще го замаскира и можем да не го забележим. Освен това, не бива да включвате тази настройка при използване на persist-връзки. - Save x y & appendonly yes
Запазване на RDB-снепшота.
Проблемите с RDB/AOF ще обсъдим подробно по-долу. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Ако е включено, при повреда на RDB-снепшота, майсторът спира да приема заявки за промяна. Ако връзката с майстора е изгубена, слейвът може да продължи да отговаря на заявки (да). Или да спре да отговаря (не).
Не сме доволни от ситуация, в която Redis се превръща в тиква. - repl-ping-slave-period 5
След този период от време, ние ще започнем да се притесняваме, че основният сървър е спрял да работи и е време да се проведе процедура за failover.
Ще се наложи ръчно да намерим баланс между фалшивите сработвания и стартирането на failover. Според нашия опит, това е 5 секунди. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Точно толкова данни можем да съхраняваме в буфера за отпадналата реплика. Ако буферът свърши, ще трябва да се синхронизираме напълно.
Практиката подсказва, че е по-добре да зададете по-голямо значение. Има много причини, поради които репликата може да започне да изостава. Ако тя изостава, най-вероятно основният ви сървър вече се справя с трудност и пълната синхронизация ще бъде последната капка. - maxclients 10000
Максималният брой съвременни клиенти.
Според нашия опит, е по-добре да зададете по-голямо значение. Redis прекрасно се справя с 10 хиляди връзки. Просто се уверете, че в системата има достатъчно сокети. - maxmemory-policy volatile-ttl
Правилото, по което се изтриват ключове при достигане на лимита за налична памет.
Тук е важно не самото правило, а разбирането как това ще се случи. Redis може да бъде похвален за способността си да работи нормално при достигане на лимита на паметта.
Проблеми при RDB и AOF
Въпреки че самият Redis съхранява цялата информация в оперативната памет, също така има механизъм за запазване на данни на диск. По-точно, три механизма:
- RDB-снапшот — пълен образ на всички данни. Настройва се с конфигурация SAVE X Y и се чете като „Запазвайте пълен снимка на всички данни на всеки X секунди, ако е променен поне Y ключа“.
- Append-only файл — списък с операции в реда на тяхното изпълнение. Добавя новопостъпили операции в файла на всеки Х секунди или на всеки Y операции.
- RDB и AOF — комбинация от двете предходни.
Всички методи имат своите предимства и недостатъци, няма да изброявам всичките, а само ще обърна внимание на неочевидни, според мен, моменти.
На първо място, за запазване на RDB-снапшота е необходимо да се извика FORK. Ако данните са много, това може да забави целия Redis за период от няколко милисекунди до секунда. Освен това системата трябва да изисква памет за такъв снимка, което води до необходимостта да се поддържа двойна резервна оперативна памет на логичната машина: ако за Redis са предвидени 8 ГБ, то на виртуалната машина с него трябва да има достъпни 16.
На второ място, има проблеми с частична синхронизация. В режима AOF, при повторно свързване на слейва, може да се извърши пълна синхронизация вместо частична. Защо се случва това, не успях да разбера. Но е добре да се помни.
Тези две точки вече ни карат да се замислим дали действително ни трябват тези данни на диска, ако те вече се дублират от слейвовете. Загубата на данни може да се случи само ако всички слейве излязат от строя, а това е проблем от нивото на "пожар в дата центъра". Като компромис може да се предложи да се съхраняват данните само на слейвовете, но в този случай трябва да сме сигурни, че тези слейвове никога не ще станат мастър при възстановяване след авария (за това има настройка за приоритета на слейвовете в конфигурацията им). За себе си ние обмисляме в конкретен случай дали е необходимо да съхраняваме данните на диска и по-често отговаряме "не".
Заключение
В заключение, се надявам, че успях да дам обща представа за работата на redis-cluster на тези, които изобщо не са чували за него, както и да обърна внимание на някои неочевидни моменти за онези, които вече го използват отдавна.
Благодаря за отделеното време и, както обикновено, коментарите по темата са добре дошли.
Източник: habr.com
