

Нека разгледаме концепцията за мониторинг на Kubernetes, да се запознаем с инструмента Prometheus и да поговорим за алъртинг.
Темата на мониторинга е обширна и в една статия не може да бъде изчерпана. Целта на този текст е да даде обзорно представление за инструментите, концепциите и подходите.
Материалът на статията е резюме от . Ако искате да получите пълно обучение, запишете се на курса по .
Какво се мониторира в кластера Kubernetes
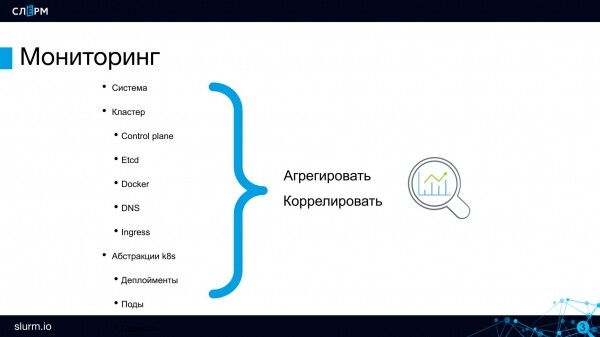
Физическите сервери. Ако кластера Kubernetes е разположен на ваши сървъри, трябва да следите за тяхното здравословно състояние. С тази задача се справя Zabbix; ако работите с него, не е необходимо да се отказвате, конфликти няма да има. Именно Zabbix следи за състоянието на нашите сървъри.
Преминаваме към мониторинга на ниво кластер.
Компонентите на Control Plane: API, Scheduler и други. Най-малкото трябва да следите, за да е повече от 0 API серверите или etcd. Etcd може да предоставя много метрики: за дисковете, на които работи, за здравето на своя кластер и други.
Docker отдавна съществува и проблемите му са добре известни: множеството контейнери предизвикват зависвания и други проблеми. Затова самият Docker, като система, също трябва да се контролира, поне за достъпност.
DNS. Ако в кластерът отпадне DNS, тогава ще отпадне и целият сервис Discovery, и комуникацията между подовете ще спре да работи. В моята практика не е имало подобни проблеми, но това не означава, че не трябва да следите състоянието на DNS. Задържането в заявките и някои други метрики могат да се следят на CoreDNS.
Ingress. Трябва да следите достъпността на ингерси (включително Ingress Controller) като входни точки в проекта.
Основните компоненти на кластерa разгледахме — сега да слезем по-долу, на ниво абстракции.
На пръв поглед приложенията се изпълняват в контейнери, следователно трябва да се наблюдават, но всъщност не е така. Контейнерите са ефимерни: днес работят на един сървър, утре на друг; днес са 10, утре 2. Затова просто контейнерите никой не ги наблюдава. В рамките на микросервисната архитектура по-важно е да се контролира наличността на приложението като цяло. В частност, да се проверява наличността на края на услугата: работи ли нещо? Ако приложението е достъпно, то какво се случва зад него, колко реплики има в момента — тези въпроси са второстепенни. Няма нужда да следите отделни инстанции.
На последното ниво трябва да се контролира работата на самото приложение, да се събират бизнес метрики: брой поръчки, поведение на потребителите и други.
Prometheus
Най-добрата система за мониторинг на клъстера е . Не познавам нито един инструмент, който да може да се сравни с Prometheus по качество и удобство на работа. Той е отлично подходящ за гъвкава инфраструктура, затова, когато говорят за "мониторинг на Kubernetes", обикновено имат предвид именно Prometheus.
Има няколко варианта как да започнете работа с Prometheus: с помощта на Helm можете да инсталирате стандартния Prometheus или Prometheus Operator.
- Стандартният Prometheus. С него всичко е наред, но трябва да настроите ConfigMap — по същество да пишете текстови конфигурационни файлове, както правехме преди, преди микросервисната архитектура.
- Prometheus Operator е малко по-сложен, немного по-сложен по вътрешната логика, но работата с него е по-проста: там има отделни обекти, абстракции, които се добавят в клъстера, затова е много по-удобно да ги контролите и настройвате.
За да разберете продукта, препоръчвам първо да инсталирате стандартния Prometheus. Ще трябва да настроите всичко през конфигурацията, но това ще бъде полезно: ще разберете какво за какво е и как се настройва. В Prometheus Operator веднага се изкачвате на по-висока абстракция, макар че при желание също ще можете да се потопите в дълбочината.
Prometheus е добре интегриран с Kubernetes: може да се обръща към API сървъра и да взаимодейства с него.
Prometheus е популярен, затова много приложения и програмни езици го поддържат. Поддръжката е необходима, тъй като Prometheus има свой формат на метрики и за предаването им е нужна или библиотека в приложението, или готов експортер. И има доста такива експортера. Например, има PostgreSQL Exporter: той взима данни от PostgreSQL и ги конвертира в формат Prometheus, за да може да работи с тях.
Архитектура на Prometheus
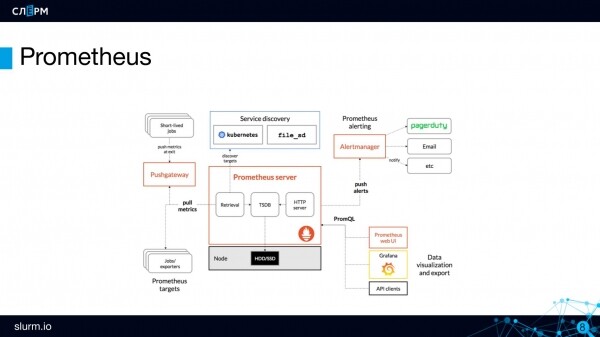
Prometheus Server е сърверната част, мозъкът на Prometheus. Тук се съхраняват и обработват метриките.
Метриките се съхраняват в базата данни за времеви серии (TSDB). TSDB не е отделна база данни, а пакет на езика Go, който е вграден в Prometheus. Грубо казано, всичко се намира в един бинарен файл.
Не съхранявайте данни в TSDB дълго
Инфраструктурата на Prometheus не е подходяща за дълготрайно съхранение на метриките. По подразбиране срокът на съхранение е 15 дни. Може да превишите това ограничение, но трябва да имате предвид: колкото повече данни ще съхранявате в TSDB и колкото по-дълго ще го правите, толкова повече ресурси ще консумира. Съхраняването на исторически данни в Prometheus се счита за лоша практика.
Ако имате огромен трафик, а броят на метриките е стотици хиляди в секунда, по-добре е да ограничите съхранението им по обем диск или срок. Обикновено в TSDB се съхраняват "горещи данни", метрики буквално за няколко часа. За по-дълго съхранение се използват външни хранилища в тези бази данни, които наистина са подходящи за това, например InfluxDB, ClickHouse и т.н. Виждал съм повече положителни отзиви за ClickHouse.
Prometheus Server работи по модела pull: сам търси метриките в тези ендпоинти, които сме му предоставили. Казали сме: "ходи в API Server", и той веднъж на n-о количество секунди отива там и взима метриките.
За обекти с кратка продължителност на живота (job или cron job), които могат да се появяват между периодите на скрапинг, има компонент Pushgateway. В него се изпращат метриките от краткосрочните обекти: job-ът се активира, изпълнява действие, изпраща метрики в Pushgateway и приключва. След известно време Prometheus в своя ритъм отива и взима тези метрики от Pushgateway.
За настройка на известия в Prometheus има отделен компонент — Alertmanager. И правила за алертиране — alerting rules. Например, трябва да се създаде alert в случай, че API сървърите 0. Когато събитието се задейства, alert-ът се предава на alert manager за по-нататъшно изпращане. В alert manager има достатъчно гъвкави настройки за маршрутиране: една група алерти може да бъде изпращана в Telegram чат на админите, друга в чат на разработчиците, трета в чат на инфраструктурните специалисти. Уведомленията могат да идват в Slack, Telegram, на имейл и в други канали.
И накрая ще разкажа за киллер-функцията на Prometheus — Откриване. При работа с Prometheus не е необходимо да посочвате конкретни адреси на обектите за мониторинг, достатъчно е да зададете техния тип. Тоест не е нужно да пишете „ето IP адрес, ето порт — мониторирай“, вместо това трябва да определите, по какви принципи да се намират тези обекти (targets — цели). Prometheus сам, в зависимост от това, какви обекти в момента са активни, извлича нужните и ги добавя за мониторинг.
Този подход добре се вписва в структурата на Kubernetes, където всичко постоянно се променя: днес 10 сървъра, утре 3. За да не е нужно всеки път да посочвате IP адреса на сървъра, един път написвате как да го намерите — и Откриването ще го прави.
Езикът на Prometheus се нарича PromQL. С помощта на този език можете да извличате стойностите на конкретни метрики и след това да ги променяте, строейки аналитични изводи по тях.
https://prometheus.io/docs/prometheus/latest/querying/basics/

Прост заявка

    container_memory_usage_bytes

Математически операции

    container_memory_usage_bytes / 1024 / 1024

Вградени функции

    sum(container_memory_usage_bytes) / 1024 / 1024

Уточняване на заявката

    100 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]) * 100)
Уеб интерфейс на Prometheus
Prometheus има свой собствен, доста минималистичен уеб интерфейс. Подходящ е единствено за дебъгване или демонстрации.
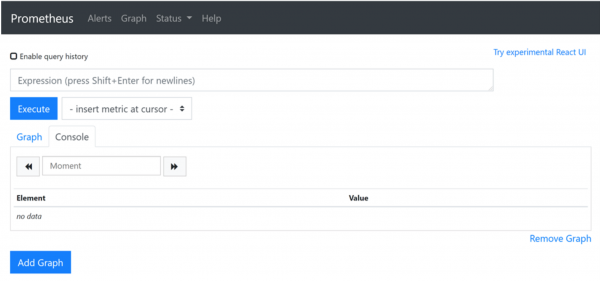
В полето Expression можете да напишете заявка на езика PromQL.
В раздела Alerts се съдържат правилата за алерти — alerting rules, и те имат три статуса:
- inactive — ако в момента alert-ът не е активен, тоест всичко е наред и не е сработил;
- pending — това е случаят, когато alert-ът е сработил, но изпращането все още не е преминало. Забавянето се задава, за да се компенсира мигането на мрежата: ако в течение на минута зададеният сервиз е бил възстановен, тревога не трябва да бъде подавана;
- firing — това е третият статус, при който alert-ът светва и изпраща съобщения.
В менюто Status ще намерите достъп до информация за това какво представлява Prometheus. Там също има преместване към целите (targets), за които говорихме по-горе.
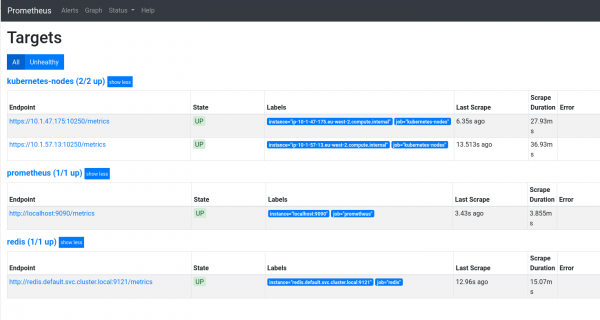
По-подробен преглед на интерфейса на Prometheus вижте .
Интеграция с Grafana
В уеб интерфейса на Prometheus няма красиви и ясни графики, от които да може да се направи извода за състоянието на кластера. За да ги изградим, Prometheus се интегрира с Grafana. Получават се такива табла.
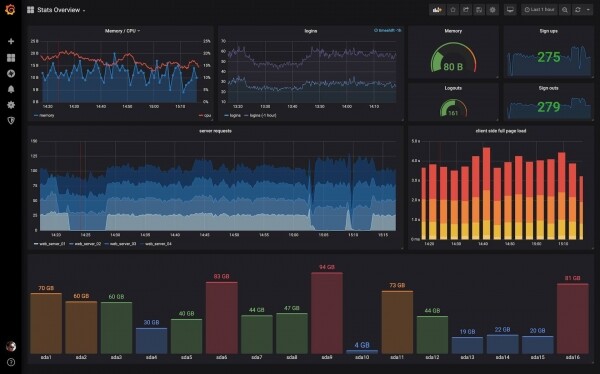
Настройването на интеграцията между Prometheus и Grafana не е сложно, инструкциите ще намерите в документацията: , но аз на това ще сложа край.
В следващите статии ще продължим темата за мониторинга: ще говорим за събиране и анализ на логове с помощта на Grafana Loki и алтернативни инструменти.
Автор: Марсел Ибраев, сертифициран администратор Kubernetes, практикуващ инженер в компания , лектор и разработчик на курсове в Слёрм.
Източник: habr.com
