

Въведение
Преди известно време ми беше поставена задачата да разработя отказоустойчив клъстер за , работещ в няколко дата центрове, свързани с оптични влакна в рамките на един град и способен да издържи на отказ (например, прекъсване на захранването) на един дата център. За софтуер, отговарящ за отказоустойчивостта, избрах , защото това е официалното решение от RedHat за изграждане на отказоустойчиви клъстери. То е добро, защото RedHat осигурява поддръжка за него и защото това решение е универсално (модулно). С него може да се осигури отказоустойчивост не само на PostgreSQL, но и на други услуги, или използвайки стандартни модули, или създавайки ги за специфични нужди.
Към това решение възникна основателен въпрос: колко отказоустойчив ще бъде отказоустойчивият клъстер? За да изследвам това, разработих тестова среда, която симулира различни откази на възлите на клъстера, очаква възстановяване на работоспособността, възстановява отказалия възел и продължава тестовете в цикъл. Първоначално този проект се наричаше hapgsql, но с времето ми омръзна името, в което имаше само една гласна. Затова отказоустойчивите бази данни (и float IP адресите, насочени към тях) започнах да наричам krogan (персонаж от компютърна игра, при когото всички важни органи са дублирани), а възлите, клъстерите и самият проект — tuchanka (планета, на която живеят кrogani).
В момента ръководството разреши . README скоро ще бъде преведен на английски (защото се очаква, че основните потребители ще бъдат разработчици на Pacemaker и PostgreSQL), а старият руски вариант на README реших да оформя (частично) под формата на тази статия.
Клъстерите се разгръщат на виртуални машини . Общo ще бъдат разположени 12 виртуални машини (общо 36GiB), които образуват 4 отказоустойчиви клъстера (различни варианти). Първите два клъстера се състоят от два сървъра PostgreSQL, които са разположени в различни дата центрове, и общ сървър witness с quorum device (разположен на евтина виртуална машина в третия дата център), който разрешава неопределеността 50%/50%, давайки гласа си на едната от страните. Третият клъстер е в три дата центъра: един майстор, два роба, без quorum device. Четвъртият клъстер се състои от четири PostgreSQL сървъра, по два на дата център: един мастер и останалите реплики, и също използва witness с quorum device. Четвъртият издържа на отказа на два сървъра или един дата център. Това решение може да бъде, при необходимост, скалирано на по-голямо количество реплики.
Сервиз за точно време също е конфигуриран за отказоустойчивост, но там се използва методът на ntpd (orphan mode). Общият сървър witness изпълнява роля на централен NTP сървър, разпределяйки своето време на всички клъстери, като по този начин синхронизира всички сървъри помежду си. Ако witness се повреди или стане изолиран, тогава своето време ще започне да раздава един от сървърите на клъстера (вътре в клъстера). Допълнителният кеширащ HTTP proxy също е разположен на witness, с неговата помощ останалите виртуалки имат достъп до Yum хранилища. На практика, такива услуги като точно време и прокси, вероятно ще бъдат разположени на отделни сървъри, но в стенда са разположени на witness само за спестяване на брой виртуалки и пространство.
Версии
v0. Работи с CentOS 7 и PostgreSQL 11 на VirtualBox 6.1.
Структура на клъстерите
Всички клъстери са предназначени за разполагане в няколко дата центъра, свързани в една плоска мрежа и трябва да издържат на отказ или мрежова изолация на един дата център. Следователно не е възможно използва за защита от split-brain стандартната технология Pacemaker, наречена STONITH (Shoot The Other Node In The Head) или fencing. Същността й е: ако възлите в клъстера започнат да подозират, че с някой възел нещо не е наред, той не отговаря или се държи неправилно, те принудително го изключват чрез "външни" устройства, например управляваща карта IPMI или UPS. Но такова нещо ще сработи само в случаите, когато при единичен отказ на сървър IPMI или UPS продължат да работят. Тук се планира защита от много по-катастрофичен отказ, когато отказа (например спиране на тока) целия дата център. А при такъв отказ всички stonith-устройства (IPMI, UPS и т.н.) също няма да работят.
Вместо това в основата на системата стои идеята за кворум. Всички възли имат глас, и могат да работят само тези, които виждат повече от половината от всички възли. Това количество "половина+1" се нарича кворум. Ако кворум не може да бъде достигнат, възелът решава, че е в мрежова изолация и трябва да изключи своите ресурси, т.е. това е такава защита от split-brain. Ако софтуерът, който отговаря за такова поведение, не работи, трябва да сработи watchdog, например, на база IPMI.
Ако броят на възлите е четен (кластър в два дата центъра), може да възникне така наречената неопределеност 50%/50% (половин наполовина), когато мрежовата изолация дели кластера точно наполовина. Заради четния брой възли се добавя quorum device — ненадежден демон, който може да бъде стартиран на най-евтината виртуалка в третия дата център. Той дава своя глас на един от сегментите (който вижда) и по този начин решава неопределеността 50%/50%. Сървърът, на който ще бъде стартирано quorum устройството, нарекох witness (терминология от repmgr, хареса ми).
Ресурсите могат да бъдат премествани от едно място на друго, например, от неисправни сървъри на работещи, или по команда на системните администратори. За да знаят клиентите къде се намират необходимите им ресурси (къде да се свържат?), се използват плаващи IP (float IP). Това са IP адреси, които Pacemaker може да мести между възлите (всичко е в плоска мрежа). Всеки от тях символизира ресурс (услуга) и ще се намира там, където трябва да се свързват, за да получат достъп до тази услуга (в нашия случай БД).
Tuchanka1 (схема с уплътнение)
Структура
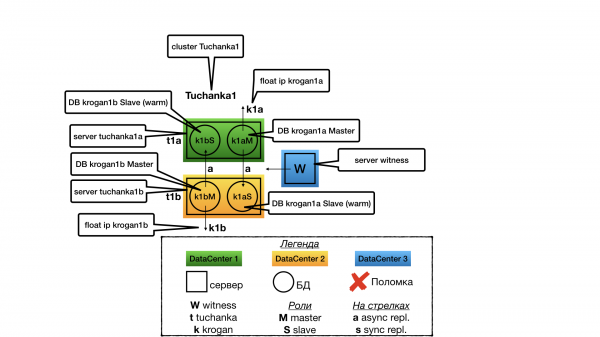
Идеята беше, че имаме много малки бази данни с ниско натоварване, за които не е изгодно да се поддържа специален slave-сървър в режим на hot standby за read only транзакции (няма нужда от такава разхищение на ресурси).
Във всеки дата център по един сървър. На всеки сървър има два инстанса PostgreSQL (в терминологията на PostgreSQL те се наричат клъстери, но за да избегнем объркване, ще ги наричам инстанси (по аналогия с други БД), а клъстери ще наричам само клъстери Pacemaker). Един инстанс работи в режим на майстор и само той предоставя услуги (само на него е насочен float IP). Вторият инстанс работи като работник за втория дата център и ще предоставя услуги само ако неговият майстор не е на линия. Тъй като по-голямата част от времето услугите (изпълняване на заявки) ще предоставя само един инстанс от двата (майстор), всички ресурси на сървъра се оптимизират за майстор (разпределя се памет за кеш shared_buffers и т.н.), но така, че да има достатъчно ресурси и за втория инстанс (макар и за неоптимална работа чрез кеш на файловата система) в случай на отказ на един от дата центровете. Работникът не предоставя услуги (не изпълнява read only заявки) при нормална работа на клъстера, за да не се състезава за ресурси с майстора на същата машина.
При случай на два възела отказоустойчивостта е възможна само при асинхронна репликация, тъй като при синхронна отказ на работника ще доведе до спиране на майстора.
Отказ на witness
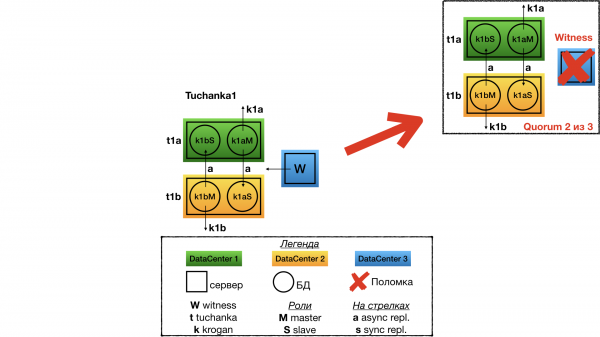
Отказ на witness (quorum device) ще разгледам само за клъстера Tuchanka1, с всички останали ще бъде същата история. При отказ на witness в структурата на клъстера нищо няма да се промени, всичко ще продължи да работи така, както и преди. Но кворумът ще стане равен на 2 от 3, и затова всякакъв следващ отказ ще стане фатален за клъстера. Въпреки това ще трябва спешно да се поправи.
Отказ на Tuchanka1
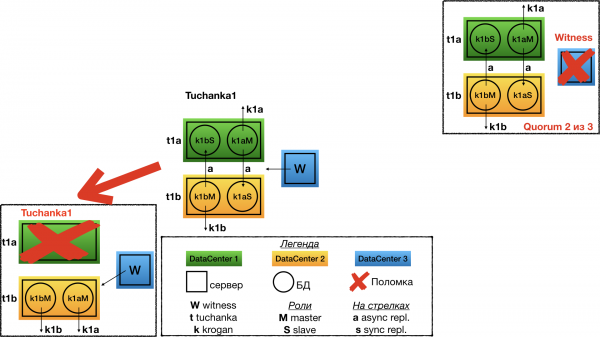
Отказ на един от дата центровете за Tuchanka1. В този случай witness дава своя глас на втория възел на втория дата център. Там бившият работник се превръща в майстор, в резултат на което на един сървър работят и двата майстора и на тях са насочени и двата им float IP.
Tuchanka2 (класически)
Структура
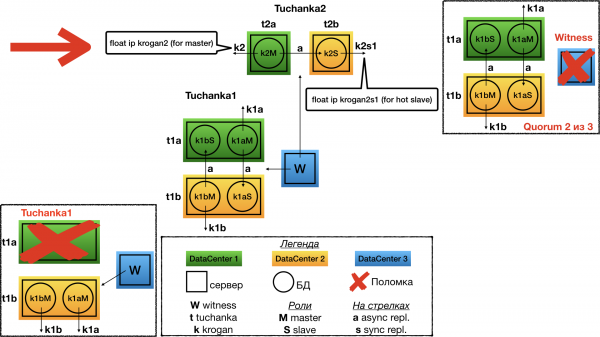
Класическа схема с два възела. На един работи майстор, на втория работник. И двата могат да изпълняват заявки (работникът само read only), затова и на двата са насочени float IP: krogan2 — на майстора, krogan2s1 — на работника. Отказоустойчивост ще има и при майстора, и при работника.
При случай на два възела отказоустойчивостта е възможна само при асинхронна репликация, защото при синхронна отказ на работника ще доведе до спиране на майстора.
Отказ на Tuchanka2
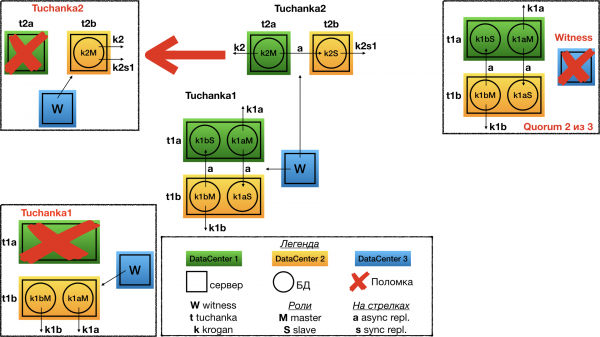
При отказ на един от дата центровете witness гласува за втория. На единствения работещ датацентър ще бъде повдигнат майстор, и към него ще сочат и двете float IP: майсторският и робският. Разбира се, инстансът трябва да бъде настроен така, че да разполага с достатъчно ресурси (лимити под connection и т.н.), за да може едновременно да приема всички връзки и запитвания от майсторския и робския float IP. Тоест при нормална работа той трябва да има достатъчен запас по лимитите.
Tuchanka4 (много роби)
Структура
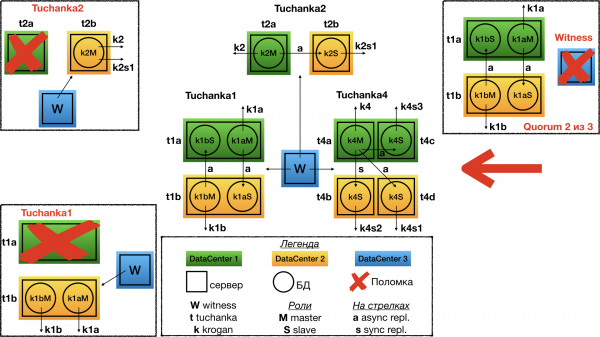
Вече друга крайност. Има бази данни, на които постъпват много запитвания тип read-only (типичен случай на високо натоварен сайт). Tuchanka4 — това е ситуация, когато робите могат да бъдат три или повече за обработка на такива запитвания, но все пак не твърде много. При много голямо количество роби ще трябва да се изобрети йерархична система за репликиране. В минималния случай (на картинката) в двата датацентъра има по два сървъра, на всеки от които има по един инстанс на PostgreSQL.
Още една особеност на тази схема е, че тук вече може да се организира една синхронна репликация. Тя е настроена така, че да репликира, по възможност, в друг датацентър, а не на реплика в същия датацентър, където е и майсторът. Към майстора и към всеки робот сочи float IP. По-добре между роботите да се направи балансировка на запитванията по някакъв sql proxy, например, от страната на клиента. Различни типове клиенти могат да изискват различен тип sql proxy, и само разработчиците на клиентските приложения знаят кой какво нуждае. Тази функционалност може да бъде реализирана както от външния демон, така и от клиентската библиотека (connection pool) и т.н. Всичко това излиза извън обсега на темата за отказоустойчивия кластер на БД (отказоустойчивост SQL proxy може да бъде реализирана независимо, заедно с отказоустойчивостта на клиента).
Отказ Tuchanka4
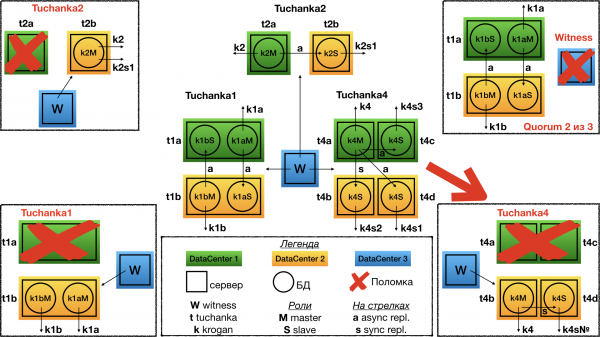
При отказ на един датацентър (т.е. на двата сървъра) свидетелят гласува за втория. В резултат на това във втория датацентър работят два сървъра: на един работи майсторът, и към него сочи майсторският float IP (за прием на read-write запитвания); а на втория сървър работи робот с синхронна репликация, и към него сочи един от робските float IP (за read only запитвания).
Първото, което трябва да се отбележи: работещите робски float IP ще бъдат не всички, а само един. И за коректната работа с него е необходимо, за да sql proxy пренасочва всички заявки към единствения останал float IP; а ако sql proxy не, то може да се изброят всички float IP на робите през запетая в URL за свързване. В такъв случай с libpq свързването ще бъде към първия работещ IP, така е направено в системата за автоматично тестване. Може би, в други библиотеки, например, JDBC, това няма да работи и е необходим sql proxy. Така е направено, защото за float IP на робите е поставена забрана да се издигат едновременно на един сървър, за да се разпределят равномерно по роботизираните сървъри, ако работят няколко.
Второ: дори в случай на отказ на дата центъра ще се запази синхронната репликация. И дори ако се случи вторичен отказ, т.е. в оставащия дата център да се повреди един от двата сървъра, клъстерът, макар и да спре да предоставя услуги, все пак ще запази информация за всички закомитирани транзакции, за които е дал потвърждение за комит (няма да има загуба на информация при вторичен отказ).
Tuchanka3 (3 дата центъра)
Структура
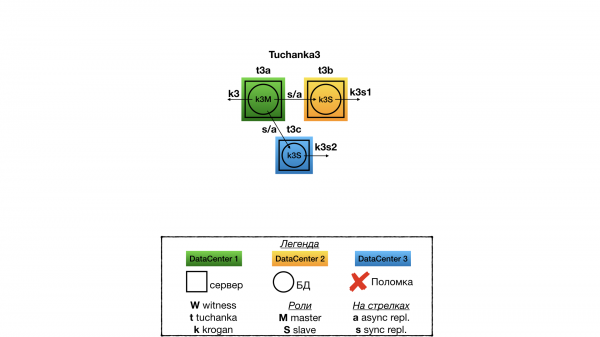
Това е клъстер за ситуация, когато има три напълно работещи дата центъра, в които всеки има функциониращ сървър на БД. В този случай quorum device не е необходим. В един дата център работи майстор, в другите два — роби. Репликацията е синхронна, тип ANY (slave1, slave2), т.е. на клиента ще се изпрати потвърждение за комит, когато който и да е от робите първи отговори, че е приел комита. На ресурсите сочи един float IP за майстора и два за робите. За разлика от Tuchanka4, всички три float IP са отказоустойчиви. За балансиране на read-only SQL заявки може да се използва sql proxy (с отделна отказоустойчивост), или на половината клиенти да се назначи един робски float IP, а на другата половина — втори.
Отказ Tuchanka3
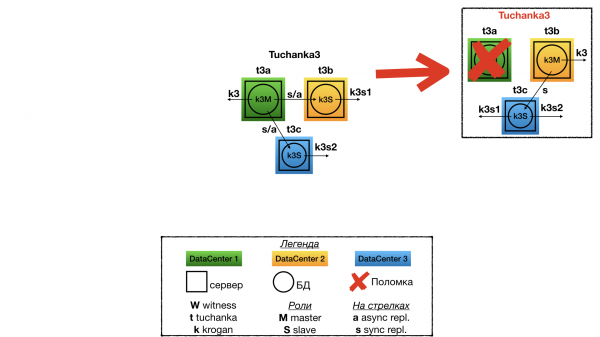
При отказ на един от дата центровете остават два. В един е издигнат майсторът и float IP от майстора, във втория — робът и двата робски float IP (на инстанса трябва да има двукратен запас от ресурси, за да приеме всички връзки от двата робски float IP). Между майстора и роба има синхронна репликация. Освен това клъстерът ще запази информация за закомитираните и потвърдените транзакции (няма да има загуба на информация) в случай на унищожаване на два дата центъра (ако те са унищожени не одновременно).
Не включих подробно описание на файловата структура и разгръщането. Който иска да пробва, може да прочете всичко в README. Показвам само описание на автоматичното тестване.
Система за автоматично тестване
За проверка на устойчивостта на клъстери с имитация на различни повреди е създадена система за автоматично тестване. Стартира се чрез скрипт test/failure. Скриптът може да приема параметри с номера на клъстерите, които искате да тествате. Например, тази команда:
test/failure 2 3ще тества само втория и третия клъстер. Ако параметрите не са зададени, ще се тестват всички клъстери. Всички клъстери се тестват паралелно, а резултатите се извеждат в панела tmux. Tmux използва отделен tmux сървър, така че скриптът може да се стартира от default tmux, което ще доведе до вложен tmux. Препоръчвам да използвате терминал с голямо прозорец и малък шрифт. Преди началото на тестването всички виртуални машини се връщат на моментна снимка в момента на завършване на скрипта. настройка.
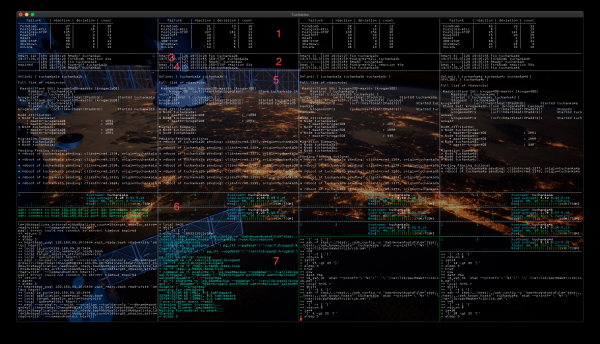
Терминалът е разделен на колони според броя на тестваните клъстери, по подразбиране (на екрана) те са четири. Съдържанието на колоните ще опиша на примера на Tuchanka2. Панелите на екрана са номерирани:
- Тук се извежда статистиката за тестовете. Колоните:
- failure — името на теста (функцията в скрипта), която имитира повреда.
- reaction — средното арифметично време в секунди, за което клъстерът е възстановил работоспособността си. Измерва се от началото на работата на скрипта, имитиращ повреда, и до момента, когато клъстерът възстановява работоспособността си и е в състояние да продължи да предлага услуги. Ако времето е много малко, например шест секунди (както е в клъстери с няколко раба (Tuchanka3 и Tuchanka4)), това означава, че повредата е била на асинхронен раб и по никакъв начин не е повлияла на работоспособността, не е имало превключвания на състоянието на клъстера.
- deviation — показва разпространението (точността) на стойността reaction методом „стандартно отклонение“.
- count — колко пъти е бил изпълнен този тест.
- Краткият журнал позволява да оцените какво прави клъстерът в момента. Извежда се номер на итерацията (теста), времева метка и име на операцията. Прекалено дългото изпълнение (> 5 минути) подсказва за някакъв проблем.
- heart (сърце) — текущо време. За визуална оценка на работоспособността майстора в неговата таблица постоянно се записва текущото време, използвайки float IP на майстора. В случай на успех, резултатът се показва в тази панел.
- удар (пулс) — «текущо време», което преди е било записано от скрипта heart в майстор, сега се чете от роба чрез неговия float IP. Позволява визуална оценка на работоспособността на роба и репликацията. В Tuchanka1 няма роби с float IP (няма роби, предлагащи услуги), но там има два инстанса (БД), затова тук ще бъде показано не удар, а heart втория инстанс.
- Мониторинг на състоянието на кластера с помощта на утилитата
pcs mon. Показва структурата, разпределението на ресурсите по възли и друга полезна информация. - Тук се извежда системен мониторинг с всяка виртуална машина на кластера. Такива панели може да има и повече — колкото виртуалки има кластера. Два графика CPU Load (във виртуалките по два процесора), име на виртуалката, System Load (наречен като Load Average, защото е средно за 5, 10 и 15 минути), данни за процесите и разпределението на паметта.
- Проследяване на скрипта, извършващ тестовете. В случай на неизправност — внезапно прекъсване на работата или безкраен цикъл на изчакване — тук може да се види причината за такова поведение.
Тестването се извършва в два етапа. Първо, скриптът минава през всички видове тестове, като случайно избира виртуалка, на която да приложи този тест. След това се изпълнява безкраен цикъл на тестване, при което виртуалките и неизправностите се избират на случаен принцип всяка път. Внезапното завършване на скрипта за тестване (долната панел) или безкраен цикъл на изчакване на нещо (> 5 минути време за изпълнение на една операция, това се вижда в проследяването) показва, че някой от тестовете на този кластер е провалил.
Всеки тест се състои от следните операции:
- Стартиране на функция, емулираща неизправност.
- Готово? — очакване на възстановяване на работоспособността на кластера (когато всички услуги са налични).
- Показва времето на изчакване за възстановяване на кластера (reaction).
- Fix — кластерът се «поправя». След което той трябва да се върне в напълно работоспособно състояние и готовност за следваща неизправност.
Ето списък на тестовете с описание на това, какво правят:
- ForkBomb: създава "Out of memory" чрез форк-бомба.
- OutOfSpace: запълва диска. Но тестът е по-скоро символичен, при това незначително натоварване, което се създава при тестването, при запълване на диска отказът на PostgreSQL обикновено не настъпва.
- Postgres-KILL: убива PostgreSQL с командата
killall -KILL postgres. - Postgres-STOP: спира PostgreSQL с командата
killall -STOP postgres. - PowerOff: „изключва“ виртуалната машина с командата
VBoxManage controlvm "виртуалка" poweroff. - Нулиране: рестартира виртуалната машина с командата
VBoxManage controlvm "виртуалка" reset. - SBD-STOP: спира демона SBD с командата
killall -STOP sbd. - ShutDown: чрез SSH изпраща команда на виртуалната машина
systemctl poweroff, системата правилно завършва работа. - UnLink: мрежова изолация, команда
VBoxManage controlvm "виртуалка" setlinkstate1 off.
Завършване на теста или с помощта на стандартната команда tmux "kill-window" Ctrl-b &, или с командата "detach-client" Ctrl-b d: в този случай тестът приключва, tmux се затваря, виртуалните машини се изключват.
Откритите проблеми при тестването
В момента демонът watchdog sbd работи с прекъсването на наблюдаваните демони, но не и с техния зависимост. И, следователно, неправилно обработва неизправности, които водят до зависване само Corosync и Pacemaker, но не и до спиране на sbd. За проверка Corosync присъства на клиента, , прието в клон master. Обещаха (в PR#83), че и за Pacemaker ще бъде нещо подобно, надявам се, че до RedHat 8 ще го направят. Но подобни "неизправности" са теоретични, лесно могат да се симулират изкуствено, например,
killall -STOP corosync, но никога не се срещат в реалния живот.В Pacemaker в версията за CentOS 7 неправилно е зададен sync_timeout у quorum device, в резултат на което , на който трябваше да премине майсторът. Заработи се с увеличението sync_timeout у quorum device по време на разгръщането (в скрипта
setup/setup1). Тази корекция не беше приета от разработчиците Pacemaker, вместо това те обещаха да преработят инфраструктурата по такъв начин (в някакво неопределено бъдеще), че този тайм-аут да се изчислява автоматично.Ако при конфигуриране на базата данни е посочено, че в
LC_MESSAGES(текстови съобщения) може да се използва Юникод, например,ru_RU.UTF-8, тогава при стартиране postgres в среда, където locale не е UTF-8, да речем, в празна среда (тук pacemaker+pgsqlms(paf) стартира postgres), тогава . Разработчиците на PostgreSQL не се споразумяха какво да се прави в този случай. Това се заобикаля, необходимо е да се зададеLC_MESSAGES=en_US.UTF-8при конфигуриране (създаване) на инстанс на БД.Ако е зададен wal_receiver_timeout (по подразбиране 60s), при теста PostgreSQL-STOP на основния сървър в кластерите tuchanka3 и tuchanka4 . Репликацията там е синхронна, така че спира не само работещият, но и новият основен сървър. Това може да се заобиколи чрез настройка на wal_receiver_timeout=0 при конфигуриране на PostgreSQL.
Рядко съм наблюдавал замразяване на репликацията в PostgreSQL по време на теста ForkBomb (препълване на паметта). . Срещал съм това само в кластерите tuchanka3 и tuchanka4, където поради синхронната репликация, основният сървър замръзваше. Проблемът се решава сам след известно време (около два часа). Необходимо е допълнително проучване, за да се поправи. Симптомите наподобяват предишен бъг, предизвикан от друга причина, но с еднакви последствия.
Снимката на крогана е взета от с разрешение на автора:
Източник: habr.com
