

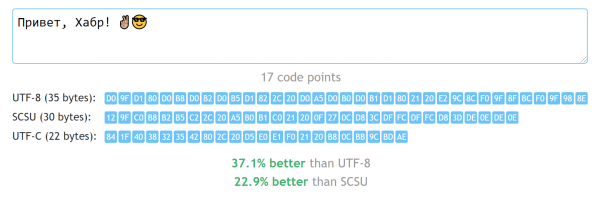
Ако сте разработчик и пред вас стои задачата за избор на кодировка, почти винаги правилното решение е Юникод. Конкретният начин на представяне зависи от контекста, но най-често има универсален отговор — UTF-8. Той е добър, защото позволява да се използват всички символи на Юникода, без да се харчат твърде много байта в повечето случаи. Истина, за езици, които не използват само латиница, «не твърде много» — това е най-малко два байта на символ. Може ли да бъде по-добре, без да се връщаме към примитивните кодировки, ограничени до 256 налични символа?
По-долу предлагам да се запознаете с моя опит да дам отговор на този въпрос и реализирам относително прост алгоритъм, който позволява съхраняването на редове на повечето езици в света, без да добавя онази излишност, която имаме в UTF-8.
Отказ от отговорност. Веднага ще направя няколко важни уточнения: описаното решение не е предлагано като универсална замяна на UTF-8, то е подходящо само за тесен списък от случаи (за които по-долу), и по никакъв начин не трябва да бъде използвано за взаимодействие с външни API (които дори не знаят за него). Най-често за компактно съхранение на големи обеми текстови данни подхождат алгоритмите за компресия с общо предназначение (например, deflate). Освен това, вече в процеса на създаването на собственото си решение, аз открих съществуващ стандарт в самия Юникод, който решава същата задача — той е малко по-сложен (и често по-лош), но все пак представлява приет стандарт, а не събран на коляно. За него също ще разкажа.
За Юникод и UTF-8
Първо — няколко думи за това какво представлява Unicode и UTF-8.
Както е известно, по-рано били популярни 8-битовите кодировки. С тях всичко е просто: 256 символа могат да се номерират с числа от 0 до 255, а числата от 0 до 255 очевидно могат да се представят с един байт. Ако се върнем към самите начала, кодировката ASCII дори е ограничена до 7 бита, поради което най-старшият бит в нейното байтово представяне е равен на нула, и повечето 8-битови кодировки са с нея съвместими (те се различават само в «горната» част, където най-старшият бит е единица).
С какво Юникод се различава от тези кодировки и защо с него е свързано толкова много конкретни представяния — UTF-8, UTF-16 (BE и LE), UTF-32? Нека разгледаме ред по ред.
Основният стандарт на Юникода описва само съответствието между символите (и в някои случаи — отделни компоненти на символите) и техните номера. И възможните номера в този стандарт са много — до 0x00 до 0x10FFFF (1 114 112 броя). Ако искахме да поставим число в такъв диапазон в променлива, нито 1, нито 2 байта не биха стигнали. А тъй като нашите процесори не са особено приспособени за работа с тройни числа, щяхме да бъдем принудени да използваме цели 4 байта за един символ! Това и е UTF-32, но именно заради тази „разточителност“ този формат не е популярен.
За радост, символите в Юникод не са подредени случайно. Цялото им множество е разделено на 17 „плоскости», всяка от които съдържа 65536 (0x10000) «кодови точки». Понятието „кодова точка“ тук — това е просто номер на символа, присвоен му от Юникода. Но, както бе споменато по-горе, в Юникода са номерирани не само отделни символи, но също техните компоненти и служебни бележки (а понякога и вовсе номерът не съответства на нищо — възможно е временно, но за нас това не е толкова важно), затова е по-точно винаги да говорим именно за броя на самите номера, а не символи. Въпреки това по-нататък за краткост често ще употребявам думата „символ“, имайки предвид термина „кодова точка“.
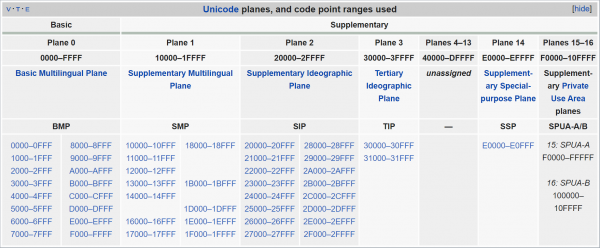
Плоскости на Юникода. Както се вижда, голяма част (плоскостите от 4 до 13) все още не са използвани.
Най-удивителното е, че цялата основна „мякотка“ лежи в нулевата плоскост, тя се нарича "Basic Multilingual Plane". Ако стринга съдържа текст на един от съвременните езици (включително китайски), извън пределите на тази плоскост няма да излезете. Но не можете да отрежете останалата част на Юникода — например, емоджита основно се намират в края на следващата по ред плоскост, "Supplementary Multilingual Plane" (тя се простира от 0x10000 до 0x1FFFF). Затова UTF-16 постъпва така: всички символи, попадащи в Basic Multilingual Plane, се кодира „както са“, със съответното им двубайтово число. Въпреки това част от числата в този диапазон изобщо не обозначават конкретни символи, а указват, че след тази двойка байтове трябва да се разгледа още една — комбинирайки стойностите на тези четири байта заедно, получаваме число, обхващащо целия допустим диапазон на Юникода. Такова представяне се нарича „сурогатни двойки“ — възможно е да сте чували за тях.
По този начин, UTF-16 изисква два или (в много редки случаи) четири байта за една „кодова точка“. Това е по-добре от постоянното използване на четири байта, но латиницата (и други ASCII символи) при това кодиране изразходват половината за нули. UTF-8 е създаден, за да поправи това: ASCII в него заема, както преди, само един байт; кодове от 0x80 до 0x7FF — два байта; от 0x800 до 0xFFFF — три, а от 0x10000 до 0x10FFFF — четири. От една страна, латиницата получи предимство: възвърна се съвместимостта с ASCII, а разпределението е по-равномерно „разтегнато“ от 1 до 4 байта. Но азбуките, различни от латинската, за съжаление, не печелят в сравнение с UTF-16, а много от тях сега изискват три байта вместо два — диапазонът, покрит от двубайтовата запис, намаля до 32 пъти, с 0xFFFF до 0x7FF, и в него не попада вече нито китайският, нито, например, грузинският. На кирилицата и още пет азбуки — ура — късмет им донесе, по 2 байта на символ.
Защо се получава така? Нека видим как UTF-8 представлява кодовете на символите:
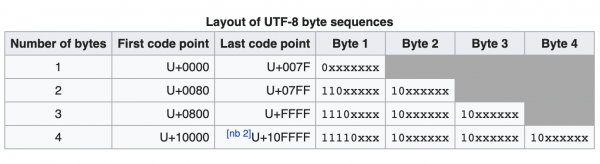
Непосредствено за представяне на числата тук са използвани битове, маркирани със символа x. Ясно е, че в двубайтовата запис има само 11 от 16 бита. Водещите битове тук, изпълняват само служебна функция. В случай на четирибайтовата запис, коментираният номер на кодовата точка заема 21 бит от 32 — изглежда, че трябвало е да стигнат и три байта (които дават общо 24 бита), но служебните маркери поглъщат твърде много.
Лошо ли е това? Всъщност, не много. От една страна — ако много сме загрижени за заетото пространство, имаме алгоритми за компресия, които лесно ще елиминират цялата излишна ентропия и излишък. От друга страна — целта на Юникода беше да предложи максимално универсално кодиране. Например, низ, кодирани в UTF-8, можем да доверим на код, който преди е работил само с ASCII, и не трябва да се страхуваме, че той ще види символ от ASCII диапазона, който всъщност няма там (защото в UTF-8 всички байтове, започващи с нулев бит — това именно са ASCII символи). А ако решим изведнъж да отрежем малък край от голям низ, без да декодираме от самото начало (или да възстановим част от информацията след повреден участък) — лесно можем да намерим отместването, откъдето започва някакъв символ (достатъчно е да пропуснем байтовете, които имат битов префикс 10).
Защо тогава да измисляме нещо ново?
В същото време, понякога се случват ситуации, когато алгоритмите за компресия, като deflate, не са особено приложими, а е желание да се постигне компактно съхранение на низове. Лично аз се сблъсках с такава задача, размишлявайки за изграждането на за голям речник, включващ думи на произволни езици. От една страна - всяка дума е много кратка, затова компресирането ѝ ще бъде неефективно. От друга страна - реализацията на дървото, която обмислях, беше проектирана така, че всеки байт на съхранявания низ да поражда отделен връх на дървото, така че минимизирането на техния брой беше много полезно. В моята библиотека (както и в , на която тя е основана), подобен проблем се решава просто - низовете, опаковани в -речник, се съхраняват там в . Но, както е лесно да се разбере, това работи добре само за ограничен алфавит - низът на китайски в такъв речник вече не може да бъде съхранен.
Отделно ще посоча още един неприятен нюанс, който възниква при използването на UTF-8 в подобна структура на данните. На изображението по-горе се вижда, че когато записвате символа в два байта, битовете, свързани с неговия номер, не са последователни, а са прекъснати от двойка бит 10 в средата: 110xxxxx 10xxxxxx. Поради това, когато в кода на символа се препълнят младшите 6 бита на втория байт (т.е. настъпва преход 10111111 → 10000000), първият байт също се променя. Оказва се, че буквата „п“ се обозначава с байтове 0xD0 0xBF, а следващата „р“ - вече с 0xD1 0x80. В префиксното дърво това води до разделяне на родителския връх на два - един за префикса 0xD0, и друг за 0xD1 (въпреки че цялата кирилица можеше да бъде кодирана само с втория байт).
Какво постигнах
Сблъсквайки се с тази задача, реших да поиграя с битовете и освен това да се запозная по-добре със структурата на Юникода като цяло. Резултатът беше формат на кодиране UTF-C („C“ от компактен), който харчи не повече от 3 байта за една кодова точка и много често позволява да се изразходва само един излишен байт за целия кодируем низ.Това води до факта, че за много не-ASCII алфавити такова кодиране се оказва с 30-60 % по-компактно от UTF-8.
Оформил съм примери за реализация на алгоритми за кодиране и декодиране под формата на , можете свободно да ги използвате в кода си. Но все пак подчертавам, че в известен смисъл този формат си остава "велосипед" и не бих го препоръчал. без да осъзнавате защо ви е необходим.. В крайна сметка, това е повече експеримент, отколкото истинско "подобрение на UTF-8". Въпреки това, кодът там е написан внимателно, лаконично, с много коментари и тестово покритие.
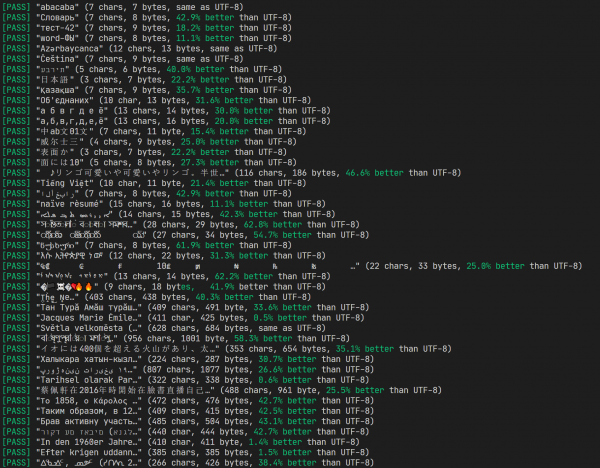
Резултат от изпълнението на тестовете и сравнение с UTF-8.
Също така направих , където можете да оцените работата на алгоритма, а по-късно ще ви разкажа повече за неговите принципи и процеса на разработка.
Премахваме излишните битове.
За основа взех, разбира се, UTF-8. Първото и най-очевидно, което можем да променим - е да намалим броя на служебните битове във всеки байт. Например, първият байт в UTF-8 винаги започва или с 0, или с 11 — а префиксът 10 е само за следващите байтове. Ще заменим префикса 11 на 1, а от следващите байтове ще премахнем префиксите напълно. Какво ще се получи?
0xxxxxxx — 1 байт
10xxxxxx xxxxxxxx — 2 байта
110xxxxx xxxxxxxx xxxxxxxx — 3 байта
Стоп, а къде е четирибайтовата версия? Тя стана ненужна - с писането на три байта сега разполагаме с 21 бит и това е повече от достатъчно за всички числа до 0x10FFFF.
Какво загубихме тук? Най-важното - откриването на границите на символите от произволно място в буфера. Не можем да посочим произволен байт и от него да намерим началото на следващия символ. Това е ограничение на нашия формат, но на практика необходимостта от него не възниква често. Обикновено можем да преминем през буфера от самото начало (особено когато става въпрос за кратки редове).
Ситуацията с покритие на езици с 2 байта също стана по-добра: сега двубайтовият формат дава диапазон от 14 бита, а това са кодовете до 0x3FFF. Китайците не са на късмет (их иероглифите основно съществуват в диапазона от 0x4E00 до 0x9FFF), но грузинците и много други народи са в по-добра позиция - техните езици също се побират в 2 байта на символ.
Въвеждаме състоянието на кодера.
Нека сега помислим за свойствата на самите редове. В речника обикновено се намират думи, написани със символи от един азбука, и за много други текстове това също е вярно. Би било добре да посочим този азбук веднъж, а след това само номера на буквата в него. Нека видим дали ще ни помогне разположението на символите в таблицата на Юникода.
Както беше казано по-горе, Юникод е разделен на плоскости по 65536 кодов всяка. Но това не е много полезно разделяне (както вече споменахме, най-често сме в нулевата равнина). По-интересно е разделянето на блокове. Тези диапазони вече нямат фиксирана дължина и носят повече смисъл — като правило, всеки обединява символи от един алфавит.
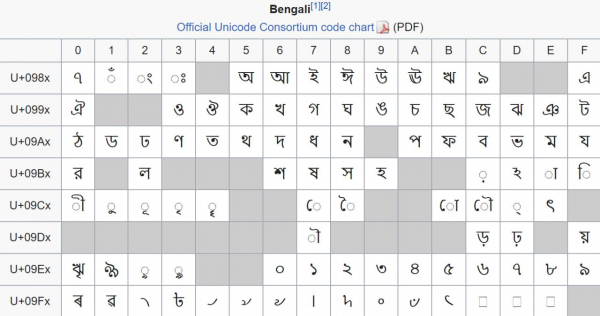
Блок, съдържащ символи от бенгалския алфавит. За съжаление, по исторически причини, това е пример за не много плътна опаковка — 96 символа хаотично разпределени по 128 кодови точки на блока.
Началата на блоковете и техните размери винаги са кратни на 16 — направено е просто за удобство. Освен това, много блокове започват и завършват на стойности, кратни на 128 или дори 256 — например, основната кирилица заема 256 байта от 0x0400 до 0x04FF. Това е доста удобно: ако веднъж запомним префикса 0x04, след това всеки кирилски символ може да бъде записан с един байт. Разбира се, така ще загубим възможността да се върнем към ASCII (и към всякакви други символи изобщо). Затова правим така:
- Два байта
10yyyyyy yxxxxxxxне само обозначават символ с номерyyyyyy yxxxxxxx, но и променят текущия алфавит наyyyyyy y0000000(т.е. запомняме всички битове, освен най-младшите 7 бита); - Един байт
0xxxxxxxтова е символът на текущия алфавит. Трябва просто да го съберем с това изместване, което запомнихме на стъпка 1. Докато не сме променили алфавита, изместването е равно на нула, така че запазваме съвместимост с ASCII.
По аналогия за кодовете, изискващи 3 байта:
- Три байта
110yyyyy yxxxxxxx xxxxxxxxобозначават символ с номерyyyyyy yxxxxxxx xxxxxxxx, променят текущия алфавит наyyyyyy y0000000 00000000(запомнили сме всичко, освен най-младшите 15 бита), и поставят флаг, че сега сме в дългия режим (при смяна на алфавита обратно на дву байтов, този флаг ще бъде нулиран); - Два байта
0xxxxxxx xxxxxxxxв дългия режим това е символът на текущия алфавит. По аналогия, добавяме го с изместването от стъпка 1. Цялата разлика е, че сега четем по два байта (защото сме преминали в такъв режим).
Звучи добре: сега, докато трябва да кодиране символи от един и същи 7-битов диапазон на Юникод, ние харчим 1 излишен байт в началото и само по един байт за всеки символ.
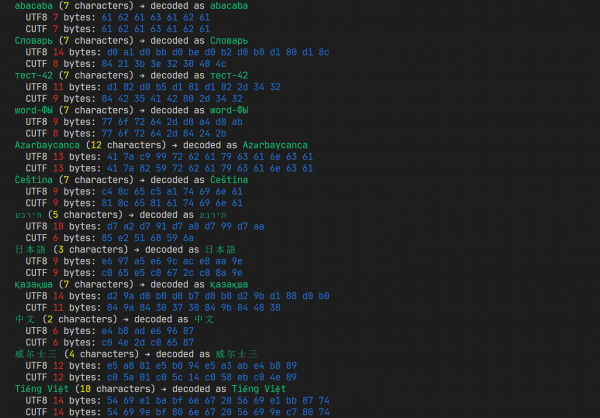
Работа на една от ранните версии. Вече е доста често среща UTF-8, но все още има какво да се подобрява.
Какво стана по-лошо? Първо, имаме състояние, а именно изместването на текущия алфавит и флага дългия режим. Това ни ограничава допълнително: сега същите символи могат да бъдат кодирани по различен начин в различни контексти. Търсенето на подстрингове, например, ще трябва да се извършва с оглед на това, а не просто да сравняваме байтове. На второ място, веднага след като сменим азбуката, става трудно с кодирането на ASCII символите (а това не е само латиница, но и основната пунктуация, включително интервали) — те изискват повторна смяна на азбуката в 0, т.е. отново излишен байт (а после още един, за да се върнем към основната ни).
Една азбука е добре, две — по-добре
Нека опитаме малко да променим нашите битови префикси, добавяйки още един към трите по-горе описани:
0xxxxxxx — 1 байт в нормален режим, 2 в дългия
11xxxxxx — 1 байт
100xxxxx xxxxxxxx — 2 байта
101xxxxx xxxxxxxx xxxxxxxx — 3 байта
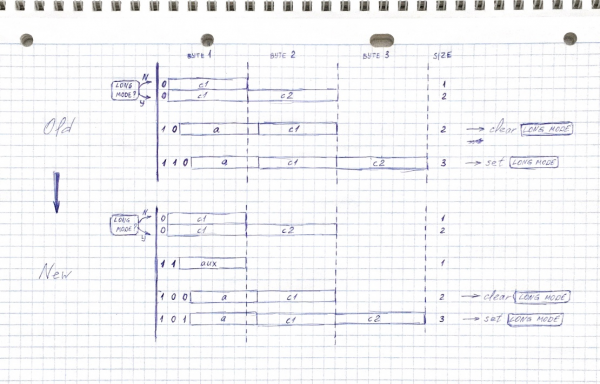
Сега в двубайтовата запись на един наличен бит имаме по-малко — кодовите точки стигат до 0x1FFF, а не 0x3FFF. Въпреки това, все още е чувствително повече, отколкото в двубайтовите кодове UTF-8, по-голямата част от разпространените езици все още се побират, най-забележимата загуба — отпадна и , японците са тъжни.
Какво е новият код 11xxxxxx? Это небольшой «загашник» размером в 64 символа, он дополняет наш основной алфавит, поэтому я назвал его вспомогательным (auxiliary) алфавит. Когато превключваме текущия алфавит, тогава част от стария алфавит става спомагателен. Например, ако сменим от ASCII на кирилица — в „загашника“ вече има 64 символа, съдържащи латиница, цифри, интервал и запетая (най-честите вставки в не-ASCII текстовете). Върнем се обратно на ASCII — и спомагателният алфавит ще стане основната част от кирилицата.
Благодарение на достъпа до две азбуки, можем да се справим с много текстове, имайки минимални разходи за превключване на азбуките (пунктуацията най-често ще води до връщане в ASCII, но след това много не-ASCII символи ще извлечем вече от допълнителния алфавит, без повторно превключване).
Бонус: обозначавайки допълнителния алфавит с префикс 11xxxxxx и избирайки началното му изместване равно на 0xC0, получаваме частична съвместимост с CP1252. С други думи, много (но не всички) западноевропейски текстове, кодирани в CP1252, ще изглеждат по същия начин и в UTF-C.
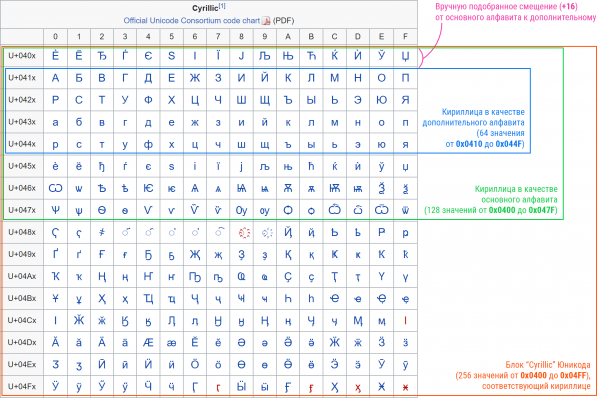
Тук обаче възниква трудност: как да получим спомагателния алфавит от основния? Може да оставим същото изместване, но — уви — тук структурата на Unicode вече работи против нас. Много често основната част от алфавита не се намира в началото на блока (например, руската главна буква „А“ има код 0x0410, макар че кирилицата започва с 0x0400). По този начин, ако вземем „резерв“ първите 64 символа, може би ще загубим достъп до опашката на азбуката.
За да отстраня проблемите, ръчно преминах през някои блокове, съответстващи на различни езици, и указах за тях изместване на помощната азбука в основната. Латиницата, за изключение, въобще пренаредих като base64.
Финални щрихи
Нека накрая да помислим къде още можем да направим нещо.
Забелязваме, че форматът 101xxxxx xxxxxxxx xxxxxxxx позволява кодиране на числа до 0x1FFFFF, а Юникод завършва по-рано, на 0x10FFFF. Иначе казано, последната кодова точка ще бъде представена като 10110000 11111111 11111111. Следователно, можем да кажем, че ако първият байт има вида 1011xxxx (където xxxx повече от 0), то той обозначава нещо друго. Например, можем да добавим още 15 символа, постоянно достъпни за кодиране с един байт, но реших да постъпя по различен начин.
Нека да разгледаме онези блокове на Юникод, които изискват три байта в момента. Основно, както вече бе споменато, това са китайски йероглифи — но с тях е трудно да се направи нещо, те са 21 хиляда. Но освен това там са и хирагана с катаканата — а те вече не са толкова много, по-малко от двеста. А, тъй като споменахме японците — там също са и емодзи (всъщност, те са разпръснати на много места в Юникод, но основните блокове в диапазона 0x1F300 – 0x1FBFF). Ако помислим за това, че в момента съществуват емодзи, които се събират от няколко кодови точки (например, емодзи са цели 7 кода!), става съвсем жалко да се харчат по три байта за всяко (7×3 = 21 байт за един символ, истински кошмар).
Затова избираме няколко избрани диапазона, съответстващи на емодзи, хирагана и катакана, нумерираме ги в един непрекъснат списък и ги кодирахме в два байта вместо три:
1011xxxx xxxxxxxx
Отлично: споменатият по-горе емодзи , състоящ се от 7 кодови точки, в UTF-8 заема 25 байта, а ние го побрахме в 14 (точно по два байта на всяка кодова точка). Между другото, Хабр отказа да го обработи (както в стария, така и в новия редактор), така че трябваше да го поставя като картинка.
Опитваме се да поправим и още един проблем. Както помним, основната азбука всъщност е по-високите 6 бита, които държим в ума, и ги лепим към кода на всеки следващ декодируем символ. В случая с китайските йероглифи, които са в блока 0x4E00 – 0x9FFF, това е или бит 0, или 1. Не е много удобно: постоянно ще трябва да превключваме азбуката между тези две стойности (т.е. да изразходваме по три байта). Но нека забележим, че в дългия режим можем да извадим самото число символи, което кодираме с помощта на късия режим (след всички описани по-горе трикове, това е 10240) — така диапазонът на йероглифите ще се измести към 0x2600 – 0x77FF, и в този случай в целия този диапазон старшите 6 бита (от 21) ще бъдат равни на 0. По този начин, последователността от йероглифи ще използва по два байта за йероглиф (което е оптимално за такъв голям диапазон), без да предизвиква превключвания на азбуката.
Алтернативни решения: SCSU, BOCU-1
Знаещите Unicode, само прочитайки заглавието на статията, вероятно бързо ще напомнят, че пряко сред стандартите на Unicode съществува (SCSU), който описва начин за кодиране, доста подобен на описания в статията.
Признавам честно: за съществуването му научих едва след като се задълбочих дълбоко в написването на собственото си решение. Ако бях научил за него от самото начало, вероятно бих се опитал да напиша неговата реализация вместо да измисля собствен подход.
Интересно е, че SCSU използва идеи, много сходни с тези, до които самостоятелно стигнах (вместо понятието „азбуки“ там се използват „прозорци“, и те са на разположение в по-голям брой от моите). В същото време, този формат също има недостатъци: той е малко по-близо до алгоритмите за компресия, отколкото за кодиране. В частност, стандартът дава много начини за представяне, но не уточнява как да се избере оптималният — за това енкодерът трябва да прилага някакви хевристики. Така че SCSU-енкодер, който предоставя добра опаковка, ще бъде по-сложен и обемен от моя алгоритъм.
За сравнение, пренесох относително проста реализация на SCSU на JavaScript — по обем на кода тя се оказа сравнима с моя UTF-C, но в редица случаи показа резултат с десет процента по-лош (понякога може и да го надминава, но незначително). Например, текстове на иврит и гръцки UTF-C кодира с 60% по-добре от SCSU (вероятно заради компактните им азбуки).
Отделно ще добавя, че освен SCSU съществува и друг начин за компактно представяне на Unicode — , но той его целта е съвместимост с MIME (което не ми беше необходимо), и използва доста различен подход към кодиране. Не съм оценявал неговата ефективност, но ми се струва, че едва ли ще бъде по-висока от SCSU.
Възможни доработки
Предложеният от мен алгоритъм не е универсален по замисъл (в това, вероятно, моите цели най-силно се разминават с целите на консорциума Unicode). Вече споменах, че той е разработен главно за една задача (съхранение на многоезиков речник в префиксно дърво), и някои от неговите особености могат да не са подходящи за други задачи. Но фактът, че не е стандарт, може да е и плюс — можете лесно да го доработите според нуждите си.
Например, очевидно може да се отървете от наличието на състояние, да направите кодиране безсъстояние — просто не обновявайте променливите изключване, помощно и is21Bit в енкодера и декодера. В такъв случай няма да можете ефективно да опаковате последователности от символи на един алфавит, но ще имате гаранция, че един и същ символ винаги се кодира с одни и същи байтове, независимо от контекста.
Освен това, може да настроите кодера за конкретен език, като промените състоянието по подразбиране — например, насочвайки се към руски текстове, да зададете в началото на енкодера и декодера offs = 0x0400 и auxOffs = 0. Особено това има смисъл именно в случаите на безсъстояние. Като цяло това ще наподобява използването на стара осембитова кодировка, само че не лишава възможността да се вмъкват символи от целия Юникод при необходимост.
Едно друго неудобство, споменато по-рано — в обемния текст, закодиран в UTF-C, няма бърз начин за намиране на границата на символа, най-близък до произволен байт. Отрязвайки от кодирания буфер последните, да речем, 100 байта, рискувате да получите боклук, с който няма какво да направите. Кодировката не е предназначена за съхранение на многогигабайтни логове, но изобщо това може да се поправи. Байт 0xBF никога не трябва да се среща като първи байт (но може да е втори или трети). Затова при кодиране можете да вмъкнете последователност 0xBF 0xBF 0xBF на всеки, да речем, 10 КБ — тогава при необходимост да намерите границата ще е достатъчно да сканирате избрания участък, докато не намерите подобен маркер. След последния 0xBF гарантирано ще има начало на символа. (При декодиране тази последователност от три байта, разбира се, трябва да бъде игнорирана.)
В обобщение
Ако сте прочели до тук — поздравления! Надявам се, че вие, както и аз, научихте нещо ново (или обновихте спомените за старото) за устройството на Юникода.
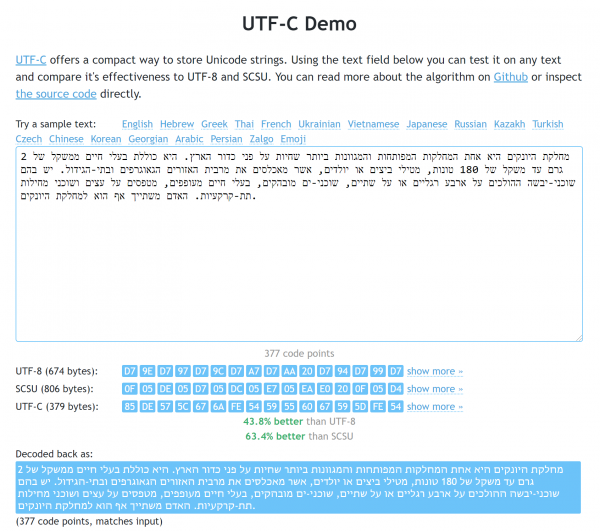
Демонстрационна страница. На примера с иврит са видни предимствата както пред UTF-8, така и пред SCSU.
Не трябва да разглеждате горепосочените изследвания като посегателство върху стандартите. Все пак съм доволен от резултатите на моите разработки, затова съм радостен да ги : например, JS-библиотеката в минифициран вид тежи само 1710 байта (и разбира се, няма зависимости). Както споменах по-горе, с нейното функциониране можете да се запознаете на (там също има набор от текстове, с които можете да я сравните с UTF-8 и SCSU).
Накрая, отново ще обърна внимание на случаите, в които да се използва UTF-C не трябва.:
- Ако вашите редове са достатъчно дълги (от 100-200 символа). В такъв случай е разумно да се замислите за приложението на алгоритми за компресия като deflate.
- Ако ви е необходимо ASCII прозрачност, тоест важно е за вас, да няма ASCII кодове в кодирани последователности, които не са били в оригиналния ред. Можете да избегнете подобна нужда, ако при взаимодействие с външни API (например, работейки с БД) предавате резултата от кодиране като абстрактен набор от байтове, а не като редове. В противен случай рискувате да получите непредвидими уязвимости.
- Ако искате бързо да намирате границите на символите по произволно изместване (например, при повреда на част от реда). Това може да се направи, но само чрез сканиране на реда от началото (или като приложите усъвършенстване, описано в предишната част).
- Ако ви е нужно бързо да извършвате операции над съдържанието на редовете (да ги сортирате, да търсите подтекстове, да конкатенирате). За целта е необходимо първо да декодирате редовете, затова UTF-C ще бъде по-бавен от UTF-8 в тези случаи (но по-бърз от алгоритмите за компресия). Тъй като един и същ ред винаги се кодира по един и същи начин, точна проверка на декодирането не е необходима, тя може да се извършва байт по байт.
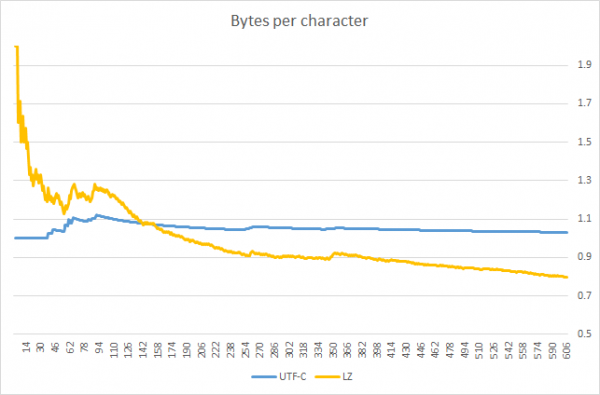
Актуализация: потребител публикувал график, който подчертава границата на приложимост на UTF-C. На него е видно, че UTF-C е по-ефективен от алгоритъма за компресия с общо предназначение (вариации LZW), докато компресираната строка е по-кратка ~140 символа (въпреки че ще отбележа, че сравнението беше направено с един и същ текст; за други езици резултатът може да е различен).
Източник: habr.com
