

Високата производителност е едно от основните изисквания при работа с големи данни. Ние в управлението на данните в Сбер се занимаваме с обработката на практически всички транзакции в нашето Облако от данни на базата на Hadoop и затова работим с наистина големи обеми информация. Разбира се, постоянно търсим начини за повишаване на производителността и сега искаме да разкажем как успяхме да подобрим RegionServer HBase и HDFS клиента, благодарение на което значително увеличихме скоростта на операцията по четене.
Преди обаче да преминем към същността на подобренията, е важно да споменем ограниченията, които по принцип не могат да бъдат избегнати, ако се използва HDD.
Защо HDD и бързите Random Access четения са несъвместими
Както е известно, HBase, а и много други бази данни, съхраняват данните на блокове, с размер от няколко десетки килобайта. По подразбиране размерът е около 64 Кб. Сега си представете, че трябва да извлечем само 100 байта и ние молим HBase да ни предостави тези данни по определен ключ. Тъй като размерът на блока в HFiles е 64 Кб, ще получим 640 пъти повече (внимание!) отколкото е необходимо.
След това, тъй като заявката ще премине през HDFS и неговия механизъм за кеширане на метаданни ShortCircuitCache (който позволява директен достъп до файл), това води до четене на уже 1 Мб от диска. Въпреки това, това може да бъде регулирано с параметъра dfs.client.read.shortcircuit.buffer.size и в много случаи има смисъл да намалим тази стойност, например до 126 Кб.
Да предположим, че направим това, но освен това, когато започнем да четем данни чрез java api, с функции като FileChannel.read и молим операционната система да прочете зададения обем данни, тя чете "за всеки случай" 2 пъти повече, т.е. 256 Кб в нашия случай. Това се случва, защото в java няма проста възможност да се зададе флага FADV_RANDOM, който предотвратява такова поведение.
В крайна сметка, за да получим нашите 100 байта, под капака се извеждат 2600 пъти повече. Изглежда, че изходът е очевиден, нека да намалим размера на блока до килобайт, да зададем споменатия флаг и да постигнем страхотно ускорение. Но проблемът е, че намалявайки размера на блока наполовина, ние също така намаляваме и количеството четени байтове за единица време наполовина.
Печатаем флага FADV_RANDOM можем получить известные преимущества, но только при высокой многопоточности и размере блока от 128 Кб. Но это максимум лишь десятков процентов:
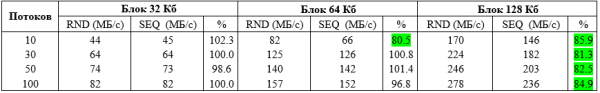
Тестовите се проведоха на 100 файла, все с размер 1 Гб, разположени на 10 HDD диска.
Нека да изчислим какво можем да очакваме с такава скорост:
Да приемем, че четем от 10 диска със скорост 280 МБ/сек, т.е. 3 милиона пъти по 100 байта. Но, както помним, данните, от които се нуждаем са 2600 пъти по-малко от прочитаното. Така че 3 милиона делим на 2600 и получаваме 1100 записа в секунда.
Тъжно, нали? Такава е природата на Случайния достъп до данните на HDD — независимо от размера на блока. Това е физически предел на произволния достъп и никоя база данни не може да извлече повече в такива условия.
Как тогава базите достигат значително по-високи скорости? За да отговорим на този въпрос, нека видим какво се случва на следващата картинка:
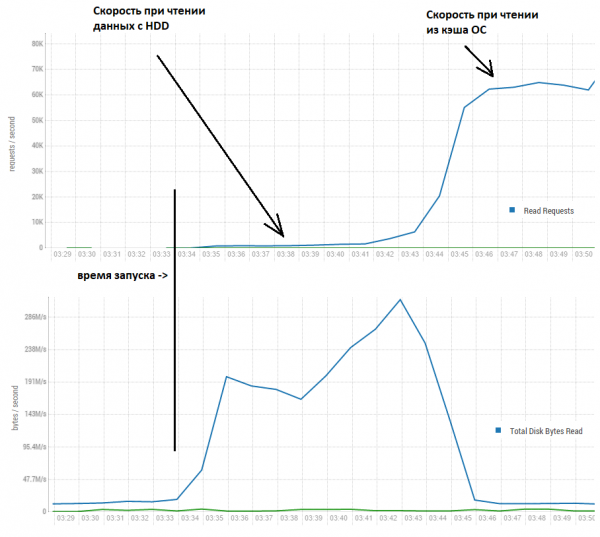
Тук виждаме, че в първите няколко минути скоростта наистина е около хиляда записа в секунда. Обаче по-късно, благодарение на това, че се четат много повече от колкото е заявено, данните се натрупват в buff/cache на операционната система (linux) и скоростта нараства до по-прилични 60 хиляди в секунда.
Следователно, по-късно ще се занимаваме с ускоряване на достъпа само до тези данни, които се намират в кэша на ОС или са в хранилища с подобна скорост на достъп, като SSD/NVMe.
В нашия случай ще провеждаме тестове на платформа от 4 сървъра, всеки от които е конфигуриран по следния начин:
CPU: Xeon E5-2680 v4 @ 2.40GHz 64 нишки.
Памет: 730 Гб.
java версия: 1.8.0_111
И тук всъщност е ключовият момент — обемът на данните в таблиците, които трябва да се четат. Факт е, че ако четете данни от таблица, която напълно се помещава в кэш HBase, то четенето от buff/cache на операционната система дори не стига до там. Защото HBase по подразбиране отделя 40% от паметта за структурата, наречена BlockCache. Всъщност, това е ConcurrentHashMap, където ключът е името на файла плюс offset на блока, а value всъщност са данните за това смещение.
Така че, когато четенето идва само от тази структура, ние , като се предлагат милиони заявки в секунда. Но нека си представим, че не можем да отделим стотици гигабайти памет само за нуждите на базата данни, защото на тези сървъри работят много други полезни неща.
Например, в нашия случай обемът на BlockCache на един RS е около 12 Гб. Разположихме два RS на един възел, т.е. за BlockCache са отделени 96 Гб на всички възли. А данните при това са многократно повече, например, нека да кажем, че това ще бъдат 4 таблици, по 130 региона, в които файловете са по 800 Мб, компресирани с FAST_DIFF, т.е. общо 410 Гб (това са чисти данни, т.е. без да се взима предвид фактора на репликация).
Следователно, BlockCache съставлява само около 23% от общия обем данни и това е много по-близо до реалните условия на това, което наричаме BigData. И тук започва най-интересното — очевидно е, че колкото по-малко попадения в кеша, толкова по-лоша е производителността. В случай на пропуск, ще трябва да извършим куп работа — т.е. да слезем до повиквания на системни функции. Но няма как да го избегнем, така че да разгледаме съвсем друг аспект — какво се случва с данните в кеша?
Определяме ситуацията и предполагаме, че имаме кеш, в който може да се съхранява само 1 обект. Ето пример за това какво ще се случи, когато се опитваме да работим с обем данни, три пъти по-голям от кеша, ще трябва да:
1. Поместим блок 1 в кеша
2. Премахнем блок 1 от кеша
3. Поместим блок 2 в кеша
4. Премахнем блок 2 от кеша
5. Поместим блок 3 в кеша
Извършени са 5 действия! Но не можем да наречем тази ситуация нормална, всъщност ние принуждаваме HBase да извършва куп напълно безполезна работа. То постоянно чете данни от кеша на ОС, поставя ги в BlockCache, за да ги изхвърли почти веднага, защото е получила нова партида данни. Анимацията в началото на публикацията показва същността на проблема — Garbage Collector е натоварен, атмосферата се загрява, малката Грета в далечна и гореща Швеция се разстройва. А ние, айти специалистите, много не обичаме, когато децата са тъжни, затова започваме да се чудим какво можем да направим с това.
А какво ако поставяме в кеша не всички блокове, а само определен процент от тях, така че кешът да не се препълва? Нека първо просто добавим няколко реда код в началото на функцията за поставяне на данни в BlockCache:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
Смисълът тук е следният: офсетовете представляват позицията на блока в файла, а последните цифри са случайно и равномерно разпределени от 00 до 99. Затова ще пропускаме само тези, които попадат в нашия нужден диапазон.
Например, задаваме cacheDataBlockPercent = 20 и ще видим какво ще стане:
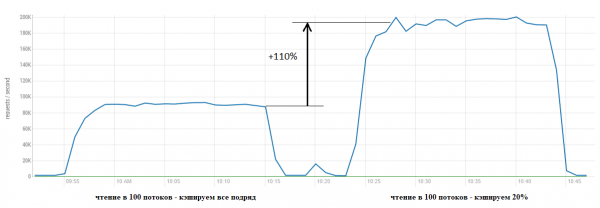
Резултатът е очевиден. На графиките по-долу става ясно какво е довело до това ускорение — спестяваме много ресурси на GC, без да се занимаваме със сизифовска работа за разполагане на данни в кеша, само за да ги изхвърлим на марсианските кучета под опашките:
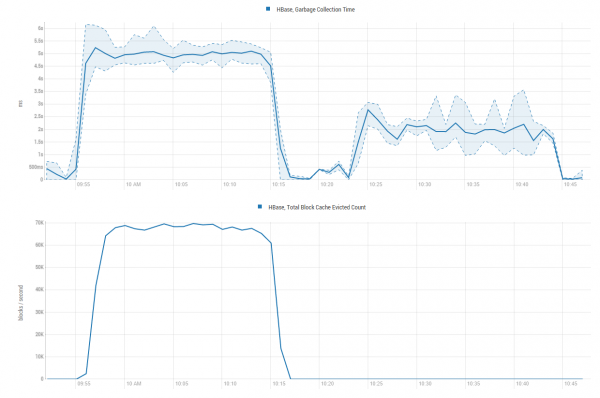
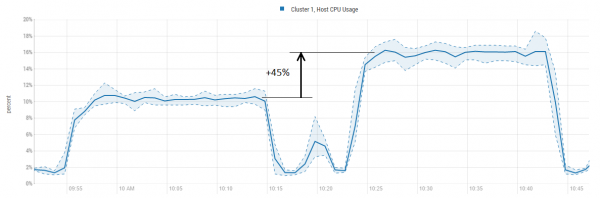
Утилизацията на CPU обаче нараства, но значително по-малко от производителността:
Тук все пак трябва да се отбележи, че блоковете, които се съхраняват в BlockCache, са различни. По-голямата част, около 95%, всъщност представляват данни. А останалото са метаданни, като Bloom филтри или LEAF_INDEX и . Тези данни не са много, но са много полезни, тъй като преди да се обърне директно към данните, HBase се обръща към метаданните, за да разбере дали е необходимо да търси по-нататък и ако да, то къде точно се намира интересуващият го блок.
Затова в кода виждаме условие за проверка buf.getBlockType().isData() и благодарение на тези метаданные ще оставим в кеша във всеки случай.
Сега нека увеличим натоварването и заедно да оптимизираме малко функцията. В първия тест направихме процента на отсяване = 20 и BlockCache беше малко под натоварен. Сега ще зададем 23% и ще добавяме по 100 нишки на всеки 5 минути, за да видим в кой момент се достига насищане:
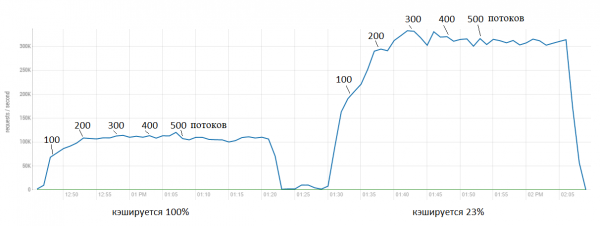
Тук виждаме, че оригиналната версия практически веднага удря тавана на около 100 хиляди запитвания в секунда. Докато патчът дава ускорение до 300 хиляди. При това става ясно, че по-нататъшното ускорение вече не е толкова "безплатно", утилизацията на CPU също нараства.
Въпреки това, това не е много елегантно решение, тъй като предварително не знаем какъв процент от блоковете трябва да кешираме, това зависи от профила на натоварването. Затова беше реализиран механизъм за автоматична настройка на този параметър в зависимост от активността на операциите по четене.
За да управлявате това, бяха добавени три параметъра:
hbase.lru.cache.heavy.eviction.count.limit — определяє, скільки разів має запуститися процес виселення даних з кешу, перш ніж ми почнемо використовувати оптимізацію (тобто пропускати блоки). За замовчуванням це значення MAX_INT = 2147483647, що фактично означає, що функція ніколи не почне працювати з таким значенням. Це пов'язано з тим, що процес виселення запускається кожні 5 — 10 секунд (в залежності від навантаження), і 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 років. Однак ми можемо встановити цей параметр на 0 і змусити функцію працювати відразу після старту.
Однак у цього параметра є й корисна сторона. Якщо у нас характер навантаження такою, що постійно чергуються короткострокові читання (припустимо, вдень) і довгострокові (вночі), ми можемо зробити так, що функція буде включатися лише коли відбуваються тривалі операції читання.
Наприклад, ми знаємо, що короткострокові читання тривають зазвичай близько 1 хвилини. Не варто починати викидати блоки, кеш не встигне застаріти, і тоді ми можемо встановити цей параметр, наприклад, на 10. Це призведе до того, що оптимізація почне працювати лише тоді, коли розпочалося тривале активне читання, тобто через 100 секунд. Таким чином, якщо ми маємо короткострокові читання, всі блоки потраплять у кеш і будуть доступні (за винятком тих, що будуть виселені стандартним алгоритмом). А коли ми здійснюємо довгострокові читання, функція включається і ми маємо значно вищу продуктивність.
hbase.lru.cache.heavy.eviction.mb.size.limit — встановлює, скільки мегабайтів хотіли б вміщати в кеш (і, звісно, виселяти) за 10 секунд. Функція намагатиметься досягти цього значення і підтримувати його. Суть у тому, якщо ми засовуємо в кеш гігабайти, то і виселяти доведеться гігабайти, а це, як ми бачимо, досить накладно. Однак не варто намагатися встановити його занадто малим, оскільки це призведе до передчасного виходу з режиму пропуску блоків. Для потужних серверів (близько 20-40 фізичних ядер) оптимально встановлювати близько 300-400 МБ. Для середнього класу (~10 ядер) 200-300 МБ. Для слабких систем (2-5 ядер) може бути нормально 50-100 МБ (на таких не тестувалося).
Нека видим как това работи: да предположим, че сме задали hbase.lru.cache.heavy.eviction.mb.size.limit = 500, има натоварване (четене) и тогава на всеки ~10 секунди изчисляваме колко байта са били освободени по формулата:
Overhead = Освободени байти общо (MB) * 100 / Лимит (MB) — 100;
Ако реално са освободени 2000 MB, то Overhead е равен на:
2000 * 100 / 500 — 100 = 300%
Алгоритмите се стремят да поддържат не повече от няколко десетки процента, така че функцията ще намали процента на кешираните блокове, реализирайки механизма за авто-настройка.
Но ако натоварването спадне, например, освободени са само 200 MB и Overhead стане отрицателен (така нареченият overshooting):
200 * 100 / 500 — 100 = -60%
Тогава функцията обратното ще увеличи процента на кешираните блокове, докато Overhead не стане положителен.
По-долу ще бъде пример как изглежда това с реални данни. Не трябва да се опитвате да достигнете 0%, това е невъзможно. Много добре е, когато е около 30 — 100%, това помага да се избегне преждевременното излизане от режима на оптимизация при краткосрочни изблици.
hbase.lru.cache.heavy.eviction.overhead.coefficient — задава как бързо бихме искали да получим резултат. Ако знаем със сигурност, че нашите четения са основно дълготрайни и не искаме да чакаме, можем да увеличим този коефициент и да получим висока производителност по-бързо.
Например, ако зададем този коефициент = 0.01. Това означава, че Overhead (вж. по-горе) ще бъде умножен по това число и ще намали процента на кешираните блокове. Да предположим, че Overhead = 300%, а коефициентът = 0.01, то процентът на кешираните блокове ще бъде намален с 3%.
Подобна логика «Backpressure» е реализирана и за отрицателни стойности на Overhead (overshooting). Тъй като винаги е възможно краткосрочни колебания в обема на четенето-освобождаването, този механизъм позволява да се избегне преждевременното излизане от режима на оптимизация. Backpressure има обратна логика: колкото по-силен е overshooting, толкова повече блокове се кешират.
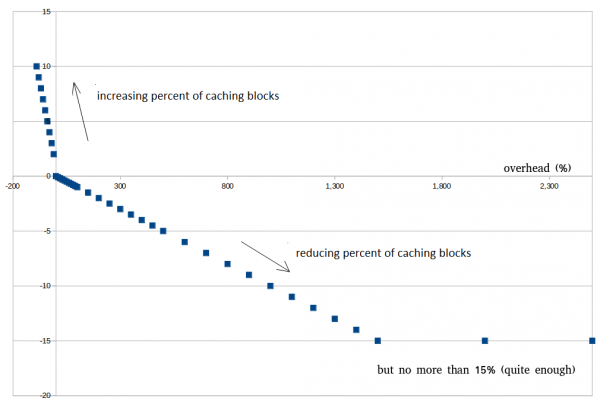
Код на реализация
        LruBlockCache кеш = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict() / 1024 / 1024;
        /*
        * Понякога четем повече данни, отколкото могат да се поберат в BlockCache
        * и това е причина за висок процент на изхвърляния.
        * Това от своя страна води до тежка работа на Garbage Collector.
        * Така че много блокове влизат в BlockCache, но никога не се четат,
        * а изразходват много CPU ресурси.
        * Тук ще анализираме колко байта са освободени и ще решим
        * дали е дошло времето да намалим количеството кеширани блокове.
        * Това помага да се избегне поставяне на твърде много блокове в BlockCache
        * когато evict() работи много активно и спестява CPU за други задачи.
        * Повече подробности: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // Първо, трябва да контролираме колко време
        // е изминало от последното извикване на evict()
        // Това трябва да бъде почти същото време (+/- 10s)
        // защото получаваме съпоставими обеми освободени байтове всеки път.
        // 10s, защото това е зададеният период за изпълнение на evict() (вижте по-горе this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Тук трябва да изчислим каква ситуация имаме.
          // Имаме лимит "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // и можем да изчислим надхвърлянето.
          // Ще използваме тази информация, за да решим,
          // как да променим процента на кешираните блокове.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Сега сме в ситуация, когато сме над лимита
            // Но може би ще го пренебрегнем, защото ще приключи доста скоро
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // Продължава дълго и трябва да намалим кеширането
              // на блокове сега. Така че тук изчисляваме колко блокове искаме да пропуснем.
              // Зависи от:
             // 1. Надхвърляне - ако надхвърлянето е голямо, можем да бъдем по-агресивни
              // в намаляването на количеството кеширани блокове.
              // 2. Колко бързо искаме да получим резултата. Ако знаем, че нашето
              // тежко четене ще продължи дълго, не искаме да чакаме, можем
              // да увеличим коефициента и да получим добра производителност доста скоро.
              // Но ако не сме сигурни, можем да го направим бавно и ще предотвратим
              // преждевременното излизане от този режим. Така че, когато коефициентът е
              // по-висок, можем да получим по-добра производителност, когато тежкото четене е стабилно.
              // Но когато четенето се променя, можем да се настроим и да зададем
              // коефициента на по-ниска стойност.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // Но практиката показва, че 15% намаление е напълно достатъчно.
              // Не сме алчни (това може да доведе до преждевременно излизане).
              change = Math.min(15, change);
              change = Math.max(0, change); // Мисля, че това никога няма да стане, но проверете.
              // Това е ключовият момент, тук намаляваме % на кешираните блокове
              cache.cacheDataBlockPercent -= change;
              // Ако паднем твърде дълбоко, трябва да спрем тук, 1% по всякакъв начин трябва да бъде.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // Добре, получихме надхвърляне.
            // Може би е просто краткосрочно колебание и можем да останем в този режим.
            // Това помага да се избегне преждевременното излизане по време на краткосрочни колебания.
            // Ако надхвърлянето е по-малко от 90%, ще опитаме да увеличим процента на
            // кешираните блокове и се надяваме, че това е достатъчно.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Проста логика: повече надхвърляне - повече кеширани блокове (обратен натиск)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // Но не може да бъде повече от 100%, така че проверете.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Изглежда, че тежкото четене е приключило.
              // Просто излизаме от този режим.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache изхвърли (MB): {}, надхвърляне (%): {}, " +
            "брояч на тежки изхвърляния: {}, " +
            "текущо кеширане DataBlock (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Нека разгледаме всичко това на реален пример. Имаме следния тестов сценарий:
- Започваме да правим Scan (25 нишки, пакет = 100)
- След 5 минути добавяме multi-gets (25 нишки, пакет = 100)
- След 5 минути изключваме multi-gets (остава само scan)
Извършваме два пробега, първо hbase.lru.cache.heavy.eviction.count.limit = 10000 (което фактически изключва функцията), след това задаваме limit = 0 (включва).
В логовете по-долу виждаме как функцията се включва, като нулира Overshooting до 14-71%. Време на време натоварването намалява, което включва Backpressure и HBase отново кешира повече блокове.
Лог RegionServer
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 2170, ratio 1.09, overhead (%): 985, heavy eviction counter: 1, current caching DataBlock (%): 91 < start
evicted (MB): 3763, ratio 1.08, overhead (%): 1781, heavy eviction counter: 2, current caching DataBlock (%): 76
evicted (MB): 3306, ratio 1.07, overhead (%): 1553, heavy eviction counter: 3, current caching DataBlock (%): 61
evicted (MB): 2508, ratio 1.06, overhead (%): 1154, heavy eviction counter: 4, current caching DataBlock (%): 50
evicted (MB): 1824, ratio 1.04, overhead (%): 812, heavy eviction counter: 5, current caching DataBlock (%): 42
evicted (MB): 1482, ratio 1.03, overhead (%): 641, heavy eviction counter: 6, current caching DataBlock (%): 36
evicted (MB): 1140, ratio 1.01, overhead (%): 470, heavy eviction counter: 7, current caching DataBlock (%): 32
evicted (MB): 913, ratio 1.0, overhead (%): 356, heavy eviction counter: 8, current caching DataBlock (%): 29
evicted (MB): 912, ratio 0.89, overhead (%): 356, heavy eviction counter: 9, current caching DataBlock (%): 26
evicted (MB): 684, ratio 0.76, overhead (%): 242, heavy eviction counter: 10, current caching DataBlock (%): 24
evicted (MB): 684, ratio 0.61, overhead (%): 242, heavy eviction counter: 11, current caching DataBlock (%): 22
evicted (MB): 456, ratio 0.51, overhead (%): 128, heavy eviction counter: 12, current caching DataBlock (%): 21
evicted (MB): 456, ratio 0.42, overhead (%): 128, heavy eviction counter: 13, current caching DataBlock (%): 20
evicted (MB): 456, ratio 0.33, overhead (%): 128, heavy eviction counter: 14, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.33, overhead (%): 71, heavy eviction counter: 15, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.32, overhead (%): 71, heavy eviction counter: 16, current caching DataBlock (%): 19
evicted (MB): 342, ratio 0.31, overhead (%): 71, heavy eviction counter: 17, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.3, overhead (%): 14, heavy eviction counter: 18, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.29, overhead (%): 14, heavy eviction counter: 19, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.27, overhead (%): 14, heavy eviction counter: 20, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.25, overhead (%): 14, heavy eviction counter: 21, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.24, overhead (%): 14, heavy eviction counter: 22, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.22, overhead (%): 14, heavy eviction counter: 23, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.21, overhead (%): 14, heavy eviction counter: 24, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.2, overhead (%): 14, heavy eviction counter: 25, current caching DataBlock (%): 19
evicted (MB): 228, ratio 0.17, overhead (%): 14, heavy eviction counter: 26, current caching DataBlock (%): 19
изхвърлени (МБ): 456, съотношение 0.17, разходи (%): 128, тежка изхвърляща 计数: 27, текущо кеширане DataBlock (%): 18 < добавени получавания (но таблицата остава същата)
изхвърлени (МБ): 456, съотношение 0.15, разходи (%): 128, тежка изхвърляща 计数: 28, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 342, съотношение 0.13, разходи (%): 71, тежка изхвърляща 计数: 29, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 342, съотношение 0.11, разходи (%): 71, тежка изхвърляща 计数: 30, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 342, съотношение 0.09, разходи (%): 71, тежка изхвърляща 计数: 31, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 228, съотношение 0.08, разходи (%): 14, тежка изхвърляща 计数: 32, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 228, съотношение 0.07, разходи (%): 14, тежка изхвърляща 计数: 33, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 228, съотношение 0.06, разходи (%): 14, тежка изхвърляща 计数: 34, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 228, съотношение 0.05, разходи (%): 14, тежка изхвърляща 计数: 35, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 228, съотношение 0.05, разходи (%): 14, тежка изхвърляща 计数: 36, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 228, съотношение 0.04, разходи (%): 14, тежка изхвърляща 计数: 37, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 109, съотношение 0.04, разходи (%): -46, тежка изхвърляща 计数: 37, текущо кеширане DataBlock (%): 22 < обратна налягане
изхвърлени (МБ): 798, съотношение 0.24, разходи (%): 299, тежка изхвърляща 计数: 38, текущо кеширане DataBlock (%): 20
изхвърлени (МБ): 798, съотношение 0.29, разходи (%): 299, тежка изхвърляща 计数: 39, текущо кеширане DataBlock (%): 18
изхвърлени (МБ): 570, съотношение 0.27, разходи (%): 185, тежка изхвърляща 计数: 40, текущо кеширане DataBlock (%): 17
изхвърлени (МБ): 456, съотношение 0.22, разходи (%): 128, тежка изхвърляща 计数: 41, текущо кеширане DataBlock (%): 16
изхвърлени (МБ): 342, съотношение 0.16, разходи (%): 71, тежка изхвърляща 计数: 42, текущо кеширане DataBlock (%): 16
изхвърлени (МБ): 342, съотношение 0.11, разходи (%): 71, тежка изхвърляща 计数: 43, текущо кеширане DataBlock (%): 16
изхвърлени (МБ): 228, съотношение 0.09, разходи (%): 14, тежка изхвърляща 计数: 44, текущо кеширане DataBlock (%): 16
изхвърлени (МБ): 228, съотношение 0.07, разходи (%): 14, тежка изхвърляща 计数: 45, текущо кеширане DataBlock (%): 16
изхвърлени (МБ): 228, съотношение 0.05, разходи (%): 14, тежка изхвърляща 计数: 46, текущо кеширане DataBlock (%): 16
изхвърлени (МБ): 222, съотношение 0.04, разходи (%): 11, тежка изхвърляща 计数: 47, текущо кеширане DataBlock (%): 16
изхвърлени (МБ): 104, съотношение 0.03, разходи (%): -48, тежка изхвърляща 计数: 47, текущо кеширане DataBlock (%): 21 < прекъсване на получаванията
изхвърлени (МБ): 684, съотношение 0.2, разходи (%): 242, тежка изхвърляща 计数: 48, текущо кеширане DataBlock (%): 19
изхвърлени (МБ): 570, съотношение 0.23, разходи (%): 185, тежка изхвърляща 计数: 49, текущо кеширане DataBlock (%): 18
изхвърлени (МБ): 342, съотношение 0.22, разходи (%): 71, тежка изхвърляща 计数: 50, текущо кеширане DataBlock (%): 18
изхвърлени (МБ): 228, съотношение 0.21, разходи (%): 14, тежка изхвърляща 计数: 51, текущо кеширане DataBlock (%): 18
изхвърлени (МБ): 228, съотношение 0.2, разходи (%): 14, тежка изхвърляща 计数: 52, текущо кеширане DataBlock (%): 18
изхвърлени (МБ): 228, съотношение 0.18, разходи (%): 14, тежка изхвърляща 计数: 53, текущо кеширане DataBlock (%): 18
изхвърлени (МБ): 228, съотношение 0.16, разходи (%): 14, тежка изхвърляща 计数: 54, текущо кеширане DataBlock (%): 18
изхвърлени (МБ): 228, съотношение 0.14, разходи (%): 14, тежка изхвърляща 计数: 55, текущо кеширане DataBlock (%): 18
изхвърлени (МБ): 112, съотношение 0.14, разходи (%): -44, тежка изхвърляща 计数: 55, текущо кеширане DataBlock (%): 23 < обратна налягане
изхвърлени (МБ): 456, съотношение 0.26, разходи (%): 128, тежка изхвърляща 计数: 56, текущо кеширане DataBlock (%): 22
изхвърлени (МБ): 342, съотношение 0.31, разходи (%): 71, тежка изхвърляща 计数: 57, текущо кеширане DataBlock (%): 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 58, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 59, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 60, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 61, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 62, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 63, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.32, накладные расходы (%): 71, счетчик тяжелых выселений: 64, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 65, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 66, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.32, накладные расходы (%): 71, счетчик тяжелых выселений: 67, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 68, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.32, накладные расходы (%): 71, счетчик тяжелых выселений: 69, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.32, накладные расходы (%): 71, счетчик тяжелых выселений: 70, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 71, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 72, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 73, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 74, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 75, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 342, соотношение 0.33, накладные расходы (%): 71, счетчик тяжелых выселений: 76, текущий процент кэширования DataBlock: 22
изгоняемые (МБ): 21, соотношение 0.33, накладные расходы (%): -90, счетчик тяжелых выселений: 76, текущий процент кэширования DataBlock: 32
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
evicted (MB): 0, ratio 0.0, overhead (%): -100, heavy eviction counter: 0, current caching DataBlock (%): 100
Скани бяха нужни, за да се покаже този същия процес под формата на графика на съотношението между двата раздела на кеша — single (където попадат блоковете, които никой не е искал) и multi (тук се съхраняват „изисквани“ поне веднъж данни):
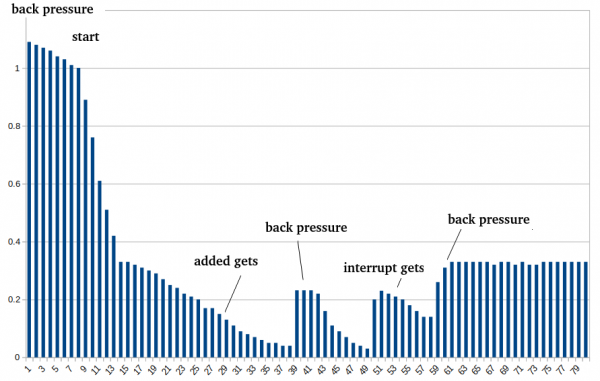
И накрая, как изглежда работата на параметрите под формата на графика. За сравнение кешът беше напълно изключен в началото, след това HBase стартира с кеширане и отлагане на началото на оптимизацията с 5 минути (30 цикъла на виселение).
Пълният код може да бъде намерен в Pull Request на github.
Въпреки това, 300 000 четения в секунда не е всичко, което може да се извлече на това оборудване при тези условия. Факт е, че когато е необходимо да се достъпят данните чрез HDFS, се използва механизма ShortCircuitCache (по-нататък SSC), който позволява достъп до данните директно, избягвайки мрежови взаимодействия.
Профилировката показа, че този механизъм, въпреки че осигурява голямо предимство, сам по себе си в някакъв момент става тясно място, защото почти всички тежки операции протичат вътре в lock, което води до блокировки през по-голямата част от времето.
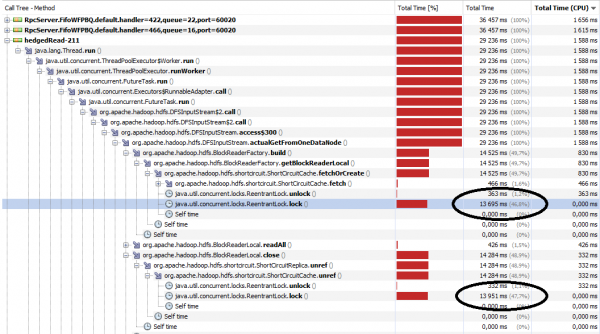
Разбирайки това, осъзнахме, че проблемът може да бъде заобиколен, ако създадем масив от независими SSC:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
И след това работим с тях, изключвайки пресечените по последната цифра на оффсета:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Сега можем да започнем с тестовете. За целта ще четем файлове от HDFS с прост многопоточен приложението. Излагаме параметрите:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // по подразбиране = 1 МБ и това значително забавя четенето, затова е по-добре да се приведат в съответствие с реалните нужди
conf.set("dfs.client.short.circuit.num", num); // от 1 до 10
И просто четем файлове:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Този код се изпълнява в отделни потоци и ще увеличим броя на четените файлове едновременно (от 10 до 200 — хоризонталната ос) и броя на кешовете (от 1 до 10 — графики). Вертикалната ос показва ускорението, което дава увеличаването на SSC в сравнение с случая, когато кешът е само един.
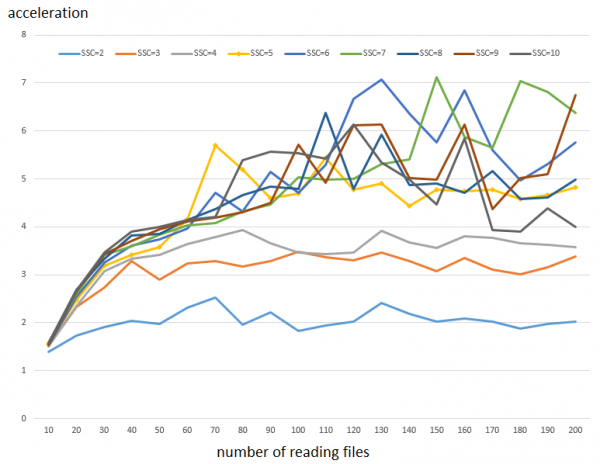
Как да четем графика: времето за изпълнение на 100 хиляди четения на блокове по 64 КБ с един кеш изисква 78 секунди. Докато с 5 кеша това се изпълнява за 16 секунди. Т.е. има увеличаване ~5 пъти. Както се вижда от графика, при малък брой паралелни четения ефектът не е много забележителен, но това започва да играе забележителна роля, когато броят на четенията на потоци е над 50. Също така е видно, че увеличаването на броя на SSC от 6 и нагоре дава значително по-малко нарастване на производителността.
Бележка 1: тъй като резултатите от тестването са достатъчно променливи (вижте по-долу), бяха извършени 3 стартирания и получените стойности бяха средно арифметично.
Бележка 2: Увеличението на производителността от настройката за произволен достъп е същото, въпреки че самият достъп е малко по-бавен.
Въпреки това е важно да се уточни, че за разлика от случая с HBase, това ускорение не винаги е безплатно. Тук по-скоро "разблокираме" възможностите на CPU да върши работа, вместо да изчаква на локове.
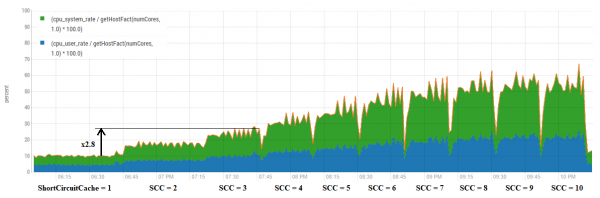
Тук може да се наблюдава, че увеличаването на броя кешове дава приблизително пропорционален ръст в използването на CPU. Въпреки това, има няколко по-печеливши комбинации.
Например, нека се спрем внимателно на настройката SSC = 3. Ръстът на производителността в диапазона е около 3.3 пъти. По-долу са резултатите от трите отделни старта.
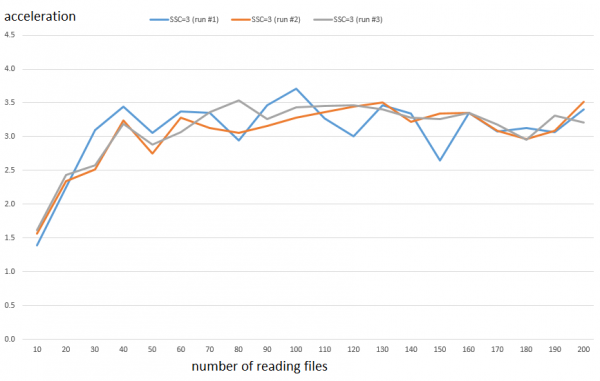
Докато потреблението на CPU расте приблизително 2.8 пъти. Разликата не е много голяма, но малката Грета вече е доволна и може да се появи време за посещение на училище и уроци.
Така че това ще има положителен ефект за всеки инструмент, който използва масов достъп до HDFS (например Spark и т.н.), при условие че приложният код е лек (т.е. опашката е именно на страна клиента HDFS) и има свободни ресурси на CPU. За проверка, нека тестваме какъв ефект ще даде съвместното приложение на оптимизацията BlockCache и настройката на SSC за четене от HBase.
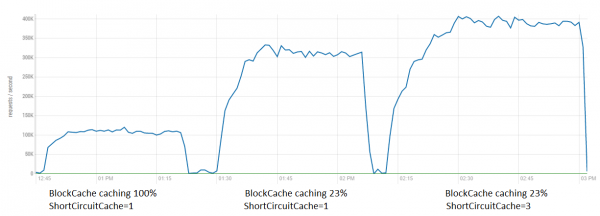
Тук е видно, че при такива условия ефектът не е толкова голям, колкото при прецизирани тестове (четене без никаква обработка), обаче да се извлекат допълнителни 80К е напълно възможно. В съвкупност, двете оптимизации дават ускорение до 4 пъти.
Също така по тази оптимизация беше направен PR , който беше приет и тази функционалност ще бъде достъпна в следващите издания.
И накрая, беше интересно да сравним производителността на четене на подобна wide-column база данни Cassandra и HBase.
За целта бяха стартирани инстанции на стандартния инструмент за натоварване YCSB от две хостове (800 нишки общо). На сървърната страна — по 4 инстанции RegionServer и Cassandra на 4 хостове (не същите, където са стартирани клиентите, за да се избегне тяхното влияние). Четенето се извършваше от таблици с размер:
HBase — 300 GB на HDFS (100 GB чисти данни)
Cassandra — 250 GB (репликационен фактор = 3)
Т.е. обемът беше приблизително одинаков (в HBase малко повече).
Параметри на HBase:
dfs.client.short.circuit.num = 5 (оптимизация на клиента HDFS)
hbase.lru.cache.heavy.eviction.count.limit = 30 — това означава, че патчът ще започне да работи след 30 виселвания (~5 минути)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — целеви обем на кеширане и виселване
Логовете на YCSB бяха обработени и сведени в графики в Excel:
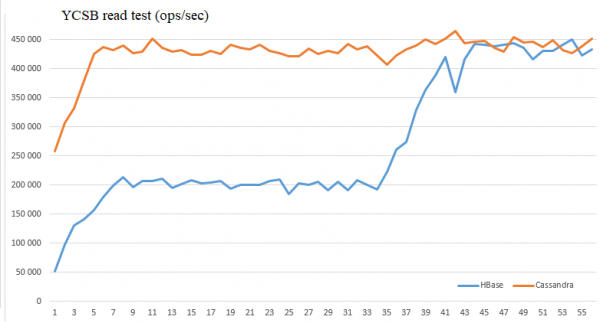
Както се вижда, оптимизационните данни позволяват да се подобри производителността на тези БД при тези условия и да се достигне 450 хиляди четения в секунда.
Надяваме се, че тази информация може да бъде полезна на някого в увлекателната борба за производителност.
Източник: habr.com
