

В работата си често се сблъсквам с нови технически решения/програмни продукти, за които информацията в българския интернет е доста ограничена. С тази статия се опитвам да запълня едно такова пространство с пример от напоследък, когато се наложи да настроя изпращането на CDC-събития от две популярни СУБД (PostgreSQL и MongoDB) в Kafka клъстер с помощта на Debezium. Надявам се, че тази обзорна статия, която се появи след извършената работа, ще бъде полезна и на други.
Какво е Debezium и изобщо CDC?
е представител на категорията софтуер CDC (), или по-точно - това е набор от конектори за различни СУБД, съвместими с Apache Kafka Connect.
Това използва лиценз Apache License v2.0 и е спонсориран от компания Red Hat. Разработката започна през 2016 година и в момента той поддържа официално следните СУБД: MySQL, PostgreSQL, MongoDB, SQL Server. Съществуват и конектори за Cassandra и Oracle, но в момента те са в статус на "ранен достъп", а новите версии не гарантират обратна съвместимост.
Ако сравним CDC с традиционния подход (когато приложението чете данни директно от СУБД), основните му предимства са реализиране на стрийминг на изменение на данните на ниво ред с ниска латентност, висока надеждност и наличност. Последните две характеристики се постигат благодарение на използването на Kafka клъстер като хранилище за CDC-събития.
Към предимствата може да се добави и фактът, че за съхранение на събитията се използва единна модел, така че крайното приложение не трябва да се тревожи за нюансите на експлоатация на различни СУБД.
Накрая, благодарение на използването на брокера за съобщения, се открива възможност за хоризонтално мащабиране на приложенията, наблюдаващи измененията в данните. Влиянието върху източника на данни е сведено до минимум, тъй като получаването на данни става не директно от СУБД, а от Kafka клъстера.
За архитектурата на Debezium
Използването на Debezium се свежда до такава проста схема:
СУБД (като източник на данни) → конектор в Kafka Connect → Apache Kafka → консумер
Като илюстрация ще приведем схема от сайта на проекта:
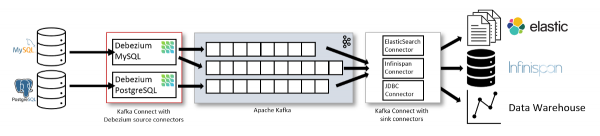
Въпреки това, не ми харесва много тази схема, тъй като оставя впечатление, че е възможно само използване на sink-конектор.
На практика ситуация отличается: напълването на вашето Data Lake (последното звено на схемата по-горе) — това не е единственият начин за приложение на Debezium. Събитията, изпратени в Apache Kafka, могат да се използват от вашите приложения за решаване на различни ситуации. Например:
- премахване на ненужни данни от кеша;
- изпращане на известия;
- актуализации на търсещи индекси;
- някакъв вид одитни логове;
- …
В случай, че имате приложение на Java и няма нужда/възможност да използвате Kafka клъстер, съществува и възможност за работа чрез . Ясното предимство е, че с него можете да се откажете от допълнителната инфраструктура (като например конектора и Kafka). Въпреки това, това решение е обявено за остаряло (deprecated) от версия 1.1 и вече не се препоръчва за употреба (в бъдещи версии поддръжката му може да бъде премахната).
В тази статия ще се разглежда препоръчителната архитектура от разработчиците, която осигурява отказоустойчивост и възможност за мащабиране.
Конфигурация на конектора
За да започнем да проследяваме промените на най-ценния ресурс — данните, ни е необходима:
- източник на данни, който може да бъде MySQL от версия 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- кластер Apache Kafka;
- инстанция на Kafka Connect (версии 1.x, 2.x);
- конфигуриран конектор Debezium.
Работите по първите две точки, т.е. процесът на инсталирае на СУБД и Apache Kafka, излизат извън обхвата на статията. Въпреки това, за тези, които искат да стартират всичко в пясъчник, в официалното репо с примери има готов .
Ние ще се спрем по-подробно на последните две точки.
0. Kafka Connect
Тук и нататък в статията всички примери за конфигурация ще бъдат разгледани в контекста на Docker образа, разпространяван от разработчиците на Debezium. Той съдържа всички необходими файлове с приставки (конектори) и предвижда конфигурация на Kafka Connect чрез променливи на средата.
В случай, че се предполага използване на Kafka Connect от Confluent, ще трябва сами да добавите необходимите приставки за конектори в директорията, посочена в plugin.path или зададена чрез променлива на средата CLASSPATH. Настройките на работника на Kafka Connect и конекторите се определят чрез конфигурационни файлове, които се подават като аргументи на командата за стартиране на работника. Подробности вижте в .
Целият процес на настройка Debeizium с конектор се извършва в два етапа. Нека разгледаме всеки от тях:
1. Настройка на фреймуърка Kafka Connect
За стрийминга на данни в кластера Apache Kafka фреймуъркът Kafka Connect задава специфични параметри, като:
- параметри за свързване с кластера,
- имена на теми, в които ще се съхранява самата конфигурация на конектора,
- име на групата, в която е стартиран конекторът (в случай на използване на distributed-режим).
Официалният Docker образ на проекта поддържа конфигурация с помощта на променливи на средата — нека го използваме. Скачваме образа:
docker pull debezium/connectМинималния набор от променливи на средата, необходим за стартиране на конектора, изглежда по следния начин:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— начален списък на сървърите на кластера Kafka, за получаване на пълен списък на членовете на кластера; -
OFFSET_STORAGE_TOPIC=connector-offsets— тема за съхраняване на позициите, на които в момента се намира конекторът; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— тема за съхраняване на статуса на конектора и неговите задачи; -
CONFIG_STORAGE_TOPIC=connector-config— тема за съхраняване на данните от конфигурацията на конектора и неговите задачи; -
GROUP_ID=1— идентификатор на групата работници, на които може да се изпълнява задачата на конектора; необходим при използване на разпределен (distributed) режим.
Стартираме контейнера с тези променливи:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Бележка относно Avro
По подразбиране Debezium записва данните в формат JSON, което е приемливо за пясъчници и малки обеми от данни, но може да се окаже проблем в силно натоварени бази. Алтернатива на JSON конвертора е сериализацията на съобщения в бинарен формат, което позволява да се намали натискът върху подсистемата I/O в Apache Kafka.
За да се използва Avro, е необходимо да се разверне отделен (за съхраняване на схеми). Променливите за конвертора ще изглеждат по следния начин:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Детайли за използването на Avro и настройката на registry извънлизат рамките на статията — по-долу, за визуализация, ще използваме JSON.
2. Настройка на самия конектор
Сега можете да преминете направо към конфигурацията на самия конектор, който ще чете данни от източника.
Нека разгледаме примера на конектори за две СУБД: PostgreSQL и MongoDB, — за които имам опит и по които има разлики (макар и малки, но в някои случаи — съществени!).
Конфигурацията се описва в JSON нотация и се зарежда в Kafka Connect чрез POST заявка.
2.1. PostgreSQL
Пример за конфигурация на конектора за PostgreSQL:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
Принципът на работа на конектора след такава настройка е доста прост:
- При първоначалното стартиране той се свързва с базата, посочена в конфигурацията, и стартира в режим initial snapshot, изпращайки в Kafka начален набор от данни, получени с помощта на условно
SELECT * FROM table_name. - След като инициализацията бъде завършена, конекторът преминава в режим на четене на промени от WAL файловете на PostgreSQL.
За използваните опции:
-
name— името на конектора, за който се използва конфигурацията, описана по-долу; в бъдеще това име се използва за работа с конектора (т.е. за преглед на статуса/рестартиране/актуализиране на конфигурацията) чрез REST API на Kafka Connect; -
connector.class— класът на конектора на СУБД, който ще се използва от конфигурируемия конектор; -
plugin.name— името на плъгина за логично декодиране на данните от WAL файловете. На разположение саwal2json,decoderbuffsиpgoutput. Първите две изискват инсталиране на съответните разширения в СУБД, аpgoutputза PostgreSQL версия 10 и по-висока не изисква допълнителни манипулации; -
database.*— опции за свързване с БД, къдетоdatabase.server.name— името на инстанцията на PostgreSQL, използвано за формиране на името на темата в клъстера на Kafka; -
table.include.list— списък на таблиците, които искаме да проследяваме за промени; задава се във форматschema.table_name; не може да се използва заедно сtable.exclude.list; -
heartbeat.interval.ms— интервал (в милисекундах), с който конекторът изпраща heartbeat съобщения в специална тема; -
heartbeat.action.query— заявка, която ще се изпълнява при изпращане на всяко heartbeat съобщение (опцията е налична от версия 1.1); -
slot.name— име на слота за репликация, който ще се използва от конектора; publication.name— име в PostgreSQL, която използва конекторът. В случай че тя не съществува, Debezium ще се опита да я създаде. При недостатъчни права на потребителя, под който е свързването, за това действие — конекторът ще приключи с грешка;-
transformsопределя как точно да се променя названието на целевата тема:-
transforms.AddPrefix.typeпосочва, че ще използваме регулярни изрази; -
transforms.AddPrefix.regex— маска, по която се преопределя названието на целевата тема; -
transforms.AddPrefix.replacement— директно това, на което преопределяваме.
-
Повече за heartbeat и transforms
По подразбиране конекторът изпраща данни в Kafka при всяка записана транзакция, а нейният LSN (Log Sequence Number) записва в служебна тема offset. Но какво ще се случи, ако конекторът е настроен да чете не цялата база данни, а само част от нейните таблици (в които обновяването на данните не се случва често)?
- Конекторът ще чете WAL файловете и няма да открива в тях комит на транзакции в тези таблици, за които следи.
- Следователно той няма да обновява текущата си позиция нито в темата, нито в слота за репликация.
- Това от своя страна ще доведе до "задържане" на WAL файловете на диска и вероятното изчерпване на цялото дисково пространство.
И тук на помощ идват опциите heartbeat.interval.ms и heartbeat.action.query. Използването на тези опции в комбинация дава възможност всеки път при изпращането на heartbeat съобщение да се изпълнява заявка за промяна на данни в отделна таблица. По този начин постоянно се актуализира LSN, на който в момента е конекторът (в слота за репликация). Това позволява на СУБД да изтрие WAL файловете, които вече не са нужни. Повече информация за работата на опциите може да бъде намерена в .
Друга опция, която заслужава по-подробно внимание, е transforms. Въпреки че тя е по-скоро за удобство и естетика…
По подразбиране Debezium създава теми, ръководейки се от следната политика за именуване: serverName.schemaName.tableName. Това не винаги може да е удобно. Опциите transforms може да определим списък от таблици с помощта на регулярни изрази, евентите, от които трябва да се маршрутизират в тема с конкретно име.
В нашата конфигурация благодарение на В края на описанието на конфигурацията на конектора за PostgreSQL е важно да се споменат следните особености/ограничения в работата му: И така, ще заредим нашата конфигурация в конектора: Проверяваме, че зареждането е преминало успешно и конекторът е стартиран: Отлично: той е настроен и готов за работа. Сега ще се престорим на консуматор и ще се свържем с Kafka, след което ще добавим и променим запис в таблицата: В нашата тема това ще се отрази по следния начин: Много дълъг JSON с нашите промени В двата случая записите се състоят от ключа (PK) на записа, който е бил променен, и самата същина на промените: какъв е бил записа преди и какъв е станал след това. Този конектор използва стандартния механизъм на репликация на MongoDB, четейки информация от oplog'а на primary-нода на СУБД. По подобие на вече описания конектор за PgSQL, тук също при първото стартиране се прави първичен snapshot на данните, след което конекторът преминава в режим на четене на oplog'а. Примерна конфигурация: Както може да се види, тук няма нови опции в сравнение с миналия пример, но се е намалило само количеството опции, отговарящи за свързването с БД и техните префикси. Настройки Въпросът за отказоустойчивостта и високата достъпност в наши дни е по-актуален от всякога — особено когато говорим за данни и транзакции, а проследяването на промените в данните не остава настрана. Нека разгледаме какво в принципе може да се обърка и какво ще се случи с Debezium във всеки от случаите. Има три варианта на отказ: . Въпреки това съществуват изключения. Ако конекторът е бил в изключено състояние за продължително време (или не е могъл да достигне до инстанцията на MongoDB), а оплогът по време на това е преминал ротация, то при възстановяване на свързаността конекторът спокойно ще продължи да чете данни от първата налична позиция, поради което част от данните в Kafka не ще попадне. Debezium — моят първи опит с CDC системите и като цяло доста положителен. Проектът привлече с поддръжката на основни СУБД, простота на конфигурацията, поддръжка на кластеризация и активно общество. На заинтересованите практици препоръчвам да се запознаят с ръководствата за и . . В сравнение с JDBC конектора за Kafka Connect основното предимство на Debezium е, че промените се четат от журнали на СУБД, което позволява получаване на данни с минимално забавяне. JDBC Connector (от доставката на Kafka Connect) прави запитвания към наблюдаваната таблица с фиксиран интервал и (по тази причина) не генерира съобщения при изтриване на данни (как може да се запитат данни, които не съществуват?). За решаването на подобни задачи може да се обърне внимание на следните решения (освен Debezium): Прочетете също в нашия блог: Източник: habr.comtransforms се случва следното: всички CDC-събития от проследяваната база данни ще преминат в тема с името data.cdc.dbname. В противен случай (без тези настройки) Debezium по подразбиране ще създаде по тема за всяка таблица във вида: pg-dev.public..
Ограничения на конектора
Прилагане на конфигурацията
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date: Thu, 17 Sep 2020 20:19:40 GMT
Content-Type: application/json
Content-Length: 175
Server: Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERT: стойността преди (before) е равна на null, а след това — низът, който е бил вставен. UPDATE: в payload.before се показва предишното състояние на реда, а в payload.after — новото с същността на промените.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms този път правят следното: превръщат името на целевия топик от схемата <server_name>.<db_name>.<collection_name> в data.cdc.mongo_<db_name>.Отказоустойчивост
Заключение
P.S.
