

Изглежда, че разработчиците на Terraform предлагат достатъчно удобни най-добри практики за работа с AWS инфраструктура. Но има едно известно притеснение. С течение на времето броят на средите се увеличава, всяка от които има свои особености. Появява се почти копие на стека приложения в съседен регион. И кодът на Terraform трябва внимателно да се копира и редактира съобразно новите изисквания или да се създаде снежинка.
Моята презентация е за патерните в Terraform за справяне с хаоса и ръчната рутина в големи и дългосрочни проекти.
Видео:
На 40 съм, работя в IT 20 години. 12 години съм в компанията Ixtens. Занимаваме се с e-commerce driven development. И пет години практикувам DevOps практики.
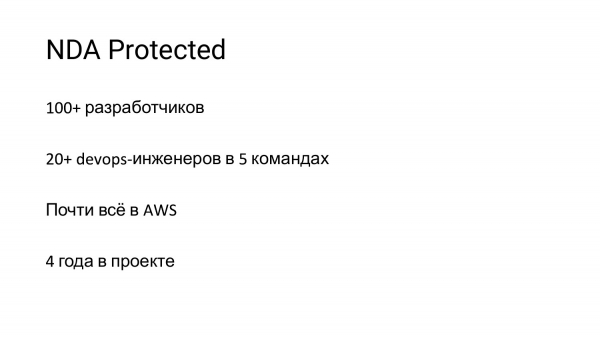
Моят разказ ще бъде за опит в проект в компания, чието име няма да спомена, прикривайки се зад споразумение за конфиденциалност.
Цифрите на слайда са посочени, за да се разбере мащабът на проекта. И всичко, за което ще говоря по-нататък, е свързано с Amazon.
Присъединих се към този проект преди 4 години. И в самия разгар преминавахме през рефакторинг на инфраструктурата, защото проектът се увеличи. И патерните, които бяха използвани, вече не бяха подходящи. И предвид целия планиран растеж на проекта, трябваше да измислим нещо ново.
Благодаря на Матвей, който вчера разказа какво се случваше в Додо Пица. Това е нещо, което се случваше при нас преди 4 години.
Дошли разработчици и започнаха да правят инфраструктурен код.
Най-очевидните моменти, защо това се наложи, е необходимостта от time to market. Трябваше да направим така, че DevOps екипът да не е слабата звено при внедряването. И освен всичко, на най-първото ниво се използваха Terraform и Puppet.
Terraform е open source проект на компанията HashiCorp. И за тези, които изобщо не знаят какво е това, следващите няколко слайда.
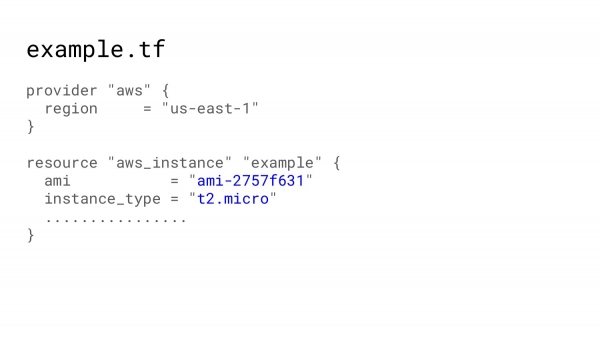
Инфраструктурата като код означава, че можем да опишем нашата инфраструктура и да поискаме от някакви роботи да направят така, че да получим тези ресурси, които сме описали.
Например, нуждаем се от виртуална машина. Ще я опишем и добавим няколко задължителни параметри.
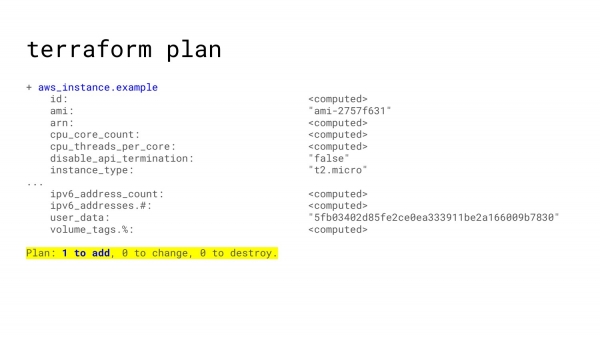
След това в конзолата ще настроим достъпа до Amazon. И ще помолим Terraform plan. Terraform plan ще каже: „Ок, за вашия ресурс можем да направим следните неща“. И най-малкото, един ресурс ще бъде добавен. И не се предвиждат промени.
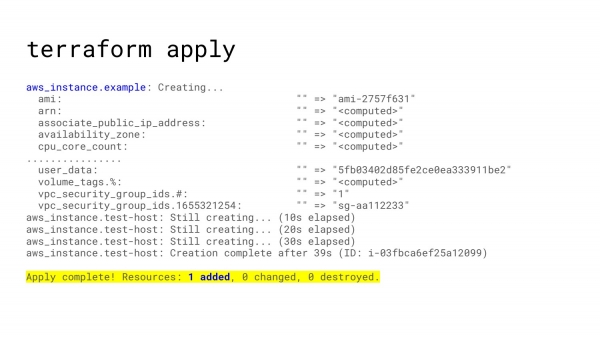
След като всичко е уредено, можете да заявите Terraform apply и Terraform ще създаде инстанс за вас, предоставяйки ви виртуална машина в облака.
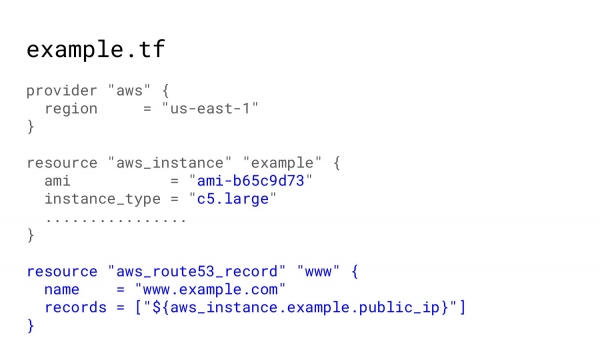
Следва проектът ни да се развива. Добавяме някои промени. Искаме още инстанции, добавяме 53 записа.
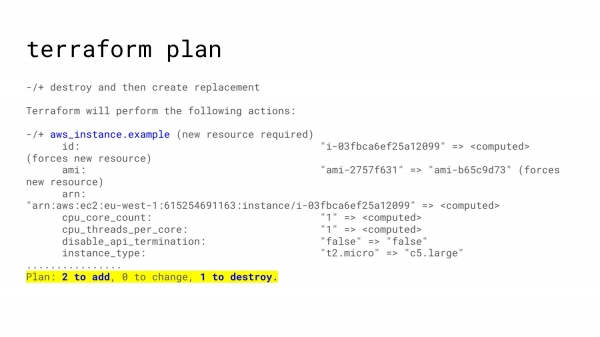
И повтаряме. Искаме план. Виждаме какви промени се планират. Прилагаме. И по този начин инфраструктурата ни расте.
Terraform използва така наречените state файлове. Тоест, всички промени, които отиват в Amazon, той запазва в файл, където за всеки ресурс, който сте описали, съществуват съответстващи ресурси, създадени в Amazon. Така че при промяна на описанието на определен ресурс, Terraform точно знае какво точно трябва да се промени в Amazon.
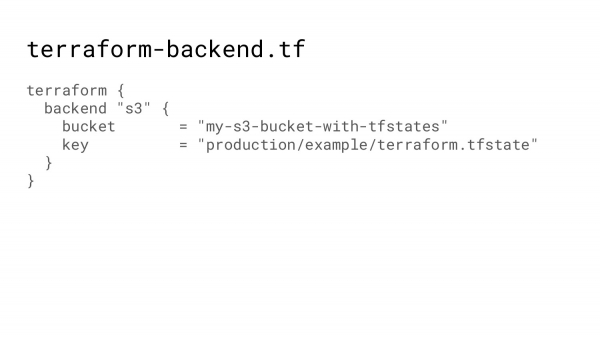
Първоначално тези state файлове бяха просто файлове. И ние ги съхранявахме в Git, което беше изключително неудобно. Постоянно някой забравяше да комитне промените и възникваха много конфликти.
Сега има възможност да се използва бекенд, т.е. Terraform указва в кой bucket, по какъв ключ да се запази state файлът. И Terraform сам ще се погрижи да вземе този state файл, да направи цялата магия и да положи обратно финалния резултат.
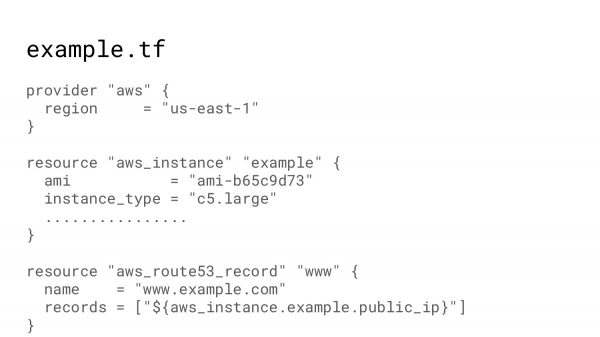
Инфраструктурата ни расте. Ето кода ни. И вече не искаме просто да създаваме виртуална машина, а желаем да имаме тестова среда.
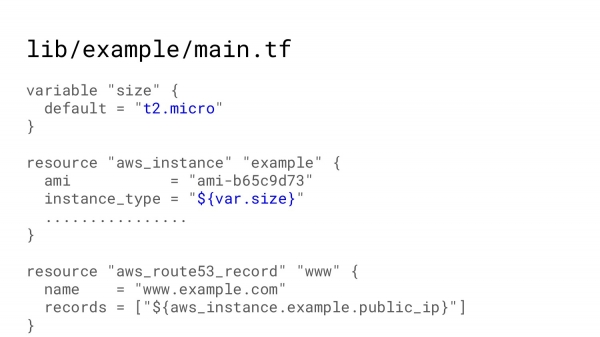
Terraform позволява създаването на модул, т.е. същото да бъде описано в папка.
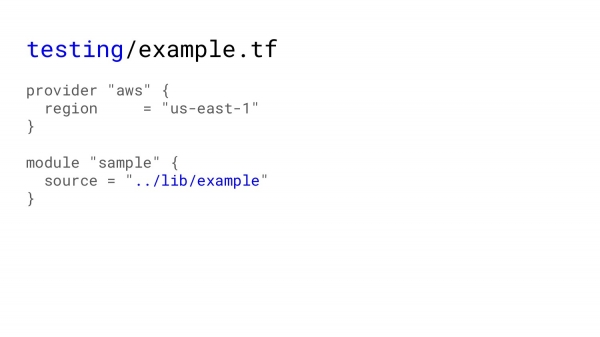
И например, в тестовото обкръжение да извикаме този модул и да получим същото, все едно сме изпълнили Terraform apply в самия модул. Кодът за тестове ще бъде такъв.
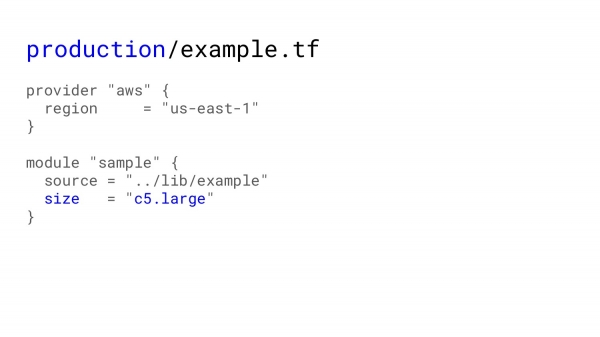
За продукцията можем да изпратим там някои промени, тъй като в тестовата среда не ни трябват големи инстанции, докато в продукцията големите инстанции ще бъдат полезни.
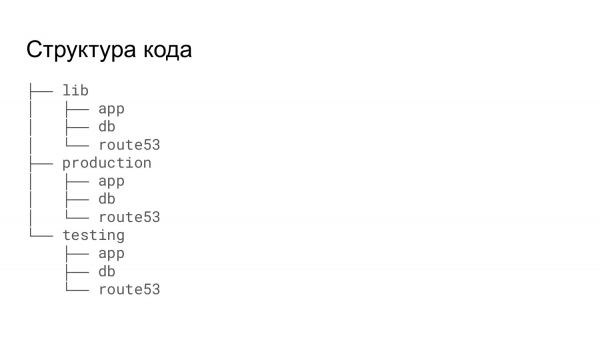
И след това ще се върна отново в проекта. Имаше сложна задача, инфраструктурата се планираше да бъде много голяма. И трябваше по някакъв начин да организираме целия код, така че да е удобно за всички: както за тези, които поддържат този код, така и за тези, които внасят промени. Планираше се, че всеки разработчик може да отиде и да коригира инфраструктурата според нуждите на неговата част от платформата.
Това е дървото на директориите, което самият HashiCorp препоръчва, ако имате голям проект и има смисъл да разделите цялата инфраструктура на малки части и всяка част да бъде описана в отделна папка.
С голяма библиотека от ресурси, може да се извиква почти същото в тестинг и в продукция.
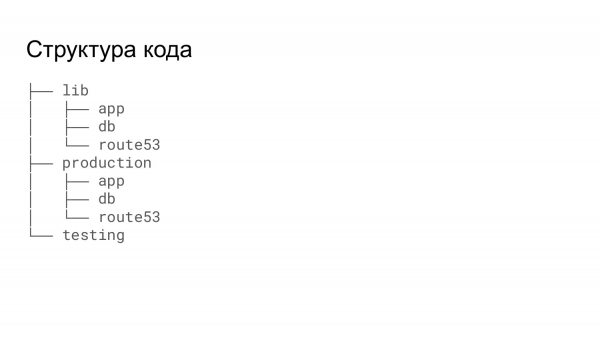
В нашия случай това не беше съвсем подходящо, защото тестовият стек за разработчици или за тестване трябваше да бъде получен по малко по-прост начин. Не ми се искаше да се разхождам из папките и да прилагам в нужната последователност, и да се тревожа дали базата ще се стартира, а след това ще се стартира инстанция, която използва тази база. Затова целият тестинг стартираше от една папка. Там се извикваха същите модули, но всичко минаваше с едно изпълнение.
Terraform се грижи за всички зависимости. И винаги създава ресурсите в такава последователност, че да може да получи IP адрес, например, от новосъздадена инстанция, и да получи този IP адрес в записа route53.
Освен това, платформата е много голяма. И стартирането на тестовия стек, дори и за един час, дори и за 8 часа - е доста скъпо.
И автоматизирахме този процес. Джобът на Jenkins позволяваше стартирането на стека. В него трябваше да се стартира pull request с промените, които разработчикът иска да тества, да се посочат всички нужни опции, компоненти, както и размери. Ако той иска Performance тестване, може да вземе повече инстанции. Ако просто иска да провери, че някаква форма се отваря, може да стартира на минималните параметри. Също така да посочи дали е необходим клъстър или не и т.н.
И след това Jenkins стартираше shell скрипт, който малко модифицираше кода в папката Terraform. Премахваше ненужните файлове, добавяше нужните файлове. И след това с едно изпълнение Terraform apply стекът се стартираше.
А след това идваха други стъпки, в които не искам да се задълбочавам.
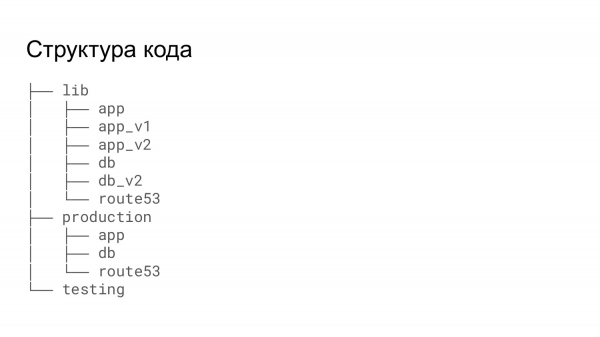
Заради факта, че за тестинга ни бяха нужни малко повече опции, отколкото в продукцията, ни се налагаше да създаваме копия на модулите, за да можем в тези копия да добавим онези функции, които са нужни само за тестинга.
И така се оказа, че в тестинга искахме да тестваме онези промени, които в крайна сметка ще отидат в продукция. Но всъщност се тествало едно, а в продукция се прилагало малко друго. И имаше малка разлика, че в продукцията всички промени се прилагаха от оперативния екип. И понякога се случваше така, че онези промени, които трябваше да преминат от тестинга в продукция, оставали в друга версия.
Освен това имаше и проблема, че се добавяше нова услуга, която малко се различаваше от вече съществуваща. И вместо да модифицираме съществуващия модул, трябваше да направим негово копие и да добавим необходимите промени.
По същество, Terraform не е истински език. Това е декларация. Ако трябва да декларираме нещо, го декларираме. И всичко това работи.
В един момент, когато беше обсъждан един от моите pull request-и, един от колегите каза, че не трябва да се генерират снежинки. Заинтересувах се какво има предвид. Има научен факт, че в света няма две еднакви снежинки, всичките са малко, но различни. И когато чух това, веднага усетих цялата тежест на Terraform кода. Защото, когато беше необходимо да преминем от версия на версия, Terraform изискваше breaking chain промяна, т.е. кодът вече не беше съвместим с следващата версия. Трябваше да направя pull request, който покриваше почти половината файлове в инфраструктурата, за да приведем инфраструктурата към следващата версия на Terraform.
И след като се появи такава снежинка, целият Terraform код, който имахме, се превръщаше в голяма купчина сняг.
За външен разработчик, който е извън операцията, това няма голямо значение, защото той е направил pull request, ресурсът му е стартирал. И всичко, след това не е негова грижа. А на екипа DevOps, който следи всичко да е наред, им се налага да направят всички тези промени. И цената на тези промени нараства много с всяка допълнителна снежинка.
Има една история за студент, който на семинар рисува два идеални кръга с тебешир на дъската. Преподавателят се учудва как е успял толкова точно да ги нарисува без компас. Студентът отговаря: "Много просто, две години в армията завъртах машинка за месо."
От четирите години, в които участвам в този проект, около две години се занимавам с Terraform. И, разбира се, имам някои трикове, някои съвети как да опростим Terraform кода, да работим с него като с програмируем език и да намалим натоварването на разработчиците, които трябва да поддържат този код актуален.
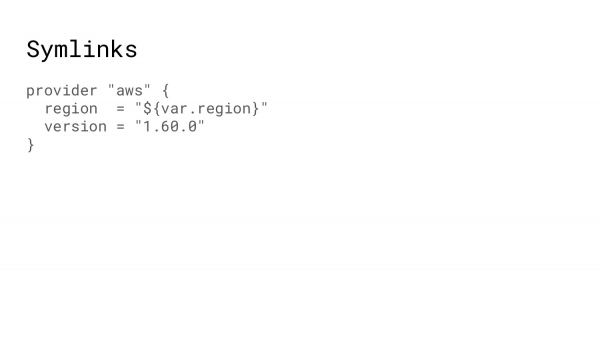
Първото, с което искам да започна, е Symlinks. Terraform има много повторящ се код. Например, извикването на провайдера е практически на всяка точка, където създаваме парче инфраструктура, едно и също. И логично е да го изнесем в отделна папка. И навсякъде, където е необходим провайдер, да се правят Symlinks на този файл.
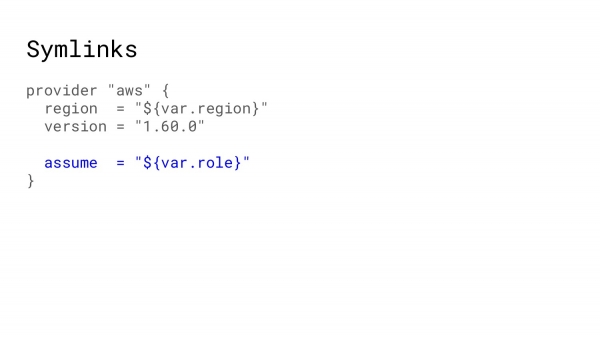
Например, в продукция използвате assume role, който ви позволява да получите права за достъп до някакъв външен Amazon акаунт. И променяйки един файл, всички останали, които са в дървото на ресурсите, ще имат необходимите права, така че Terraform да знае към кой сегмент на Amazon да се обърне.
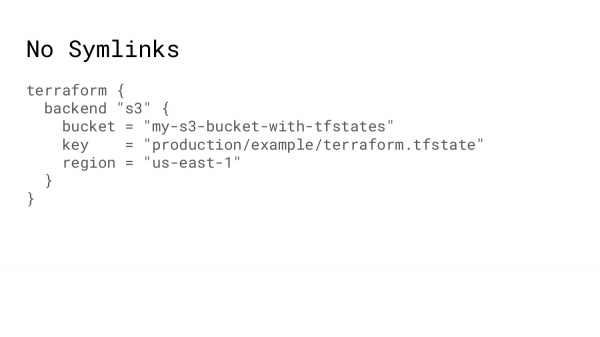
Къде не работят Symlinks? Както казах, в Terraform има state файлове. И те са много- много страхотни. Но проблемът е, че Terraform инициализира бекенда в самото начало. И той не може да използва в тези параметри каквито и да било променливи, те винаги трябва да бъдат написани текстово.
И в резултат, когато някой създава нов ресурс, той копира част от кода от други папки. И може да допусне грешка с ключа или с bucket. Например, той от sandbox прави нещо в sandbox, а после работи в продукция. И така може да се окаже, че bucket в продукцията ще се използва от sandbox. Разбира се, това бързо ще бъде открито. Може да се поправи по някакъв начин, но все пак това е загуба на време и до известна степен ресурси.
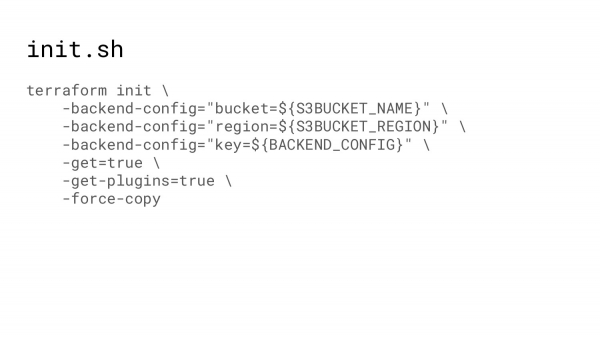
Какво можем да направим след това? Преди да работите с Terraform, трябва да го инициализирате. В момента на инициализация Terraform изтегля всички плъгини. Те в някакъв момент от монолита се разделиха на по-микросервисна архитектура. И винаги трябва да правите Terraform init, за да изтегли всички модули, всички плъгини.
И можете да използвате shell-скрипт, който, от една страна, ще може да извлече всички променливи. Shell-скриптът не е ограничен. А, от друга страна, пътища. Ако винаги използваме този път, който в репозитория служи като ключ към state файла, то съответно, грешката тук ще бъде изключена.
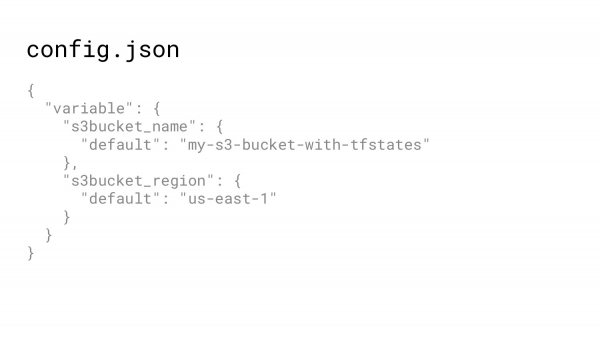
От къде да извлечем данни? JSON файл. Terraform позволява записването на инфраструктура не само в hcl (HashiCorp Configuration Language), но и в JSON.
JSON лесно се чете от shell-скрипт. Съответно, можете да поставите конфигурационния файл с bucket на някое място. И да използвате този bucket и в Terraform кода, и в shell-скрипта за инициализация.
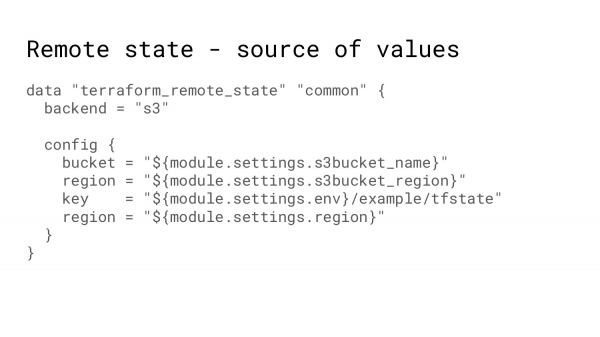
Защо е важно да имате bucket за Terraform? Защото съществува нещо, наречено remote state файлове. Тоест, когато създавам някакъв ресурс, за да кажа на Amazon: „Моля, пусни инстанс“, трябва да посоча много задължителни параметри.
И тези идентификатори се съхраняват в някаква друга папка. И мога да кажа: „Terraform, отиди, моля, до state файла на този ресурс и ми извади тези идентификатори“. И по този начин се постига определена унификация между различните региони или среди.
Не винаги е възможно да се използва отдалечен state файл. Например, ако ръчно сте създали VPC. И Terraform кодът, който създава VPC, създава толкова различен VPC, че ще отнеме много време и усилия да адаптирате едно към друго, затова можете да използвате следния трик.
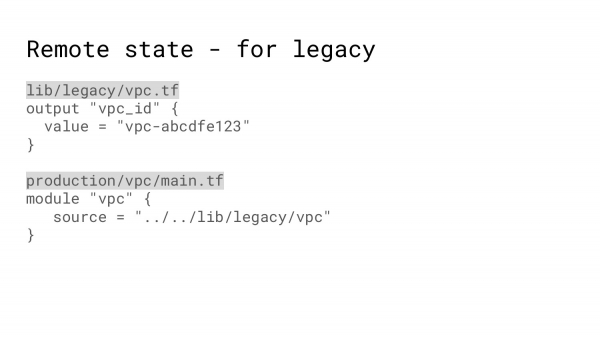
Тоест, да направите модул, който по някакъв начин създава VPC и предоставя идентификатори, а всъщност просто има файл със захардкодени стойности, който може да се използва за създаване на същия инстанс.
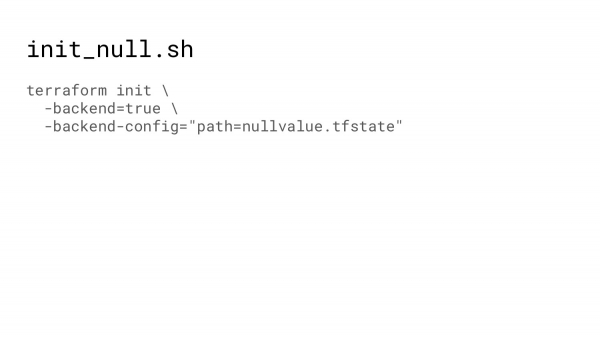
Не винаги е необходимо да се съхранява state файл в облака. Например, когато тествате модули, можете да използвате инициализация на бекенда, когато файлът ще се съхранява просто на диска по време на тестването.
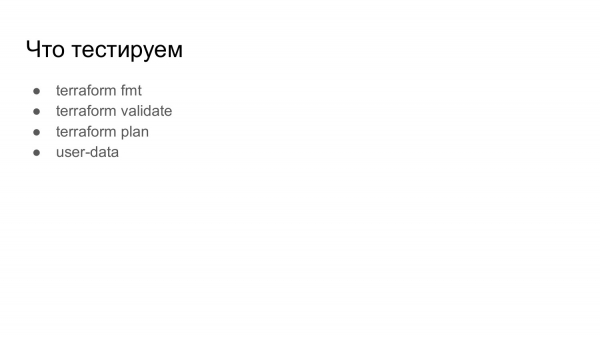
Сега малко за тестването. Какво може да се тества в Terraform? Вероятно много неща, но ще говоря за тези 4 неща.
HashiCorp има разбиране как трябва да се форматира Terraform кодът. И Terraform fmt ви позволява да форматирате кода, който редактирате в съответствие с това разбиране. Съответно, тестовете трябва задължително да проверят дали форматирането съответства на това, което е завещал HashiCorp, за да не се налага да променяте разположението на скобичките и т.н.
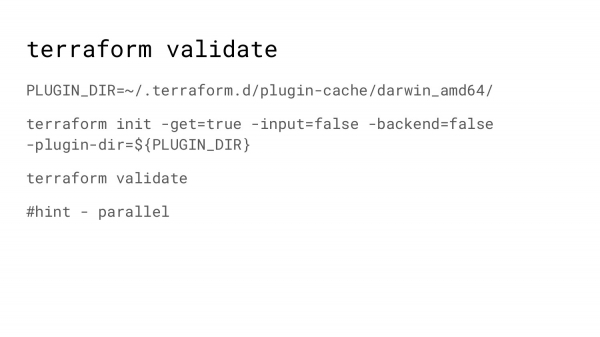
Следващото е Terraform validate. Той прави нещо малко повече от проверка на синтаксиса – дали всичките скобки са парни. Какво е важно тук? Нашата инфраструктура е много разпръсната. Има много различни папки. И във всяка от тях трябва да пуснем Terraform validate.
Съответно, за да ускори тестването, пускаме няколко процеса паралелно, използвайки паралелизъм.
Паралелизъм – това е наистина страхотно нещо, използвайте го.
Но всеки път, когато се инициализира Terraform, той отива при HashiCorp и пита: «Кои са последните версии на плъгините? А този плъгин, който имам в кеша – същият ли е или не?». И това забавя процеса на всяка стъпка.
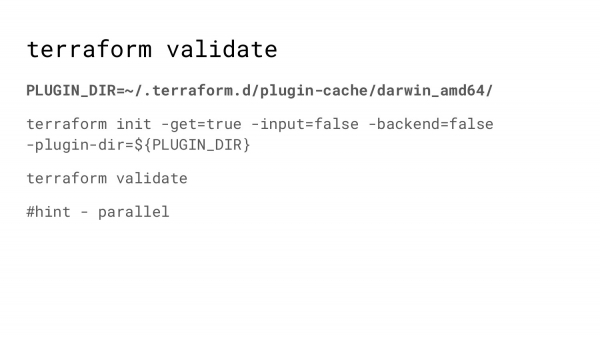
Ако на Terraform му се кажат къде се намират плъгините, той ще каже: «Ок, вероятно това е най-новото, което имам. Няма да ходя никъде, веднага ще започна да валидирам вашия Terraform код».
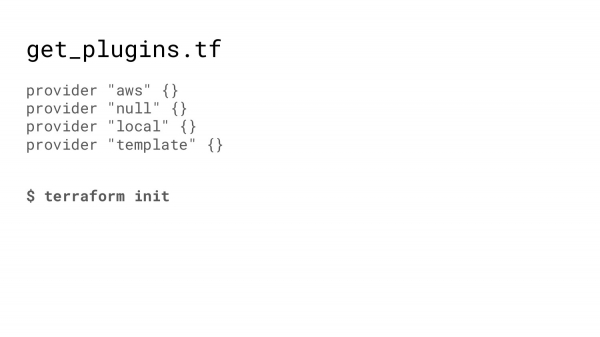
За да напълним папката с нужните плъгини, имаме много прост Terraform код, който просто трябва да инициализираме. Тук, разбира се, е нужно да посочим всички доставчици, които участват в кода, иначе Terraform ще каже: «Не знам за този доставчик, защото го няма в кеша».
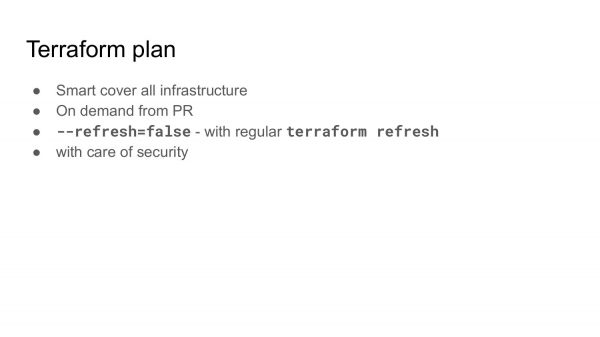
Следващото е Terraform plan. Както казах, разработката е циклична. Правим код с промени. И след това трябва да разберем какви изменения се планират за инфраструктурата.
И когато инфраструктурата е много голяма, може да промените един модул, да поправите тестова среда или конкретен регион и да счупите нещо съседно. Затова Terraform plan трябва да се прави за цялата инфраструктура и да показва какви промени се предвиждат.
Може да направите това по умния начин. Например, написахме скрипт на Python, който разрезолвява зависимостите. И в зависимост от това, което е променено: Terraform модул или просто конкретен компонент, той прави планове за всички зависими папки.
Terraform plan трябва да се прави по заявка. Най-малкото, това е което ние правим.
Разбира се, добре е да се правят тестове за всяка промяна, за всяко комитване, но плановете са доста скъпи. И в pull request казваме: «Моля, дай ми плановете». Стартира се робот. И той изпраща в коментарите или като прикачен файл всички планове, които се предвиждат от вашите промени.
Планът е нещо доста скъпо. Отнема време, защото Terraform отива в Amazon и пита: «Този инстанс все още ли съществува? Има ли този autoscale точно такива параметри?». И за да ускорите този процес, можете да използвате параметър refresh=false. Това означава, че Terraform ще извлече state от S3. И ще вярва, че state ще съответства точно на това, което се намира в Amazon.
Този Terraform план протича значително по-бързо, но състоянието трябва да съответства на вашата инфраструктура, тоест, понякога трябва да се изпълни Terraform refresh. Terraform refresh прави точно това, за да съответства състоянието на реалната инфраструктура.
И трябва да споменем за сигурността. С това трябваше да започнем. Там, където стартирате Terraform и Terraform работи с вашата инфраструктура, има уязвимост. Тоест, вие по същество изпълнявате код. И ако pull request съдържа злонамерен код, той може да се изпълни върху инфраструктура, която има прекалено много достъп. Затова бъдете внимателни, къде стартирате Terraform plan.
Следващото, за което искам да говоря, е тестването на user-data.
Какво е user-data? В Amazon, когато създаваме инстанция, можем да изпратим email - мета-данни от инстанцията. Когато инстанцията се стартира, обикновено cloud init винаги присъства на тези инстанции. Cloud init прочита този email и казва: „Ок, днес аз съм load balancer“. И в съответствие с тези указания извършва определени действия.
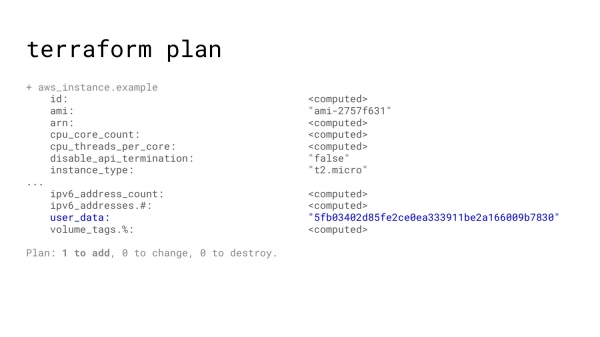
Но, за съжаление, когато правим Terraform plan и Terraform apply, user-data изглежда като безсмислица от числа. Тоест, просто ви изпраща хеш. И всичко, което можете да видите в плана, е дали ще има някакви промени или хешът ще остане същият.
И ако не обърнете внимание на това, е възможно на Amazon реалната инфраструктура да получи поврежден текстов файл.
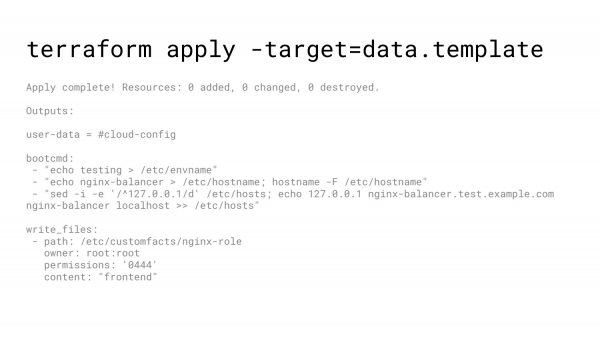
Като вариант, можете при изпълнението да посочите не цялата инфраструктура, а само шаблон. И в кода да кажете: „Моля, покажи ми този шаблон“. В крайна сметка можете да получите печат на това, как ще изглеждат вашите данни в Amazon.
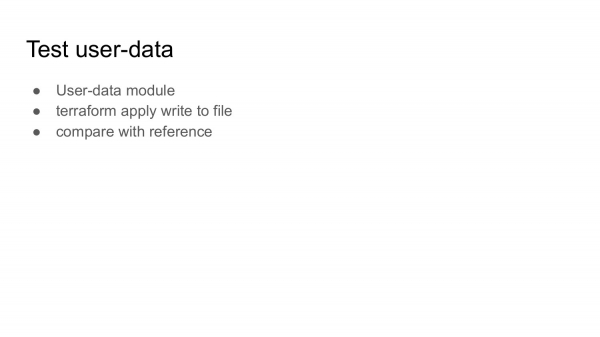
Друг вариант е да използвате модул за генериране на user-data. Вие прилагате този модул. Получавате файл на диска. Сравнявате го с референтен. А по този начин, ако някой начинаещ реши да направи малки промени в user-data, вашите тестове ще кажат: „Ок, тук и тук има някакви промени – това е нормално“.
Следващото, за което искам да говоря, е автоматизирането на Terraform apply.
Разбира се, е доста страшно да се прави Terraform apply автоматично, защото кой знае какви промени са направени и колко разрушителни могат да бъдат те за живата инфраструктура.
За тестова среда – това е напълно нормално. Т.е. работата, която създава тестова среда, е това, от което се нуждаят всички разработчици. И такова изразяване, като "всичко работеше за мен" – това не е смешен мем, а доказателство, че човекът се е ангажирал, е вдигнал стек, стартирал е тестове на този стек. И е убеден, че всичко е наред и е казал: "Ок, онзи код, който пускам, е бил тестван."
В продукция, песочница и други среди, които са по-важни за бизнеса, може частично да се прилагат някои ресурси сравнително безопасно, защото това не води до смърт. Това са: autoscale групи, security групи, роли, route53 и списъкът може да бъде доста дълъг. Но следете какво се случва, четете докладите за автоматичните приложения.
Където приложението е опасно или плашещо, например, ако става въпрос за ресурси с persistent, с бази данни, изисквайте отчети, че в някаква част от инфраструктурата има неизпълнени промени. И инженерът под надзор пуска jobs, за да приложи или прави това от своята конзола.
В Amazon има функция, наречена Terminate protection. И тя може да защити в някои случаи от нежелани за вас промени. Т.е. Terraform отива в Amazon и казва: "Трябва да убия този инстанс, за да направя друг." А Amazon отговаря: "Съжалявам, не днес. Имаме Terminate protection."
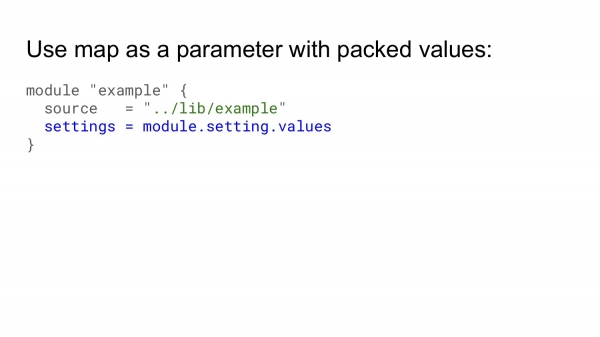
И вишенка на тортата – това е оптимизация на кода. Когато работим с Terraform код, трябва да предадем на модула много параметри. Това са параметрите, необходими за създаването на някакъв ресурс. И кодът се превръща в дълги списъци от параметри, които трябва да се предадат от модул на модул, от модул на модул, особено ако модулите са вложени.
И това е много сложно за четене. Много трудно е да се направи преглед. И често се оказва, че някои параметри преминават прегледа, но не са точно тези, от които се нуждаем. А това струва време и пари, за да се поправи по-късно.
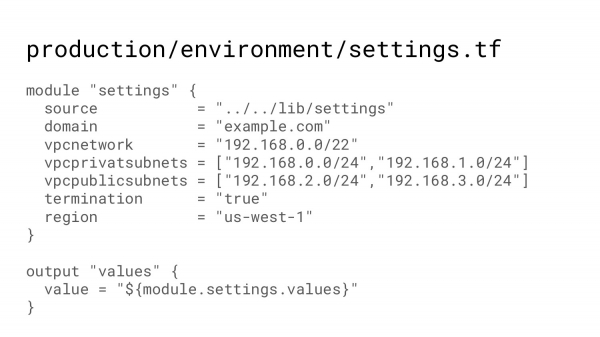
Затова ви предлагам да използвате функция, наречена сложен параметър, който включва едно дърво от стойности. Т.е. необходима е някаква папка, където са изброени всички стойности, които бихте искали да имате на някаква среда.
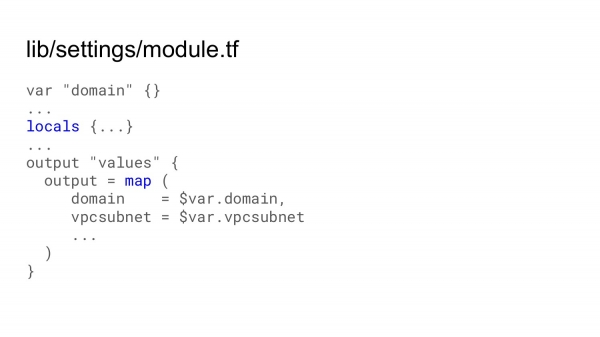
С призиването на този модул, можете да получите дървото, което се генерира в един общ модул, т.е. в общ модул, който работи еднакво за цялата инфраструктура.
В този модул можете да извършите определени изчисления, използвайки такава свежа функция в Terraform, като locals. И след това с един output да изведете някакъв сложен параметър, който може да включва хешове, масиви и т.н.
На това място завършват всичките ми най-добри открития. И искам да разкажа история за Колумб. Когато търсеше пари за експедицията си, за да открие Индия (както той смяташе), никой не му вярваше и го считаха за невъзможно. Тогава той каза: "Направете така, че яйцето да не падне". Всички банкери, много богати и вероятно умни хора, се опитваха по някакъв начин да поставят яйцето, но то постоянно падаше. Тогава Колумб взе яйцето, малко му натисна. Черупката се смачка и яйцето остана неподвижно. Те казаха: "О, това е твърде просто!". А Колумб отговори: "Да, това е твърде просто. И когато открия Индия, всички ще използват този търговски път."
И това, което ви разказах сега, вероятно са достатъчно простички и тривиални неща. И когато ги научите и започнете да ги използвате, е съвсем нормално. Така че използвайте ги. И ако за вас това са съвсем нормални неща, поне знаете как да поставите яйцето, за да не падне.
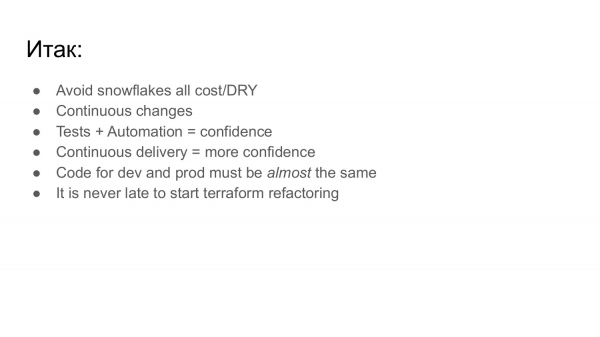
Нека обобщим:
- Опитайте се да избягвате снежинките. И колкото по-малко снежинки, толкова по-малко ресурси ще ви трябват, за да правите някакви промени в цялата ваша голяма инфраструктура.
- Постоянни промени. Т.е. когато в кода има някакви промени, трябва да приведете инфраструктурата си в съответствие с тези промени колкото се може по-бързо. Не трябва да има ситуация, в която някой след два-три месеца идва, за да погледне Elasticsearch, прави Terraform plan, а там има куп изменения, които не е очаквал. И се губи много време, за да се върне всичко в ред.
- Тестове и автоматизация. Колкото повече кодът ви е покрит с тестове и функции, толкова повече увереност имате, че правите всичко правилно. А автоматизираното разпространение ще увеличи увереността ви многократно.
- Кодът за тестовото и продукционно обкръжение трябва да бъде практически еднакъв. Практически, защото продукцията е малко по-различна и все пак ще има някои нюанси, които ще излизат извън тестовото обкръжение. Но все пак плюс-минус това може да бъде осигурено.
- Ако имате много Terraform-код и поддържането му в актуално състояние отнема много време, никога не е късно да направите рефакторинг и да го приведете в добра форма.
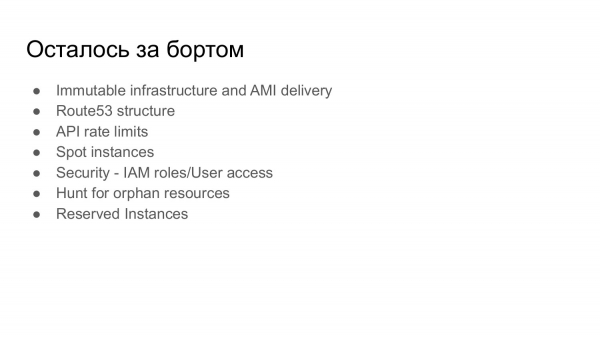
- Непроменлива инфраструктура. Доставка на AMI по график.
- Структура за route53, когато имате много записи и искате те да са в подреден вид.
- Борба с ограниченията на API. Това е, когато Amazon казва: 'Всичко, не мога да приемам повече заявки, моля, изчакайте'. И половината служители чакат, докато могат да развият инфраструктурата си.
- Spot инстанции. Amazon не е евтина работа и spot инстанциите позволяват значителни икономии. Може да се изнесе цяло изказване за това.
- Сигурност и IAM роли.
- Търсене на изгубени ресурси, когато имате инстанции в Amazon с неясен произход, те ядат пари. Дори ако инстанцията струва 100-150 долара на месец – за година това е над 1000. Търсенето на такива ресурси е доходоносна работа.
- И резервирани инстанции.
Това е всичко от мен. Terraform е наистина страхотно, използвайте го. Благодаря!
Въпроси
Благодаря за изказването! Вашият state-файл се съхранява в S3, а как решавате проблема, че няколко души могат да вземат този state-файл и да се опитат да се разгърнат?
На първо място, не бързаме. На второ, разполагаме с флагове, с които уведомяваме, че работим по някакъв участък от кода. Тоест, въпреки че инфраструктурата е много голяма, това не означава, че постоянно някой прилага нещо. И когато беше активната фаза – това беше проблем, нашите state-файлове се съ храниха в Git. Това беше важно, иначе някой щеше да направи state-файл и ние трябваше ръчно да ги събираме, за да продължи всичко нататък. Сега този проблем не съществува. Всъщност, Terraform разреши този проблем. И ако постоянно нещо се променя, можете да използвате lock механизми, които предотвратяват споменатото.
Използвате ли отворена версия или enterprise?
Никакво enterprise, тоест всичко, което можете да отидете и изтеглите безплатно.
Меня зовут Станислав. Искам да направя малко допълнение. Вие споменахте функцията на Amazon, която позволява да направите инстанция нерушима. Има я и в самия Terraform, в блока Life Second можете да зададете забрана за промяна или забрана за унищожаване.
Бях ограничен във времето. Добро наблюдение.
Исках да попитам още две неща. Първо, говорихте за тестване. Използвали ли сте някакви инструменти за тестване? Чух за плъгина Test Kitchen. Може би има и нещо друго. И бих искал да попитам за Local Values. С какво те се различават от Input Variables? И защо не мога да параметризиране нещо само чрез Local Values? Опитвах се да се запозная с тази тема, но не успях.
Можем да поговорим по-подробно за това извън залата. Инструментите за тестване са изцяло наши. Няма нищо, което да тестваме. Въобще, има варианти, при които автоматичните тестове създават инфраструктура някъде, проверяват, че е ОК, а след това всичко се унищожава с отчет, че вашата инфраструктура все още е в добро състояние. Нямаме това, защото тестовите стеки се стартират всеки ден. И това е достатъчно. И ако нещо започне да се проваля, то ще започне да се проваля, без да правим проверка някъде другаде.
По отношение на Local Values, нека продължим разговора извън залата.
Здравейте! Благодаря за доклада! Много полезно. Говорихте, че имате много еднотипен код за описание на инфраструктурата. Не сте ли обмисляли вариант за генериране на този код?
Отличен въпрос, благодаря! Фактът е, че когато използваме инфраструктурата като код, приемаме, че гледаме на кода и разбираме каква инфраструктура стои зад него. Ако кодът се генерира, трябва да си представим какъв код ще бъде генериран, за да разберем каква инфраструктура ще има. Или генерираме кода, комитваме го, и по същество получаваме същия резултат. Затова тръгнахме по пътя, по който написахме, и той функционира. Плюс това генераторите се появяват по-късно, когато започнахме да го правим. И беше късно да се променя.
Чули ли сте нещо за jsonnet?
Не.
Вижте, това е наистина страхотна работа. Виждам конкретен случай, където може да се приложи и да се генерира структура от данни.
Генераторите са полезни, когато имате, както е в анекдота за машината за бръснене. Тоест, първият път лицето е различно, но след това при всички лицето е едно и също. Генераторите наистина работят отлично. Но за съжаление, нашите лица са малко различни. Това е проблемът.
Просто погледни. Благодаря!
Казвам се Максим, аз съм от Сбербанк. Вие малко разказахте, че сте се опитали да приведете Terraform в аналог на програмен език. Не е ли по-лесно да ползвате Ansible?
Това са много различни неща. Може да се създават ресурси и с Ansible, и с Puppet в Amazon. Но Terraform е точно за това.
Имате ли само Amazon?
Не става въпрос само, че имаме само Amazon. Имаме почти само Amazon. Но ключовата черта е, че Terraform помни. В Ansible, ако кажеш: "Създай ми 5 инстанции", той ще ги създаде, а после ти казваш: "А сега ми трябват 3". Terraform ще каже: "Добре, ще затворя 2", а Ansible ще каже: "Добре, ето ти 3". Така общо стават 8.
Здравейте! Благодаря за вашата презентация! Много интересно беше да чуя за Terraform. Искам веднага да дам малък коментар относно факта, че Terraform все пак няма стабилен релиз, затова подходете с голямо внимание към Terraform.
Добра лъжица за обяд. Тоест, ако ви трябва решение, понякога отлагате това, което е нестабилно и т.н., но работи и ни помогна.
Въпрос е такъв. Използвате Remote backend, използвате S3. Защо не използвате официалния backend?
Официален?
Terraform Cloud.
Кога се появи?
Преди около 4 месеца.
Ако беше излязъл преди 4 години, вероятно щях да отговоря на вашия въпрос.
Там вече има вградена функция и за заключване, и можете да съхранявате state файла. Опитайте. Но и аз не съм тествал.
Пътуваме с голям влак, който се движи с голяма скорост. И не можете просто да вземете и да изхвърлите няколко вагона.
Вие говорихте за снежинките, а защо не използвахте branch? Защо не успяхте да го направите?
Имаме такъв подход, че цялата инфраструктура е в едно репозитори. Terraform, Puppet, всички скриптове, които по някакъв начин се отнасят до това, са в едно репозитори. Така можем да гарантираме, че инкременталните промени са тествани една след друга. Ако имаше куп branches, то такъв проект практически е невъзможно да се обслужва. Минават шест месеца и те се разминават до такава степен, че е просто наказание. Това е нещо, от което исках да избягам преди рефакторинга.
Тоест, това не работи?
Това изобщо не работи.
В branch изрязах слайда на папката. Т.е. ако създам за всеки тестов стек, например, за отбор А – той има своя папка, отбор Б – своя папка, това също не работи. Направихме унифициран код за тестова среда, който беше достатъчно гъвкав, за да подхожда на всички. Т.е. обслужвахме един код.
Здравейте! Аз съм Юра! Благодаря за доклада! Имам въпрос относно модулите. Вие казвате, че използвате модули. Как решавате проблема, ако в един модул са направени промени, които не са съвместими с промените на друг човек? Някак си версионирате модулите или се опитвате да адаптирате чудото, за да отговаря на двете изисквания?
Това е проблем на голямата снежна вълна. Това е, от което страдаме, когато някаква безобидна промяна може да развали някоя част от инфраструктурата. И това става видимо само след доста време.
Т.е. в момента никак не се решава ли?
Правите универсални модули. Избягвайте снежинките. И всичко ще тръгне. Втората част на доклада е за това как да се избегне.
Здравейте! Благодаря за доклада! Исках да уточня. Вижте, остава голямо неподходящо нещо, заради което дойдох. По какъв начин са интегрирани Puppet и разпределението на роли?
User-data.
Т.е. просто изхвърляте файл и по него каквото и да е изпълнявате?
User-data е записка, т.е. когато клонираме образа, там се стартира Daemon и, опитвайки се да разбере кой е, чете записката, че е load balancer.
Т.е. това е някакъв отделен процес, който се предоставя?
Не ние го изобретихме. Ние го използваме.
Здравейте! Имам точно въпрос относно User-data. Вие казахте, че там има проблеми, че някой може да предаде нещо грешно. Има ли някакъв начин за съхраняване на user-data в същия Git, за да е винаги ясно, на какво се отнася User-data?
User-data генерираме от template. Тоест, там идва определен брой променливи. И Terraform генерира крайния резултат. Затова не може просто да се погледне шаблона и да се каже какво ще се получи, защото всички проблеми са свързани с това, че разработчикът мисли, че предава низ в тази променлива, а там идва масив. И изведнъж той – бам и аз – този, този, следващият ред, и всичко се е счупило. Ако това е нов ресурс и човек го стартира, вижда, че нещо не работи, то това се решава бързо. Но ако това е обновена autoscale група, то в определен момент инстанците в autoscale групата започват да се подменят. И хоп, нещо не работи. Това е разочароващо.
Излиза, че единственото решение е да се тества?
Да, виждате проблема, добавяте тестови стъпки. Тоест, output'ът също може да се тества. Може би не е толкова удобно, но можете да поставите някакви етикети – проверявайте, че User-data тук е закована с пирони.
Казвам се Тимур. Много е готино, че има доклади за това как правилно да се организира Terraform.
Аз дори не започнах.
Мисля, че на следващата конференция, може би, ще има. Имам прост въпрос. Защо хардкодите стойностите в отделен модул, а не използвате tfvars, тоест какво е по-добре в модула със стойности от tfvars?
Тоест, трябва ли тук (слайд: Production/environment/settings.tf) да напиша: domain = променлива, domain vpcnetwork, променлива vpcnetwork и stvars – да извлека същото?
Ние точно така правим. Позоваваме се на модула setting source, например.
Всъщност, това е такъв tfvars. Tfvars е много удобен в testing среда. Имам tfvars за големи инстанции, за малки. И хвърлям един файл в папката. И получавам това, което искам. Когато правим инфраструктура, искаме да можем да погледнем и веднага да разберем всичко. А в случая се налага да погледнем тук и после в tfvars.
Излиза, че всичко трябва да е на едно място?
Да, tfvars – това е, когато имате един код. И той се използва на няколко различни места с различни нюанси. Тогава бихте хвърлили tfvars и получили вашите нюанси. А ние – това е инфраструктура като код в чист вид. Погледнахте и разбрахте.
Здравейте! Сблъсквали ли сте се с ситуации, когато облачният доставчик се намесва в това, което сте направили с Terraform? Да кажем, че променяме метаданни. Там са ssh ключовете. А Google постоянно вкарва своите метаданни и ключове. И Terraform винаги показва, че има промени. След всеки прогон, дори и да не се променя нищо, той винаги казва, че ще обновява това поле.
С ключовете, но – да, част от инфраструктурата е повлияна от такова нещо, т.е. Terraform не може да промени нищо. Ние също не можем да променим нищо на ръка. В момента живеем с това.
Т.е. вие сте се сблъсквали с такова нещо, но не сте измислили нищо, то просто продължава да работи само по себе си?
За съжаление, да.
Здравейте! Казвам се Станислав Старков. Mail.ru Group. Как решавате проблема с генерирането на таг на …, как го предавате вътре? Разбирам, че чрез User — data, за да зададете host name, за да активирате Puppet? И втората част на въпроса. Как решавате този въпрос в SG, т.е. когато генерирате SG, стотици идентични instances, как да ги наименувате правилно?
Тези instances, които са много важни за нас, именуваме красиво. Тези, които не са нужни, имат добавка, че това е autoscale група. И по идеята, това може да бъде затворено, за да получите ново.
По отношение на проблема с таговете, нямаме проблем, а задача. И таговете при нас се използват много, много интензивно, защото инфраструктурата е голяма и скъпа. И трябва да проследим къде отиват парите, затова таговете позволяват да се идентифицират какво и къде е било изхарчено. И съответно, да се търси това, което изразходва много пари.
Какво още пита?
Когато SG създава стотици instances, трябва ли да ги различавате по някакъв начин?
Не, не е необходимо. На всеки instance има агент, който съобщава, че има проблем. Ако агентът съобщава, то за него агентът знае и, поне, неговият IP адрес съществува. Вече можете да отидете. Освен това, използваме Consul за Discovery, там, където няма Kubernetes. И Consul също показва IP адреса на instance.
Т.е. вие се ориентирате именно по IP, а не по host name?
Невъзможно е да се ориентирате по host name, т.е. те са много. Има идентификатори на instance – AE и т.н. Можете да го намерите някъде, можете да го пуснете в търсене.
Здравейте! Разбрах, че Terraform е страхотно нещо, насочено към облаците.
Не само.
Точно този въпрос ми е интересен. Ако решите да се преместите, да кажем, на Bare Metal с всички свои инстанции? Няма ли да възникнат проблеми? Или все пак ще трябва да използвате други продукти, като например Ansible, който беше споменат тук?
Ansible е малко по-различен. Тоест, Ansible работи, когато инстанцията е вече пусната. А Terraform работи преди инстанцията да бъде пусната. Преминаването на Bare Metal – не.
Сега не, но бизнесът ще дойде и ще каже: „Давай“.
Преминаването на друго облако – да, но тук става въпрос за малко различна ситуация. Нужно е да напишете Terraform код, така че с по-малко усилия да можете да преминете на друго облако.
Първоначално задачата беше такава, че нашата инфраструктура да е агностик, тоест всяко облако да е подходящо, но в един момент бизнесът се предаде и каза: „Ок, през следващите N години няма да се местим, можем да използваме услугите на Amazon“.
Terraform позволява да се създават Front-End jobs, да се конфигурира PagerDuty, data doc и т.н. Той има много възможности. Практически може да контролира целия свят.
Благодаря за доклада! Аз също вече 4 години работя с Terraform. На етапа на плавен преход към Terraform, към инфраструктура и декларативно описание, се сблъсквахме със ситуация, в която някой правеше нещо на ръка, а вие се опитвахте да направите план. И получавахте някаква грешка. Как решавате такива проблеми? Как намирате загубените ресурси, които бяха упоменати?
Основно ръчно и визуално, ако видим в отчета нещо странно, анализираме какво става, или просто убиваме. А всъщност, pull requests са нормално явление.
Ако има грешка, правите ли rollback? Опитвали ли сте да правите такова нещо?
Не, това е решение на човека в момента, когато види проблема.
Източник: habr.com
