

Днес ще разгледаме метриките на дисковата подсистема в vSphere. Проблемите със съхранението са най-честата причина за бавното изпълнение на виртуална машина. Докато при проблеми с CPU и RAM отстраняването на проблеми завършва на ниво хипервизор, при проблеми с диска, може да се наложи да разгледаме и мрежата за предаване на данни и СХД.
Темата ще разгледам на примера на блоков достъп до СХД, макар че при файловия достъп метриките са приблизително същите.
Няколко теории
Когато става дума за производителността на дисковата подсистема на виртуалните машини, обикновено се обръща внимание на три свързани помежду си параметъра:
- броя на входно/изходните операции (Input/Output Operations Per Second, IOPS);
- пропускната способност (Throughput);
- забавянето на входно/изходните операции (Latency).
Броят на IOPS обикновено е важен за произволни натоварвания: достъп до блокове на диска, разположени на различни места. Пример за такова натоварване могат да бъдат бази данни, бизнес приложения (ERP, CRM) и др.
Пропускна способност е важен за последователни натоварвания: достъп до блокове, разположени един след друг. Например, такова натоварване могат да генерират файлови сървъри (но не винаги) и системи за видео наблюдение.
Пропускната способност е свързана с броя на входно/изходните операции по следния начин:
Throughput = IOPS * Block size, където Block size е размерът на блока.
Размерът на блока е доста важна характеристика. Съвременните версии на ESXi пропускат блокове с размер до 32 767 КБ. Ако блокът е още по-голям, той се разделя на няколко. Не всички СХД могат да работят ефективно с толкова големи блокове, затова в Advanced Settings на ESXi има параметър DiskMaxIOSize. Чрез него може да се намали максималният размер на блока, който хипервизорът пропуска (повече ). Препоръчвам преди промяна на този параметър да се консултирате с производителя на СХД или поне да тествате промените на лабораторен стенд.
Големият размер на блока може да има негативен ефект върху производителността на СХД. Дори ако броят на IOPS и throughput е относително малък, при голям размер на блока могат да се наблюдават високи забавяния. Затова обръщайте внимание на този параметър.
Забавяне – най-интерсният параметър на производителността. Забавянето на входно/изходните операции за виртуалната машина се състои от:
- забавяния въ хипервизора (KAVG, средно време на отговор в милисекунди / прочит);
- забавяния, които дават мрежата за предаване на данни и СХД (DAVG, средно време на отговор в милисекунди / команда).
Общата забавяне, което е видимо в хостващата ОС (GAVG, средно време на отговор в милисекунди / команда), е сумата от KAVG и DAVG.
GAVG и DAVG се измерват, докато KAVG се изчислява: GAVG–DAVG.
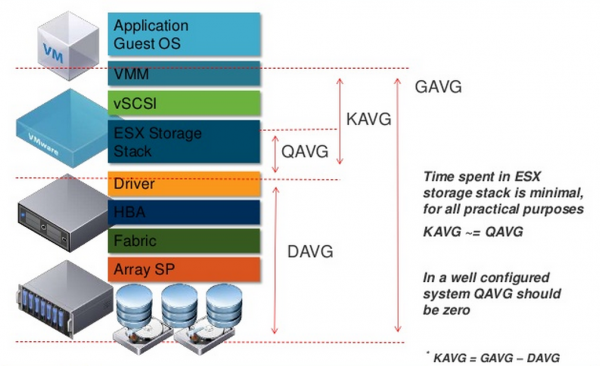
Нека спрем по-подробно на KAVG. При нормална работа KAVG трябва да се стреми към нула или поне да бъде значително по-малко от DAVG. Единственото известно на мен обстоятелство, при което KAVG е очаквано високо, е ограничението по IOPS на диска на ВМ. В такъв случай, при опит за надвишаване на лимита, KAVG ще расте.
Най-съществената съставка на KAVG е QAVG – времето в опашка за обработка вътре в хипервизора. Останалите съставки на KAVG са пренебрежимо малки.
Опашката в драйвера на дисковия адаптер и опашките към луните имат фиксиран размер. За среди с високо натоварване е полезно да се увеличи този размер. описано как да увеличите опашките в драйвера на адаптера (в същото време ще се увеличи опашката към луните). Тази настройка работи, когато с луната работи само една ВМ, което е рядкост. Ако на луната има няколко ВМ, е необходимо също да се увеличи параметърът Disk.SchedNumReqOutstanding (инструкция ). Увеличавайки опашката, намалявате QAVG и KAVG съответно.
Но, отново, първо се запознайте с документацията на производителя HBA и тествайте промените на лабораторното оборудване.
На размера на опашката към луната може да въздейства включването на механизма SIOC (Storage I/O Control). Той осигурява равномерен достъп до луните от всички сървъри в кластера чрез динамично изменение на опашката към луните на сървърите. Тоест, ако на някой от хостовете работи ВМ, която изисква непропорционално много производителност (noisy neighbor VM), SIOC намалява дължината на опашката към луните на съответния хост (DQLEN). Повече информация .
С KAVG се справихме, сега малко за DAVG. Тук е просто: DAVG е забавянето, което внася външната среда (мрежата за предаване на данни и СХД). Във всяка съвременна и не толкова съвременна СХД има собствени броячи на производителността. За анализ на проблеми с DAVG е разумно да ги разгледате. Ако обаче от страна на ESXi и СХД всичко е наред, проверете мрежата за предаване на данни.
За да избегнете проблеми с производителността, изберете правилната политика за избор на пътеки (PSP) за вашето СХД. Практически всички съвременни СХД поддържат PSP Round-Robin (с ALUA, Asymmetric Logical Unit Access, или без). Тази политика позволява използването на всички налични пътеки към СХД. В случай на ALUA се използват само пътища до контролера, който притежава LUN. Не за всички СХД на ESXi има подразбиращи се правила, които задават политиката Round-Robin. Ако за вашето СХД няма правило, използвайте приставката на производителя на СХД, която ще създаде съответното правило на всички хостове в клъстера или създайте правило сами. Подробности .
Също така част от производителите на СХД препоръчват да се промени количеството IOPS на пътя от стандартното значение 1000 на 1. В нашата практика това е позволявало да "изцедим" повече производителност от СХД и значително да намалим времето, необходимо за failover в случай на отказ или обновяване на контролерите. Сверете се с препоръките на вендора и ако няма противопоказания, опитайте да промените този параметър. Подробности .
Основни метрики за производителността на дисковата подсистема на виртуалната машина
Метриките за производителността на дисковата подсистема в vCenter са събрани в разделите Datastore, Disk, Virtual Disk:
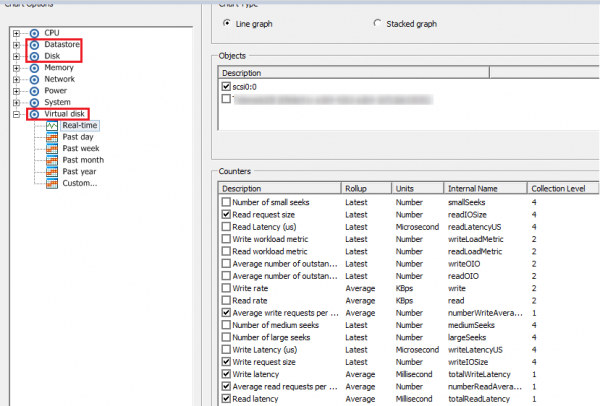
В секцията Datastore съдържат метрики за дисковите хранилища vSphere (датастори), на които се намират дисковете на ВМ. Тук ще намерите стандартни метрики по:
- IOPS (среден брой четения/записи на заявка в секунда),
- пропускна способност (степен на четене/запис),
- забавяния (четене/запис/най-високо забавяне).
От имената на метриките в принципе всичко е разбираемо. Още веднъж ще подчертая, че тук статистиката не е за конкретна ВМ (или диск на ВМ), а обща за целия датастор. На моето мнение, тази статистика е по-удобно да се наблюдава в ESXTOP, особено с оглед на факта, че минималният период на измерване там е 2 секунди.
В секцията Диск съдържат метрики за блочните устройства, които се използват от ВМ. Тук има метрики по IOPS от тип summation (брой операции четене/ запис за измервания период) и няколко метрики, свързани с блочен достъп (заявки, прекратени команди, нулирания на шини). На моето мнение, тази информация е също така по-удобна за гледане в ESXTOP.
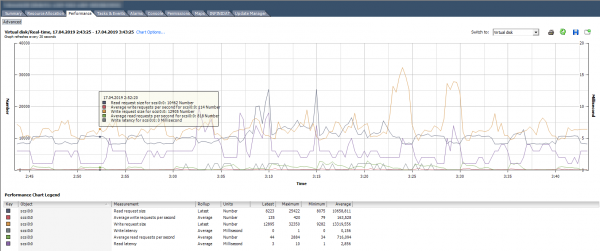
Раздел Virtual Disk – най-полезният инструмент за идентифициране на проблеми свързани с производителността на дисковата подсистема на виртуалната машина. Тук може да се види производителността на всеки виртуален диск. Тази информация е необходима, за да се определи дали има проблем с конкретна виртуална машина. Освен стандартните метрики за брой операции на вход/изход, обем на четене/писане и забавяния, в този раздел има полезни метрики, показващи размера на блока: Размер на заявки за четене/писане.
На изображението по-долу е графикът на производителността на диска на виртуалната машина, където може да се види броят на IOPS, забавянията и размерът на блока.
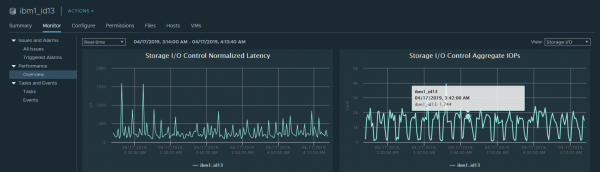
Също така, метриките за производителност могат да се видят за целия datastore, ако SIOC е включен. Тук е представена основна информация за средното забавяне и IOPS. По подразбиране, тази информация може да се види само в реално време.
ESXTOP
В ESXTOP има няколко екрана, на които е представена информация за дисковата подсистема на хоста като цяло, отделни виртуални машини и техните дискове.
Започваме с информацията за виртуалните машини. Екранът "Disk VM" се отваря с клавиша "v":
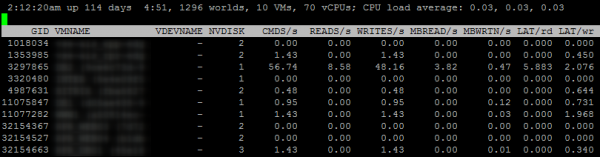
NVDISK – това е броят на дисковете на виртуалната машина. За да видите информация за всеки диск, натиснете "e" и въведете GID на интересуващата ви виртуална машина.
Стойността на останалите параметри на този екран е ясна от имената им.
Още един полезен екран при търсене на проблеми е – Disk adapter. Отваря се с клавиша "d" (на изображението по-долу са избрани полета A,B,C,D,E,G):
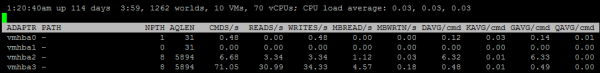
NPTH – броят на пътищата към lun-ове, видими от този адаптер. За да получите информация за всеки път на адаптера, натиснете "e" и въведете името на адаптера:
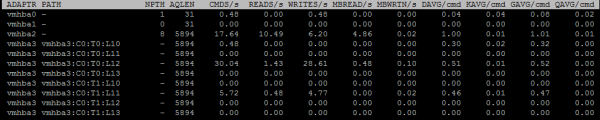
AQLEN – максималният размер на опашката на адаптера.
Също така на този екран са представени метриките за забавяния, за които говорих по-горе: KAVG/cmd, GAVG/cmd, DAVG/cmd, QAVG/cmd.
На екрана Disk device, който се отваря с клавиша "u", е представена информация за отделните блочни устройства – lun-ове (на изображението по-долу са избрани полета A, B, F, G, I). Тук може да видите състоянието на опашката за lun-ове.

DQLEN – размерът на опашката за блочно устройство.
ACTV – броят на командите за вход/изход в ядрото на ESXi.
QUED – броят на командите за вход/изход в опашката.
%USD – ACTV / DQLEN × 100%.
LOAD – (ACTV + QUED) / DQLEN.
Ако %USD е висок, трябва да обмислите увеличаването на опашката. Колкото повече команди са в опашката, толкова по-високо е QAVG и, съответно, KAVG.
На екрана на Disk device можете да видите дали VAAI (vStorage API for Array Integration) работи на СХД. За да направите това, изберете полетата A и O.
Механизмът VAAI позволява прехвърляне на част от работата от хипервизор директно на СХД, например, зануляване, копиране на блокове или блокиране.

Както може да се види на изображението по-горе, на този СХД VAAI работи: активно се използват примитиви Zero и ATS.
Съвети за оптимизация на работата с дисковата подсистема на ESXi
- Обърнете внимание на размера на блока.
- Настройте оптималния размер на опашката на HBA.
- Не забравяйте да активирате SIOC на датасторите.
- Избирайте PSP в съответствие с препоръките на производителя на СХД.
- Убедете се, че VAAI работи.
Полезни статии по темата:
Източник: habr.com
