

Базата данни за времеви редици (TSDB, time series database) в Prometheus 2 е отличен пример на инженерно решение, което предлага значителни подобрения в сравнение с хранилището v2 в Prometheus 1 по отношение на скоростта на натрупване на данни и изпълнение на заявки, ефективността на използване на ресурсите. Ние внедрихме Prometheus 2 в Percona Monitoring and Management (PMM) и имах възможността да изследвам производителността на Prometheus 2 TSDB. В тази статия ще споделя резултатите от тези наблюдения.
Средна работна натовареност на Prometheus
За тези, които са свикнали да работят с бази данни за основни приложения, обичайната работна натовареност на Prometheus е доста интересна. Скоростта на натрупване на данни стреми към стабилна стойност: обикновено услугите, които наблюдавате, изпращат приблизително еднакво количество метрики, а инфраструктурата се променя сравнително бавно.
Запитванията за информация могат да идват от различни източници. Някои от тях, като например алармите, също се стремят към стабилна и предсказуема стойност. Други, като например потребителските запитвания, могат да предизвикват върхове, въпреки че това не е характерно за по-голямата част от натоварването.
Тест на натовареността
По време на тестовете се фокусирах върху способността да се натрупват данни. Разгърнах Prometheus 2.3.2, компилиран с Go 1.10.1 (като част от PMM 1.14) на услуга Linode, използвайки този скрипт: . За максимално реалистично генериране на натоварване с помощта на този стартирах няколко MySQL възли с реално натоварване (Sysbench TPC-C тест), всеки от които е емилирал 10 Linux/MySQL възли.
Всички последващи тестове бяха проведени на сървър Linode с осем виртуални ядра и 32 GB памет, на който са стартирани 20 симулации на натоварване за мониторинг на двесте инстанции на MySQL. Или, в термини на Prometheus, 800 мишени (targets), 440 сборки (scrapes) в секунда, 380 хиляди записи (samples) в секунда и 1,7 милиона активни времеви редици.
Дизайн
Обичайният подход на традиционните бази данни, включително този, който използва Prometheus 1.x, е . Ако тя е недостатъчна, за да издържи натоварването, ще се сблъскате с големи закъснения и някои запитвания няма да бъдат изпълнени. Използването на памет в Prometheus 2 се конфигурира чрез ключ storage.tsdb.min-block-duration, който определя колко дълго записите ще се съхраняват в паметта преди да бъдат записани на диск (по подразбиране това е 2 часа). Необходимото количество памет ще зависи от броя на времевите редици, етикетите (labels) и интензивността на събиране на данни (scrapes) в комбинация с чистия входящ поток. В плана за дисково пространство Prometheus се стреми да използва по 3 байта на запис (sample). От друга страна, изискванията за памет са много по-високи.
Въпреки че има възможност да се конфигурира размерът на блока, не се препоръчва да го настройвате ръчно, така че сте поставени пред необходимостта да дадете на Prometheus толкова памет, колкото той поиска за вашето натоварване.
Ако паметта не е достатъчна, за да поддържа входящия поток от метрики, Prometheus ще падне с out of memory или OOM killer ще се активира.
Добавянето на swap, за да се забави моментът на падение, когато на Prometheus му свърши паметта, не помага особено, защото използването на тази функция води до експлозивно потребление на памет. Мисля, че става въпрос за Go, неговия garbage collector и начина, по който работи със swap.
Друг интересен подход е настройването на записването на head block на диск в определено време, вместо да бъде изчислявано от времето на стартиране на процеса.
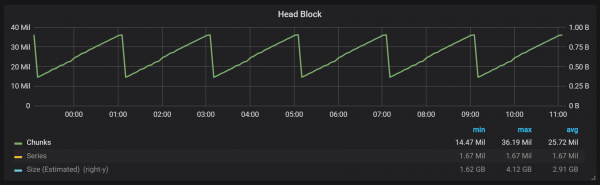
Както можете да видите от графика, записванията на диск се извършват на всеки два часа. Ако промените параметъра min-block-duration на един час, тези записвания ще се извършват всеки час, започвайки след половин час.
Ако искате да използвате тази и други графики във вашата инсталация на Prometheus, можете да използвате този . То е разработено за PMM, но с малки изменения е подходящо за всяка инсталация на Prometheus.
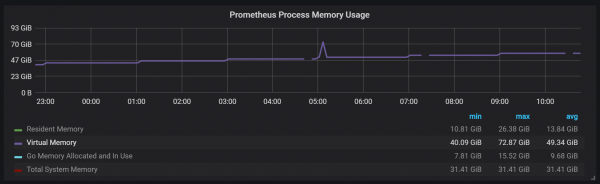
Имаме активен блок, наречен head block, който се съхранява в паметта; блоковете с по-стари данни са достъпни чрез mmap(). Това премахва необходимостта да се конфигурира кеша отделно, но също така означава, че трябва да оставяте достатъчно място за кеша на операционната система, ако желаете да правите заявки за данните по-стари от тези, които побира head block.
Освен това, това означава, че потреблението на виртуална памет от Prometheus ще изглежда сравнително високо, за което не трябва да се притеснявате.
Още един интересен момент в дизайна – използването на WAL (write ahead log). Както личи от документацията за хранилището, Prometheus използва WAL, за да избегне загуби при сривове. Конкретните механизми за гарантиране на устойчивост на данните, за съжаление, не са достатъчно документирани. Версия Prometheus 2.3.2 записва WAL на диск на всеки 10 секунди и този параметър не може да бъде конфигуриран от потребителя.
Компактиране (Compactions)
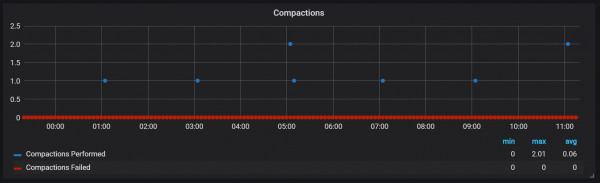
Prometheus TSDB е проектирана по подобие на LSM-хранилището (Log Structured Merge — журнално-структурирано дърво със сливане): head блокът се записва периодично на диск, в същото време механизма за компактиране обединява няколко блока за да се избегне сканиране на прекалено много блокове при заявки. Тук се вижда броя на блоковете, които наблюдавах на тестовата система след едно денонощие натоварване.
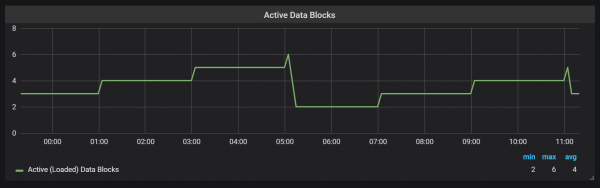
Ако искате да научите повече за хранилището, можете да проучите файла meta.json, в който има информация за наличните блокове и как са се появили те.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Компактирания в Prometheus са свързани с времето на запис на head блока на диска. В този момент могат да се извършват няколко такива операции.
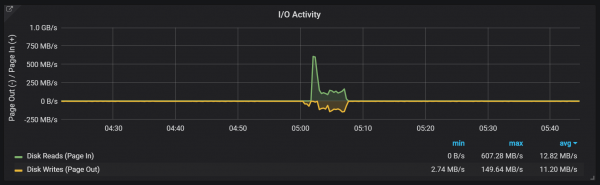
Очевидно, уплотнения не имеют ограничений и могут вызывать значительные скачки дискового ввода/вывода во время выполнения.
Скачки загрузки ЦП
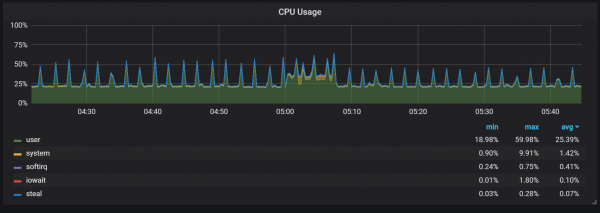
Это вполне негативно сказывается на скорости работы системы и представляет собой серьезный вызов для LSM-хранилищ: как выполнять уплотнения, чтобы поддерживать высокую скорость запросов и при этом не создавать чрезмерной нагрузки?
Использование памяти во время уплотнений также выглядит довольно интересно.
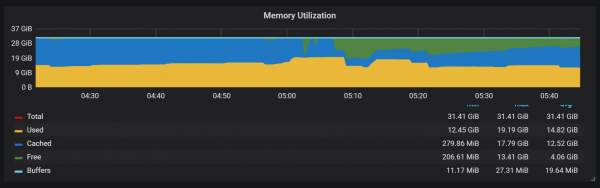
Мы можем наблюдать, как после уплотнения большая часть памяти переходит из состояния Cached в Free: это означает, что потенциально ценная информация была удалена. Интересно, используется ли здесь fadvice() или какая-то другая техника минимизации, или это связано с тем, что кеш был очищен от блоков, удалённых во время уплотнения?
Восстановление после сбоя
Восстановление после сбоев занимает время, и это оправдано. Для входящего потока в миллион записей в секунду мне пришлось ждать около 25 минут во время восстановления с учетом SSD-диска.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Започва Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Започвам да слушам за връзки" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Започване на TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="намерен здрав блок" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="приготвяне на маршрутизатора" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="намерен здрав блок" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="намерен здрав блок" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="намерен здрав блок" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="намерен здрав блок" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="Открито повреда в WAL; изтриване" err="неочакван CRC32 контролна сума d0465484, искано 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB стартирано"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Зареждане на конфигурационен файл" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Завърши зареждането на конфигурационния файл" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Сървърът е готов да получава уеб заявки."
Основният проблем при възстановяването на процеса е високото потребление на паметта. Въпреки че при нормални обстоятелства сървърът може стабилно да работи с такова количество памет, при срив той може да не се събуди поради OOM. Единственото решение, което намерих, е да изключа събирането на данни, да стартирам сървъра, да му позволя да се възстанови и след това да рестартирам с включено събиране.
Разгрев
Едно поведение, за което трябва да се помни по време на разгрев, е съотношението на ниска производителност и високо потребление на ресурси веднага след стартиране. По време на някои, но не при всички стартирания, наблюдавах значителна натовареност на CPU и паметта.
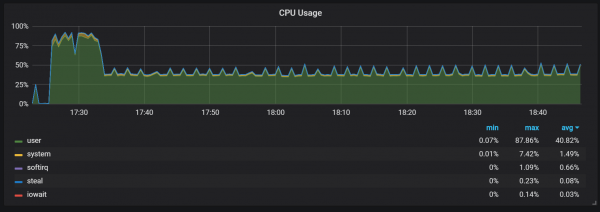
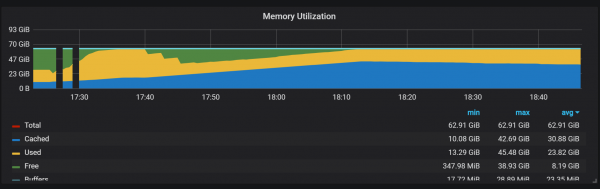
Провалите в използването на паметта показват, че Prometheus не може от самото начало да конфигурира всичките си събирания и някаква информация остава загубена.
Не успях да установя точните причини за високото натоварване на процесора и паметта. Подозирам, че е свързано с генерирането на нови времеви редове в head block с висока честота.
Скокове на натоварването на CPU
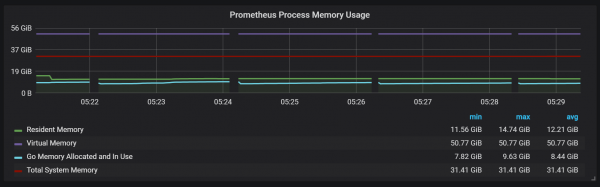
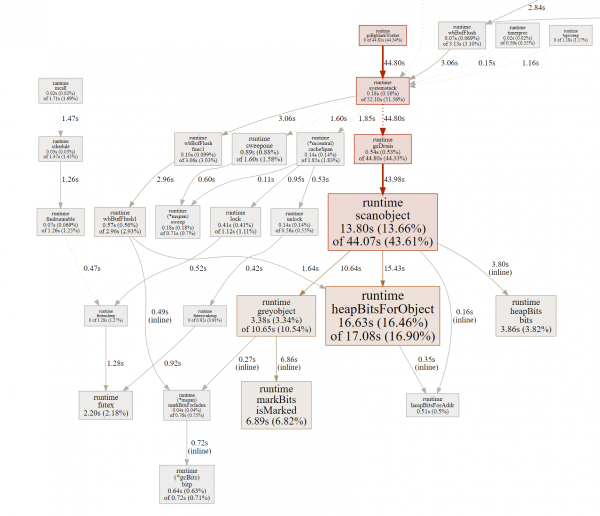
Освен уплътненията, които създават доста високо натоварване по I/O, забелязах сериозни скокове на натоварването на процесора на всеки две минути. Всплесъците са по-дълги при висок поток на входящите данни и изглежда, че са причинени от сборщика на боклук Go, поне някои ядра са напълно натоварени.
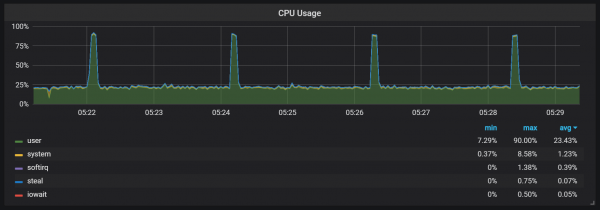
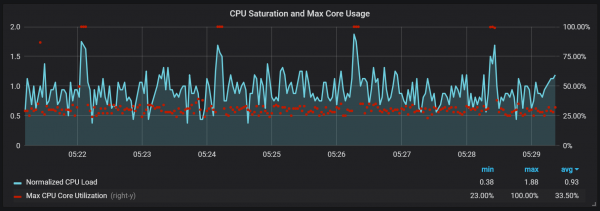
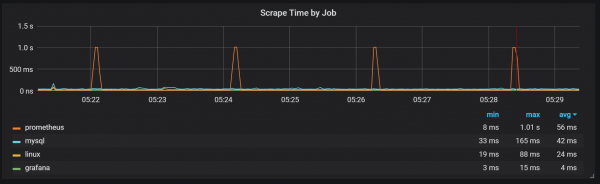
Тези скокове не са толкова незначителни. Изглежда, че когато се случват, вътрешната точка на вход и метриките на Prometheus стават недостъпни, което води до пропуски в данните в същите тези периоди.
Също така може да се забележи, че експортерът на Prometheus блокира за една секунда.
Можем да забележим корелации с почистването на боклука (GC).
Заключение
TSDB в Prometheus 2 работи бързо, способна е да се справя с милиони времеви редове и едновременно с това с хиляди записи, извършвани в секунда, използвайки доста скромен хардуер. Утилизацията на CPU и дисковото I/O също е впечатляваща. Моят пример показваше до 200 000 метрики в секунда на едно използвано ядро.
При планирането на разширения, трябва да се помни за достатъчните обеми памет и тя трябва да бъде реална памет. Обемът на използваната памет, който наблюдавах, беше около 5 ГБ на 100 000 записи в секунда на входящия поток, което в комбинация с кеша на операционната система даваше около 8 ГБ заета памет.
Разбира се, все още има много работа по овладяване на скоковете на CPU и дисковото I/O, и това не е учудващо, предвид колко млада е TSDB Prometheus 2 в сравнение с InnoDB, TokuDB, RocksDB, WiredTiger, но и те имаха подобни проблеми в началото на жизнения си цикъл.
Източник: habr.com
