

Здравейте, аз съм Дмитрий Логвиненко — Data Engineer в отдела по анализ на групата компании „Везёт“.
Ще ви разкажа за страхотен инструмент за разработка на ETL процеси — Apache Airflow. Но Airflow е толкова универсален и многогранен, че трябва да му обърнете внимание дори ако не се занимавате с потоци от данни, а имате нужда периодично да стартирате определени процеси и да следите тяхното изпълнение.
И да, няма да говоря само, а и ще покажа: в програмата има много код, скрийншотове и препоръки.
Какво обикновено виждате, когато търсите думата Airflow / Wikimedia Commons
Съдържание
Въведение
Apache Airflow — работи като Django:
- напичан е на Python,
- има отлична админка,
- неограничено разширяем,
— само че по-добро и е направено за съвсем други цели, а именно (както е написано за ката):
- стартиране и мониторинг на задачи на неограничен брой машини (колкото ще позволят Celery/Kubernetes и вашата съвест)
- с динамична генерация на работен поток от много лесен за писане и възприемане Python код
- и възможността да свързвате всяка база данни и API помежду им посредством готови компоненти или самоделни плъгини (което е изключително просто).
Използваме Apache Airflow по следния начин:
- събиране на данни от различни източници (множество инстанции на SQL Server и PostgreSQL, различни API с метрики на приложения, дори 1С) в DWH и ODS (при нас това са Vertica и Clickhouse).
- като напреднал
cron, който стартира процеси по консолидиране на данни в ODS и следи за тяхното обслужване.
До неотдавна нуждите ни бяха покривани от един малък сървър с 32 ядра и 50 GB RAM. В Airflow обаче работят:
- повече от 200 дага (всъщност работни потоци, в които сме напълнили задачки),
- във всеки средно по 70 задачи,
- тези хубавци се стартират (средно) веднъж на час.
А за това как се разширявахме, ще напиша по-долу, а сега нека да определим über-задачата, която ще решаваме:
Има три основни SQL сървъра, на всеки от които по 50 бази данни — инстанции на един проект, съответно структурата им е идентична (почти навсякъде, хехе), а това означава, че в тях всички имат таблица Orders (хубаво е, че таблица с такова име може да бъде включена в всеки бизнес). Вземаме данни, добавяйки служебни полета (сървър-източник, база-източник, идентификатор на ETL-задача) и наивно ще ги вкараме в, да кажем, Vertica.
Хайде да започваме!
Основната част, практическата (и малко теоретична)
Защо е необходимо за нас (и за вас)
Когато дърветата бяха големи, а аз бях прост SQL-щик в един руски ритейл, ние извършвахме ETL процеси aka потоци данни с помощта на двата налични инструмента:
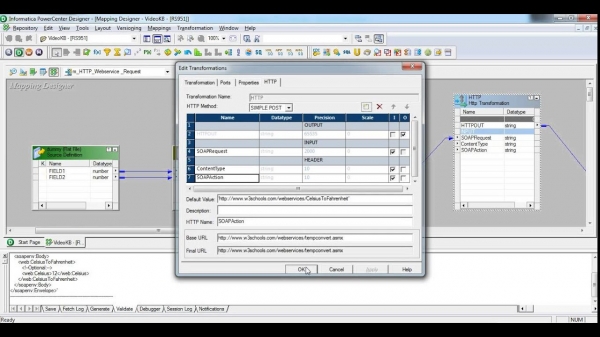
- Informatica Power Center — изключително сложна система, изключително производителна, със собствен хардуер и собствено версиониране. Използвах, да ми е на ум, 1% от възможностите й. Защо? Ами, първо, този интерфейс е някъде от началото на 2000-те и психически натискаше на нас. На второ място, това нещо е насочено към изключително сложни процеси, яростно преизползване на компоненти и други много важни за корпоративния сектор детайли. За цената й, колкото крилото на Airbus A380/година, ще мълчим.
Внимание, скрийншотът може да нарани хора под 30 години.

- SQL Server Integration Services — с този инструмент работихме в нашите вътрешни проекти. А наистина: SQL Server вече използваме и да не използваме ETL инструментите му би било малко неразумно. Всичко в него е наред: и интерфейсът е красив, и отчетите за изпълнение... Но не за това обичаме софтуерните продукти, ох, не за това. Можем да версионираме
dtsx(който представлява XML с объркани при запазване възли), но каква полза? А да направим пакет от задачи, който да прехвърли стотици таблици от един сървър на друг? Какво да кажем за стотиците, от двадесет парчета ще се откаже показалеца, щракащ по мишката. Но определено изглежда по-модерно:
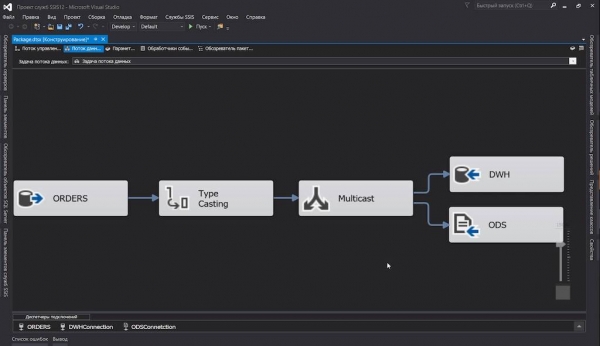
Ние безусловно търсехме решения. Стигнахме дори нищо до самостоятелно написан генератор на SSIS пакети...
... а после ме настигна нова работа. А там ме застигна Apache Airflow.
Когато разбрах, че описанията на ETL процеси са просто Python код, едва не заплясках от радост. Ето как потоците данни получиха версиониране и дифуване, а изсипването на таблици със същата структура от стотици бази данни в един таргет стана работа на Python код на 13-инчов екран.
Създаваме клъстер
Нека да не правим детска градина и да не говорим за очевидни неща като инсталирането на Airflow, избраната от вас база данни, Celery и други неща, описани в документацията.
За да можем веднага да започнем с експериментите, аз набросих docker-compose.yml в който:
- Да стартираме собствено Airflow: Scheduler, Webserver. Тук ще работи Flower за мониторинг на задачите на Celery (защото вече е включен в
apache/airflow:1.10.10-python3.7, а ние не сме против); - PostgreSQL, в който Airflow ще записва своята служебна информация (данни от планировщика, статистики за изпълнението и т.н.), а Celery ще маркира завършените задачи;
- Redis, който ще бъде брокер за задачи на Celery;
- Celery worker, който ще се заеме с непосредственото изпълнение на задачите.
- В папката
. /dagsще съхраняваме нашите файлове с описания на даговете. Те ще се прихващат в движение, така че не е необходимо да перезареждаме целия стек след всяка малка промяна.
Някои от примерите в кода не са приведени напълно (за да не затрудняват текста), а на места са модифицирани в процеса. Целите работещи кодови примери могат да се видят в репозитория .
docker-compose.yml
версия: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis as a Celery broker
  broker:
    image: redis:6.0.5-alpine

  # DB for the Airflow metadata
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Основной контейнер с Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, будет масштабироваться с помощью `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Бележки:
- В сборке композа я в значительной степени опирался на известный образ – обязательно посмотрите. Может, вам в жизни больше ничего и не понадобится.
- Все настройки Airflow доступны не только через
airflow.cfg, но и через переменные среды (слава разработчикам), чем я злостно воспользовался. - Естественно, он не подготовлен для production: я намеренно не ставил heartbeats на контейнеры, не заморачивался с безопасностью. Но минимум, подходящий для наших экспериментов, я сделал.
- Обратите внимание, что:
- Папка с дагами должна быть доступна как планировщику, так и воркерам.
- То же самое касается и всех сторонних библиотек — они все должны быть установлены на машины с шедулером и воркерами.
Ну а теперь просто:
$ docker-compose up --scale worker=3После того, как всё поднимется, можно смотреть на веб-интерфейсы:
- Airflow:
- Flower:
Основни понятия
Ако не сте разбрали нищо от всички тези „даги“, ето един кратък речник:
- Планирател — най-важният човек в Airflow, който контролира, за да работят роботите, а не хората: следи графика, обновява дагите, стартира задачите.
Всъщност, в старите версии имаше проблеми с паметта (не, не амнезия, а течове) и в конфигурациите дори остана параметър на наследството
run_duration— интервалът на неговото повторно стартиране. Но сега всичко е наред. - DAG (той също е „даг“) — „насочен ацикличен граф“, но такова определение рядко говори на някого, а по същество това е контейнер за взаимодействащи помежду си задачи (вижте по-долу) или аналог на Package в SSIS и Workflow в Informatica.
Освен дагите, могат да съществуват и сабдаги, но най-вероятно до тях няма да стигнем.
- DAG Run — инициализиран даг, на който е присвоена своя
execution_date. Даграните на един даг могат успешно да работят паралелно (ако, разбира се, сте направили задачите си идемпонентни). - Оператор — това са парчета код, отговорни за изпълнението на конкретно действие. Има три типа оператори:
- action, например нашият любим
PythonOperator, който може да изпълни всяка (валидна) Python код; - прехвърляне, които прехвърлят данни от едно място на друго, да кажем,
MsSqlToHiveTransfer; - сензор ще позволи да реагира или да забави по-нататъшното изпълнение на дага до настъпването на конкретно събитие.
HttpSensorможе да извиква даден ендпоинт и когато получи необходимия отговор, да стартира трансфераGoogleCloudStorageToS3Operator. Любопитният ум ще попита: „защо? Все пак може да правите повторения директно в оператора!“ А след това, за да не пълните пул задачите с застояли оператори. Сензорът се стартира, проверява и умира до следващия опит.
- action, например нашият любим
- Task — декларираните оператори независимо от типа, прикрепени към дага, се повишават в чин на задача.
- Инстанция на задача — когато генералният планирател реши, че задачите е време да отидат на бой при изпълнителите-работници (на място, ако използваме
LocalExecutorили на отдалечен нод в случай наCeleryExecutor), той им назначава контекст (т.е. комплект променливи — параметри за изпълнение), разгръща шаблони на команди или заявки и ги поставя в пул.
Генерираме задачи
Първо нека обозначим общата схема на нашия даг, а след това ще се потапяме все по-дълбоко в детайлите, тъй като прилагаме някои нетривиални решения.
И така, в най-простият вариант, подобен даг ще изглежда така:
от datetime импортируем timedelta, datetime

от airflow импортируем DAG
от airflow.operators.python_operator импортируем PythonOperator

от commons.datasources импортируем sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Нека разберем:
- Първо импортираме нужните библиотеки и нещо друго;
sql_server_ds— това еСписък[namedtuple[str, str]]с имената на конекторите от Airflow Connections и базите данни, от които ще извличаме нашата таблица;dagе декларация на нашия DAG, която задължително трябва да бъде вglobals(), иначе Airflow няма да я намери. DAG-ът също трябва да знае:- как се казва
ordersтова име после ще се появява в уеб интерфейса, - че ще работи, започвайки от полунощ на осмия юли,
- и трябва да се изпълнява на всеки 6 часа (за опитните тук вместо
timedelta()е допустимоcron-строка,0 0 0/6 ? * * *за по-малко опитните — израз като@daily);
- как се казва
workflow()ще извърши основната работа, но не сега. Сега просто ще изведем контекста в логовете.- А сега простата магия на създаването на задачи:
- преминаваме през нашите източници;
- инициализираме
PythonOperator, която ще изпълни нашата празна задача.workflow()Не забравяйте да зададете уникално (в рамките на DAG-а) име на задачата и да свържете самия DAG. Флагътprovide_contextот своя страна ще предаде допълнителни аргументи на функцията, които ние внимателно ще съберем с помощта на**context.
Засега това е всичко. Какво получихме:
- нов DAG в уеб интерфейса,
- полутора стотин задачи, които ще се изпълняват паралелно (ако настройките на Airflow, Celery и капацитета на сървърите позволяват).
Ами, почти получихме.
Кой ще зададе зависимостите?
За да опростя всичко това, добавих docker-compose.yml обработката requirements.txt на всички възли.
Сега потегляме:
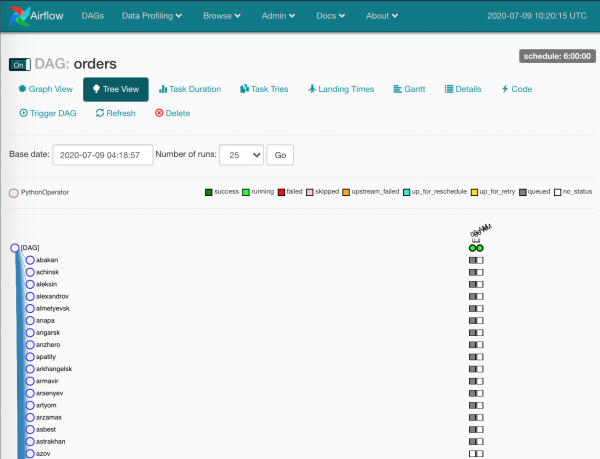
Сивите квадрати — екземпляри на задача, обработени от планировщика.
Чакаме малко, задачите се взимат от работниците:
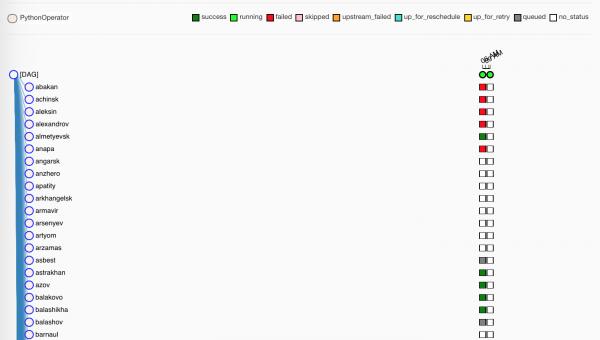
Зелените, естествено, — успешно изпълнили. Червените — не толкова успешно.
Между другото, на нашия прод не съществува папка,
. /dags, синхронизирана между машините — всички DAG-ове лежат вgitв нашия GitLab, а GitLab CI разпределя обновленията на машините при мърджа вmaster.
Няколко думи за Flower
Докато работниците разглеждат нашите празни задачи, нека си припомним за един друг инструмент, който може да ни покаже нещо — Flower.
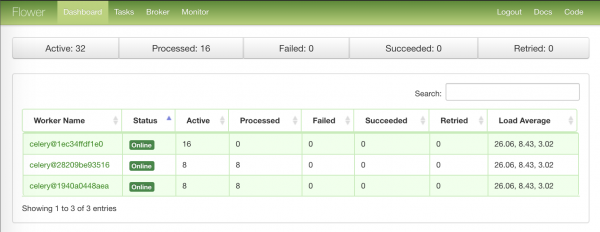
Първата страница с обобщена информация за възлите-работници:
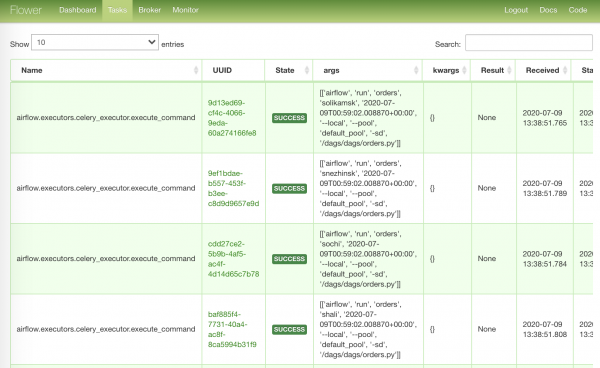
Най-пъстрата страница с задачите, изпратени за работа:
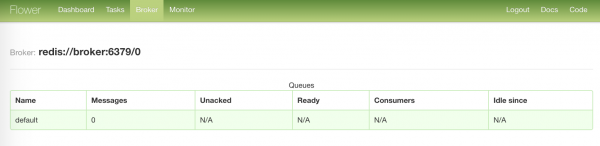
Най-скучната страница със състоянието на нашия брокер:
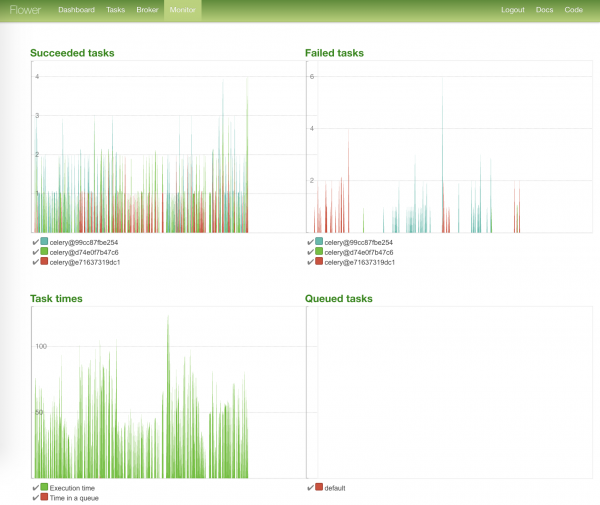
Най-цветната страница — с графики на състоянието на задачите и времето за изпълнение:
Довършваме недовършеното
И така, всички задачи приключиха, можем да изнесем ранените.
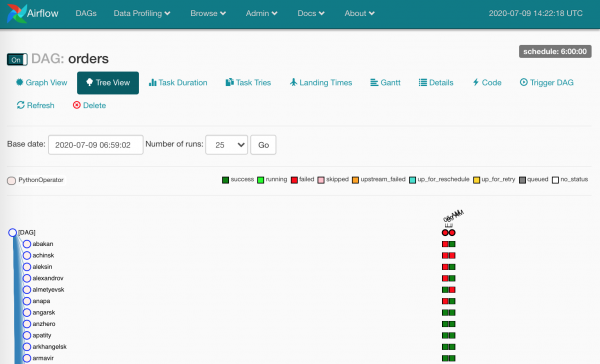
Ранените се оказаха доста — по различни причини. При правилна употреба на Airflow, тези квадрати говорят за това, че данните определено не са достигнали.
Трябва да погледнем логовете и да рестартираме падналите инстанции на задачите.
Като кликнем на всеки квадрат, ще видим наличните ни действия:
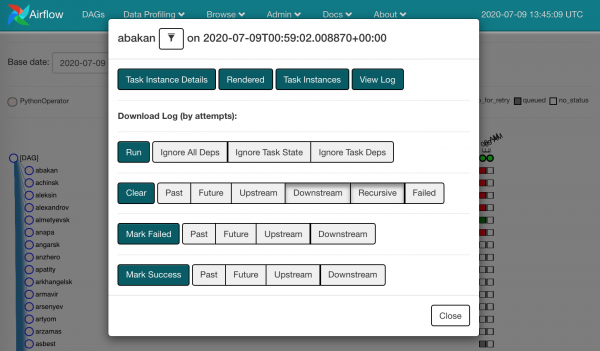
Можем да изберем и да направим Clear на падналото. Тоест, забравяме, че нещо е блокирано, и същата инстанция на задачата ще отиде при планиращия.
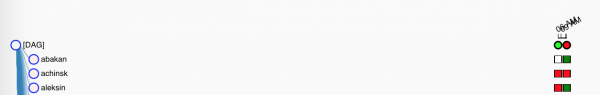
Разбира се, не е много хуманно да правим това с мишката на всички червени квадрати — не това очакваме от Airflow. Разбира се, имаме оръжие за масово унищожение: Browse/Task Instances
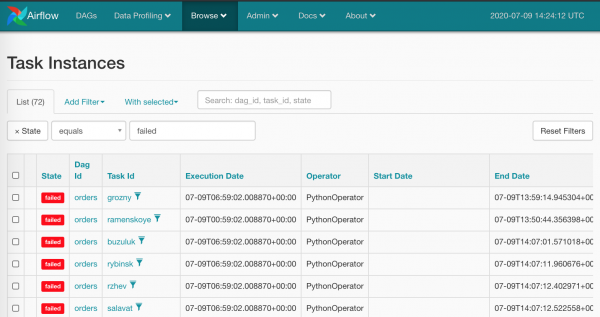
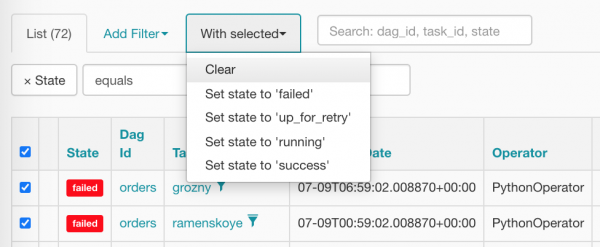
Ще изберем всичко веднага и ще нулираме, натискайки правилната опция:
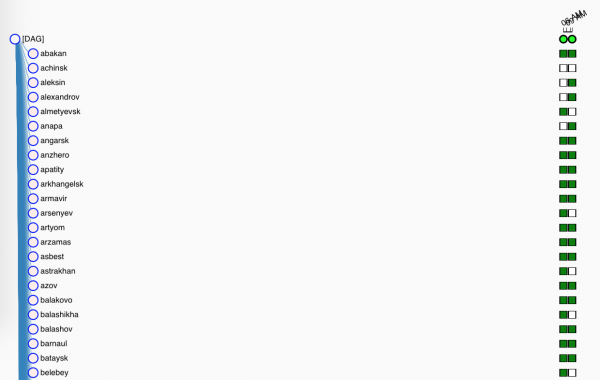
След почистването нашите таксита изглеждат така (те вече чакат, когато шедулерът ги планира):
Връзки, хукове и други променливи
Време е да погледнем следващия DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Господа добри, отчетите са обновени"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Наташа, събуди се, ние {{ dag.dag_id }} паднахме
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Всички сме правили обновление на отчетите, нали? Ето я отново: имаме списък с източници, от които да вземем данни; имаме списък, където да ги поставим; не забравяме да сигнализираме, когато всичко се е случило или е счупено (но това не се отнася за нас, нали).
Нека отново прегледаме файла и да видим новите неразбираеми неща:
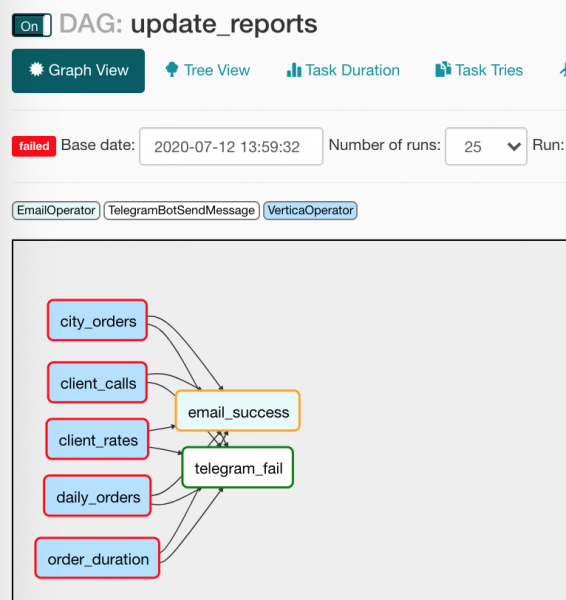
from commons.operators import TelegramBotSendMessage— нищо не ни пречи да правим свои операторов, което и направихме, създавайки малка обвивка за изпращане на съобщения в Разблокиран. (За този оператор ще поговорим по-долу);default_args={}— DAG може да раздава същите аргументи на всички свои оператори;to='{{ var.value.all_the_kings_men }}'— полекъмняма да бъде хардкоднато, а ще се генерира динамично с помощта на Jinja и променлива с списък на имейл адреси, която аз внимателно поставих вAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— условие за задействане на оператора. В нашия случай, писмото ще отиде до шефовете само ако всички зависимости работят успешно;tg_bot_conn_id='tg_main'— аргументитеconn_idприемат идентификаторите на връзките, които създаваме вAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— съобщенията в Telegram ще отиват само при наличие на провалили се задачи;task_concurrency=1— забраняваме едновременното стартиране на няколко task instances на една задача. В противен случай, ще получим едновременно стартиране на няколкоVerticaOperator(които гледат на една таблица);report_update >> [email, tg]— всичкоVerticaOperatorще се събере в изпращането на писмо и съобщение, ето така:

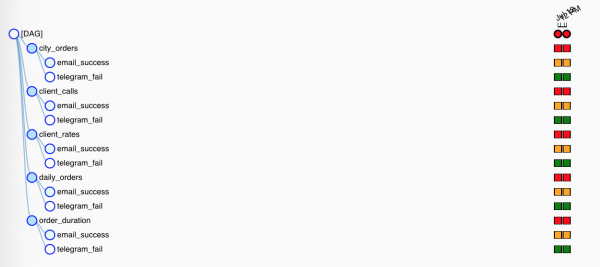
Но тъй като операторите-нотификатори имат различни условия за задействане, ще работи само един. В Tree View всичко изглежда малко по-малко ясно:

Ще кажа няколко думи за макросите и техните приятели — на променливи.
Макросите са Jinja плейсхолдери, които могат да вмъкват различна полезна информация в аргументите на операторите. Например, така:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} ще се развие в съдържанието на променливата от контекста execution_date в този формат YYYY-MM-DD: 2020-07-14. Най-хубавото е, че променливите от контекста са заковани към определен инстанс на задачата (квадратчето в Tree View), и при повторно стартиране плейсхолдерите ще се разкрият в същите стойности.
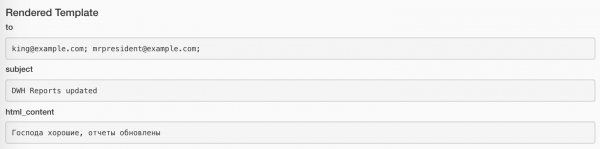
Присвоените стойности могат да се видят с помощта на бутона Rendered на всеки task инстанс. Ето как изглежда за задачата с изпращане на писмо:
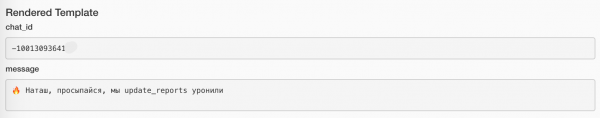
А ето как изглежда за задачата с изпращане на съобщение:
Пълният списък на вградените макроси за последната налична версия е наличен тук:
Освен това, с помощта на плъгини, можем да обявяваме свои макроси, но това е съвсем друга история.
Освен предварително зададените неща, можем да използваме стойности на собствените си променливи (в кода по-горе вече го направих). Ще създадем в Admin/Variables няколко неща:
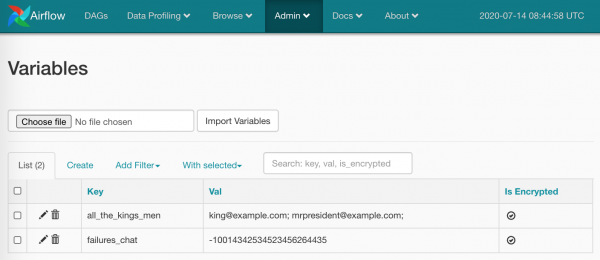
Готово, можем да използваме:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')В стойността може да има скалар, а може да бъде и JSON. В случай на JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
просто използваме пътя към необходимия ключ: {{ var.json.bot_config.bot.token }}.
Ще кажа буквално една дума и ще покажа един скрийншот за соединения. Тук всичко е елементарно: на страницата Admin/Connections създаваме соединение, слагаме там нашите логини/пароли и по-специфични параметри. Ето така:
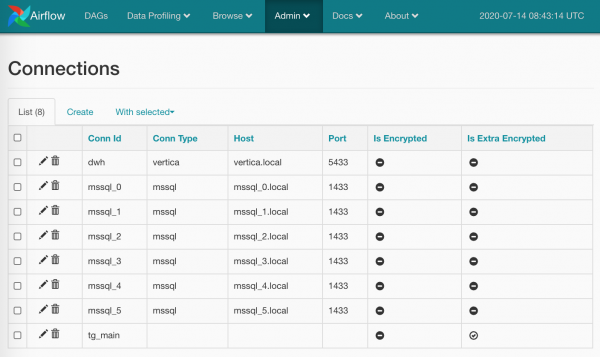
Паролите могат да се шифроват (по-старателно, отколкото по подразбиране), а можем да не указваме типа на соединение (както направих за tg_main) — работата е там, че списъкът с типове е зашит в моделите на Airflow и не може да се разширява без намеса в изходния код (ако случайно не съм намерил нещо — моля, поправете ме), но да получим кредите просто по име, не ни пречи.
А още можем да направим няколко соединения с едно и също име: в такъв случай методът BaseHook.get_connection(), който ни извлича соединенията по име, ще връща произволно от няколко съседи (беше логично да направим Round Robin, но оставяме това на съвестта на разработчиците на Airflow).
Variables и Connections, безспорно, са страхотни средства, но е важно да не се изгуби балансът: какви части от вашите потоци съхранявате в кода, а какви — оставяте за съхранение на Airflow. От една страна, бързото смяна на стойност, например, кутията за разпращане, може да е удобно през UI. А от друга — все пак това е връщане към кликането с мишка, от което ние (аз) искахме да се освободим.
Работата с соединенията — едно от задачите хукове. Всъщност хуките на Airflow са точки на свързване към странични услуги и библиотеки. Например, JiraHook ще отвори за нас клиент за взаимодействие с Jira (можем да преместваме задачки насам-натам), а с помощта на SambaHook можем да качим локален файл на smb-точка.
Разиграваме кастомния оператор
И ние сме много близо до това да видим как е направено TelegramBotSendMessage
Код commons/operators.py със самия оператор:
от typing импортировать Union

от airflow.operators импортировать BaseOperator

от commons.hooks импортировать TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Изпраща съобщение на chat_id с помощта на TelegramBotHook

    Пример:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} не успя :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    деф __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    деф execute(self, context):
        print(f'Изпращам "{self.message}" до чата {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Тук, както и всичко в Airflow, всичко е много просто:
- Наследяваме от
BaseOperator, който реализира доста специфични неща за Airflow (погледнете, когато имате време) - Обявихме полета
template_fields, в които Jinja ще търси макроси за обработка. - Организирахме правилните аргументи за
__init__(), поставихме стойности по подразбиране, където е необходимо. - Не забравихме да инициализираме родителя.
- Отворихме съответния хук
TelegramBotHook, получихме от него клиентски обект. - Override (переопределихме) метода
BaseOperator.execute(), който Airflow ще активира, когато дойде времето за изпълнение на оператора — именно в него реализираме основното действие, не забравяйки да се логнем. (Логираме се, между другото, директно вstdoutиstderr— Airflow всичко ще прихване, красиво ще обгърне, ще разложи, където трябва.)
Нека да видим какво имаме в commons/hooks.py. Първата част на файла, със съответния хук:
от typing импортировать Union

от airflow.hooks.base_hook импортировать BaseHook
от requests_toolbelt.sessions импортировать BaseUrlSession

class TelegramBotHook(BaseHook):
    """Хук за Telegram Bot API

    Забележка: добавете връзка с празен тип връзка и не забравяйте
    да попълните Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    деф __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    деф get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Аз дори не знам какво може да се обясни, просто ще отбележа важните моменти:
- Наследяваме, мислим за аргументите — в повечето случаи той ще бъде един:
conn_id; - Переопределяме стандартните методи: ограничих се до
get_conn(), в който получавам параметрите на връзката по име и просто извличам секциятаextra(това поле за JSON), в което сложих токена на Telegram бота:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Създавам екземпляр на нашия
TelegramBot, предавайки му вече конкретния токен.
И това е всичко. Можете да получите клиента от хука с помощта на TelegramBotHook().client или TelegramBotHook().get_conn().
И втората част от файла, в която направих микрообвивка за REST API на Telegram, за да не носим същия за един метод sendMessage.
class TelegramBot:
    """Обвивка на Telegram Bot API

    Примери:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Привет, скъпа')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Привет, скъпа', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Правилният път е да съберем всичко това:
TelegramBotSendMessage,TelegramBotHook,TelegramBot— в плъгин, да го сложим в публичен репозиторий и да го предоставим в Open Source.
Докато изучавахме всичко това, нашите актуализации на отчетите успяха успешно да се провалят и да ми изпратят съобщение за грешка в канала. Ще отида да проверя какво отново не е наред…
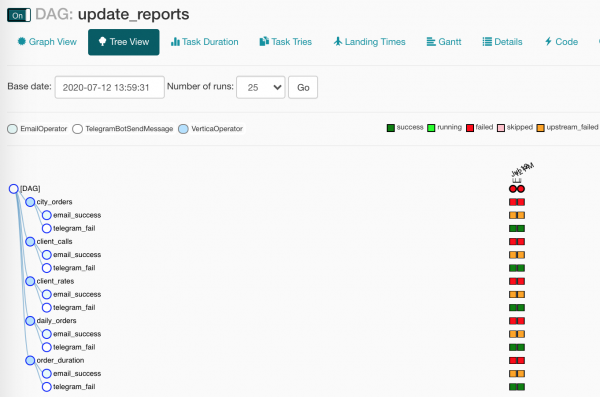
Нещо се счупи в нашето даг! А не това ли чакахме? Точно така!
Ще наливате ли?
Усещате, че нещо пропуснах? Някак си обещах да преливам данни от SQL Server в Vertica и тук изведнъж се отклоних от темата, негодник!
Това злодеяние беше умишлено, просто трябваше да обясня някоя терминология. Сега можем да продължим.
Планът ни беше такъв:
- Да направим даг
- Да генерираме таскове
- Да видим как всичко изглежда красиво
- Да присвояваме на заливките номера на сесиите
- Да вземем данни от SQL Server
- Да поставим данните в Vertica
- Да съберем статистика
И така, за да стартираме всичко това, направих малко допълнение към нашия docker-compose.yml:
docker-compose.db.yml
версия: '3.4'

x-mssql-base: &mssql-base
  изображение: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  перезапуск: всегда
  окружение:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

услуги:
  dwh:
    изображение: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    изображение: mio101/py3-sql-db-client-base
    команда: python3 ./mssql_init.py
    зависит_от:
      - mssql_0
      - mssql_1
      - mssql_2
    окружение:
      SA_PASSWORD: SayThanksToSatiaAt2020
    объемы:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Там ние подемаме:
- Vertica като хост
dwhс най-дефолтните настройки, - три инстанции на SQL Server,
- попълваме базите с последните някои данни (в никакъв случай не поглеждайте в
mssql_init.py!)
Стартираме всичко това с малко по-сложна команда от предишния път:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Какво генерира нашият чудо-рандомайзер, може да се види, като се възползвате от пункта Data Profiling/Ad Hoc Query:
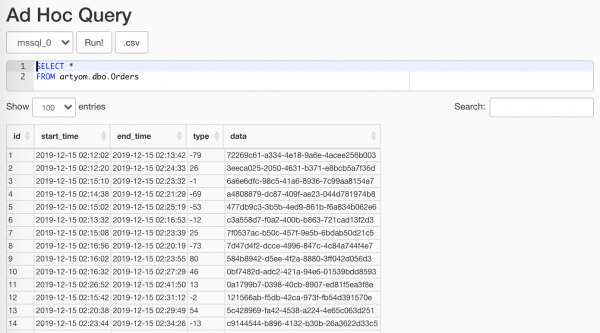
Основното е да не се показва на анализаторите
За подробно разглеждане на ETL-сесиите няма да се спирам, там всичко е тривиално: правим база, в нея таблица, обвиваме всичко с мениджър на контекста и сега правим следното:
with Session(task_name) as session:
    print('Load', session.id, 'started')

    # Load workflow
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
от sys импортировать stderr

класс Сессия:
    """ETL работен процес сесия

    Пример:
        с Сессия(името_на_задачата) като сесия:
            печат(сесия.id)
            сесия.успешна = Истина
            сесия.заредени_редове = 15
            сесия.коментар = 'Добре свършена работа'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            печат(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'<{self.__class__.__name__} '
                f'id={self.id} '
                f'task_name="{self.task_name}">')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            СЪЗДАЙ TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            ВСТАВИ В sessions (task_name, finished)
            VALUES (%s, NULL)
            ВРЪЩАНЕ id;
            """
        self._id = self._execute(query, self.task_name)
        печат(self, 'отворена')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Сесията не е отворена')
        query = """
            АДИРЕКТ update sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            ВРЪЩАНЕ id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        печат(self, 'затворена',
              ', успешна: ', self.successful,
              ', Заредени: ', self.loaded_rows,
              ', коментар:', self.comment)

клас SessionError(Изключение):
    премини

клас SessionClosedError(SessionError):
    премини
Настъпи времето да вземем нашите данни от нашите полутора стотни таблици. Ще го направим с помощта на много елементарни редове:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    ИЗБЕРИ
        id, start_time, end_time, type, data
    ОТ dbo.Orders
    КЪДЕ
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- С помощта на хук ще получим от Airflow
pymssql-коннект - В заявката добавяме ограничение под формата на дата — във функцията ще бъде подхвърлено от шаблона.
- Предоставяме нашата заявка
pandas, която ще извлече за насDataFrame— тя ще ни е полезна в бъдеще.
Използвам заместване
{dt}вместо параметъра на заявката%sне защото съм злобен Буратино, а защотоpandasне може да се справи сpymssqlи подлага на последнияпараметри: Списък, макар че той много искаtuple.
Също така, имайте предвид, че разработчикътpymssqlреши да не го поддържа повече и е време да се преместим наpyodbc.
Нека видим какво Airflow е напълнил аргументите на нашите функции:
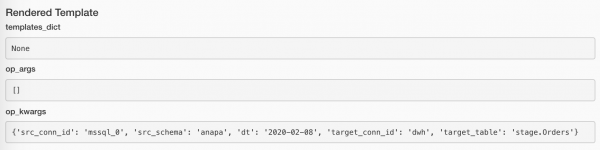
Ако данните ги няма, няма смисъл да продължаваме. Но също така е странно да се смята, че зареждането е успешно. Но това не е и грешка. Аха, какво да правим?! Ето как:
if df.empty:
    raise AirflowSkipException('Няма редове за зареждане')
AirflowSkipException ще каже Airflow, че всъщност няма грешка, а задачата ние я пропускаме. В интерфейса няма да има нито зелен, нито червен квадрат, а цвят розов.
Да добавим на нашите данни няколко колони:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
А именно:
- БД, от която сме взели поръчките,
- Идентификатор на нашата зареждаща сесия (той ще е различен за всяка задача),
- Хаш от източника и идентификатора на поръчката — за да имаме уникален идентификатор на поръчката в крайната база (където всичко се консолидира в една таблица).
Остава предпоследната стъпка: да заредим всичко в Vertica. А, как ни странно, един от най-ефективните и ефективни начини да го направим — е чрез CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Правим специален приемник
StringIO. pandasв който любезно ще сложи нашетоDataFrameвъв форматаCSV-редове.- Отваряме свързване към нашия любим Vertica чрез хук.
- А сега с помощта на
copy()ще изпратим нашите данни директно в Вертица!
От драйвера вземаме колко редове са заредени и казваме на мениджъра на сесията, че всичко е ОК:
session.loaded_rows = cursor.rowcount
session.successful = True
И това е всичко.
В продукция създаваме целевата таблица ръчно. Тук се позволих малко автоматизация:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
С помощта на
VerticaOperator()създавам схема на БД и таблица (ако все още не съществуват, разбира се). Важно е да се поставят правилно зависимостите:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Обобщаваме
— Ето, — каза мишлето, — не е ли вярно, че сега
Убеден ли си, че аз съм най-страшното същество в гората?
Джулия Доналдсън, „Груфало“
Мисля, че ако с моите колеги направим състезание: кой по-бързо ще създаде и стартира ETL процес от нула: те със своите SSIS и мишка, а аз с Airflow… И след това бихме сравнили удобството на поддръжката… ох, мисля, че ще се съгласите, че ще ги изпреваря на всички фронтове!
Ако говорим малко по-сериозно, Apache Airflow – благодарение на описанието на процесите под формата на програмен код – е направил работата ми много по-удобна и приятна.
Неограниченото му разширяване: както по отношение на плъгини, така и предразположението към мащабируемост – ви дава възможност да използвате Airflow практически във всяка област: било в целия цикъл на събиране, подготовка и обработка на данни, било в стартиране на ракети (разбира се, на Марс).
Заключителна част, справочно-информационна
Грабли, които събрахме за вас
start_date. Да, това вече е локален мем. Чрез основния аргумент на дагstart_dateпреминават всички. Накратко, ако зададете вstart_dateтекущата дата, а вschedule_interval— един ден, то DAG ще стартира утре, не по-рано.start_date = datetime(2020, 7, 7, 0, 1, 2)И повече никакви проблеми.
С него е свързана и още една грешка при изпълнение:
Task is missing the start_date parameter, която най-често казва, че сте забравили да свържете с оператора на даг.- Всичко на една машина. Да, и базите (на самия Airflow и нашия интерфейс), и уеб сървърът, и планировщият, и работниците. И то дори работеше. Но с времето броят на задачите в услугите нарастваше, и когато PostgreSQL започна да дава отговор по индекса за 20 ms вместо 5 ms, го взехме и пренесохме.
- LocalExecutor. Да, все още сме на него, и вече сме на ръба на пропастта. LocalExecutor все още ни беше достатъчен, но сега дойде времето да се разширим с поне един работник и ще трябва да се напрегнем, за да преминем на CeleryExecutor. А предвид, че с него може да се работи и на една машина, нищо не ни спира да използваме Celery дори на сървър, който „естествено, никога не ще отиде в продукция, честно!“
- Неползване на вградените средства:
- Connections за съхранение на данни за достъп на услуги,
- SLA Misses за реагиране на задачи, които не са изпълнени навреме,
- XCom за обмен на метаданни (казах метаданни!) между задачите на даг.
- Злоупотребление почтой. Как тут не сказать? Были установлены уведомления на все повторения упавших задач. Теперь в моем рабочем Gmail >90k писем от Airflow, и веб-интерфейс почты отказывается обрабатывать и удалять более 100 штук за раз.
Больше подводных камней:
Средства за още по-голяма автоматизация
Для того чтобы мы могли работать головой, а не руками, Airflow подготовил для нас следующее:
- — он по-прежнему имеет статус Experimental, что не мешает ему работать. С его помощью можно не только получать информацию о дагах и задачах, но и останавливать/запускать даг, создавать DAG Run или пул.
- — через командную строку доступны многие инструменты, которые не только неудобны в использовании через WebUI, а вообще отсутствуют. Например:
backfillнужен для повторного запуска экземпляров задач.
Например, пришли аналитики и говорят: «А у вас, товарищ, проблемы с данными с 1 по 13 января! Исправьте-исправьте-исправьте-исправьте!». А ты так раз:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Обслуживание базы:
initdb,resetdb,upgradedb,checkdb. run, который позволяет запустить один экземпляр задачи и игнорировать все зависимости. Более того, можно запустить его черезLocalExecutor, даже если у вас Celery-кластер.- Примерно то же самое делает
test, только и не записывает ничего в базу. connectionsпозволяет массово создавать подключения из оболочки.
- — довольно хардкорный способ взаимодействия, который предназначен для плагинов, а не для ручного редактирования. Но кто мешает нам зайти в
/home/airflow/dags, запуститьipythonи начать экспериментировать? Можно, например, экспортировать все подключения таким кодом:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Подключение к базе метаданных Airflow. Писать в нее я не рекомендую, а вот получать состояния задач для различных специфических метрик можно значительно быстрее и проще, чем через любой из API.
Скажем, далеко не все наши задачи идемпотентны, и они могут иногда падать, и это нормально. Но несколько сбоев — уже подозрительно, и нужно проверить.
Осторожно, SQL!
С последними_исполнениями КАК (
ВЫБРАТЬ
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
ИЗ public.task_instance
ГДЕ
    execution_date > теперь() - ИНТЕРВАЛ '2' ДНЯ
),
неудавшиеся КАК (
    ВЫБРАТЬ
        task_id,
        dag_id,
        execution_date,
        state,
        CASE WHEN rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 THEN TRUE END AS last_fail_seq
    ИЗ last_executions
    ГДЕ
        state IN ('failed', 'up_for_retry')
)
ВЫБРАТЬ
    task_id,
    dag_id,
    count(last_fail_seq)                       AS unsuccessful,
    count(CASE WHEN last_fail_seq
        И state = 'failed' THEN 1 END)       AS failed,
    count(CASE WHEN last_fail_seq
        И state = 'up_for_retry' THEN 1 END) AS up_for_retry
ИЗ неудавшиеся
GROUP BY
    task_id,
    dag_id
HAVING
    count(last_fail_seq) > 0
Връзки
И, конечно, первые десять ссылок из выдачи гугла содержимое папки Airflow из моих закладок.
- — конечно, нужно начать с официальной документации, но кто же читает инструкции?
- — ну хотя бы рекомендации от создателей прочитайте.
- — самое основное: пользовательский интерфейс в картинках
- — хорошо расписаны базовые понятия, если (вдруг!) вы что-то не поняли у меня.
- — краткий гайд по настройке кластера Airflow.
- — почти такая же интересная статья, разве что формализма побольше, а примеров поменьше.
- — о работе в связке с Celery.
- — про идемпотентность задач, загрузку по ID вместо даты, трансформации, структуру файлов и прочие интересные вещи.
- — зависимости задач и Trigger Rule, которые я упомянул лишь вскользь.
- — как преодолевать некоторые «работает, как задумано» у планировщика, загружать потерянные данные и расставлять приоритеты задач.
- — полезные SQL-запросы к метаданным Airflow.
- — есть полезный раздел про создание кастомного сенсора.
- — интересная короткая заметка о построении инфраструктуры на AWS для Data Science.
- — распространенные ошибки (когда кое-кто всё-таки не читает инструкции).
- — улыбнитесь, как люди костылят хранение паролей, хотя можно просто использовать Connections.
- — неявно предаване на DAG, предаване на контекста в функция, отново за зависимостите, а също така и за пропускането на стартирането на задачи.
- — за използването на
по подразбиране аргументиипараметрив шаблоните, както и за променливи и връзки. - — разказ за подготовката на планировчика за Airflow 2.0.
- — малко остаряла статия за внедряване на нашия клъстер в
docker-compose. - — динамични задачи с помощта на шаблони и предаване на контекста.
- — стандартни и персонализирани известия по имейл и Slack.
- — Разклонения на задачите, макроси и XCom.
И линковете, използвани в статията:
- — налични за използване в шаблоните placeholders.
- — Разпространени грешки при създаване на дагове.
- —
docker-composeза експерименти, отстраняване на проблеми и не само. - — Python обвивка за Telegram REST API.
Източник: habr.com
