

Вероятно, никому не секрет, что минувший год стал годом значительных изменений для Apache Hadoop. В прошлом году произошло слияние Cloudera и Hortonworks (по сути, поглощение второго), а Mapr, столкнувшись с серьезными финансовыми трудностями, был продан Hewlett Packard. Если несколько лет назад выбор при установках on-premises чаще сводился к Cloudera и Hortonworks, то на сегодняшний день этого выбора у нас, увы, не осталось. Сюрпризом стало также то, что Cloudera с февраля этого года объявила о прекращении выпуска бинарных сборок своего дистрибутива в публичный репозиторий, и теперь они доступны только по платной подписке. Конечно, возможность загрузки последних версий CDH и HDP, выпущенных до конца 2019 года, все еще существует, и поддержка по ним предполагается в течение одного-двух лет. Но что делать дальше? Для тех, кто ранее платил за подписку, ничего не изменилось. А для тех, кто не хочет переходить на платную версию дистрибутива, но хочет иметь возможность получать свежие версии компонентов кластера, а также патчи и другие обновления, мы подготовили эту статью. В ней мы рассмотрим возможные варианты выхода из сложившейся ситуации.
Статья больше обзорная. В ней не будет сравнения дистрибутивов и подробного их разбора, а также рецептов по их установке и настройке. А что же будет? Мы кратко расскажем о дистрибутиве Arenadata Hadoop, который по праву заслужил наше внимание благодаря своей доступности, что сегодня является большой редкостью. Затем поговорим о Vanilla Hadoop, в основном о том, как его можно “приготовить” с помощью Apache Bigtop. Готовы? Тогда добро пожаловать под кат.
Arenadata Hadoop
Это совершенно новый и, пока еще, малознакомый дистрибутив отечественной разработки. К сожалению, на данный момент на Хабре о нем имеется лишь .
Более подробную информацию можно найти на официальном проекта. Последние версии дистрибутива основаны на Hadoop 3.1.2 для 3-й версии и 2.8.5 для 2-й версии.
Информацию о дорожной карте можно найти .
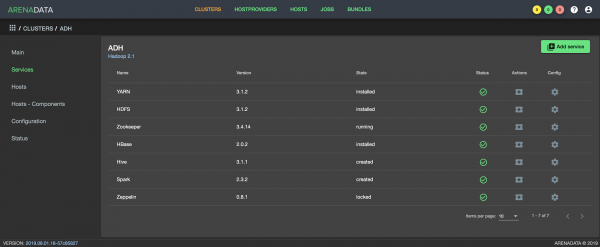
Интерфейс Arenadata Cluster Manager
Ключевым продуктом Arenadata является , който се използва за инсталиране, конфигуриране и мониторинг на различни софтуерни решения на компанията. ADCM се разпространява безплатно, а функционалността му се разширява чрез добавяне на бандли, които представляват набор от ansible-playbooks. Бандлите се делят на два вида: enterprise и community. Последните са налични за безплатно изтегляне от сайта Arenadata. Има и възможност да се разработи собствен бандл и да се свърже с ADCM.
За внедряване и управление на Hadoop 3 се предлага community-версия на бандла в комбинация с ADCM, а за hadoop 2 има само като алтернатива. Що се отнася до репозиториите с пакети, те са отворени за публичен достъп и могат да бъдат изтеглени и инсталирани по обичайния начин за всички компоненти на клъстера. Като цяло дистрибуцията изглежда доста интересна. Сигурен съм, че ще има хора, които са свикнали с решения като Cloudera Manager и Ambari, и на които ADCM ще им хареса. За някои ще бъде огромно предимство и фактът, че дистрибуцията за импортозаместителство.
Ако говорим за недостатъци, те ще бъдат същите, както за всички останали дистрибуции на Hadoop. А именно:
- Така нареченият „vendor lock-in“. На примера на Cloudera и Hortonworks вече разбираме, че винаги съществува риск от промяна на политиката на компанията.
- Значително забавяне по отношение на upstream Apache.
Vanilla Hadoop
Както знаем, Hadoop не е монолитен продукт, а по същество цял набор от услуги около неговата разпределена файлова система HDFS. Малко хора биха били доволни само с един файлов клъстер. На едни им трябва Hive, на други Presto, а има и HBase и Phoenix, все по-често се използва Spark. За оркестрация и зареждане на данни понякога се срещат Oozie, Sqoop и Flume. А когато става въпрос за осигуряване на сигурност, веднага се сеща за Kerberos в комбинация с Ranger.
Бинарните версии на компонентите на Hadoop са налични на сайта на всеки от проектите в екосистемата под формата на tarballs. Можете да ги изтеглите и започнете инсталацията, но с едно условие: освен самостоятелното изграждане на пакети от "сурови" бинарници, в което вероятно ще искате да се захванете, няма да имате никаква увереност в съвместимостта на изтеглените версии на компонентите помежду им. По-предпочитаният вариант е изграждането с Apache Bigtop. Bigtop ще ви позволи да изградите от maven репозитории на Apache, да проведете тестове и да съберете пакети. Но, което е много важно за нас, Bigtop ще събере тези версии на компонентите, които ще бъдат съвместими помежду си. За него ще разкажем по-подробно по-долу.
Apache Bigtop
Apache Bigtop е инструмент за изграждане, пакетиране и тестване на редица
open source проекти, като например Hadoop и Greenplum. Bigtop има множество
издания. Към момента на написване на статията последното стабилно издание бе версия 1.4,
а в master се намираше 1.5. В различните версии на изданията се използват различни версии
на компонентите. Например, за 1.4 основните компоненти на Hadoop са с версия 2.8.5, а в master
2.10.0. Съставът на поддържаните компоненти също се променя. Неща, които са остарели и
не се актуализират, отпадат, а на тяхно място идват нови, по-търсени, и
не е задължително те да са от семейството на самия Apache.
Освен това, Bigtop има множество .
Когато започнахме да се запознаваме с Bigtop, най-вече ни изненада неговата скромна, в сравнение с другите проекти на Apache, разпространеност и известност, а също и съвсем малкото комюнитито. От това следва, че информацията по продукта е минимална, а търсенето на решения на възникналите проблеми по форумите и имейл разпратките може да не даде абсолютно нищо. Първоначално за нас се оказа сложно да извършим пълно изграждане на дистрибутива заради особеностите на самия инструмент, но за това ще разкажем малко по-късно.
Като тизер – на тези, които в свое време се интересуваха от проекти в Linux вселената като Gentoo и LFS, може да им бъде носталгично приятно да поработят с този инструмент и да си припомнят онези "легендарни" времена, когато сами търсехме (или даже пишехме) ebuilds и регулярно пренаписвахме с нови пачове Mozilla.
Голямо предимство на Bigtop е откритостта и универсалността на инструментите, на които е основан. В основата му стоят Gradle и Apache Maven. Gradle е добре известен инструмент, с който Google събира Android. Той е гъвкав и, както се казва, „тестван в битка“. Maven е стандартният инструмент за компилация на проекти в самия Apache, и, тъй като повечето му продукти се публикуват чрез Maven, не е възможно да се мине без него. Кремно внимание заслужава POM (project object model) – „основен“ xml-файл, описващ всичко необходимо за работата на Maven с вашия проект, около който се изгражда цялата работа. Именно в
частта на Maven се появяват някои препятствия, с които обикновено се сблъскват първоначално започващите с Bigtop.
Практика
И така, откъде да започнем? Отиваме на страницата за изтегляне и сваляме последната стабилна версия в архив. Там също можете да намерите бинарни артефакти, събрани от Bigtop. Между другото, от разпространените пакетни мениджъри се поддържат YUM и APT.
Алтернативен начин е да изтеглите последния стабилен релиз директно от
github:
$ git clone --branch branch-1.4 https://github.com/apache/bigtop.gitКлониране в „bigtop“…
remote: Изброяване на обекти: 46, готово.
remote: Преброяване на обекти: 100% (46/46), готово.
remote: Компресиране на обекти: 100% (41/41), готово.
remote: Общо 40217 (delta 14), повторно използвани 10 (delta 1), пакетът се повторно използва 40171
Получаване на обекти: 100% (40217/40217), 43.54 MiB | 1.05 MiB/s, готово.
Определяне на изменения: 100% (20503/20503), готово.
Обновяване на файлове: 100% (1998/1998), готово.
Полученият каталог .//bigtop изглежда по този начин:
.//bigtop-bigpetstore — демонстрационни приложения, синтетични примери
.//bigtop-ci — инструменти за CI, jenkins
.//bigtop-data-generators — генериране на данни, синтетика, за smoke-тестове и т.н.
.//bigtop-deploy — инструменти за деплой
.//bigtop-packages — конфигурации, скриптове, пачове за компилиране, основна част от инструмента
.//bigtop-test-framework — тестов фреймворк
.//bigtop-tests — самите тестове, натоварващи и smoke
.//bigtop_toolchain — среда за компилиране, подготовка на средата за работа на инструмента
.//build — работен каталог за компилиране
.//dl — каталог за изтеглени източници
.//docker — компилиране в docker образи, тестване
.//gradle — конфигурация на gradle
.//output – каталог, в който попада артефактите от компилирането
.//provisioner — провизионство
Най-интересното на този етап за нас е основната конфигурация .//bigtop/bigtop.bom, в който виждаме всички поддържани компоненти с версии. Именно тук можем да посочим друга версия на продукта (ако искаме да я тестваме) или версия на сборката (например, ако сме добавили значима корекция).
Също така голям интерес представлява подкаталогът .\/bigtop\/bigtop-packages, който е тясно свързан с процеса на изграждане на компоненти и пакети с тях.
И така, изтеглихме архива, разархивирахме го или направихме клон от github, можем ли да започнем изграждането?
Не, първо трябва да подготвим околната среда.
Подготовка на околната среда
И тук ще направим малко отклонение. За изграждане на практически всеки по-сложен продукт е необходима определена околна среда — в нашия случай това е JDK, същите споделени библиотеки, заглавни файлове и т.н., инструменти, като ant, ivy2 и много още. Един от вариантите за получаване на необходимата среда за Bigtop е инсталиране на нужните компоненти на хост машината. Може да бъркам в хронологията, но изглежда, че с версия 1.0 също стана възможно изграждането в предварително конфигурирани и достъпни docker образи, с които може да се запознаете тук.
Що се отнася до подготовката на околната среда, за това има помощник — Puppet.
Можете да използвате следните команди, изпълнението става от коренната директория
на инструмента, .\/bigtop:
.\/gradlew toolchain
.\/gradlew toolchain-devtools
.\/gradlew toolchain-puppetmodules
Или направо през puppet:
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::installer"
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::deployment-tools"
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::development-tools"
За съжаление, вече на този етап могат да възникнат трудности. Общият съвет тук — да се използва поддържан дистрибутив, актуален на хоста за изграждане или да се пробва с docker.
Сборка
Какво можем да се опитаме да изградим? Отговорът на този въпрос ще даде изходът от командата
.\/gradlew tasks В раздела Package tasks има редица продукти, които са крайни артефакти на Bigtop.
Тях можем да разпознаем по суфикса -rpm или -pkg-ind (в случай на изграждане
в docker). В нашия случай най-интересният е Hadoop.
Нека опитаме да изпълним изграждането в околната среда на нашия build-сървър:
.\/gradlew hadoop-rpmBigtop ще изтегли необходимите изходни файлове за конкретния компонент и ще започне сглобяването. По този начин работата на инструмента е свързана с хранилищата на Maven и други източници, което означава, че е необходим достъп до Интернет.
В процеса на работа се генерира стандартен изход. Понякога по него и съобщенията за грешки можете да разберете какво е не така. А понякога е нужно да получите допълнителна информация. В този случай заслужава да добавите аргументите --info или --debug, и също така може да бъде полезен –stacktrace. Има удобен начин да се генерират набори от данни за последващи обращения в списъци за разпространение, ключ --scan.
С негова помощ bigtop ще събере цялата информация и ще я публикува в gradle, след което ще предостави линк,
преминавайки през който, компетентен човек ще може да разбере защо сглобяването е неуспешно.
Трябва да се има предвид, че тази опция може да направи публична нежелана за вас информация, например, имена на потребители, нодове, променливи на околната среда и т.н., така че бъдете внимателни.
Често грешките са следствие от невъзможността да се получат необходимите компоненти за сглобяване. Обикновено проблемът може да бъде поправен чрез създаване на патч за коригиране на нещо в изходните файлове, например адреса в pom.xml в коренната директория на изходния код. Това става чрез създаването и положението му в съответната директория .\/bigtop\/bigtop-packages\/src\/common\/oozie\/ патч, например, във вида patch2-fix.diff.
--- a\/pom.xml
+++ b\/pom.xml
@@ -136,7 +136,7 @@
<repositories>
<repository>
<id>central<\/id>
- <url>http:\/\/repo1.maven.org\/maven2<\/url>
+ <url>https:\/\/repo1.maven.org\/maven2<\/url>
<snapshots>
<enabled>false<\/enabled>
<\/snapshots>
Скорее всего, в момент чтения данной статьи вам не придется делать указанное выше исправление самостоятельно.
При внедрении каких-либо патчей и правок в механизм сборки может понадобиться "сбросить" сборку через команду очистки:
.\/gradlew hadoop-clean
> Task :hadoop_vardefines
> Task :hadoop-clean
BUILD SUCCESSFUL in 5s
2 actionable tasks: 2 executed
Операцията ще откатне всички промени по сглобяването на този компонент, след което сглобяването ще се изпълни отново. В този случай ще опитаме да съберем проекта в docker-образ:
./gradlew -POS=centos-7 -Pprefix=1.2.1 hadoop-pkg-ind
> Task :hadoop-pkg-ind
Building 1.2.1 hadoop-pkg on centos-7 in Docker...
+++ dirname ./bigtop-ci/build.sh
++ cd ./bigtop-ci/..
++ pwd
+ BIGTOP_HOME=/tmp/bigtop
+ '[' 6 -eq 0 ']'
+ [[ 6 -gt 0 ]]
+ key=--prefix
+ case $key in
+ PREFIX=1.2.1
+ shift
+ shift
+ [[ 4 -gt 0 ]]
+ key=--os
+ case $key in
+ OS=centos-7
+ shift
+ shift
+ [[ 2 -gt 0 ]]
+ key=--target
+ case $key in
+ TARGET=hadoop-pkg
+ shift
+ shift
+ [[ 0 -gt 0 ]]
+ '[' -z x ']'
+ '[' -z x ']'
+ '[' '' == true ']'
+ IMAGE_NAME=bigtop/slaves:1.2.1-centos-7
++ uname -m
+ ARCH=x86_64
+ '[' x86_64 '!=' x86_64 ']'
++ docker run -d bigtop/slaves:1.2.1-centos-7 /sbin/init
+
CONTAINER_ID=0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8
+ trap 'docker rm -f
0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8' EXIT
....
много вывода
....
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-mapreduce-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-namenode-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-secondarynamenode-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-zkfc-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-journalnode-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-datanode-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-httpfs-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-resourcemanager-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-nodemanager-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-proxyserver-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-yarn-timelineserver-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-mapreduce-historyserver-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-client-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-conf-pseudo-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-doc-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-libhdfs-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-libhdfs-devel-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-hdfs-fuse-2.8.5-1.el7.x86_64.rpm
Wrote: /bigtop/build/hadoop/rpm/RPMS/x86_64/hadoop-debuginfo-2.8.5-1.el7.x86_64.rpm
+ umask 022
+ cd /bigtop/build/hadoop/rpm//BUILD
+ cd hadoop-2.8.5-src
+ /usr/bin/rm -rf /bigtop/build/hadoop/rpm/BUILDROOT/hadoop-2.8.5-1.el7.x86_64
Executing(%clean): /bin/sh -e /var/tmp/rpm-tmp.uQ2FCn
+ exit 0
+ umask 022
Executing(--clean): /bin/sh -e /var/tmp/rpm-tmp.CwDb22
+ cd /bigtop/build/hadoop/rpm//BUILD
+ rm -rf hadoop-2.8.5-src
+ exit 0
[ant:touch] Creating /bigtop/build/hadoop/.rpm
:hadoop-rpm (Thread[Task worker for ':',5,main]) completed. Took 38 mins 1.151 secs.
:hadoop-pkg (Thread[Task worker for ':',5,main]) started.
> Task :hadoop-pkg
Task ':hadoop-pkg' is not up-to-date because:
Task has not declared any outputs despite executing actions.
:hadoop-pkg (Thread[Task worker for ':',5,main]) completed. Took 0.0 secs.
BUILD SUCCESSFUL in 40m 37s
6 actionable tasks: 6 executed
+ RESULT=0
+ mkdir -p output
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:/bigtop/build .
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:/bigtop/output .
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
+ '[' 0 -ne 0 ']'
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
Error: No such container:
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
BUILD SUCCESSFUL in 41m 24s
1 actionable task: 1 executed
Сборката беше извършена под CentOS, но може да се реализира и под Ubuntu:
.\/gradlew -POS=ubuntu-16.04 -Pprefix=1.2.1 hadoop-pkg-indОсвен създаването на пакети за различни дистрибуции на Linux, инструментът може да генерира хранилище с компилирани пакети, например:
.\/gradlew yumСъщо така можем да споменем smoke тестовете и разгръщането в docker.
Създайте клъстер от три нода:
.\/gradlew -Pnum_instances=3 docker-provisionerСтартирайте smoke тестовете в клъстера от три нода:
.\/gradlew -Pnum_instances=3 -Prun_smoke_tests docker-provisionerИзтрийте клъстера:
.\/gradlew docker-provisioner-destroyПолучете команди за свързване към docker контейнерите:
.\/gradlew docker-provisioner-sshПокажете състоянието:
.\/gradlew docker-provisioner-statusМожете да прочетете повече за задачите по разгръщане в документацията.
Ако говорим за тестовете, те са в доста голямо количество, предимно smoke и интеграционни. Разборът им е извън обхвата на тази статия. Ще кажа само, че създаването на дистрибуция не е толкова сложна задача, колкото може да изглежда на пръв поглед. Всички компоненти, които използваме в продукцията, успяхме да компилираме и да преминем тестовете, и нямаме проблеми с тяхното разгръщане и извършване на основни операции в тестова среда.
Освен наличните компоненти в Bigtop, има възможност да добавите и нещо друго, дори собствена софтуерна разработка. Всичко това отлично се автоматизира и вписва в концепцията CI\/CD.
Заключение
Очевидно е, че създаденият по този начин дистрибутив не следва веднага да се изпраща в продукция. Трябва да разберем, че ако има реална нужда от създаване и поддръжка на собствен дистрибутив, в него трябва да се инвестира финансово и времево.
Въпреки това, в съчетание с правилния подход и професионален екип, напълно е възможно да се мине и без търговски решения.
Важно е да се отбележи, че самият проект Bigtop се нуждае от развитие и изглежда, че в момента няма активна разработка в него. Също така не е ясна перспективата за появата на Hadoop 3 в него. Между другото, ако имате реална нужда от създаване на Hadoop 3, можете да погледнете на от Arenadata, която освен стандартните
компоненти, предлага и редица допълнителни (Ranger, Knox, NiFi).
Що се отнася до Ростелеком, то за нас Bigtop е един от разглежданите варианти в момента. Дали ще изберем него или не, ще покаже времето.
Приложение
За да добавите нов компонент в изграждането, е необходимо да добавите неговото описание в bigtop.bom и ./bigtop-packages. Можете да опитате да направите това по аналогия с наличните компоненти. Опитайте се да разберете. Не е толкова сложно, колкото изглежда на пръв поглед.
Какво мислите вие? Ще се радваме да видим вашето мнение в коментарите и благодаря за вниманието!
Статията е подготвена от екипа за управление на данни на "Ростелеком"
Източник: habr.com
