

Здравейте, Хабр! Днес ще изградим система, която с помощта на Spark Streaming ще обработва потоци от съобщения Apache Kafka и ще записва резултатите от обработката в облачна база данни AWS RDS.
Представете си, че една кредитна организация поставя пред нас задачата да обработваме входящите транзакции "на лето" за всички свои клонове. Това може да се направи с цел бързо изчисление на позиция с открита валута заTreasury, лимити или финансов резултат по сделки и т.н.
Как да реализираме този случай без използване на магия и вълшебни заклинания — четете под кат! Да започнем!
Въведение
Безспорно, обработката на голям обем данни в реално време предоставя широки възможности за използване в съвременните системи. Една от най-популярните комбинации за това е тандемът Apache Kafka и Spark Streaming, където Kafka създава поток от входящи съобщения, а Spark Streaming обработва тези пакети в зададен интервал от време.
За повишаване на устойчивостта на приложението ще използваме контролните точки — чекпоинти (checkpoints). С помощта на този механизъм, когато модулът Spark Streaming трябва да възстанови загубени данни, той ще трябва просто да се върне към последната контролна точка и да възобнови изчисленията оттам.
Архитектура на разработваната система
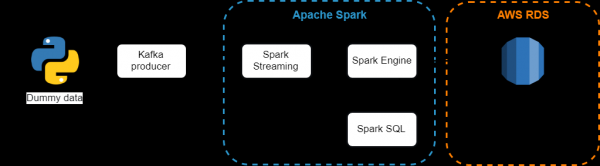
Използвани компоненти:
- — това е разпределена система за обмен на съобщения с публикация и подписка. Подходяща както за автономно, така и за онлайн потребление на съобщения. За предотвратяване на загубата на данни, съобщенията Kafka се съхраняват на диска и се репликират в клъстера. Системата Kafka е изградена върху услугата за синхронизация ZooKeeper;
- — компонент Spark за обработка на поточни данни. Модулът Spark Streaming е построен с „микропакетна“ архитектура (micro-batch architecture), при която потокът от данни се интерпретира като непрекъсната последователност от малки пакети данни. Spark Streaming приема данни от различни източници и ги обединява в малки пакети. Нови пакети се създават през регулярни интервали от време. В началото на всеки времеви интервал се създава нов пакет, а всички данни, постъпили в този интервал, се включват в пакета. В края на интервала увеличаването на пакета спира. Размерът на интервала се определя от параметър, наречен интервал на пакетиране (batch interval);
- — обединява релационна обработка с функционално програмиране на Spark. Под структурирани данни се разбират данни с схема, тоест единен набор полета за всички записи. Spark SQL поддържа въвеждане от множество източници на структурирани данни и, благодарение на наличието на информация за схемата, може ефективно да извлече само необходимите полета от записите, както и предоставя API интерфейси DataFrame;
- — това е сравнително евтина облачна релационна база данни, уеб услуга, която опростява настройката, експлоатацията и мащабирането и се администрира директно от Amazon.
Инсталиране и стартиране на Kafka сървър
Преди непосредствено да използвате Kafka, трябва да се уверите, че имате Java, тъй като работа изисква JVM:
sudo apt-get update
sudo apt-get install default-jre
java -version
Създаваме нов потребител за работа с Kafka:
sudo useradd kafka -m
sudo passwd kafka
sudo adduser kafka sudo
След това изтеглете дистрибуцията от официалния сайт на Apache Kafka:
wget -P /YOUR_PATH "http://apache-mirror.rbc.ru/pub/apache/kafka/2.2.0/kafka_2.12-2.2.0.tgz"Разархивираме изтегления архив:
tar -xvzf /YOUR_PATH/kafka_2.12-2.2.0.tgz
ln -s /YOUR_PATH/kafka_2.12-2.2.0 kafka
Следващата стъпка е опционална. Факт е, че настройките по подразбиране не позволяват пълноценно използване на всички възможности на Apache Kafka. Например, да изтривате тема, категория, група, на които могат да бъдат публикувани съобщения. За да променим това, ще редактираме конфигурационния файл:
vim ~/kafka/config/server.propertiesДобавете следното в края на файла:
delete.topic.enable = trueПреди да стартираме Kafka сървъра, е необходимо да стартираме сървъра ZooKeeper. Ще използваме помощен скрипт, който се доставя с дистрибуцията на Kafka:
Cd ~/kafka
bin/zookeeper-server-start.sh config/zookeeper.properties
След успешния старт на ZooKeeper, в отделен терминал стартираме Kafka сървъра:
bin/kafka-server-start.sh config/server.propertiesДа създадем нова тема с името Transaction:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic transactionДа се уверим, че темата с нужното количество партиции и репликация е била създадена:
bin/kafka-topics.sh --describe --zookeeper localhost:2181 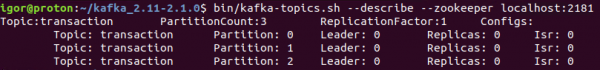
Пропускаме тестовете на продюсера и консуматора за новосъздадената тема. По-подробно за това как да тествате изпращането и приемането на съобщения, можете да намерите в официалната документация — . А ние се прехвърляме към написването на продюсера на Python с използването на KafkaProducer API.
Написване на продюсера
Продюсерът ще генерира случайни данни — по 100 съобщения всяка секунда. Под случайни данни разбираме речник, състоящ се от три полета:
- Клон — наименование на точка за продажба на кредитна институция;
- Currency — валута на сделката;
- Amount — сума на сделката. Сумата ще бъде положително число, ако е покупка на валута от банката, и отрицателно — ако е продажба.
Кодът за продюсера изглежда по следния начин:
from numpy.random import choice, randint

def get_random_value():
    new_dict = {}

    branch_list = ['Kazan', 'SPB', 'Novosibirsk', 'Surgut']
    currency_list = ['RUB', 'USD', 'EUR', 'GBP']

    new_dict['branch'] = choice(branch_list)
    new_dict['currency'] = choice(currency_list)
    new_dict['amount'] = randint(-100, 100)

    return new_dict
След това, използвайки метода send, изпращаме съобщение на сървъра, в нужната ни тема, в JSON формат:
from kafka import KafkaProducer

producer = KafkaProducer(bootstrap_servers=['localhost:9092'],
                             value_serializer=lambda x:dumps(x).encode('utf-8'),
                             compression_type='gzip')
my_topic = 'transaction'
data = get_random_value()

try:
    future = producer.send(topic = my_topic, value = data)
    record_metadata = future.get(timeout=10)

    print('--> Съобщението е изпратено към тема:
            {}, партиция: {}, offset: {}'
            .format(record_metadata.topic,
                record_metadata.partition,
                record_metadata.offset ))

except Exception as e:
    print('--> Изглежда е настъпила грешка: {}'.format(e))

finally:
    producer.flush()
При стартиране на скрипта получаваме следните съобщения в терминала:
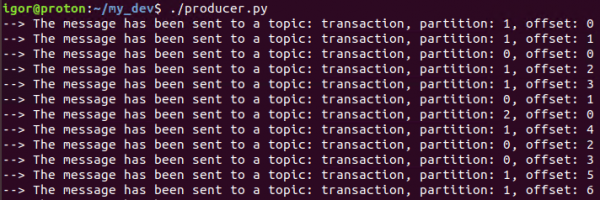
Това означава, че всичко функционира, както искахме — продюсерът генерира и изпраща съобщения в нужната ни тема.
Следващата стъпка ще бъде инсталацията на Spark и обработката на този поток от съобщения.
Инсталация на Apache Spark
Apache Spark — това е универсална и високопроизводителна кластерна изчислителна платформа.
По производителност Spark надхвърля популярните реализации на модела MapReduce, като същевременно осигурява поддръжка за по-широк диапазон от типове изчисления, включително интерактивни запитвания и потокова обработка. Скоростта играе важна роля при обработката на големи количества данни, тъй като именно тя позволява работа в интерактивен режим, без да се изразходват минути или часове за чакане. Едно от основните предимства на Spark, което осигурява толкова висока скорост, е способността му да извършва изчисления в паметта.
Този фреймуърк е написан на Scala, така че е необходимо първо да я инсталирате:
sudo apt-get install scalaИзтеглете дистрибутива на Spark от официалния сайт:
wget "http://mirror.linux-ia64.org/apache/spark/spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz"Разархивирайте архива:
sudo tar xvf spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz -C /usr/local/sparkДобавете пътя към Spark в bash файла:
vim ~/.bashrcДобавете следните редове чрез редактора:
SPARK_HOME=/usr/local/spark
export PATH=$SPARK_HOME/bin:$PATH
Изпълнете следната команда след направените промени в bashrc:
source ~/.bashrcРазгръщане на AWS PostgreSQL
Остава да разгръщате база данни, в която ще зареждаме обработената информация от потоковете. За това ще използваме услугата AWS RDS.
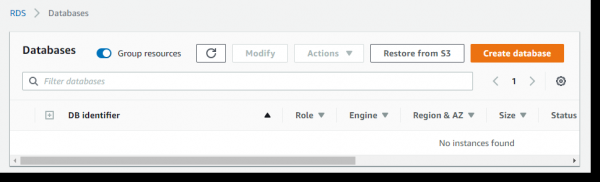
Влизаме в конзолата на AWS —> AWS RDS —> Databases —> Create database:
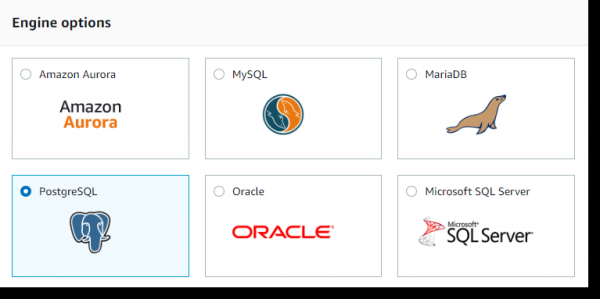
Избираме PostgreSQL и натискаме бутона Next:
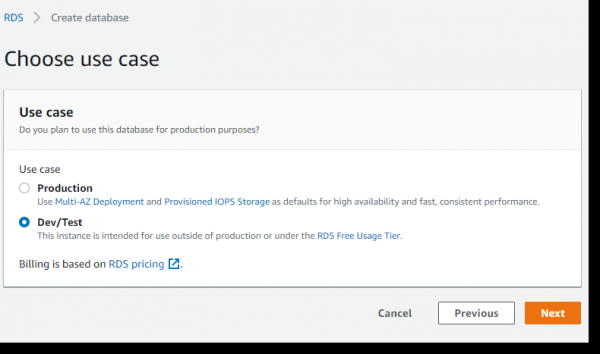
Тъй като този пример се разглежда единствено с образователна цел, ще използваме безплатен сървър "на минималках" (Free Tier):
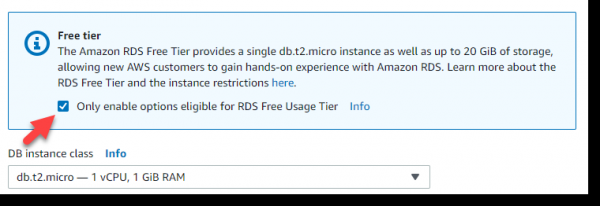
След това поставяме отметка в блока Free Tier и след това автоматично ще ни бъде предложен инстанс от клас t2.micro — макар и слабичък, но безплатен и напълно подходящ за нашата задача:
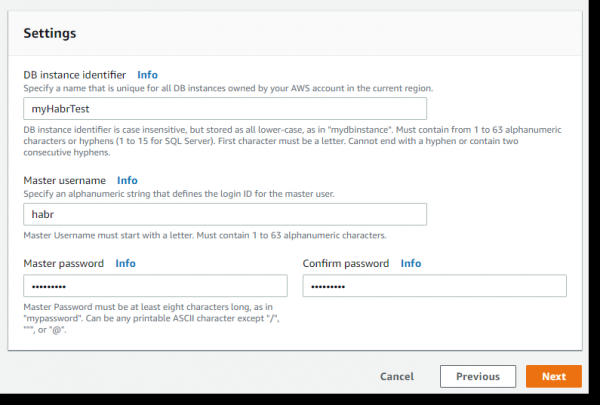
Следват много важни неща: наименование на инстанса на БД, име на майстор-потребителя и неговата парола. Нека наречем инстанса: myHabrTest, майстор-потребител: habr, парола: habr12345 и натискаме бутона Next:
На следващата страница са параметрите, отговарящи за достъпността на нашия БД сървър от външни източници (Public accessibility) и достъпността на портовете:
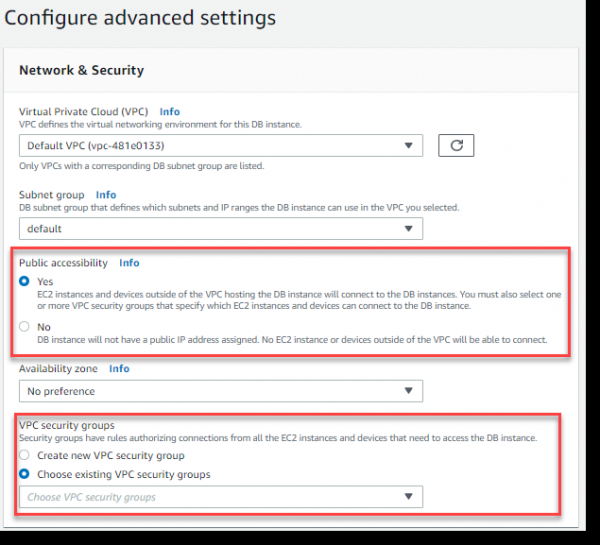
Нека създадем нова настройка за VPC security group, която ще позволи достъпа до нашия БД сървър извън порт 5432 (PostgreSQL).
Преминаваме в отделен прозорец на браузъра към конзолата на AWS в раздела VPC Dashboard —> Security Groups —> Create security group:
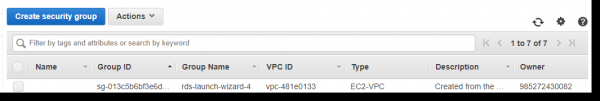
Задаваме име за групата за сигурност — PostgreSQL, описание, указваме към коя VPC тази група трябва да бъде асоциирана и натискаме бутона Create:

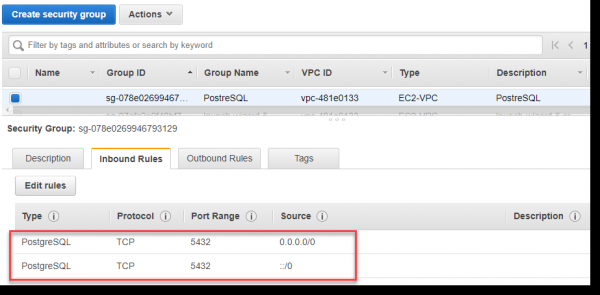
Попълваме за новосъздадената група Inbound rules за порт 5432, както е показано на изображението по-долу. Не е необходимо ръчно да посочваме порта, а можем да изберем PostgreSQL от падащото меню Type.
Строго погледнато, стойността ::/0 означава наличност на входящия трафик за сървъра от целия свят, което канонично не е съвсем вярно, но за целите на примера можем да си позволим да използваме такъв подход:
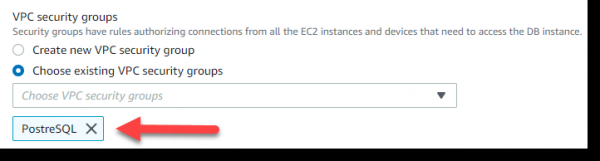
Връщаме се на страницата на браузъра, където имаме отворено „Configure advanced settings“ и избираме в раздела VPC security groups —> Choose existing VPC security groups —> PostgreSQL:
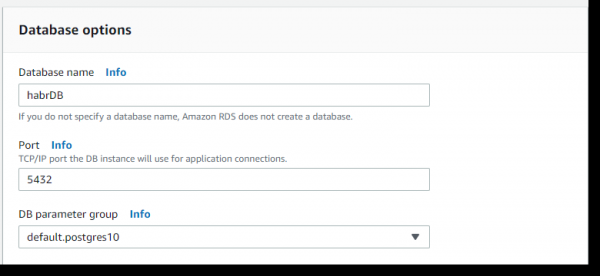
След това, в раздела Database options —> Database name —> задаваме име — habrDB.
Оставяме другите параметри, освен ако не е необходимо отключване на бекъпите (backup retention period — 0 days), мониторинг и Performance Insights, по подразбиране. Натискаме бутона Create database:
Обработчик на потока
Заключителният етап ще бъде разработка на Spark работа, която на всеки две секунди ще обработва нови данни, пристигащи от Kafka и ще записва резултата в базата данни.
Както бе споменато по-горе, контрольните точки (checkpoints) са основният механизъм в Spark Streaming, който трябва да бъде настроен за осигуряване на отказоустойчивост. Ще използваме контрольни точки и, в случай на срив на процедурата, модулът Spark Streaming за възстановяване на изгубените данни трябва само да се върне към последната контрольна точка и да възобнови изчисленията от нея.
Контрольната точка може да бъде включена, като се установи каталог в отказоустойчива, надеждна файлова система (например, HDFS, S3 и т.н.), в която ще бъде запазена информацията за контрольната точка. Това се прави с помощта на, например:
streamingContext.checkpoint(checkpointDirectory)В нашия пример ще използваме следния подход, а именно, ако checkpointDirectory съществува, контекстът ще бъде възстановен от данните на контрольната точка. Ако каталогът не съществува (т.е. изпълнява се за първи път), ще се извика функцията functionToCreateContext за създаване на нов контекст и настройка на DStreams:
from pyspark.streaming import StreamingContext

context = StreamingContext.getOrCreate(checkpointDirectory, functionToCreateContext)
Създаваме обект DirectStream с цел свързване към темата „transaction“ чрез метода createDirectStream на библиотеката KafkaUtils:
от pyspark.streaming.kafka импортируйте KafkaUtils

sc = SparkContext(conf=conf)
ssc = StreamingContext(sc, 2)

broker_list = 'localhost:9092'
topic = 'transaction'

directKafkaStream = KafkaUtils.createDirectStream(ssc,
                                [topic],
                                {"metadata.broker.list": broker_list})
Парсим входящи данни в JSON формат:
rowRdd = rdd.map(lambda w: Row(branch=w['branch'],
                                       currency=w['currency'],
                                       amount=w['amount']))

testDataFrame = spark.createDataFrame(rowRdd)
testDataFrame.createOrReplaceTempView("treasury_stream")
С използването на Spark SQL извършваме проста групировка и извеждаме резултата в конзолата:
select
    from_unixtime(unix_timestamp()) as curr_time,
    t.branch                        as branch_name,
    t.currency                      as currency_code,
    sum(amount)                     as batch_value
from treasury_stream t
group by
    t.branch,
    t.currency
Получаваме текста на запитването и го изпълняваме чрез Spark SQL:
sql_query = get_sql_query()
testResultDataFrame = spark.sql(sql_query)
testResultDataFrame.show(n=5)
След това запазваме получените агрегирани данни в таблица в AWS RDS. За да запишем резултатите от агрегиране в таблицата, ще използваме метода write на обекта DataFrame:
testResultDataFrame.write
    .format("jdbc")
    .mode("append")
    .option("driver", 'org.postgresql.Driver')
    .option("url","jdbc:postgresql://myhabrtest.ciny8bykwxeg.us-east-1.rds.amazonaws.com:5432/habrDB")
    .option("dbtable", "transaction_flow")
    .option("user", "habr")
    .option("password", "habr12345")
    .save()
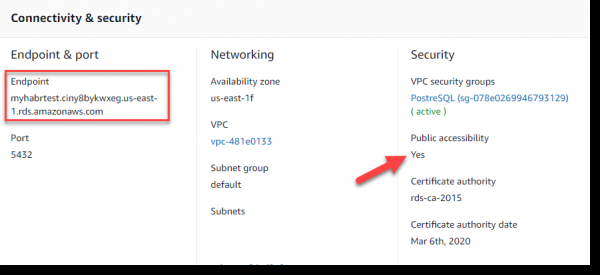
Няколко думи за конфигурирането на свързването с AWS RDS. Потребителското име и паролата му създадохме на стъпка "Разгръщане на AWS PostgreSQL". Като URL на базата данни трябва да използваме Endpoint, който се показва в раздела Connectivity & security:
С цел правилна връзка между Spark и Kafka, е необходимо да стартирате джобата чрез spark-submit, като използвате артефакта spark-streaming-kafka-0-8_2.11. Освен това ще приложим и артефакта за работа с базата данни PostgreSQL, които ще предаваме чрез —packages.
За гъвкавост на скрипта, ще изнесем имената на сървъра на съобщенията и на темата, от която искаме да получаваме данни, като входни параметри.
И така, време е да стартираме и проверим работоспособността на системата:
spark-submit
--packages org.apache.spark:spark-streaming-kafka-0-8_2.11:2.0.2,
org.postgresql:postgresql:9.4.1207
spark_job.py localhost:9092 transaction
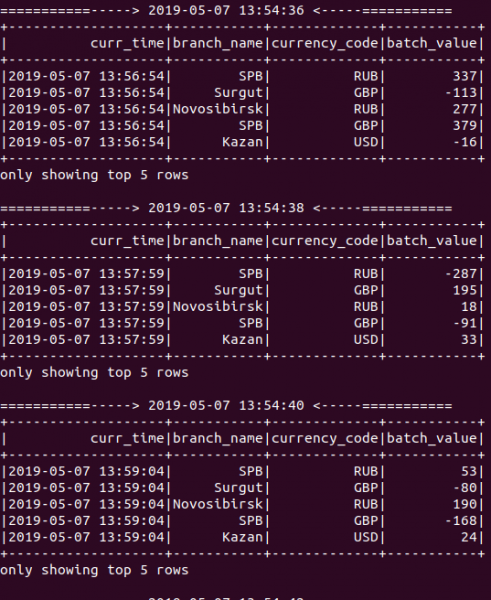
Всичко работи! Както се вижда на картинката по-долу — по време на работата на приложението новите резултати от агрегиране се показват на всеки 2 секунди, защото задать интервалът за пакетиране на 2 секунди, когато създавахме обекта StreamingContext:
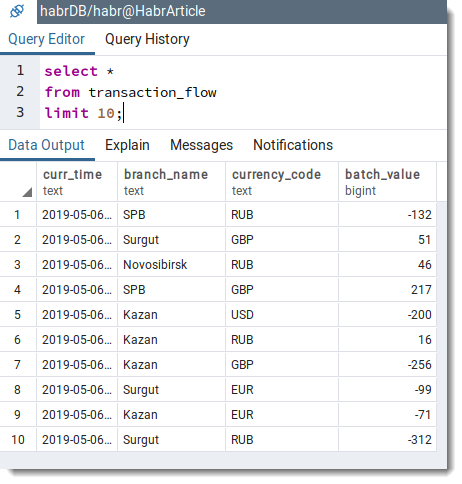
Следва да направим несложно запитване към базата данни, за да проверим наличието на записи в таблицата transaction_flow:
Заключение
В тази статия беше разгледан пример за потокова обработка на информация с използването на Spark Streaming в комбинация с Apache Kafka и PostgreSQL. С нарастващите обеми данни от различни източници, трудно може да се подцени практическата стойност на Spark Streaming за създаване на потокови приложения и приложения, работещи в реално време.
Пълният изходен код можете да намерите в моето хранилище на .
С удоволствие съм готов да обсъждам тази статия, очаквам вашите коментари и се надявам на конструктивна критика от всички заинтересовани читатели.
Пожелавам успех!
Ps. Първоначално беше планирано да се използва локална БД PostgreSQL, но с оглед на моята любов към AWS, реших да преместя базата данни в облака. В следващата статия по темата ще покажа как да реализираме напълно описаната по-горе система в AWS с помощта на AWS Kinesis и AWS EMR. Следете новините!
Източник: habr.com
