

Здравейте, аз съм Сергей Еланцев, разработвам в Яндекс.Облака. Преди това ръководих разработването на L7-балансировчика на портала на Яндекс — колегите шегуват, че каквото и да правя, все е балансьор. Ще разкажа на читателите на Хабра как трябва да се управлява натоварването в облачната платформа, какъв инструмент виждаме като идеален за постигането на тази цел и как сме на прав път към изграждането на този инструмент.
За начало нека въведем някои термини:
- VIP (Virtual IP) — IP-адрес на балансьора
- Сървър, бекенд, инстанс — виртуална машина с работещо приложение
- RIP (Real IP) — IP-адрес на сървъра
- Healthcheck — проверка на готовността на сървъра
- Зона на наличност, Availability Zone, AZ — изолирана инфраструктура в дата центъра
- Регион — обединение на различни AZ
Балансьорите на натоварването решават три основни задачи: извършват самата балансировка, подобряват устойчивостта на услугата и опростяват нейното мащабиране. Устойчивостта се осигурява чрез автоматично управление на трафика: балансьорът следи състоянието на приложението и изключва от балансировката инстансите, които не са преминали проверката за живост. Мащабирането се осигурява чрез равномерно разпределение на натоварването между инстансите, а също и чрез актуализация на списъка с инстанси в движение. Ако балансировката не е достатъчно равномерна, то някои от инстансите ще получат натоварване, което надвишава техния работен капацитет, и услугата ще стане по-малко надеждна.
Балансьорът на натоварването често се класифицира по нивото на протокола от модела OSI, на което работи. Балансьорът на Облака работи на ниво TCP, което съответства на четвърто ниво, L4.
Ще преминем към преглед на архитектурата на балансьора на Облака. Ще увеличаваме постепенно нивото на детайлизация. Ние делим компонентите на балансьора на три класа. Клас config plane отговаря за взаимодействието с потребителя и съхранява целевото състояние на системата. Control plane съхранява актуалното състояние на системата и управлява системите от класа data plane, които отговарят непосредствено за доставянето на трафик от клиентите до вашите инстанси.
Data plane
Трафик попада на скъпи устройства, наречени border routers. За повишаване на отказоустойчивостта, в един дата център работят едновременно няколко от тези устройства. След това трафикът достига до балансировачите, които анонсират anycast IP адрес на всички AZ чрез BGP за клиентите.
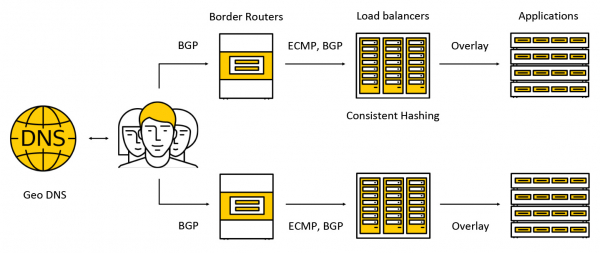
Трафикът се предава по ECMP — това е стратегия за маршрутизиране, при която могат да съществуват няколко равно добри маршрута до целта (в нашия случай целта ще бъде destination IP адрес) и пакетите могат да бъдат изпратени по който и да е от тях. Също така, ние поддържаме работа в няколко зони на достъпност по следната схема: анонсираме адрес в всяка от зоните, трафикът попада в най-близката и вече извън нея не излиза. По-нататък в поста ще разгледаме по-подробно какво се случва с трафика.
Config plane
Ключовият компонент на config plane е API, чрез който се извършват основните операции с балансировачите: създаване, изтриване, променяне на състава на инстансите, получаване на резултати от healthchecks и т.н. От една страна, това е REST API, а от друга, в Облака много често използваме фреймворка gRPC, затова „превеждаме“ REST в gRPC и после използваме само gRPC. Всеки запит води до създаването на серия от асинхронни идемпотентни задачи, които се изпълняват на общия пул от работници на Яндекс.Облак. Задачите са написани по такъв начин, че могат да бъдат спрени по всяко време и след това започнати отново. Това осигурява мащабируемост, повторяемост и логируемост на операциите.
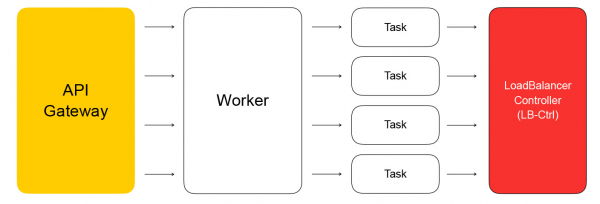
В резултат на това задачата от API ще извърши запитване към сервис-контролера на балансировачите, който е написан на Go. Той може да добавя и изтрива балансировачи, да променя състава на бекендовете и настройките.
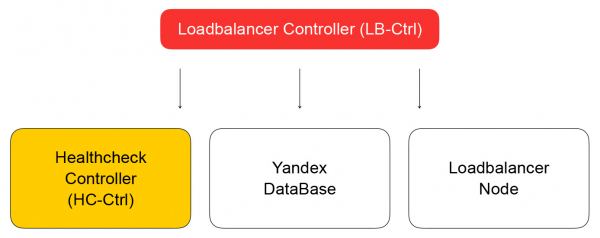
Сервисът съхранява своето състояние в Yandex Database — разпределена управлявана БД, с която скоро можете да се възползвате и вие. В Яндекс.Облак, както вече , действа концепцията dog food: ако ние самите ползваме нашите услуги, то и нашите клиенти също ще се радват да ги използват. Yandex Database е пример за реализиране на подобна концепция. Ние съхраняваме всичките си данни в YDB и не ни се налага да мислим за поддръжка и мащабиране на базата: тези проблеми са решени вместо нас, ние ползваме базата като услуга.
Връщаме се към контролера на балансьора. Неговата задача е да запази информация за балансьора, да изпрати задача за проверка на готовността на виртуалната машина в контролера за здраве.
Контролер за проверка на здраве
Той получава заявки за промяна на правилата за проверки, ги запазва в YDB, разпределя задачите между нодовете за проверка на здраве и агрегира резултатите, които след това се записват в базата и се изпращат на контролера на балансьора. Той, от своя страна, изпраща заявка за промяна на състава на клъстера в данъчната плоскост на loadbalancer-node, за който ще говоря по-долу.
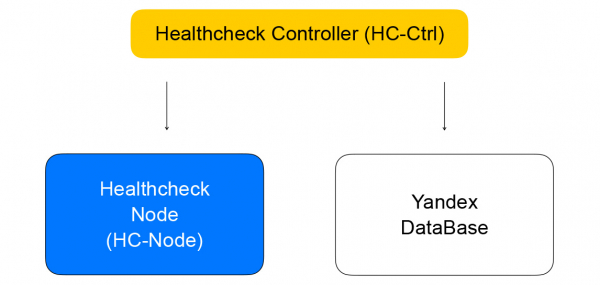
Нека поговорим по-подробно за проверките за здраве. Те могат да бъдат разделени на няколко класа. Проверки имат различни критерии за успех. TCP проверките трябва успешно да установят връзка в определен период от време. HTTP проверките изискват както успешна връзка, така и получаване на отговор със статус код 200.
Също така, проверките се различават по клас на действие — те могат да бъдат активни и пасивни. Пасивните проверки просто следят какво се случва с трафика, без да предприемат специални действия. Това не работи особено добре на L4, тъй като зависи от логиката на протоколите на по-високо ниво: на L4 няма информация за времето, което е отнело операцията, и дали затварянето на връзката е било добро или лошо. Активните проверки изискват балансьорът да изпраща заявки до всяки инстанс на сървъра.
По-голямата част от балансьорите на натоварването извършват проверки за „живост“ самостоятелно. Ние в Облака решихме да разделим тези части на системата, за да увеличим мащабируемостта. Такъв подход ни позволява да увеличим броя на балансьорите, запазвайки броя на заявките за проверка на здраве към услугата. Проверките се извършват от отделни нодове за проверка на здраве, по които са шардировани и реплицирани целите на проверките. Не може да се правят проверки от един хост, тъй като той може да се провали. Тогава не получаваме състоянието на проверените от него инстанси. Извършваме проверки на всеки от инстансите минимум от три нода за проверка на здраве. Целите на проверките шардируеме между нодовете с помощта на алгоритми за консистентно хеширане.
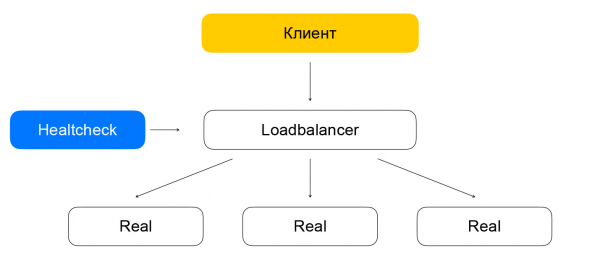
Разделянето на балансировка и проверка на състояние може да доведе до проблеми. Ако проверката на състоянието на нода извършва заявки към инстанцията, заобикаляйки балансировача (който в момента не обслужва трафик), се получава странна ситуация: ресурсът изглежда активен, но трафикът не достига до него. Тази проблема решаваме, като гарантираме, че трафикът от проверките минава през балансировачите. С други думи, схемата на преместване на пакети с клиентски трафик и трафик от проверки почти не се различава: в двата случая пакетите ще достигнат до балансировачите, които ще ги доставят до целевите ресурси.
Разликата е, че клиентите правят заявки на VIP, а проверките на състоянието се обръщат към всеки отделен RIP. Тук възниква интересен проблем: на нашите потребители предлагаме възможността да създават ресурси в сиви IP мрежи. Да предположим, че има двама различни собственици на облаци, които скриват своите услуги зад балансировачи. Всеки от тях има ресурси в подсет 10.0.0.1/24, като адресите са идентични. Необходимо е да можем да ги различаваме и тук е важно да разберем структурата на виртуалната мрежа на Яндекс.Облака. Подробности можете да получите в , но в момента е важно да знаем, че мрежата е многослойна и съдържа тунели, които могат да се различават по id на подсет.
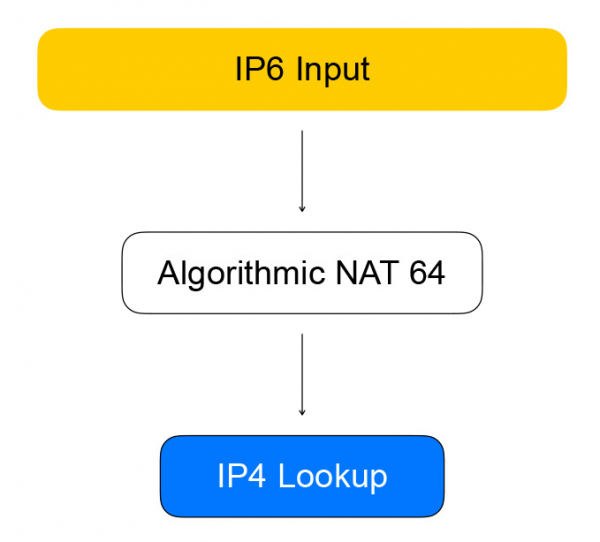
Нодовете за проверка на състоянието се обръщат към балансировачите с помощта на т.нар. квази-IPv6 адреси. Квазиадресът е IPv6 адрес, в който е вграден IPv4 адрес и id на подсет на потребителя. Трафикът попада на балансировача, той извлича от него IPv4 адреса на ресурса, заменя IPv6 с IPv4 и изпраща пакета в мрежата на потребителя.
Обратният трафик върви по същия начин: балансировачът вижда, че предназначението е сива мрежа от здравни проверки и преобразува IPv4 в IPv6.
VPP е сърцето на data plane
Балансировачът е реализиран с технологията Vector Packet Processing (VPP) — фреймворк от Cisco за пакетна обработка на мрежов трафик. В нашия случай фреймворкът работи върху библиотека за управление на мрежови устройства в потребителското пространство — Data Plane Development Kit (DPDK). Това осигурява висока производителност при обработката на пакети: в ядрото се извършват значително по-малко прекъсвания, няма превключвания на контекста между kernel space и user space.
VPP отива още по-далеч и извлича повече производителност от системата, благодарение на обединяването на пакетите в батчове. Повишаването на производителността става чрез агресивното използване на кешовете на съвременните процесори. Използват се както кешове за данни (пакетите се обработват "с вектори", с данни, които са близо една до друга), така и кешове за инструкции: в VPP обработката на пакетите следва граф, в възлите на който се намират функции, изпълняващи една задача.
Например, обработката на IP пакети в VPP преминава в следния ред: първо в възела за парсинг се извършва парсинг на заглавията на пакетите, а след това те се изпращат в възел, който препраща пакетите нататък съобразно таблиците за маршрутизиране.
Малко хардкор. Авторите на VPP не правят компромиси в използването на кешовете на процесора, затова типичният код за обработка на пакетите съдържа ръчна векторизация: има цикъл на обработка, в който се обработва ситуацията "имаме четири пакета в опашката", след това - същото за два, после - за един. Често се използват prefetch инструкции, които зареждат данни в кешовете за ускоряване на достъпа до тях в следващите итерации.
n_left_from = frame->n_vectors;
while (n_left_from > 0)
{
    vlib_get_next_frame (vm, node, next_index, to_next, n_left_to_next);
    // ...
    while (n_left_from >= 4 && n_left_to_next >= 2)
    {
        // обработка на множество пакети едновременно
        u32 next0 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        u32 next1 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        // ...
        /* Предварително извличане за следващата итерация. */
        {
            vlib_buffer_t *p2, *p3;

            p2 = vlib_get_buffer (vm, from[2]);
            p3 = vlib_get_buffer (vm, from[3]);

            vlib_prefetch_buffer_header (p2, LOAD);
            vlib_prefetch_buffer_header (p3, LOAD);

            CLIB_PREFETCH (p2->data, CLIB_CACHE_LINE_BYTES, STORE);
            CLIB_PREFETCH (p3->data, CLIB_CACHE_LINE_BYTES, STORE);
        }
        // в действителност обработваме данните
        /* проверка на спекулативни опашки, може би смяна на текущата следваща рамка */
        vlib_validate_buffer_enqueue_x2 (vm, node, next_index,
                to_next, n_left_to_next,
                bi0, bi1, next0, next1);
    }

    while (n_left_from > 0 && n_left_to_next > 0)
    {
        // обработка на пакети по един
    }

    // обработен батч
    vlib_put_next_frame (vm, node, next_index, n_left_to_next);
}
И така, Healthchecks се свързват по IPv6 към VPP, което ги превръща в IPv4. Това се извършва от възела на графа, който наричаме алгоритмичен NAT. За обратния трафик (и преобразуването от IPv6 в IPv4) съществува същият възел на алгоритмичен NAT.
Прямият трафик от клиентите на балансьора преминава през възлите на графа, които извършват самата балансировка.
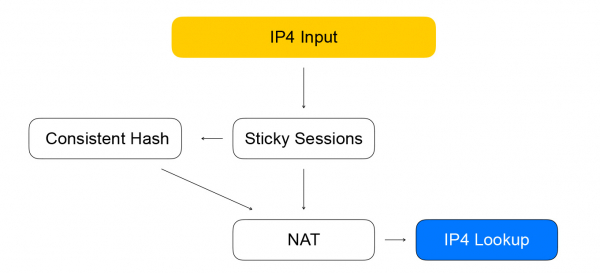
Първият възел — sticky sessions. В него се съхранява хеш от за инсталираните сесии. 5-tuple включва адреса и порта на клиента, от който се предава информация, адреса и портовете на ресурсите, достъпни за получаване на трафик, както и мрежовия протокол.
Хешът на 5-tuple ни помага да извършваме по-малко изчисления в последващия възел на консистентното хеширане, както и по-добре да обработваме промените в списъка на ресурсите зад балансировчика. Когато на балансировчика постъпи пакет, за който няма сесия, той се изпраща в възела на консистентното хеширане. Тук се извършва балансировка с помощта на консистентно хеширане: избираме ресурс от списъка на наличните „живи“ ресурси. След това пакетите се изпращат в узел NAT, който извършва фактическата замяна на адреса на дестинацията и преизчислява контролните суми. Както виждате, следваме правилата на VPP — подобното към подобно, групираме сходни изчисления за увеличаване на ефективността на кешовете на процесора.
Консистентно хеширане
Защо избрахме точно него и какво всъщност е то? Първо, нека разгледаме предишната задача — избора на ресурс от списъка.
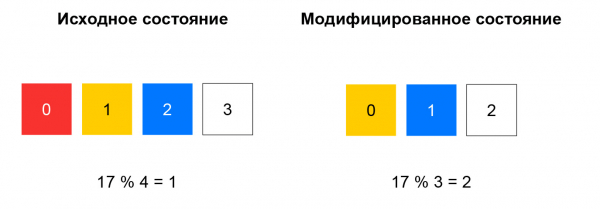
При неконсистентното хеширане се изчислява хешът на входящия пакет, а ресурсът се избира от списъка по остатъка от делението на този хеш на броя на ресурсите. Докато списъкът остава непроменен, такава схема работи добре: винаги изпращаме пакети с един и същ 5-tuple на един и същ инстанс. Ако, например, някой ресурс спре да отговаря на healthchecks, то за значителна част от хешовете изборът ще се промени. А при клиента TCP-съединенията ще се прекъснат: пакет, който по-рано попадаше на инстанс А, може да започне да попада на инстанс Б, който не познава сесията за този пакет.
Консистентното хеширане решава описаната проблема. Най-лесно е да се обясни тази концепция така: представете си, че имате пръстен, на който разпределяте ресурсите по хеш (например, по IP:port). Изборът на ресурс е завъртане на колелото под ъгъл, определен от хеш от пакета.
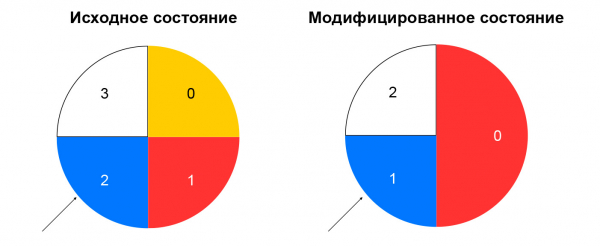
По този начин се минимизира преразпределението на трафика при промяна на състава на ресурсите. Премахването на ресурс ще засегне само тази част от пръстена на консистентното хеширане, на която се е намирал конкретния ресурс. Добавянето на ресурс също променя разпределението, но ние имаме възел за sticky sessions, който позволява да не се превключват вече установените сесии на нови ресурси.
Разгледахме какво става с директния трафик между балансировщика и ресурсите. Сега нека да се запознаем с обратния трафик. Той следва същата схема, като трафика за проверки — чрез алгоритмичен NAT, тоест чрез обратен NAT 44 за клиентския трафик и NAT 46 за трафика на healthchecks. Ние се придържаме към своята схема: унифицираме трафика на healthchecks и реалния трафик на потребителите.
Loadbalancer-node и компоненти в комплект
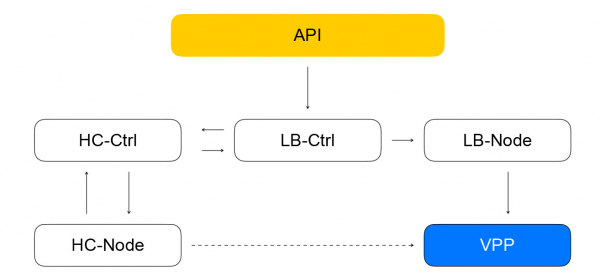
За състава на балансировките и ресурсите в VPP информира локалната услуга — loadbalancer-node. Той се абонира за потока събития от loadbalancer-controller, знае как да изготви разликата между текущото и целевото състояние, получено от контролера. Получаваме затворена система: събития от API постъпват към контролера на балансировача, който поставя на healthcheck контролера задачи за проверка на "живостта" на ресурсите. Той, от своя страна, поставя задачи на healthcheck-node и агрегира резултатите, след което ги връща обратно на контролера на балансировките. Loadbalancer-node се абонира за събития от контролера и променя състоянието на VPP. В такава система всяка услуга знае само необходимото за съседните услуги. Броят на връзките е ограничен и имаме възможност независимо да експлоатираме и мащабираме различни сегменти.
Какви въпроси успявахме да избегнем
Всички наши услуги в control plane са написани на Go и имат добри характеристики за мащабируемост и надеждност. В Go има много опенсорсни библиотеки за строене на разпределени системи. Активно ползваме GRPC, всички компоненти съдържат опенсорсна реализация на service discovery — нашите услуги наблюдават работоспособността си една друга, могат динамично да променят състава си и ние свързахме това с GRPC-балансировката. За метриките също използваме опенсорсно решение. В data plane постигнахме достойна производителност и голям запас от ресурси: оказа се много трудно да съберем стенд, на който да можем да достигнем производителността на VPP, а не на хардуерната мрежова карта.
Проблеми и решения
Какво не сработи добре? В Go управлението на паметта е автоматично, но все пак могат да възникнат течове на паметта. Най-простият начин да се справите с тях е да стартирате горутини и да не забравяте да ги приключвате. Извод: следете за консумацията на паметта на Go програмите. Често добър индикатор е броят на горутините. В тази история има и плюс: в Go лесно можете да получите данни за runtime – за консумацията на памет, за броя на стартираните горутини и по много други параметри.
Освен това, Go може би не е най-добрият избор за функционални тестове. Те са сравнително многословни, а стандартният подход „да се стартират всички в CI наведнъж“ не е особено подходящ за тях. Функционалните тестове изискват повече ресурси и реално възникват таймаути. Поради това тестовете могат да завършат неуспешно, тъй като процесорът е зает с юнит тестове. Извод: по възможност изпълнявайте „тежките“ тестове отделно от юнит тестовете.
Микросервисната събитийна архитектура е по-сложна от монолита: не е удобно да преглеждате логове на десетки различни машини. Извод: ако правите микросервиси, веднага помислете за трасировка.
Нашите планове
Ще стартираме вътрешен балансировач, IPv6 балансировач, ще добавим поддръжка на сценарии Kubernetes, ще продължим да разпределяме нашите услуги (в момента разпределени са само healthcheck-node и healthcheck-ctrl), ще добавим нови healthchecks и ще реализираме интелигентна агрегация на проверки. Обмисляме възможността да направим нашите услуги дори по-независими – за да комуникират не директно помежду си, а чрез опашка от съобщения. В Облака наскоро се появи SQS-съвместима услуга. .
Наскоро се състоя публичен релиз на Yandex Load Balancer. Изучавайте к услугата, управлявайте балансировачите по удобен за вас начин и увеличете отказоустойчивостта на вашите проекти!
Източник: habr.com
