

Тази статия ще ви помогне да разберете как работи натоварването в Kubernetes, какво се случва при мащабиране на дълготрайни връзки и защо трябва да обмислите балансирането на страната на клиента, ако използвате HTTP/2, gRPC, RSockets, AMQP или други дълготрайни протоколи.
Няколко думи за това как се переразпределя трафикът в Kubernetes
Kubernetes предлага две удобни абстракции за разгръщане на приложения: услуги (Services) и разгръщания (Deployments).
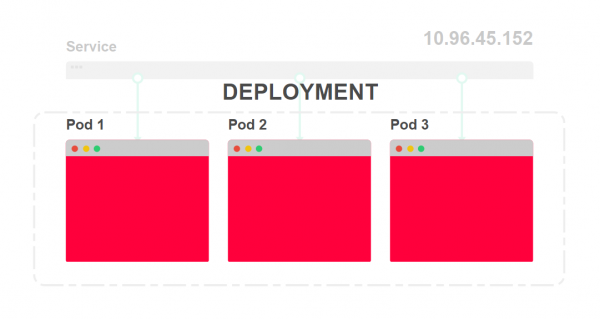
Разгръщанията описват как и колко копия от вашето приложение трябва да бъдат активни по всяко време. Всяко приложение се разгръща като под (Pod) с присвоен IP адрес.
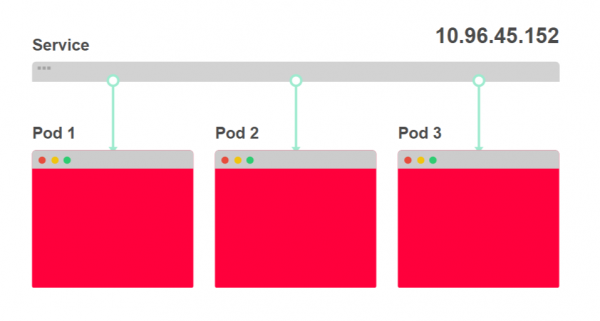
Услугите по функция наподобяват балансировач на натоварване. Те са предназначени за разпределяне на трафика по множество подове.
Нека видим как изглежда това.
- На диаграмата по-долу виждате три инстанции на едно приложение и балансировач на натоварване:

- Балансировачът на натоварване се нарича услуга (Service) и има присвоен IP адрес. Всеки входящ заявка се препраща към един от подовете:

- Сценарият на разгръщането определя броя инстанции на приложението. Почти никога няма да се налага да разгръщате директно под:

- На всеки под се присвоява собствен IP адрес:

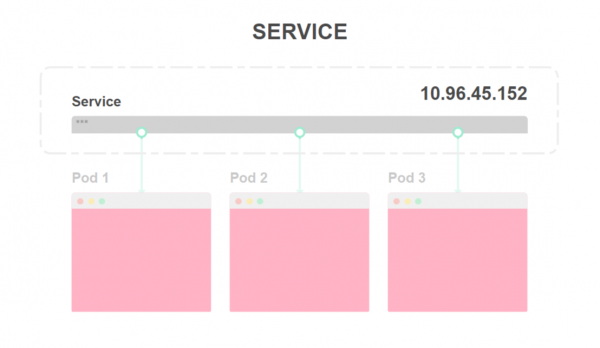
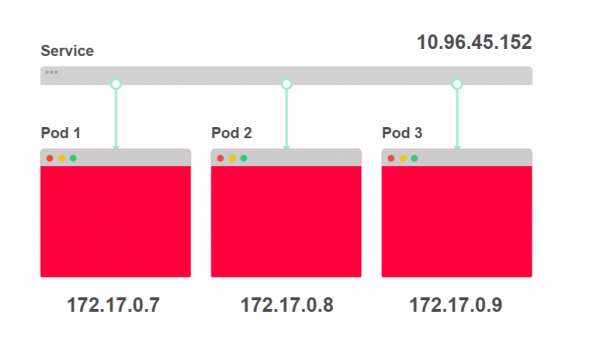
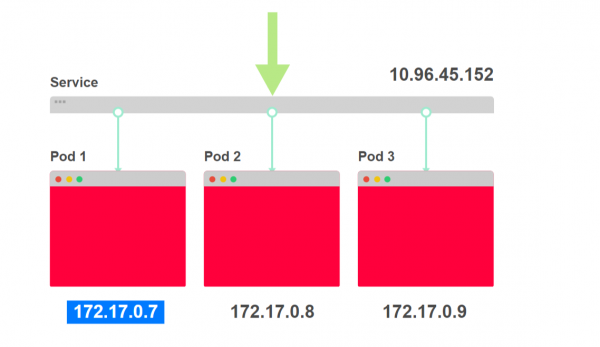
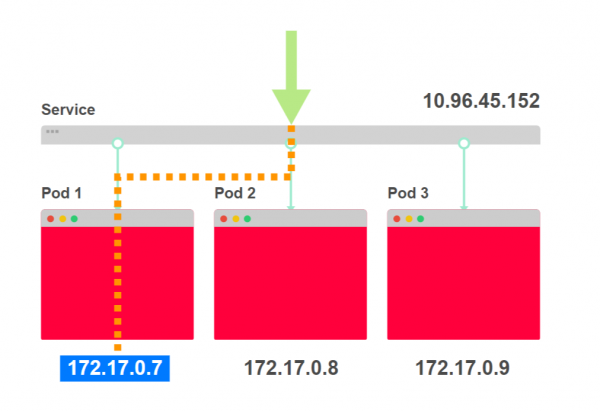
Полезно е да разглеждате услугите като набор от IP адреси. Всеки път, когато се обърнете към услуга, един от IP адресите се избира от списъка и се използва като адрес на дестинация.
Това изглежда по следния начин.
- Идва заявка curl 10.96.45.152 към услугата:

- Услугата избира един от трите адреса на подовете като дестинация:

- Трафикът се препраща към конкретен под:


Ако вашето приложение се състои от фронтенд и бекенд, ще имате и услуга, и разгръщане за всяко от тях.
Когато фронтендът прави заявка към бекенда, той не е задължен да знае колко точно пода обслужва бекендът: те могат да бъдат един, десет или сто.
Също така, фронтендът не знае адресите на подовете, обслужващи бекенда.
Когато фронтендът прави заявка към бекенда, той използва IP адреса на услугата на бекенда, който остава непроменен.
Ето как изглежда това.
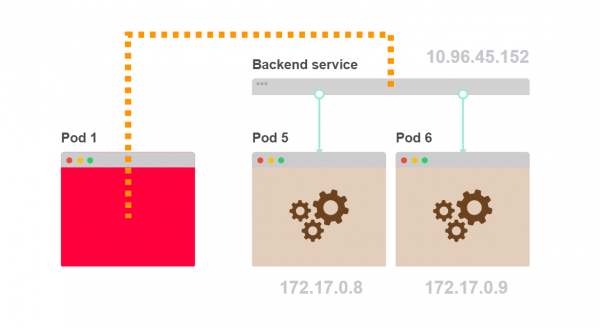
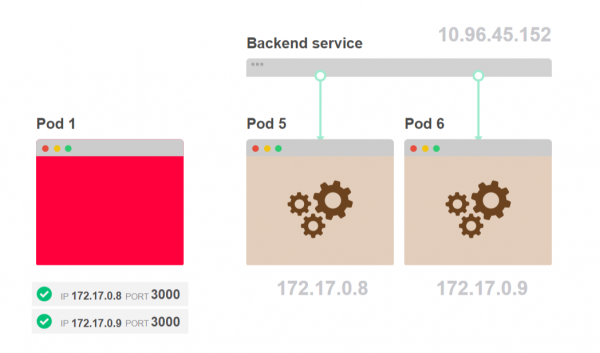
- Под 1 пита вътрешен компонент на бекенда. Вместо да избира конкретен под на бекенда, той прави заявка към услугата:

- Сервизът избира един от подовете на бекенда като целеви адрес:

- Трафикът преминава от под 1 към под 5, избран от сервиза:

- Под 1 не знае колко точно такива подове, като под 5, са скрити зад сервиза:

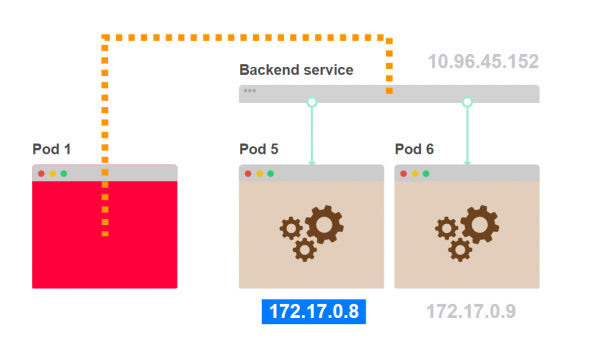
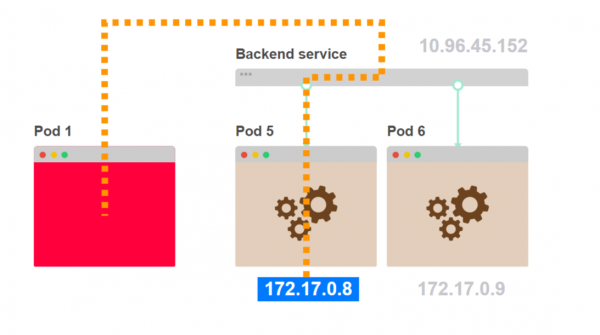
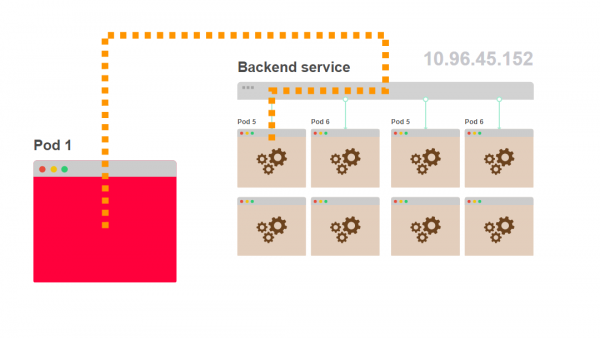
Но как точно сервизът разпределя заявките? Изглежда, използва балансировка по метода round-robin? Нека да разберем.
Балансировка в сервизите на Kubernetes
Сервизите в Kubernetes не съществуват. За сервиза няма процес, на който е назначен IP адрес и порт.
Можете да се уверите в това, като влезете в нода на кластера и изпълните командата netstat -ntlp.
Вие дори няма да можете да намерите IP адреса, назначен на сервиза.
IP адресът на сервиза е разположен в управленския слой, в контролера, и е записан в базата данни — etcd. Този адрес се използва и от друг компонент — kube-proxy.
Kube-proxy получава списък с IP адреси за всички сервизи и формира набор правила iptables на всяка нода в кластера.
Тези правила указват: «Ако видим IP адреса на сервиза, трябва да модифицираме целевия адрес на заявката и да я изпратим към един от подовете».
IP адресът на сервиза се използва само като входна точка и не се обслужва от никакъв процес, който слуша на този IP адрес и порт.
Нека да разгледаме това.
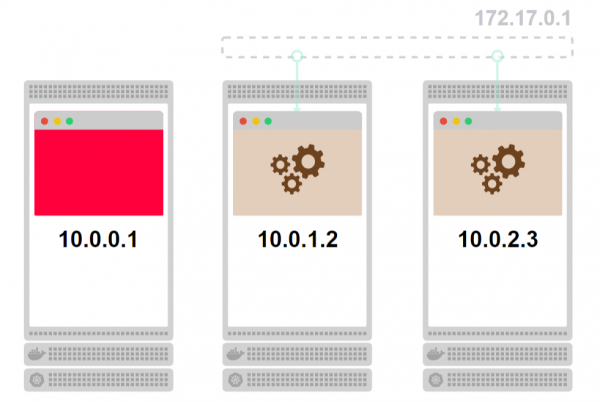
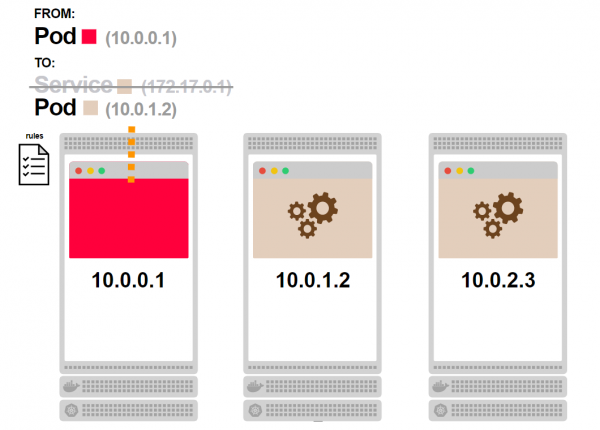
- Нека разгледаме кластер от три ноди. На всяка нода има подове:

- Свързаните подове, оцветени в бежово, са част от сервиза. Тъй като сервизът не съществува като процес, той е изобразен в сив цвят:

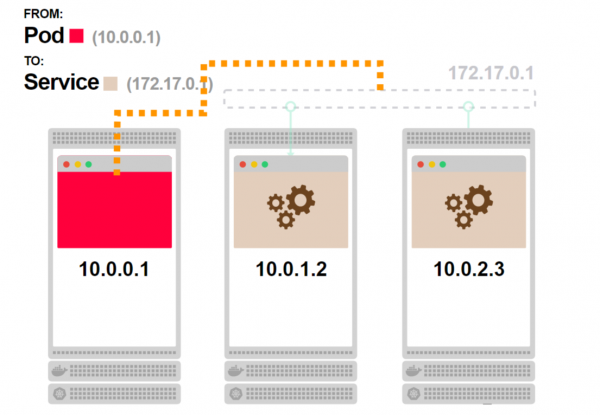
- Първият под отправя заявка към сервиза и трябва да попадне на един от свързаните подове:

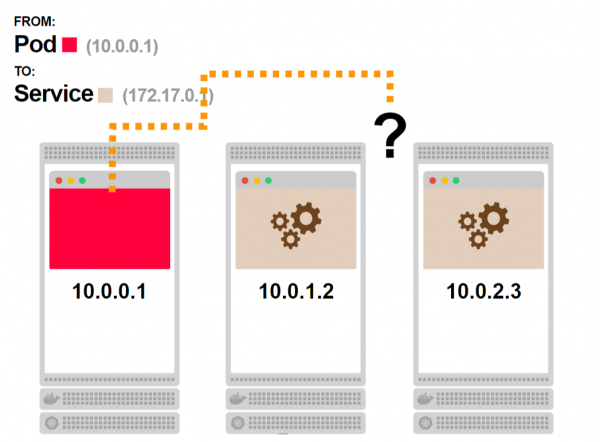
- Но сервизът не съществува, процесът липсва. Как работи това?

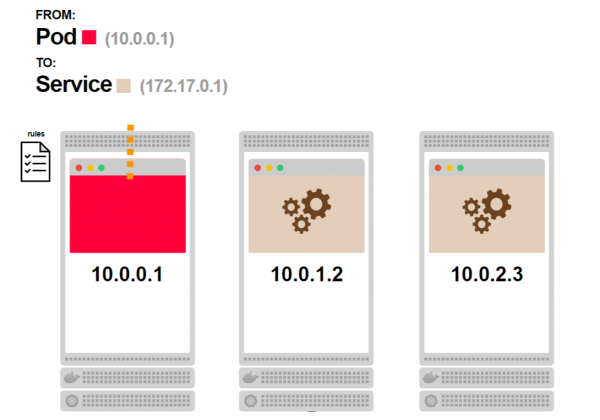
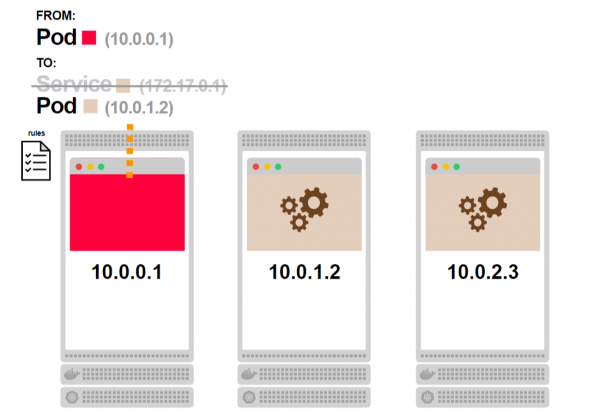
- Преди да напусне нодата, заявката преминава през правилата на iptables:

- Правилата на iptables знаят, че сервизът не съществува и заменят неговия IP адрес с един от IP адресите на подовете, свързани с този сервиз:

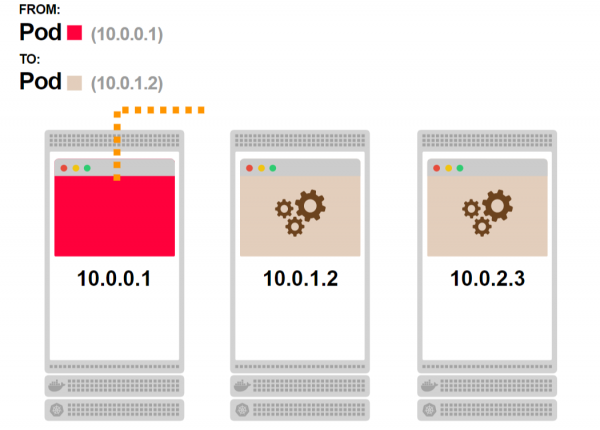
- Заявката получава валиден IP адрес като целеви адрес и се обработва нормално:
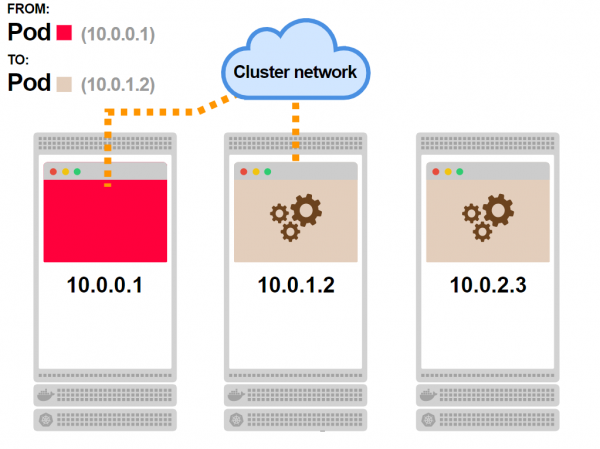
- В зависимост от мрежовата топология, заявката в крайна сметка достига до пода:

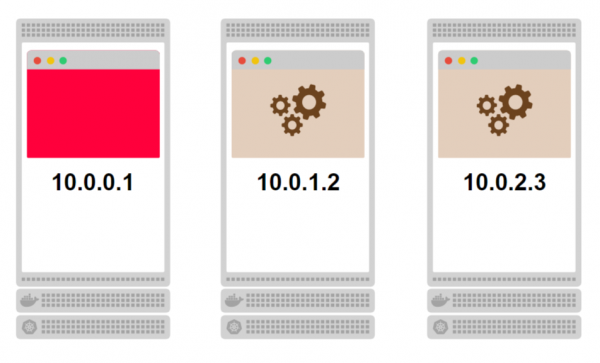
Могат ли iptables да балансират натоварването?
Не, iptables се използват за филтриране и не са проектирани за балансировка.
Въпреки това, съществува възможност да се напише набор от правила, които работят като .
И точно това е реализирано в Kubernetes.
Ако имате три пода, kube-proxy ще напише следните правила:
- Изберете първия под с вероятност 33%, в противен случай преминете към следващото правило.
- Изберете втория под с вероятност 50%, иначе преминете към следвящото правило.
- Изберете третия под.
Тази система води до това, че всеки под се избира с вероятност 33%.
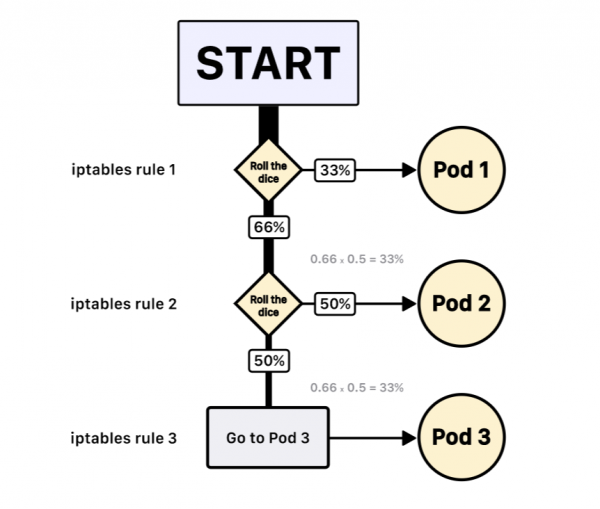
И няма никаква гаранция, че под 2 ще бъде избран след под 1.
Забележка: iptables използва статистически модул със случайно разпределение. Така алгоритъмът за натоварване е базиран на случайно избиране.
Сега, когато разбирате как работят услугите, нека да разгледаме по-интересни сценарии на работа.
Дългосрочните връзки в Kubernetes не се мащабират по подразбиране.
Всеки HTTP-заявка от фронтенда към бекенда се обслужва от отделна TCP-връзка, която се отваря и затваря.
Ако фронтендът изпрати 100 заявки в секунда към бекенда, ще се отворят и затворят 100 различни TCP-връзки.
Може да се намали времето за обработка на заявките и да се намали натоварването, ако се отвори една TCP-връзка и тя се използва за всички последващи HTTP-заявки.
В HTTP-протокола е заложена възможност, наречена HTTP keep-alive, или повторно използване на връзката. В този случай една TCP-връзка се използва за изпращане и получаване на множество HTTP-заявки и отговори:
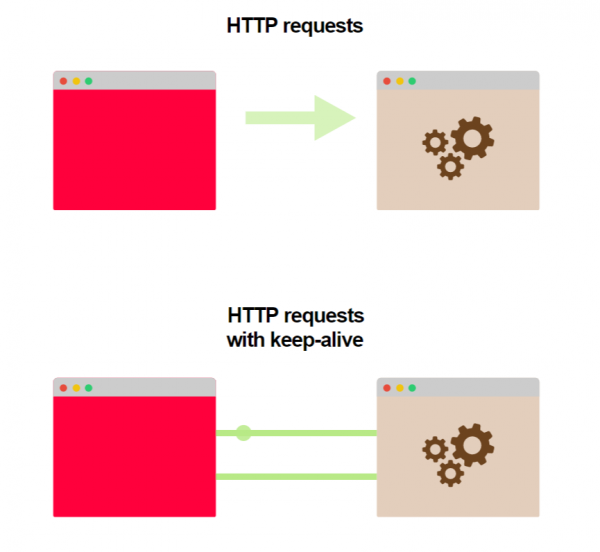
Тази възможност не е активирана по подразбиране: и сървърът, и клиентът трябва да бъдат конфигурирани съответно.
Самата настройка е проста и достъпна за повечето програмни езици и среди.
Ето няколко връзки към примери на различни езици:
Какво ще се случи, ако използваме keep-alive в услугата Kubernetes?
Нека да предположим, че и фронтендът, и бекендът поддържат keep-alive.
Имаме едно копие на фронтенда и три инстанции на бекенда. Фронтендът прави първоначалната заявка и отваря TCP-връзка към бекенда. Заявката достига услугата, един от подовете на бекенда се избира като целеви адрес. Подът на бекенда изпраща отговор и фронтендът го получава.
В разлика от обикновената ситуация, когато след получаване на отговор TCP-връзката се затваря, сега тя остава отворена за следващите HTTP-заявки.
Какво ще се случи, ако фронтендът изпрати още заявки на бекенда?
За пренасочване на тези заявки ще бъде използвана отворената TCP-връзка, всички заявки ще попаднат на същия под на бекенда, на който е попаднала първата заявка.
Налице ли не трябва iptables да пренасочи трафика?
Не в този случай.
Когато се създаде TCP връзка, тя преминава през правилата на iptables, които избират конкретния под бекенда, където ще попадне трафикът.
Тъй като всички следващи заявки преминават през вече открита TCP връзка, правилата на iptables вече не се извикват.
Нека видим как изглежда това.
- Първият под изпраща заявка към услугата:

- Вие вече знаете какво ще последва. Услугата не съществува, но има правила на iptables, които ще обработят заявката:
- Един от подовете на бекенда ще бъде избран като адрес на дестинация:

- Заявката достига до пода. В този момент постоянната TCP връзка между двете подове ще бъде установена:

- Всяка следваща заявка от първия под ще преминава през вече установената връзка:

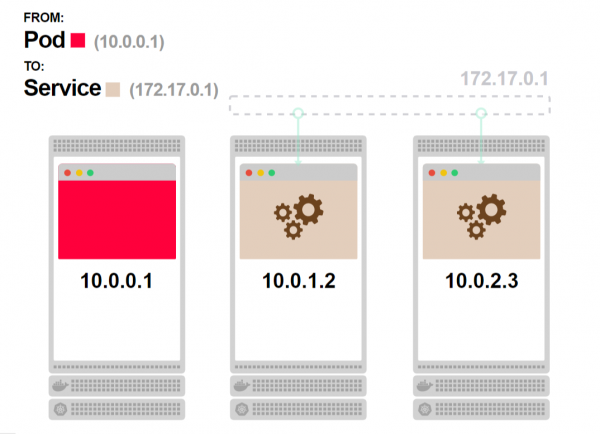
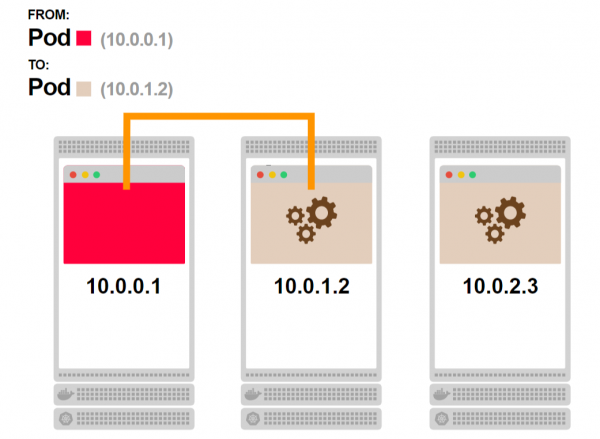
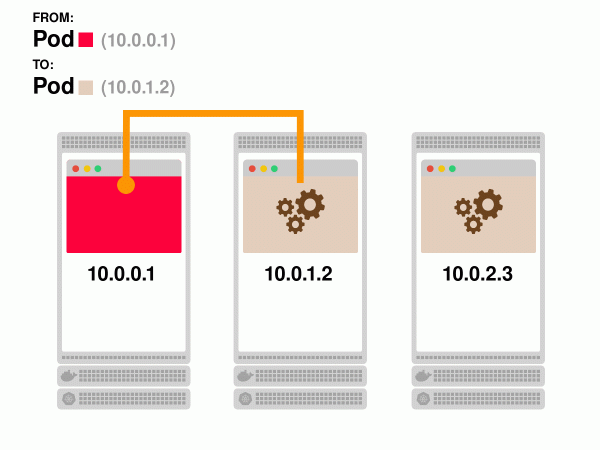
В резултат на това получавате по-бърз отговор и по-висока пропускна способност, но губите възможността за мащабиране на бекенда.
Дори ако имате два пода в бекенда, при постоянна връзка трафикът постоянно ще попада на един от тях.
Може ли това да се поправи?
Тъй като Kubernetes не знае как да балансира постоянните връзки, тази задача лежи на вас.
Услугите са набор от IP адреси и портове, които се наричат крайни точки.
Вашето приложение може да получи списък с крайни точки от услугата и да реши как да разпределя заявките между тях. Можете да установите постоянна връзка с всеки под и да балансирате заявките между тези връзки с помощта на round-robin.
Или да приложите по- .
Кодът на клиентската страна, който отговаря за балансирането, трябва да следва следната логика:
- Получете списъка с крайни точки от услугата.
- За всяка крайна точка установете постоянна връзка.
- Когато е необходимо да направите заявка, използвайте едно от отворените връзки.
- Редовно актуализирайте списъка с крайни точки, създавайте нови или затваряйте стари постоянни връзки при промяна на списъка.
Така ще изглежда.
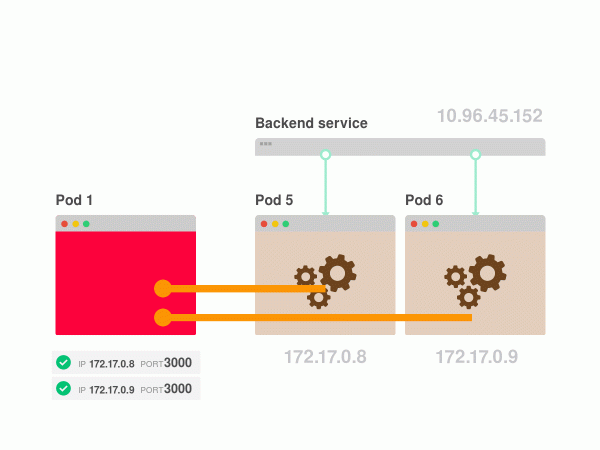
- Вместо първият под да изпратя заявка към услугата, можете да балансирате заявките на клиентската страна:

- Трябва да напишете код, който пита кои подове са част от услугата:

- След като получите списъка, съхранявайте го на клиентската страна и го използвайте за свързване с подовете:

- Вие сами отговаряте за алгоритъма за разпределение на натоварването:
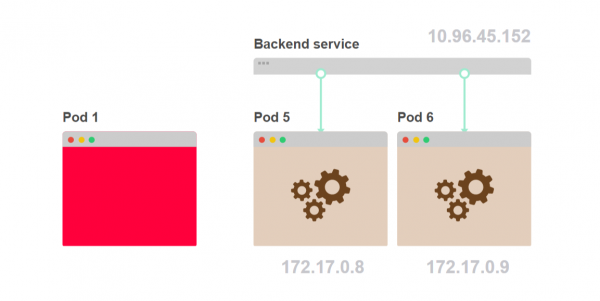
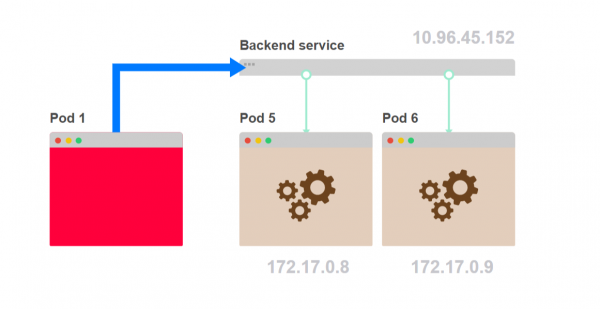
Сега възниква въпросът: Отнася ли се този проблем само за HTTP keep-alive?
Разпределение на натоварването от страна на клиента
HTTP не е единственият протокол, който може да използва постоянни TCP връзки.
Ако приложението ви използва база данни, TCP връзката не се отваря всеки път, когато трябва да изпълните заявка или да получите документ от БД.
Вместо това се отваря и използва постоянна TCP връзка към базата данни.
Ако вашата база данни е разположена в Kubernetes и достъпът се предоставя под формата на услуга, вие ще се сблъскате със същите проблеми, описани в предишната част.
Една реплика на базата данни ще бъде натоварена повече от останалите. Kube-proxy и Kubernetes няма да помогнат за разпределението на връзките. Вие трябва да се погрижите за балансирането на заявките към вашата база данни.
В зависимост от библиотеката, която използвате за свързване с БД, можете да имате различни варианти за решение на този проблем.
По-долу е даден пример за достъп до кластера на БД MySQL от Node.js:
var mysql = require('mysql');
var poolCluster = mysql.createPoolCluster();

var endpoints = /* retrieve endpoints from the Service */

for (var [index, endpoint] of endpoints) {
  poolCluster.add(`mysql-replica-${index}`, endpoint);
}

// Направете заявки към клъстерираната MySQL база данни
Съществува множество други протоколи, които използват постоянни TCP връзки:
- WebSockets и защитени WebSockets
- HTTP/2
- gRPC
- RSockets
- AMQP
Вие трябва да сте вече запознати с повечето от тези протоколи.
Но ако тези протоколи са толкова популярни, защо няма стандартизирано решение за разпределение на натоварването? Защо е необходимо изменение на логиката на клиента? Има ли нативно решение в Kubernetes?
Kube-proxy и iptables са създадени, за да адресират повечето от стандартните сценарии на използване при разгръщане в Kubernetes. Това е направено за ваше удобство.
Ако използвате уеб услуга, която предоставя REST API, имате късмет — в този случай постоянни TCP връзки не се използват, можете да използвате която и да е услуга в Kubernetes.
Но веднага щом започнете да използвате постоянни TCP връзки, ще трябва да разберете как да разпределите натоварването равномерно между бекендовете. Kubernetes не предлага готови решения за този случай.
Въпреки това, разбира се, съществуват варианти, които могат да помогнат.
Разпределение на дългоживеещи връзки в Kubernetes
В Kubernetes съществуват четири типа услуги:
- ClusterIP
- NodePort
- LoadBalancer
- Headless
Първите три услуги работят на базата на виртуален IP адрес, който се използва от kube-proxy за изграждане на правила в iptables. Но основата на всички услуги е headless услугата.
С headless услугата не е свързан никакъв IP адрес и тя просто предоставя механизъм за получаване на списък с IP адреси и портове, свързани с нея потове (крайни точки).
Всички услуги се базират на headless услугата.
Услугата ClusterIP е headless услуга с някои добавки:
- Управляващият слой й назначава IP адрес.
- Kube-proxy формулира необходимите правила в iptables.
По този начин можете да игнорирате kube-proxy и директно да използвате списъка с крайни точки, получен от headless услугата за балансиране на натоварването във вашето приложение.
Но как да добавите подобна логика към всички приложения, разгорени в клъстера?
Ако вашето приложение вече е разгръщено, то такава задача може да изглежда невъзможна. Въпреки това има алтернативен вариант.
Service Mesh ще ви помогне
Вероятно вече сте забелязали, че стратегията за балансиране на натоварването от страна на клиента е напълно стандартна.
Когато приложението стартира, то:
- Получава списък с IP адреси от услугата.
- Отваря и поддържа пул от съединения.
- Периодично актуализира пула, добавяйки или премахвайки крайни точки.
В момента, в който приложението иска да направи запитване, то:
- Избира налично съединение, използвайки някаква логика (например, round-robin).
- Изпълнява запитването.
Тези стъпки работят и за съединения WebSockets, и за gRPC, и за AMQP.
Можете да откроите тази логика в отделна библиотека и да я използвате в вашите приложения.
Вместо това обаче можете да използвате мрежи от услуги, например, Istio или Linkerd.
Service Mesh допълва вашето приложение с процес, който:
- Автоматично търси IP адреси на услуги.
- Проверява съединения, като WebSockets и gRPC.
- Балансра запитванията, използвайки правилния протокол.
Service Mesh помага за управление на трафика в клъстера, но е доста ресурсно интензивен. Други опции са използването на външни библиотеки, например Netflix Ribbon, или програмируеми проксита, например Envoy.
Какво ще се случи, ако игнорирате въпросите на балансирането?
Можете да не използвате балансировка на натоварването и все пак да не забележите никакви промени. Нека разгледаме няколко сценария на работа.
Ако имате повече клиенти, отколкото сървъри, това не е толкова голям проблем.
Да предположим, че има пет клиенти, които се свързват с два сървъра. Дори без балансировка, и двата сървъра ще се използват:
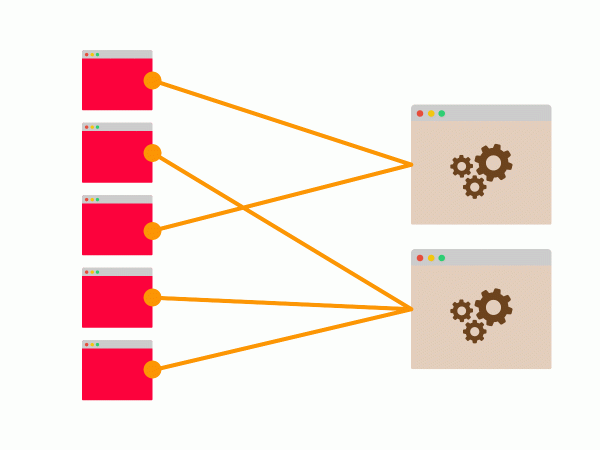
Свързванията могат да бъдат неравномерно разпределени: възможно е четирима клиенти да са се свързали към един и същи сървър, но има добър шанс, че и двата сървъра ще бъдат използвани.
По-проблематично е противоположният сценарий.
Ако имате по-малко клиенти и повече сървъри, ресурсите ви може да не се използват достатъчно и да се появи потенциално тясно място.
Да предположим, че има двама клиенти и пет сървъра. В най-добрия случай ще има две постоянни връзки към два от петте сървъра.
Останалите сървъри ще стоят празни:
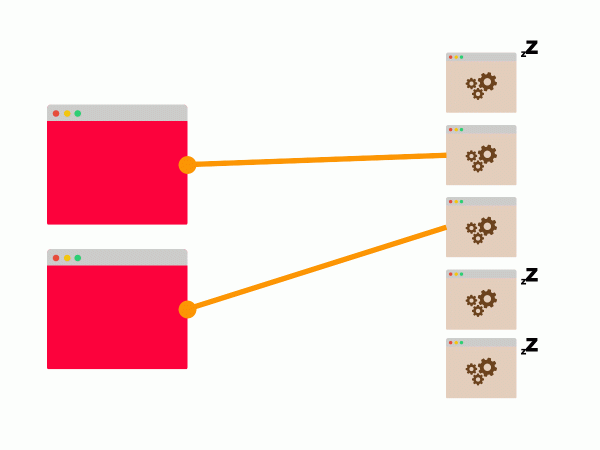
Ако тези два сървъра не могат да се справят с обработката на клиентските заявки, хоризонталното мащабиране няма да помогне.
Заключение
Услугите на Kubernetes са създадени да работят в повечето стандартни сценарии на уеб приложения.
Въпреки това, щом започнете да работите с приложни протоколи, които използват постоянни TCP връзки, като бази данни, gRPC или WebSockets, услугите вече не са подходящи. Kubernetes не предоставя вътрешни механизми за балансировка на постоянни TCP връзки.
Това означава, че трябва да пишете приложения с предвидена възможност за балансировка от страна на клиента.
Преводът е подготвен от екипа .
Какво още може да се прочете по темата:
- .
- .
- .
Източник: habr.com
