

Същността на разказа за най-популярния пакетен мениджър за Kubernetes може да се изрази с помощта на емоджи:
- кутия — това е Helm (това е най-подходящото, което имаме в последния релиз Emoji);
- катинар — безопасност;
- човечеца — решение на проблема.
Наистина, всичко ще бъде малко по-сложно, а разказът е пълен с технически подробности относно това, как да направим Helm безопасен.
- Кратко, какво е Helm, ако не сте знаели или сте забравили. Какви проблеми решава и къде се позиционира в екосистемата.
- Нека разгледаме архитектурата на Helm. Няма разговор за безопасността и как да направим инструмента или решението по-безопасно, който да не включва разбирането на архитектурата на компонентите.
- Нека обсъдим компонентите на Helm.
- Най-важният въпрос — бъдещето — новата версия Helm 3.
Всичко в тази статия се отнася до Helm 2. Тази версия в момента е в продакшън и вероятно точно нея използвате в момента, а именно в нея има заплахи за безопасността.
За лекторите: Александър Хайоров () се занимава с разработка от 10 години, помага за подобряване на съдържанието на и се присъедини към комитета на . В момента работи в Chainstack като ръководител на разработката — хибрид между ръководител на разработката и човек, отговарящ за доставката на крайни релизи. Тоест, той е на мястото на бойните действия, където всичко се случва от създаването на продукта до експлоатацията му.
Chainstack — малък, активно растящ стартъп, чиято задача е да предостави на клиентите възможността да забравят за инфраструктурата и сложностите при оперирането на децентрализирани приложения, екипът за разработка е в Сингапур. Не искайте от Chainstack да продава или купува криптовалута, но предложете да говорите за корпоративни блокчейн рамки, и те с радост ще отговорят.
Helm
Това е мениджър на пакети (чарти) за Kubernetes. Най-разбираемият и универсален начин да внасяте приложения в Kubernetes клъстера.
Става въпрос, разбира се, за по-структуриран и индустриален подход, отколкото изграждането на собствени YAML манифести и писането на малки утилити.
Helm — това е най-доброто, което в момента имаме от наличните и популярни.
Защо Helm? Първо, защото той се поддържа от CNCF. Cloud Native е голяма организация, която е майчината компания за проекти като Kubernetes, etcd, Fluentd и други.
Друга важна истина е, че Helm е много популярен проект. Когато през януари 2019 г. реших да разкажа за това как да направим Helm безопасен, проектът имаше хиляда звезди в GitHub. До май те станаха 12 хиляди.
Много хора се интересуват от Helm, така че, дори ако все още не го използвате, знанията относно неговата безопасност ще ви бъдат полезни. Безопасността е важна.
Основният екип на Helm е подкрепен от Microsoft Azure, поради което този проект е сравнително стабилен в сравнение с много други. Излизането на Helm 3 Alpha 2 в средата на юли показва, че по проекта работят много хора и те имат желание и сили да развиват и подобряват Helm.
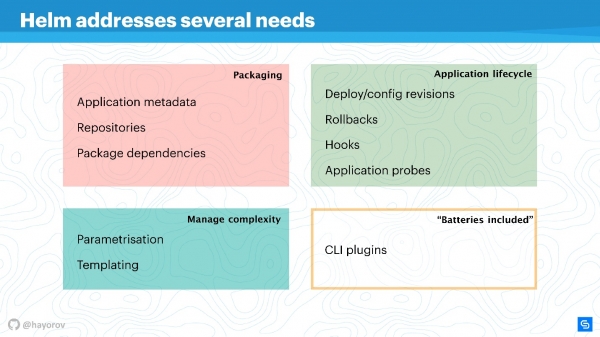
Helm решава няколко основни проблема в управлението на приложения в Kubernetes.
- Опаковане на приложението. Дори едно приложение от типа 'Hello, World' на WordPress вече представлява няколко услуги, които искате да опаковате заедно.
- Управление на сложността, която възниква с управлението на тези приложения.
- Жизненият цикъл, който не завършва след инсталацията или разгръщането на приложението. То продължава да живее, нужно е да бъде актуализирано, като Helm помага с това и се старае да донесе правилните мерки и политики за него.
Опаковане е устроено по ясен начин: има метаданни, напълно в съответствие с работата на обикновен пакетен мениджър за Linux, Windows или MacOS. Тоест хранилище, зависимости от различни пакети, метаинформация за приложения, настройки, особености на конфигурирането, индексиране на информация и т.н. Всичко това Helm позволява да получите и използвате за приложения.
Управление на сложността. Ако имате много еднотипни приложения, необходима е параметризация. Оттук извира необходимостта от шаблони, но за да не измисляте свой собствен начин за създаване на шаблони, можете да използвате това, което Helm предлага направо.
Управление на жизнения цикъл на приложението — това е, на мое мнение, най-интригуващият и нерешен въпрос. Това е причината, поради която в един момент се насочих към Helm. Трябваше да следим жизнения цикъл на приложението, и искахме да пренесем нашите CI/CD и приложения в тази парадигма.
Helm позволява:
- да управлявате разгръщанията, въвежда понятието конфигурация и ревизия;
- успешно да извършвате rollback;
- да използвате хукове на различни събития;
- да добавяте допълнителни проверки на приложенията и да реагирате на техните резултати.
Освен това Helm има 'батерии' — голямо количество вкусни неща, които можете да включите като плъгини, опростявайки живота си. Плъгините могат да се пишат сами, те са достатъчно изолирани и не изискват структурирана архитектура. Ако искате да реализирате нещо, препоръчвам да го направите под формата на плъгин, а после може би да го включите в upstream.
Helm се основава на три основни концепции:
- Chart Repo — описание и масив от параметри, които могат да бъдат приложени за вашия манифест.
- Конфигурация — т.е. стойности, които ще бъдат приложени (текст, числени стойности и т.н.).
- Release обединява два основни компонента, и заедно те се превръщат в Release. Релизите могат да бъдат версия, по този начин постигайки организиране на жизнения цикъл: малък при инсталация и голям при ъпгрейд, даунгрейд или възстановяване.
Архитектура на Helm
На схемата концептуално е отразена високоуровнева архитектура на Helm.
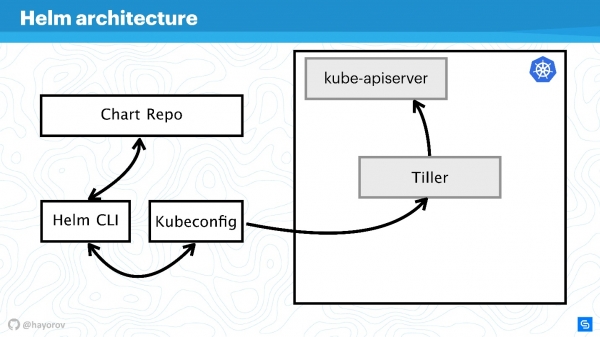
Напомням, че Helm е свързан с Kubernetes. Затова не можем без Kubernetes-клъстер (правоъгълник). Компонентът kube-apiserver се намира на мастера. Без Helm имаме Kubeconfig. Helm предоставя малък бинарен, ако може така да се нарече, инструмент Helm CLI, който може да се инсталира на компютър, лаптоп, мейнфрейм — на всичко.
Но това не е достатъчно. Helm има сървърен компонент Tiller. Той представлява интересите на Helm вътре в клъстера, това е също приложение в клъстера Kubernetes, както и всяко друго.
Следващият компонент Chart Repo — репозиторий с чартове. Има официален репозиторий, но може да има и частен репозиторий на компанията или проекта.
Взаимодействие
Нека разгледаме как взаимодействат компонентите на архитектурата, когато искаме да инсталираме приложение с помощта на Helm.
- Ние казваме
Helm install, обръщаме се към репозитория (Chart Repo) и получаваме Helm-чарт.
- Helm-инструментът (Helm CLI) взаимодейства с Kubeconfig, за да установи към кой клъстер да се обърне.
- Получавайки тази информация, инструментът се обръща към Tiller, който се намира в нашия клъстер, вече като приложение.
- Tiller се обръща към Kube-apiserver, за да извърши действия в Kubernetes, за да създаде някои обекти (услуги, подове, реплики, тайни и т.н.).
След това ще усложним схемата, за да видим вектора на атаките, на които може да бъде подложена цялата архитектура на Helm. А после ще се опитаме да я защитим.
Вектор на атаките
Първото потенциално слабо място — привилегированият API—потребителВ рамките на схемата това е хакер, получил администраторски достъп до Helm CLI.
Непривилегирован API-потребител също може да представлява опасност, ако се намира някъде наблизо. Такъв потребител ще има друг контекст, например, той може да бъде фиксиран в едно namespace на кластера в настройките на Kubeconfig.
Най-интригуващият вектор на атака може да бъде процесът, който се намира вътре в кластера някъде близо до Tiller и може да му осигури достъп. Това може да бъде уеб сървър или микроуслуга, която вижда мрежовата среда на кластера.
Екзотичен, но набиращ популярност, вариант на атака е свързан с Chart Repo. Чарт, създаден от недобросъвестен автор, може да съдържа небезопасен ресурс, и вие ще го изпълните, приемайки го за чисто. Или той може да подмени чарта, който изтегляте от официалния репозиторий, и например, да създаде ресурс под формата на политики и да ескалира достъпа си.
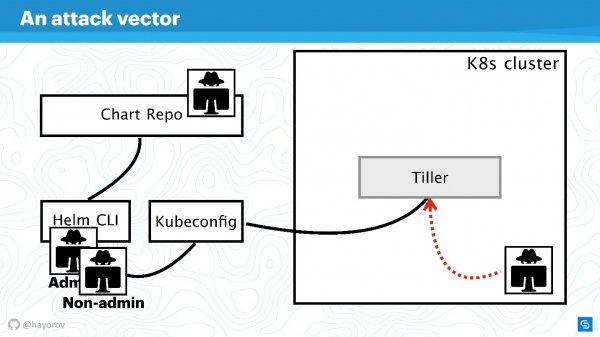
Нека опитаме да се защитим от атаките от тези четири страни и да разберем къде са проблемите в архитектурата на Helm и къде, възможно, няма.
Нека увеличим схемата, да добавим повече елементи, но да запазим всички основни съставки.
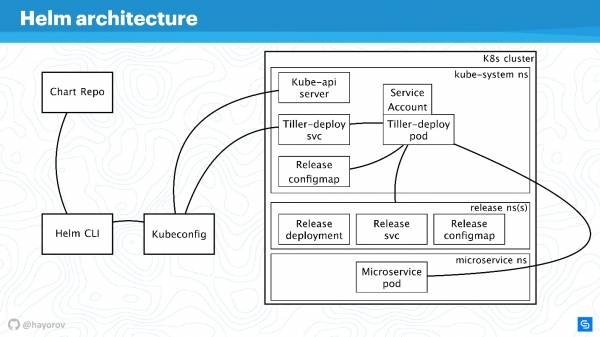
Helm CLI комуникира с Chart Repo, взаимодействува с Kubeconfig, работата се предава на кластера в компонента Tiller.
Tiller е представен от два обекта:
- Tiller-deploy svc, който осигурява определен сервис;
- Tiller-deploy pod (в схемата в единствен екземпляр в една реплика), на който работи цялото натоварване, който се свързва с кластера.
За взаимодействие се използват различни протоколи и схеми. От гледна точка на сигурността, най-интригуващите за нас са:
- Механизмът, с помощта на който Helm CLI се свързва с chart repo: какъв протокол, има ли автентикация и какво може да се направи с това.
- Протоколът, по който Helm CLI, използвайки kubectl, комуникира с Tiller. Това е RPC-сървър, инсталиран вътре в кластера.
- Самият Tiller е достъпен за микроуслуги, които се намират в кластера, и взаимодействат с Kube-apiserver.
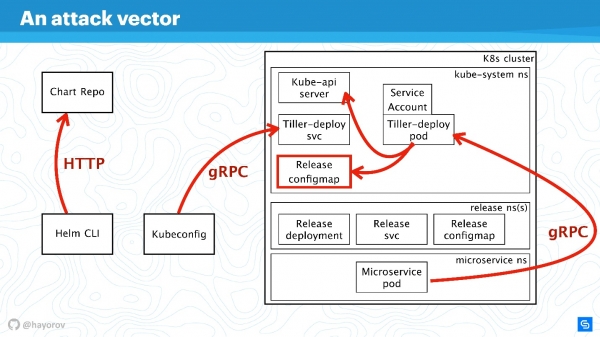
Нека обсъдим всички тези посоки по ред.
RBAC
Бесполезно е да се говори за каквато и да е сигурност на Helm или друга услуга вътре в кластера, ако RBAC не е активиран.
Изглежда, че това не е най-новата препоръка, но съм сигурен, че все още много хора не са активирали RBAC дори в продукция, защото това е голямо усилие и трябва много всичко да се настрои. Въпреки това, призовавам да направите това.
— адвокатският сайт за RBAC. Там е събрано огромно количество интересни материали, които ще помогнат за настройката на RBAC, ще покажат защо е полезен и как да се живее с него в продукция.
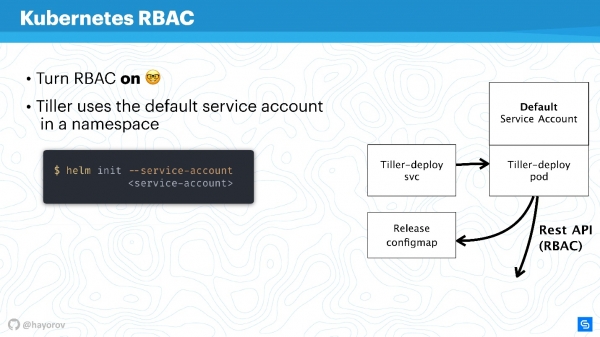
Ще опитам да обясня как работи Tiller и RBAC. Tiller работи вътре в кластера под определен сервизен акаунт. Обикновено, ако RBAC не е настроен, това ще бъде суперпотребител. В основната конфигурация Tiller ще бъде администратор. Именно затова често казват, че Tiller е SSH тунел към вашия кластер. В действителност е точно така, затова можете да използвате отделен специализиран сервизен акаунт вместо Default Service Account на схемата по-горе.
Когато инициализирате Helm, когато го инсталирате за първи път на сървъра, можете да зададете сервизен акаунт с помощта на --service-account. Това ще позволи да се използва потребител с минимално необходим набор от права. Въпреки това, ще трябва да създадете такава "верига": Role и RoleBinding.
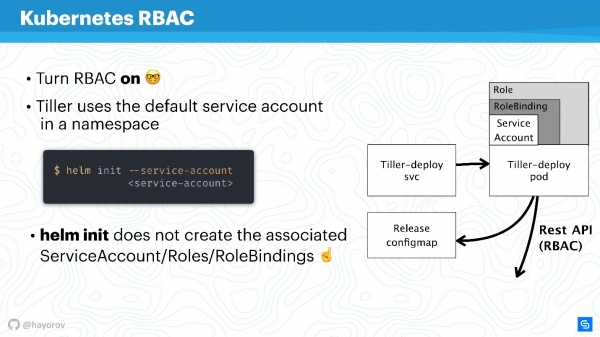
За съжаление, Helm няма да направи това вместо вас. Вие или вашият администратор на Kubernetes кластера трябва предварително да подготвите набор от Role и RoleBinding за сервизния акаунт, за да предадете на Helm.
Възниква въпросът — каква е разликата между Role и ClusterRole? Разликата е, че ClusterRole действа за всички namespaces, за разлика от обикновените Role и RoleBinding, които работят само за специализиран namespace. Можете да настроите политики както за целия кластер и всички namespaces, така и персонализирано за всеки namespace по отделно.
Струва си да се спомене, че RBAC позволява да се реши още един голям проблем. Много се оплакват, че Helm, за съжаление, не е multitenancy (не поддържа мултиарендност). Ако няколко екипа използват кластер и използват Helm, е невъзможно да се настроят политики и да се раздели достъпа в рамките на този кластер, тъй като има определен сервизен акаунт, под който работи Helm, и той създава всички ресурси в кластера от него, което понякога е много неудобно. Това е вярно — както самият бинарен файл, така и процесът, Helm Tiller не знае за multitenancy.
Но съществува прекрасен начин, който позволява да стартирате Tiller в кластера няколко пъти. С това няма никакви проблеми, Tiller може да бъде стартиран във всеки namespace. По този начин можете да използвате RBAC, Kubeconfig като контекст и да ограничите достъпа до специален Helm.
Това ще изглежда по следния начин.
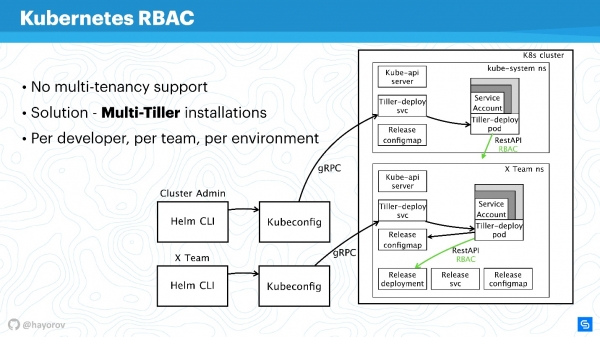
Например, имаме два Kubeconfig с контекст за различни екипи (два namespace): X Team за екипа на разработчиците и кластер на администратора. Администраторският кластер има собствен Tiller, който се намира в пространството Kube-system namespace, съответно с разширен service-account. И отделен namespace за екипа на разработчиците, те ще могат да деплоят своите услуги в специален namespace.
Това е работен подход, Tiller не е толкова ресурсоемък, че да оказва значително влияние върху вашия бюджет. Това е едно от бързите решения.
Не се колебайте да конфигурирате Tiller отделно и да предоставяте Kubeconfig с контекст за екипа, за конкретен разработчик или за среда: Dev, Staging, Production (малко вероятно е всичко да е на един кластер, обаче, е възможно да се направи така).
Продължавайки историята ни, ще преминем от RBAC и ще поговорим за ConfigMaps.
ConfigMaps
Helm използва ConfigMaps като хранилище за данни. Когато говорихме за архитектура, там нямаше база данни, в която да се съхранява информация за релизите, конфигурациите, rollbacks и т.н. За това се използват ConfigMaps.
Основният проблем с ConfigMaps е известен — те по принцип не са сигурни, в тях невъзможно е да се съхраняват sensitive-данни. Става въпрос за всичко, което не трябва да излиза извън услугата, например, пароли. Най-естественият начин за Helm в момента е да премине от използване на ConfigMaps към секрети.
Това става много лесно. Препокривате настройката на Tiller и посочвате, че хранилището ще бъдат секрети. Тогава при всяко деплойване ще получавате не ConfigMap, а секрет.
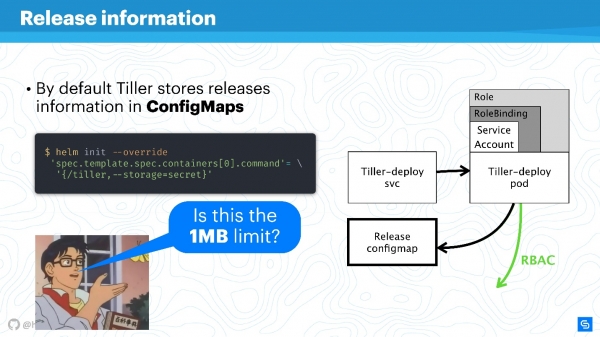
Можете да възразите, че самите секрети — странна концепция, и това не е много сигурно. Но трябва да разберете, че това е работа на самите разработчици на Kubernetes. От версия 1.10, т.е. доста отдавна, има възможност, поне в публични облаци, да се свърже подходящо хранилище за съхранение на секрети. В момента екипът работи за още по-добро разпределение на достъпа до секретите, на отделни подове или други същности.
По-добре е да се премине от Storage Helm на секрети, а тях от своя страна да се обезопасят централизирано.
Разбира се, остава лимит за съхранение на данни от 1 Мбайт. Helm използва etcd като разпределено хранилище за ConfigMaps. А там сметнаха, че това е подходящ чанк данни за репликации и т.н. По този повод има интересно обсъждане в Reddit, препоръчвам да го намерите за забавно четиво за уикенда или да прочетете резюме. .
Chart Repos
Чартовете са най-социално уязвими и могат да станат източник на 'Man in the middle', особено ако се използва стандартно решение. На първо място става въпрос за репозиториите, които са изложени по HTTP.
Определено е необходимо да се изложи Helm Repo по HTTPS — това е най-добрият вариант и е евтино.
Обърнете внимание на механизъм за подписи на чартове. Технологията е проста до безобразие. Това е същото, което използвате в GitHub, обикновена PGP машина с публични и частни ключове. Настройте и ще бъдете уверени, че с необходимите ключове подписвате всичко, което наистина е вашият чарт.
Освен това, Helm клиентът поддържа TLS (не в смисъл на HTTP от страна на сървъра, а взаимно TLS). Можете да използвате сървърни и клиентски ключове, за да комуникирате. Да бъда честен, не използвам такъв механизъм поради неохота към взаимни сертификати. В принципе, — основният инструмент за изложение на Helm Repo за Helm 2 — поддържа също и basic auth. Можете да използвате basic auth, ако това е по-удобно и спокойно.
Има също плагин , който позволява хостване на Chart Repos в Google Cloud Storage. Това е доста удобно, работи прекрасно и е достатъчно безопасно, тъй като се утилизира всичко описано механизми.
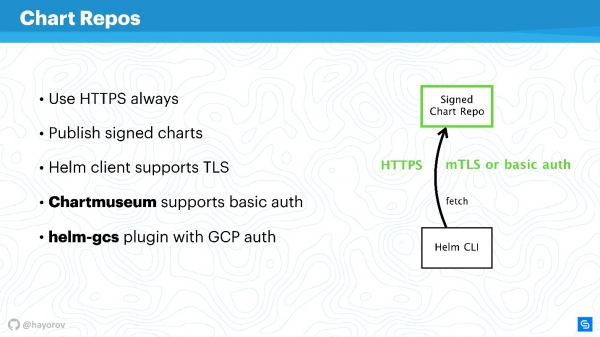
Ако включите HTTPS или TLS, използвате mTLS, добавите basic auth, за да намалите рисковете, ще получите безопасен канал за комуникация между Helm CLI и Chart Repo.
gRPC API
Следващата стъпка е много важна — да се осигури Tiller, който се намира в клъстера и от една страна е сървър, от друга страна — сам се свързва с други компоненти и се опитва да се представя за друг.
Както вече казах, Tiller е услуга, която предоставя gRPC, Helm клиентът идва при него по gRPC. По подразбиране, естествено, TLS е изключен. Защо е направено това — въпрос на дискусия, мисля, че за да се улесни настройката в началото.
За продукция и дори за staging препоръчвам да включите TLS на gRPC.
Според мен, за разлика от mTLS за чартовете, тук това е уместно и се прави много лесно — генерирате PQI инфраструктура, създавате сертификат, стартирате Tiller, предавате сертификата по време на инициализацията. След това можете да изпълнявате всички Helm команди, представяйки се с генерирания сертификат и частния ключ.
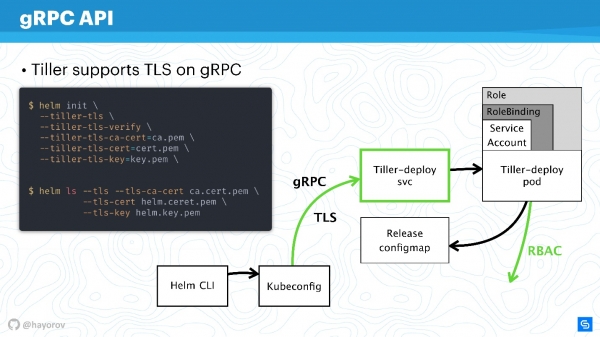
По този начин ще се защитите от всички заявки към Tiller извън клъстера.
И така, защитихме канала за свързване с Tiller, вече обсъдихме RBAC и настроихме правата на Kubernetes apiserver, намалихме домейна, с който може да взаимодейства.
Защитен Helm
Нека погледнем финалната схема. Това е същата архитектура с всички същите стрелки.
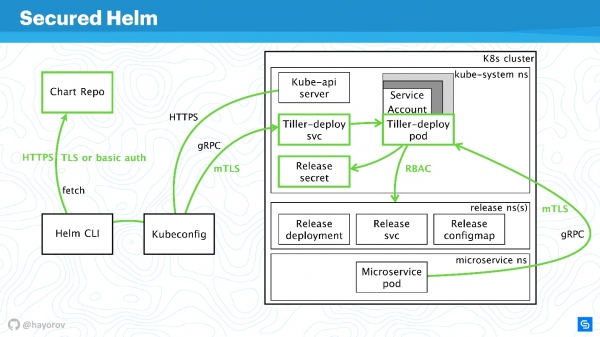
Всички връзки сега смело може да се рисуват в зелено:
- за Chart Repo използваме TLS или mTLS и базова автентикация;
- mTLS за Tiller, и той е представен като gRPC услуга с TLS, използваме сертификати;
- в кластерите се използва специален сервисен акаунт с Роля и RoleBinding.
Значително защитихме клъстера, но някой умен каза:
„Абсолютно безопасно решение може да бъде само едно — изключен компютър, който е в бетонна кутия и го охраняват войници“.
Има различни начини за манипулиране на данни и находене на нови вектори на атака. Въпреки това, съм уверен, че тези препоръки ще позволят реализирането на основен индустриален стандарт за сигурност.
Бонус
Тази част не се отнася директно до сигурността, но също така ще бъде полезна. Ще покажа някои интересни неща, за които малко хора знаят. Например, как да търсите чартове — официални и неофициални.
В репозитория в момента има около 300 чарта и два стрима: stable и incubator. Този, който дава приноси, знае колко трудно е да преминеш от incubator в stable и колко лесно е да излезеш от stable. Въпреки това, това не е най-добрият инструмент за търсене на чартове за Prometheus и всичко, което ви харесва, по една простичка причина — не е портал, където удобно да търсите пакети.
Но има услуга , с помощта на която намирането на чартове е много по-удобно. Най-важното, там има много повече външни репозитории и почти 800 чарта. Освен това, можете да свържете вашия репозитория, ако по някакви причини не искате да изпращате вашите чарта в stable.
Опитайте hub.helm.sh и нека заедно го развиваме. Тази услуга е под проекта Helm, и можете да давате принос дори в неговия UI, ако сте фронтенд разработчик и искате просто да подобрите външния вид.
Искам да привлеча вниманието ви към интеграцията на Open Service Broker API. Звучи сложно и неясно, но решава проблеми, с които всеки се сблъсква. Ще обясня с прост пример.
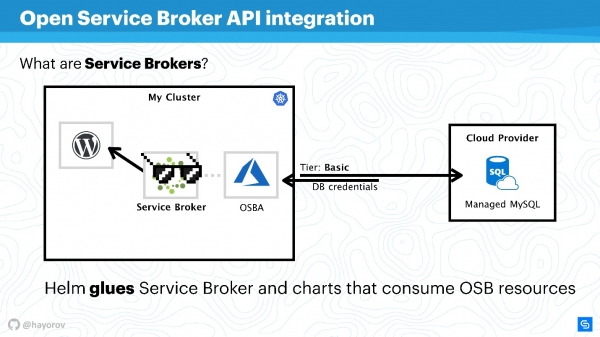
Имаме Kubernetes клъстер, в който искаме да стартираме класическо приложение — WordPress. Обикновено, за пълната функционалност е необходима база данни. Съществуват много решения, например, можем да стартираме собствен stateful сервис. Това не е много удобно, но много хора действат така.
Други, например ние в Chainstack, използват управляеми бази данни, като MySQL или PostgreSQL, за сървъри. Затова нашата база данни се намира в облака.
Но възниква проблем: необходимо е да свържем нашия сервис с базата данни, да създадем flavor на базата данни, да предадем данни за удостоверяване и да управляваме всичко това. Обикновено всичко това се извършва ръчно от системен администратор или разработчик. И няма проблем, когато приложенията са малко. Когато са много, е нужен комбайн. Този комбайн съществува — това е Service Broker. Той позволява използването на специален плъгин за клъстера на публично облако и поръчване на ресурси от доставчика чрез Broker, сякаш това е API. За това могат да се използват нативни средства на Kubernetes.
Това е много просто. Можете да поискате, например, Managed MySQL в Azure с основен tier (това може да бъде настроено). Чрез API на Azure базата данни ще бъде създадена и подготвена за употреба. Няма да ви е необходимо да се намесвате, за това отговаря плъгинът. Например, OSBA (плъгин за Azure) ще върне данни за удостоверяване на сервиза и ще ги предаде на Helm. Ще можете да използвате WordPress с облачно MySQL, без да се занимавате с управляеми бази данни и без да се притеснявате за stateful сервисите в клъстера.
Можем да кажем, че Helm е лепилото, което от една страна позволява разполагане на сървиси, а от друга — консумиране на ресурси от облачни доставчици.
Можете да напишете свой плъгин и да използвате цялата тази история on-premise. Тогава просто ще имате свой плъгин за корпоративен Cloud-доставчик. Препоръчвам да опитате този подход, особено ако имате голям мащаб и искате бързо да развиете dev, staging или цялата инфраструктура за функция. Това ще улесни живота на вашите operations или DevOps.
Още една находка, която вече споменах — това е плъгинът helm-gcs, който позволява използването на Google-бакети (обектно хранилище) за съхранение на Helm графики.
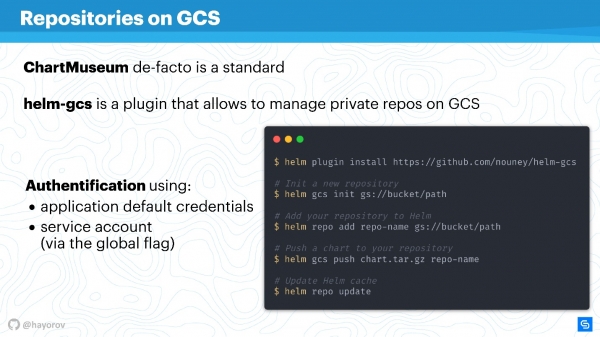
Нужни са само четири команди, за да започнете да го използвате:
- да инсталирате плъгина;
- да го инициирате;
- задать път към bucket, който се намира в gcp;
- да публикувате графики по стандартния начин.
Красотата е в това, че ще се използва нативният начин на gcp за авторизация. Можете да използвате сервизен акаунт, акаунт на разработчик — всичко, което пожелаете. Това е много удобно и не струва нищо в експлоатация. Ако, както мен, пропагандирате философията без операции, това ще бъде много удобно, особено за малки екипи.
Алтернативи
Helm не е единственото решение за управление на услуги. Има много въпроси около него, вероятно затова толкова бързо се появи трета версия. Разбира се, има и алтернативи.
Това могат да бъдат както специализирани решения, например Ksonnet или Metaparticle. Можете да използвате вашите класически средства за управление на инфраструктурата (Ansible, Terraform, Chef и т.н.) за същите цели, за които говорих.
Накрая, има решение , чиято популярност нараства.
Operator Framework е основната алтернатива на Helm, на която трябва да се обърне внимание.
Тя е по-нативна за CNCF и Kubernetes, но входният праг е значително по-висок, изисква повече програмиране и по-малко описание на манифестите.
Има различни добавки, като Draft, Scaffold. Те значително улесняват живота, например, на разработчиците, като спестяват време при изпращането и стартирането на Helm за деплой на тестова среда. Бих ги нарекъл разширители на възможности.
Ето една графика, която показва къде какво се намира.
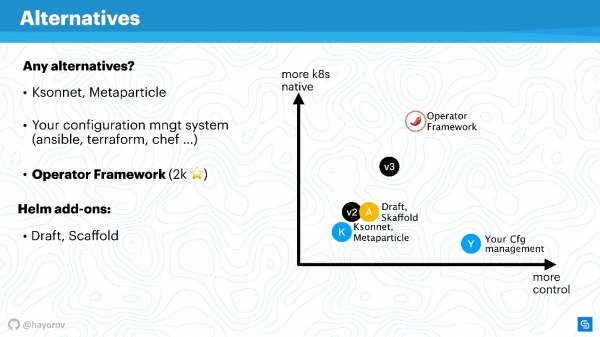
По абсцисната ос е нивото на вашия личен контрол над събитията, по ординатната ос — нивото на нативност на Kubernetes. Helm версия 2 се намира някъде по средата. В версия 3 няма колосални промени, но и контролът, и нивото на нативност са подобрени. Решенията от типа Ksonnet все пак отстъпват дори на Helm 2. Въпреки това, си заслужава да ги разгледате, за да знаят какво друго има в този свят. Разбира се, вашето управление на конфигурациите ще бъде под контрол, но абсолютно не е нативно за Kubernetes.
Operator Framework е напълно нативен за Kubernetes и позволява управление по много по-елегантен и старателен начин (но да помним за входния праг). По-скоро, това е подходящо за специализирано приложение и създаване на управление за него, отколкото за масов комбайн за опаковане на огромно количество приложения с помощта на Helm.
Разширителите просто малко подобряват контрола, допълват работния процес или улесняват CI/CD pipelines.
Бъдещето на Helm
Добрата новина е, че идва Helm 3. Вече излезе алфа-версията на Helm 3.0.0-alpha.2 и можете да я изпробвате. Тя е достатъчно стабилна, но функционалността е все още ограничена.
Защо е необходим Helm 3? На първо място, това е история за изчезването на Tiller, като компонент. Това, както вече разбирате, е огромна стъпка напред, защото от гледна точка на сигурността на архитектурата всичко се опростява.
Когато беше създаден Helm 2, а това беше по времето на Kubernetes 1.8 или дори по-рано, много концепции бяха незрели. Например, концепцията за CRD в момента активно се внедрява и Helm ще използва CRD, за да съхранява структури. Ще бъде възможно да се използва само клиент и да не се държи сървърна част. Съответно, ще можете да използвате нативните команди на Kubernetes за работа с структури и ресурси. Това е огромна стъпка напред.
Ще се появи поддръжка на нативни репозитории OCI (Open Container Initiative). Това е огромна инициатива и Helm е интересен в първоначален план, за да хоства своите чарти. Достига се до това, че например Docker Hub поддържа много от стандартите на OCI. Не искам да гадая, но е възможно класическите доставчици на Docker репозитории да започнат да предлагат възможност за хостване на вашите Helm чарти.
Спорна за мен история — това е поддръжката на Lua, като templating engine за писане на скриптове. Не съм голям фен на Lua, но това ще бъде напълно опционална възможност. Проверих го три пъти — използването на Lua няма да бъде задължително. Следователно, който желае, може да използва Lua, а който харесва Go — присъединете се към нашия огромен лагер и използвайте go-tmpl за това.
Най-накрая, това, което определено ми липсваше — това е появата на схеми и валидиране на типове данни. Няма да има повече проблеми с int или string, не е нужно да обграждате нула в двойни кавички. Ще се появи JSONS схема, която ще позволи явно да се опише за values.
Ще бъде много силно препроектирована event-driven model. Тя вече е концептуално описана. Погледнете в клон Helm 3 и ще видите колко много събития и хукове и др. са добавени, което значително ще опрости и, от една страна, ще добави контрол върху процесите на разгръщане и реакциите към тях.
Helm 3 ще бъде по-прост, по-сигурен и по-интересен не защото не обичаме Helm 2, а защото Kubernetes става все по-напреднал. Съответно, Helm може да използва натрупаните знания на Kubernetes и да създава отлични мениджъри за Kubernetes.
Другая добра новина е, че на Александър Хайоров ще разкаже, Напомняме, конференцията за интеграция на процесите на разработка, тестване и експлоатация ще се проведе в Москва на 30 септември и 1 октомври. До 20 август все още можете да и да разкажете за опита си в решаването на задачи на DevOps подхода.
Следете за новините относно чекпойнтите на конференцията в и .
Източник: habr.com
