

През есента на 2019 година в iOS екипа на Облака Mail.ru настъпи дългоочакваното събитие. Основната база данни за персистентно съхранение на състоянието на приложението стана доста екзотична за мобилния свят. (LMDB). Под заглавието ви предлагаме подробен обзор в четири части. Първо ще говорим за причините за толкова нетривиалния и труден избор. След това ще преминем към разглеждане на трите основни стълба на архитектурата на LMDB: паметно-картографирани файлове, B+-дърво и подхода copy-on-write за реализиране на транзакционност и многоверсионност. Накрая, за по sweet — практическа част. В нея ще разгледаме как на базата на нискоуровневия key-value API да проектираме и реализираме схема на база с няколко таблици, включително индексите.
Съдържание
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Мотивация за внедряване
Някъде през 2015 година ние се заехме с измерване на това колко често интерфейсът на нашето приложение забива. Започнахме с това не случайно. Получавахме чести оплаквания, че понякога приложението спира да реагира на действията на потребителя: бутоните не се натискат, списъците не се скролват и т.н. За механиката на измерванията аз на AvitoTech, затова тук давам само порядъка на числата.
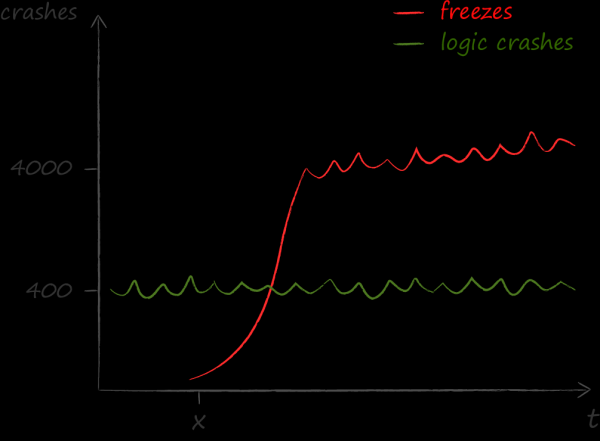
Резултатите от измерванията бяха за нас студен душ. Оказа се, че проблемите, предизвикани от забивания, са много повече отколкото каквито и да било други. Ако преди осъзнаването на този факт основният технически показател за качество беше безплъзгив (crash free), то след това фокусът върху беззамръзването (freeze free).
Построявайки и провеждайки и анализ на техните причини, стана ясен главният враг — тежката бизнес логика, която се изпълнява в главния поток на приложението. Естествената реакция на това безобразие беше жгучото желание да я разпределим по работните потоци. За системното решаване на тази задача прибегнахме до многопотокова архитектура, базирана на леки актьори. На нейното адаптиране за света на iOS посветих в колективния Twitter и . В рамките на текущото изложение искам да подчертая аспектите на решението, които повлияха на избора на база данни.
Акторният модел на организация на системата предполагава, че многопоточността става нейна втора същност. Обектите в модела обичат да преминават границите на потоките. И те го правят не от време на време и на отделни места, а практически постоянно и навсякъде.
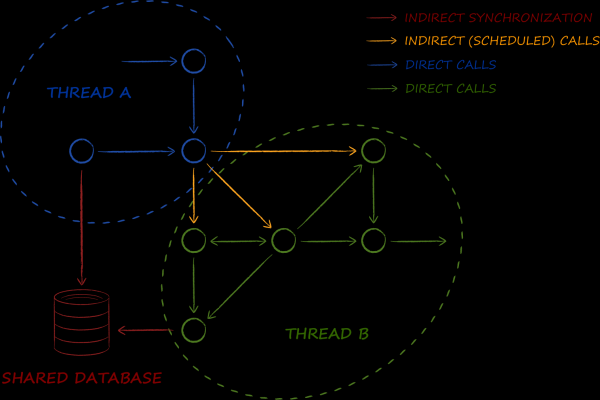
Базата данни е един от краеугълните елементи на представената схема. Основната ѝ задача е да реализира макропатерна. . Ако в корпоративния свят с нея се организира синхронизация на данни между услугите, то в случая на акторната архитектура — данните между потоките. Така че, ни е необходима такава база данни, работата с която в многопоточна среда не предизвиква дори минимални трудности. В частност, това означава, че получените от нея обекти трябва да бъдат най-малко потокобезопасни, а в идеалния случай и напълно немутируеми. Както е известно, последните могат да бъдат използвани едновременно от няколко потока, без да се прибягва до каквито и да било блокировки, което оказва благоприятно влияние върху производителността.
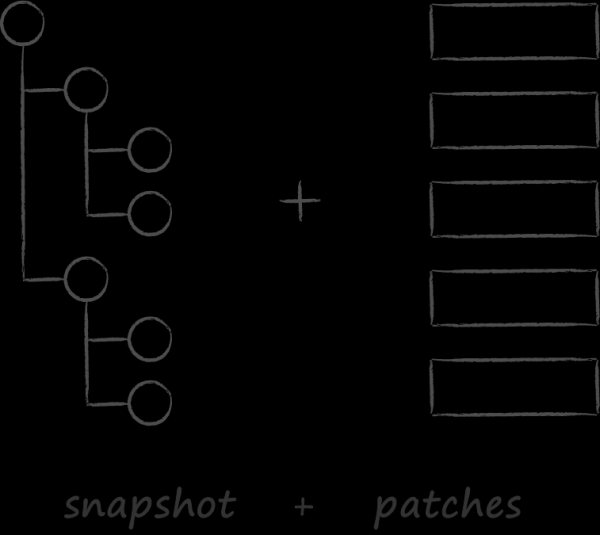 Вторият значим фактор, повлиял на избора на база данни, стана нашето облачно API. То беше вдъхновено от подхода към синхронизацията, приет в git. Както той, ние целяхме в , което за облачните клиенти изглежда повече от уместно. Предполагаше се, че те ще изтеглят веднъж цялото състояние на облака, а след това синхронизацията в преобладаващото мнозинство от случаите ще става чрез нанасяне на промени. За съжаление, тази възможност все още остава само в теоретичната сфера, а на практика клиентите не са се научили да работят с пачове. Има ред обективни причини за това, които, за да не удължавам въведението, ще оставим извън обсега. Сега обаче много по-голям интерес представляват поучителните резултати от урока за това, какво се случва, когато API-то каже „А“, а неговият потребител не каже „Б“.
Ако си представите git, който при изпълнение на командата pull вместо да прилага пачове към локалния.snapshot, сравнява състоянието му с пълното състояние на сървъра, ще имате доста точна представа как протича синхронизацията в облачните клиенти. Не е трудно да се досетите, че за да бъде извършена, е необходимо да се алокират в паметта две DOM-дерева с метаинформация за всички файлове на сървъра и локално. Получава се, че ако потребителят съхранява 500 000 файла в облака, за неговата синхронизация е необходимо да се възстановят и унищожат две дървета с 1 милион възли. А всеки възел е агрегат, съдържащ в себе си граф на подобекти. В този контекст резултатите от профилирането се оказаха очаквани. Установи се, че дори без да се взима предвид алгоритмиката на сливането, самата процедура за създаване и последващо разрушаване на огромно количество малки обекти излиза доста скъпо. Положението става по-лошо, тъй като основната операция на синхронизация е включена в множество потребителски сценарии. В резултат на това фиксираме втория важен критерий при избора на база данни — възможността за извършване на CRUD операции без динамично алокиране на обекти.
Другите изисквания са по-традиционни и техният списък изглежда следния.
- Потокобезопасност.
- Мултипроцесност. Продиктувана е от желанието да се използва един и същи инстанс на базата данни за синхронизация на състоянието не само между потоковете, но и между основното приложение и екстеншъните за iOS.
- Възможност за представяне на съ храними сущности като него мутабилни обекти.
- Отсъствие на динамични алокации в рамките на CRUD операции.
- Поддръжка на транзакционни основни свойства : атомарност, консистентност, изолираност и надеждност.
- Скорост на най-популярните случаи.
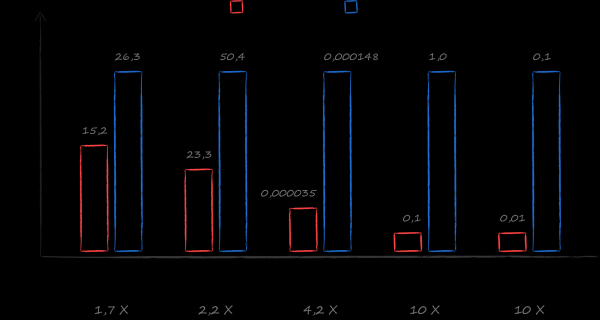
Добър избор с такъв набор от изисквания беше и остава SQLite. Обаче в рамките на проучването на алтернативи, попаднах на книгата . Под ней беше написан бенчмарк, сравняващ скоростта на работа с различни бази данни в рамките на реални облачни сценарии. Резултатът надмина най-смелите очаквания. В най-популярните случаи — получаване на курсора на сортирания списък на всички файлове и сортирания списък на всички файлове за зададена директория — LMDB се оказа 10 пъти по-бърз от SQLite. Изборът стана очевиден.
2. Позициониране на LMDB
LMDB е библиотека, много малка (едва 10К реда), реализираща най-долнопробния основен слой бази данни — хранилище.
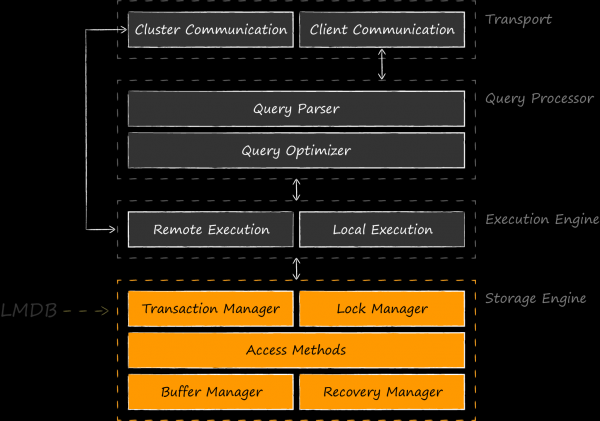
Представената схема показва, че е неправилно да се сравнява LMDB с SQLite, което реализира и по-високи нива, точно както е и неправилно да се сравнява SQLite с Core Data. По-справедливо би било да се посочат подобни движки-хранилища — BerkeleyDB, LevelDB, Sophia, RocksDB и др. Има дори разработки, където LMDB е компонент на хранилищния двигател за SQLite. Първият такъв експеримент беше проведен през 2012 година. авторът на LMDB . , които се оказаха толкова интригуващи, че начинанието му беше подхванато от ентусиасти на OSS и получи продължение в лицето на . През януари 2020 авторът на този проект Ден Шеърър го на LinuxConfAu.
Основното приложение на LMDB е като двигател за приложни бази данни. Библиотеката дължи появата си на разработчиците на , които бяха силно незадоволени от BerkeleyDB като основа на проекта си. Стъпвайки на скромната библиотека , Хауард Чу успя да създаде една от най-популярните днешни алтернативи. Тази история, а също и вътрешната структура на LMDB, той посвети на своя много интересен доклад . Отличен пример за овладяването на хранилището сподели Леонид Юриев (aka ) от Positive Technologies в своя доклад на Highload 2015 . В него той разказва за LMDB в контекста на подобна задача за реализиране на ReOpenLDAP, а сравнителната критика беше насочена към LevelDB. В резултат на внедряването в Positive Technologies се появи активно развиващ се форк с много интересни функции, оптимизации и .
LMDB често се използва и като хранилище as is. Например, браузърът Mozilla Firefox го за редица нужди, а, започвайки от версия 9, Xcode го пред SQLite за съхранение на индекси.
Двигателят се появи и в света на мобилната разработка. Следите от неговото използване могат в iOS клиента за Telegram. LinkedIn отиде още по-далеч и избра LMDB за хранилище по подразбиране за собствената си рамка за кеширане на данни Rocket Data, за което в своята статия през 2016 година.
LMDB успешно се бори за място под слънцето в нишата, оставена от BerkeleyDB след преминаването под контрола на Oracle. Библиотеката се цени за бързината и надеждността си дори в сравнение с подобните на нея. Както е известно, безплатни обяди няма и е важно да се подчертае trade-off, с който ще трябва да се сблъскате при избора между LMDB и SQLite. Схемата горе наистина демонстрира, за сметка на какво се постига увеличената скорост. Първо, не плащаме за допълнителни слоеве абстракция върху дисковото хранилище. Разбира се, в добрата архитектура не може да се мине без тях, и те неизбежно ще се появят в кода на приложението, но те ще бъдат много по-тънки. В тях няма да има функции, които не са необходими за конкретното приложение, например, поддръжка на SQL заявки. На второ място, предоставя се възможност да се оптимизира мапингът на приложените операции към заявките към дисковото хранилище. Ако SQLite изхожда от средностатистическите нужди на средностатистическото приложение, то вие като приложен разработчик отлично знаете основните сценарии на натоварване. За по-производителното решение ще трябва да платите с увеличена цена както за разработката на първоначалното решение, така и за последващата му поддръжка.
3. Трите стълба на LMDB
След като разгледахме LMDB от височина, е време да се спуснем по-дълбоко. Следващите три раздела ще бъдат посветени на разглеждането на основните стълбове, на които почива архитектурата на хранилището:
- Отображаеми в паметта файлове като механизъм за работа с диска и синхронизиране на вътрешните структури от данни.
- B+-дърво като организация на структурата на съхранените данни.
- Copy-on-write като подход за осигуряване на ACID свойства на транзакциите и многоверсионност.
3.1. Стълб №1. Файлове с картографирана памет
Отображените в паметта файлове са толкова важен архитектурен елемент, че дори фигурират в името на хранилището. Въпросите за кеширането и синхронизацията на достъпа до съхраняваната информация изцяло са отдадени на операционната система. LMDB не съдържа вътре в себе си каквито и да било кешове. Това е осъзнато решение на автора, тъй като четенето на данни директно от отображените файлове позволява да се премахнат много ъгли в реализирането на механизма. По-долу представям далеко не пълния списък на някои от тях.
- Поддържането на консистентността на данните в хранилището, когато се работи с него от няколко процеса, става задължение на операционната система. В следващия раздел тази механика е разгледана в подробности и с картинки.
- Отсъствието на кешове напълно освобождава LMDB от разходите, свързани с динамичните алокации. Четенето на данни в практиката представлява простото настройване на указател на правилния адрес в виртуалната памет и не повече. Звучи като фантастика, но в изходния код на хранилището всички повиквания на salloc са сосредоточени в функцията за конфигуриране на хранилището.
- Отсъствието на кешове означава и липса на блокировки, свързани с синхронизацията на техния достъп. Читателите, които могат да съществуват едновременно в произволен брой, не срещат нито един мютекс на пътя си към данните. Поради това скоростта на четене има идеална линейна мащабируемост спрямо количеството CPU. В LMDB синхронизацията се прилага само на модифициращите операции. Писателят може да бъде само един в даден момент.
- Минимум логика на кеширане и синхронизация освобождава кода от изключително сложните типове грешки, свързани с работата в многопоточна среда. На конференцията Usenix OSDI 2014 имаше две интересни изследвания на бази данни: и . От тях може да се извлече информация както за безпрецедентната надеждност на LMDB, така и за практически безупречното реализиране на ACID свойствата на транзакциите, надминаващо тези в SQLite.
- Минимализмът на LMDB позволява машинното представяне на нейния код напълно да се побере в L1 кеша на процесора с произтичащите от това скорости.
За съжаление, в iOS нещата с отображените в паметта файлове не са толкова ясни, колкото бихме искали. За да говорим по-съзнателно за свързаните с тях недостатъци, е необходимо да си припомним общите принципи за реализиране на този механизъм в операционните системи.
Общи сведения за файловете, отразени в паметта
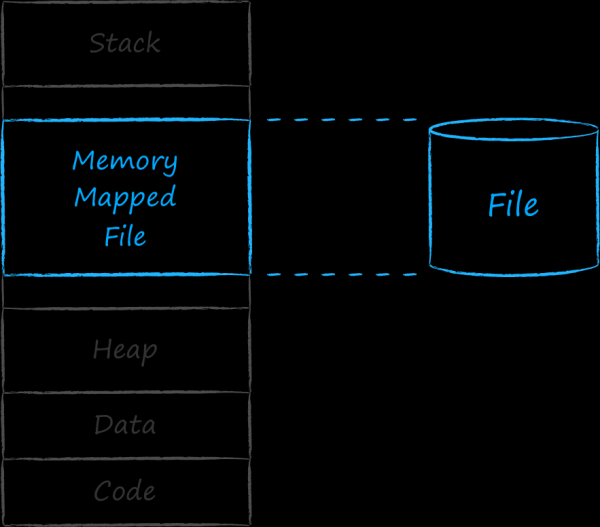 С всяко изпълняемо приложение операционната система асоциира субект, наречен процес. На всеки процес се отделя непрекъснат интервал от адреси, в който той разполага всичко необходимо за работа. В най-ниските адреси се намират секции с код и вградени данни и ресурси. Следва растящ нагоре блок от динамично адресно пространство, известен ни под името heap. В него се съдържат адреси на обекти, които се появяват по време на работа на програмата. В горната част се намира областта от паметта, използвана от стека на приложението. Той расте и се свива, с други думи, размерът му също има динамична природа. За да не се сблъскват стекът и heap-ът, те са разделени в различни краища на адресното пространство. Между двете динамични секции в горната и долната част има пролука. Адресите в този среден участък операционната система използва за асоцииране с процеса на най-различни субекти. По-специално, тя може да сопостави на определен непрекъснат набор от адреси - файл на диска. Този файл се нарича отображен в паметта.
Отделеното на процеса адресно пространство е огромно. Теоретичното количество адреси е ограничено само от размера на указателя, определян от битността на системата. Ако физическата памет беше напълно свързана 1-1 с него, то първият процес би погълнал цялата оперативна памет, и не би могло да става дума за многоезичност.
Въпреки това, от опита си знаем, че съвременните операционни системи могат да изпълняват едновременно безброй много процеси. Това е възможно, защото те само на хартия отделят на процесите купчина памет, а всъщност зареждат в основната физическа памет само онази част, която е необходима тук и сега. Следователно, асоциираната с процеса памет се нарича виртуална.
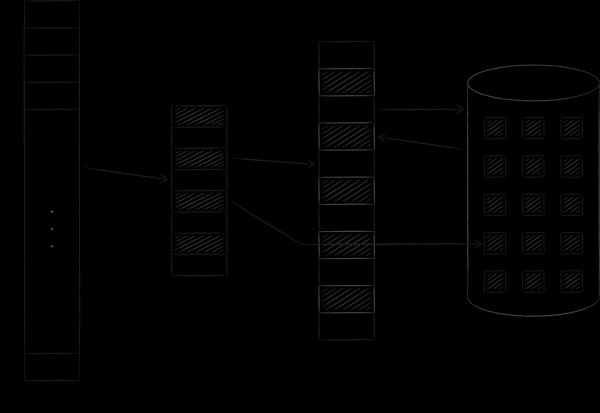
Операционната система организира виртуална и физическа памет под формата на страниците с определен размер. Веднъж щом някоя страница от виртуалната памет бъде поискана, операционната система я зарежда в физическата памет и създава съответствие между тях в специална таблица. Ако свободните слотове се изчерпят, една от преди заредените страници се копира на диска, а търсената заема нейното място. Тази процедура, към която ще се върнем по-късно, се нарича свопинг (swapping). Илюстрацията по-долу показва описания процес. На нея страница А с адрес 0 е заредена и разположена на страницата в основната памет с адрес 4. Този факт намира отражение в таблицата за съответствия в клетка номер 0.
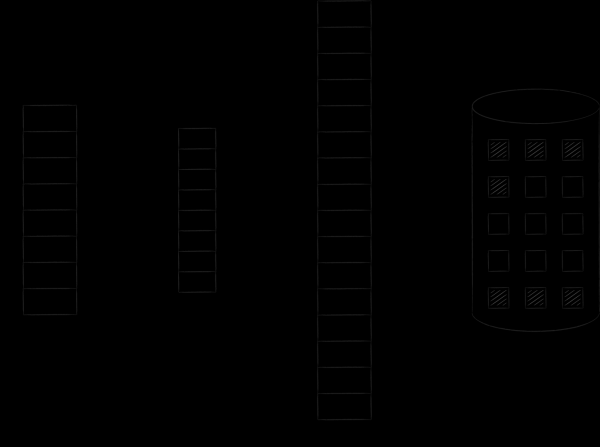
С отображените в паметта файлове историята е точно такава. Логически те безпроблемно и напълно се разполагат във виртуалното адресно пространство. Въпреки това, в физическата памет те попада постранично и само по искане. Модификацията на тези страници се синхронизира с файла на диска. По този начин е възможно да се извършва файлов вход/изход, просто работейки с байтове в паметта - всички промени ще бъдат автоматично прехвърлени от ядрото на операционната система към изходния файл.
Илюстрацията по-долу демонстрира как LMDB синхронизира своето състояние при работа с база данни от различни процеси. Когато картографираме виртуалната памет на различни процеси на един и същ файл, де факто ние задължаваме операционната система да синхронизира транситивно определени блокове от техните адресни пространства, към които LMDB се обръща.
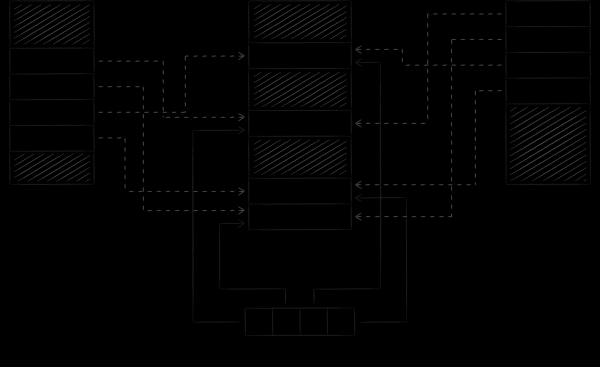
Важно уточнение е, че LMDB по подразбиране модифицира файла с данни чрез механизма на системния повик write, а самият файл е отразен в режим на само четене. Този подход има две важни последици.
Първото следствие - общо за всички операционни системи. Неговата същност е добавяне на защита срещу непреднамерено повреждане на базата данни от неправилен код. Както е известно, изпълняваните инструкции на процеса са свободни да достъпват данни от всяко място в неговото адресно пространство. В същото време, както току-що споменахме, отразяването на файла в режим read-write означава, че всяка инструкция може да го модифицира допълнително. Ако тя направи това по грешка, опитвайки се, например, наистина да презапише елемент от масив по невалиден индекс, така може случайно да промени файла, свързан с този адрес, което ще доведе до повреждане на базата данни. Ако обаче файлът е отразен в режим read-only, опитът да се промени съответното адресно пространство ще доведе до аварийно прекратяване на програмата със сигнал SIGSEGV, и файлът ще остане цял.
Второто следствие вече е специфично за iOS. Нито авторът, нито каквито и да било други източници го споменават явно, но без него LMDB би бил неизползваем в тази мобилна операционна система. Неговото разглеждане е посветено на следващия раздел.
Спецификата на отразените в паметта файлове в iOS
През 2018 година на WWDC имаше страхотна лекция . В нея се разглежда, че в iOS всички страници, разположени в физическата памет, принадлежат на един от 3 типа: dirty, compressed и clean.
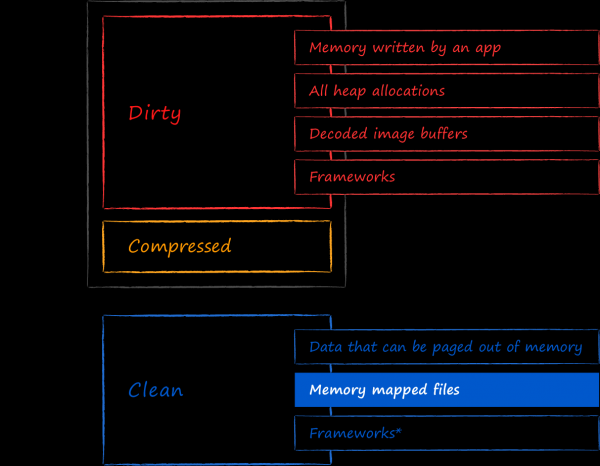
Чиста памет - това е съвкупността от страници, които могат безболезнено да бъдат извадени от физическата памет. Данните в тях могат при необходимост да бъдат заредени отново от техните първоначални източници. Разглежданите в режим read-only memory-mapped файлове попадат именно в тази категория. iOS не се притеснява да изтегля от паметта страниците, отразени на файла, тъй като те се синхронизират с файла на диска.
В dirty memory попадат всички модифицирани страници, независимо от това къде първоначално са разположени. В частност, така ще бъдат класифицирани и memory-mapped файловете, променени чрез запис в асоциираната с тях виртуална памет. Отваряйки LMDB с флага MDB_WRITEMAP, след направените промени в него ще можете да се уверите лично.
Когато приложението започне да заема твърде много физическа памет, iOS компресира dirty страниците му. Общата памет, заета от dirty и компресираните страници, представлява т.нар. memory footprint на приложението. Когато достигне определена праговая стойност, системният демон OOM killer се намесва и принудително го приключва. Това е особеност на iOS в сравнение с десктоп операционните системи. За разлика от тях, намаляването на memory footprint чрез свопинг на страници от физическа памет на диск не е предвидено в iOS. За причините можем само да гадаем. Възможно е процедурата по интензивно прехвърляне на страници на диска и обратно да е твърде енергийно натоварваща за мобилни устройства, или iOS да щади ресурса за презаписване на клетки на SSD устройства, или пък проектантите да не са били удовлетворени от общата производителност на системата, в която всичко постоянно се свопва. Както и да е, фактът остава факт.
Добрата новина, която вече споменахме, е, че LMDB по подразбиране не използва механизма mmap за обновяване на файлове. Из това следва, че показаните данни се класифицират от iOS като чиста памет и не допринасят за memory footprint. Можете да се уверите в това с помощта на инструмента Xcode, наречен VM Tracker. На скриншота по-долу е показано състоянието на виртуалната памет на приложението iOS Облака по време на работа. При стартиране в него бяха инициализирани 2 инстанса LMDB. Първият беше разрешен да отображава своя файл на 1GiB виртуална памет, а вторият — 512MiB. Въпреки че и двете хранилища заемат определен обем резидентна памет, нито едно от тях не допринася за dirty size.
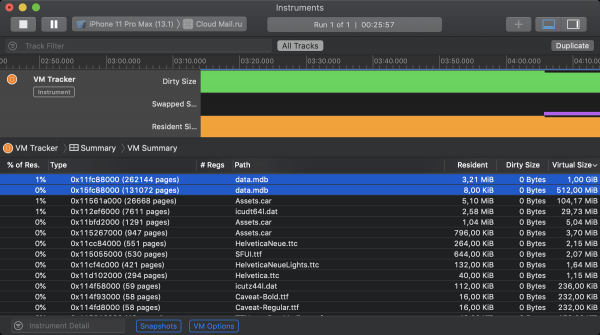
А сега е време за лошите новини. Благодарение на механизма за свопинг в 64-битните настолни операционни системи, всеки процес може да заеме толкова виртуално адресно пространство, колкото позволява свободното пространство на твърдия диск за неговия потенциален своп. Заместването на свопинга с компресия в iOS радикално намалява теоретичния максимум. Сега всички живи процеси трябва да се поберат в основната (оперативната) памет, а всички, които не могат да се поберат, подлежат на принудително приключване. Това се посочва както в споменатия по-горе , така и в . В резултат на това iOS строго ограничава размера на паметта, достъпна за заделяне чрез mmap. Ето Можете да видите емпиричните граници на обемите памет, които са успели да бъдат алокирани на различни устройства чрез тази системна функция. На най-съвременните модели смартфони iOS са предоставили 2 гигабайта, а на топ версиите на iPad - 4. На практика, разбира се, трябва да се ориентираме по най-ниските поддържани модели устройства, където ситуацията е много тъжна. Още по-лошо, при преглед на състоянието на паметта на приложението в VM Tracker, можете да откриете, че LMDB не е единственият, който претендира за памет на базата на картографиране. Значителни обеми от паметта заемат системните алокатори, файловете с ресурси, библиотеките за работа с изображения и други по-малки „хищници”.
След експериментите в Облака стигнахме до следните компромисни стойности за алокиране на паметта на LMDB: 384 мегабайта за 32-битови устройства и 768 за 64-битови. След изразходването на този обем всички операции за модификация започват да приключват с код MDB_MAP_FULL. Тези грешки наблюдаваме в нашия мониторинг, но са достатъчно малко, за да можем да ги пренебрегнем на текущия етап.
Неочевидна причина за прекомерната консумация на памет от хранилището може да бъдат дългоживеещи транзакции. За да разберем как са свързани тези две явления, ще ни помогне разглеждането на останалите два стълба на LMDB.
3.2. Стълб №2. B+-дърво
За да се емулират таблици върху хранилище с ключ-стойност, е необходимо в неговото API да присъстват следните операции:
- Вкарване на нов елемент.
- Търсене на елемент с зададен ключ.
- Изтриване на елемент.
- Итерация по интервалите от ключове в подредбата им.
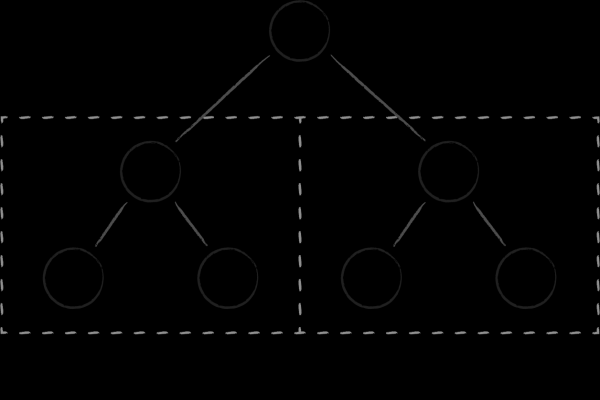 Най-простата структура от данни, с помощта на която лесно могат да бъдат реализирани всички четири операции, е двоичното дърво за търсене. Всеки негов възел представя ключ, разделящ всички подмножества от дъщерни ключове на две поддървета. В лявото се събират тези, които са по-малки от родителя, а в дясното - тези, които са по-големи. Получаването на подреден набор от ключове се постига чрез едно от класическите обходи на дървото.
Бинарните дървета имат два основни недостатъка, които не им позволяват да бъдат ефективни като дискови структури от данни. Първо, степента на тяхното балансиране е непредсказуема. Съществува значителен риск от получаване на дървета, при които височината на различните клонове може да се различава значително, което влошава алгоритмичната сложност на търсенето в сравнение с очакваното. Второ, изобилието от кръстосани връзки между възлите лишава бинарните дървета от локалност в паметта. Близките възли (от гледна точка на връзките помежду им) могат да се намират на съвсем различни страници във виртуалната памет. В резултат, дори за прост обход на няколко съседни възли в дървото може да се наложи да се посетят съпоставимо количество страници. Това е проблем дори когато говорим за ефективността на бинарните дървета като in-memory структури от данни, тъй като постоянната ротация на страниците в кеша на процесора е скъпо удоволствие. Когато става дума за често извличане на свързани със възлите страници от диска, ситуацията става още по-тревожна .
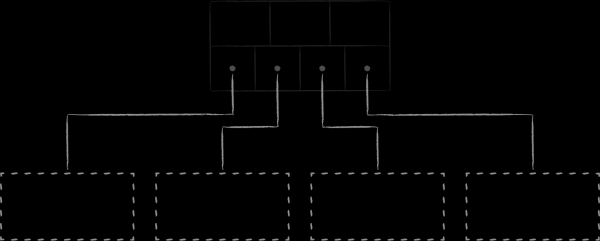 B-деревата, като еволюция на бинарните дървета, решават обозначените в предишния абзац проблеми. Първо, те са само-балансиращи. Второ, всеки от техните възли разделя множеството от дочерни ключове не на 2, а на M подредени подмножества, като числото M може да бъде доста голямо, от порядъка на стотици, а понякога и хиляди.
Това води до:
- Във всеки възел се намира голямо количество вече подредени ключове и дърветата стават много ниски.
- Дървото придобива свойството на локалност на разполагането в паметта, тъй като близките по значение ключове естествено се разполагат един до друг на един или съседни възли.
- Намалява се количеството транзитни възли при спускането по дървото по време на операция на търсене.
- Намалява се количеството прочетени целеви възли при range-запросите, тъй като в всеки от тях вече се съдържа голямо количество подредени ключове.
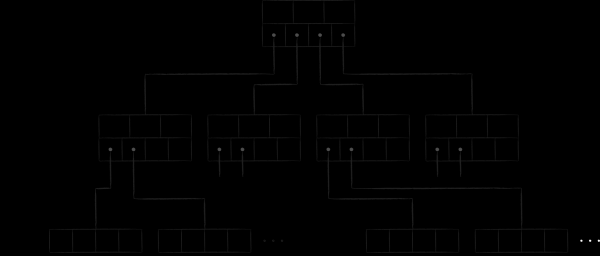
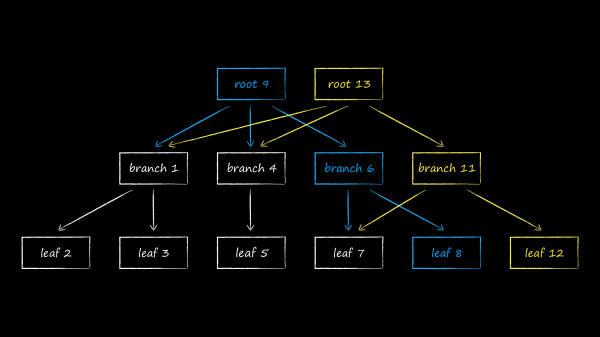
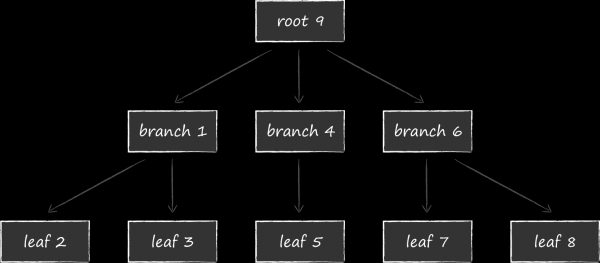
В LMDB за съхранение на данни се използва една от вариациите на B-дерева, наречена B+-дерево. На схемата по-горе са показани три типа възли, които в него съществуват:
- Върхът е коренът (root). Той материализира само концепцията за база данни в хранилището. В рамките на един инстанс LMDB могат да се създават няколко бази данни, които да споделят виртуалното адресно пространство. Всяка от тях започва със собствен корен.
- На най-долното ниво се намират листата (leaf). Именно те и само те съдържат двойките ключ-стойност, съхранявани в базата данни. Струва си да се спомене, че в това се състои особеността на B+-дърветата. Докато обикновеното B-дърво съхранява стойностите в възлите на всички нива, B+-вариацията го прави само на най-долното. След като установихме този факт, по-долу ще наричаме подтипа на дървото, използвано в LMDB, просто B-дърво.
- Между корена и листата се намират 0 или повече технически нива с навигационни (branch) възли. Тяхната задача е да разделят сортирания набор от ключове между листата.
Физически възлите са блокове памет с предварително определена дължина. Размерът им е кратен на размера на страниците памет в операционната система, за която говорихме по-горе. По-долу е показана структурата на възела. В хедъра се намира метаинформация, като най-очевидната за пример е контрольната сума. Следва информация за офсетите, по които се разполагат клетките с данни. Като данни могат да служат или ключовете, когато говорим за навигационни възли, или цели двойки ключ-стойност в случай на листата. По-подробно за структурата на страниците можете да прочетете в труда .
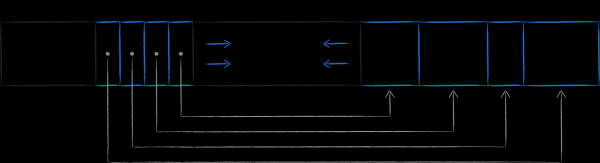
След като разбрахме вътрешното съдържание на възлите-страници, по-долу B-дървото в LMDB ще изобразим опростено по следния начин.
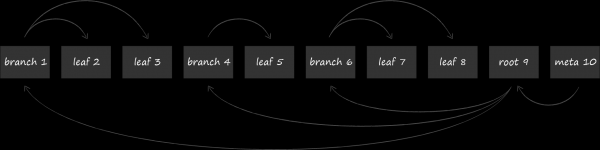
Страниците с възли последователно се разполагат на диска. Страниците с по-високи номера са разположени по-близо до края на файла. Т. нар. мета-страница (meta page) съдържа информация за офсетите, по които може да се намери коренът на всички дървета. При отваряне на файла LMDB последователно сканира файла от края към началото в търсене на валидна мета-страница и вече чрез нея намира съществуващите базы данни.
Сега, след като имате представа за логическата и физическата структура на организацията на данните, можете да преминете към разглеждането на третия кит на LMDB. Именно с негова помощ всички модификации на хранилището се извършват транзакционно и изолирано една от друга, придавайки на базата данни като цяло и свойството на мултиверсионност.
3.3. Кит №3. Copy-on-write
Някои операции с B-дерево изискват извършването на цяла поредица от промени в неговите възли. Един от примерите е добавянето на нов ключ в възел, който вече е достигнал максималната си вместимост. В такъв случай е необходимо, на първо място, да се раздели възелът на два, а на второ, да се добави връзка към новообразувания дъщерен възел в родителския му възел. Тази процедура потенциално е много опасна. Ако по някаква причина (срив, изключване на захранването и т. н.) се случи само част от промените от серията, то дървото ще остане в неконсистентно състояние.
Едно от традиционните решения за осигуряване на устойчивост на база данни към сривове е добавянето до B-деревото на допълнителна дискова структура за данни - журнал с транзакции, известен също като write-ahead log (WAL). Той представлява файл, в края на който строго преди модифицирането на самото B-дерево се записва предполагаемата операция. По този начин, ако по време на самообследването бъде открито повреждане на данни, базата данни се консултира с журнала, за да се върне в ред.
LMDB избра различен подход за осигуряване на устойчивост към сривове, наречен copy-on-write. Същността му е, че вместо да актуализира данните на съществуваща страница, първо я копира изцяло и всички модификации се извършват вече в копието.
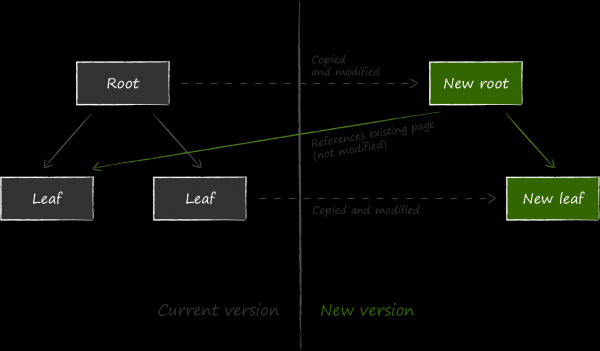
След това, за да бъдат актуализираните данни достъпни, е необходимо да се промени връзката към актуалния възел в родителския му възел. Тъй като за това и той трябва да бъде модифициран, той също предварително се копира. Процесът продължава рекурсивно до самия корен. Последни се променят данните на мета-страницата.
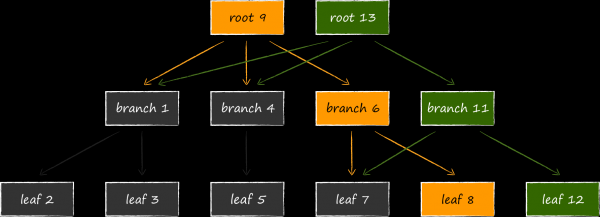
Ако по време на обновлението възникне аварийно спиране на процеса, новата мета-страница няма да бъде създадена или няма да бъде записана на диска дотогава, докато контролната й сума не стане некоректна. Във всеки от тези случаи новите страници ще бъдат недостъпни, а старите няма да бъдат засегнати. Това освобождава LMDB от необходимостта да поддържа write ahead log за запазване на консистентността на данните. Де факто структурата на данните на диска, описана по-горе, също изпълнява тази функция. Липсата на явен лог на транзакциите е една от особеностите на LMDB, която осигурява висока скорост на четене на данните.
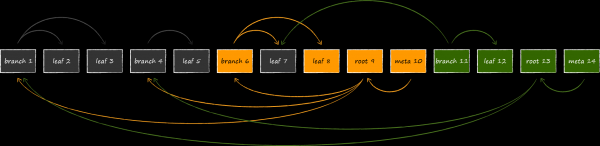
Получената структура, известна като append-only B-tree, естествено осигурява изолация на транзакциите и мултиверсионност. В LMDB с всяка отворена транзакция е свързан актуален корен на дървото. Докато транзакцията не е завършена, страниците на свързаното с нея дърво никога не ще бъдат променяни или повторно използвани за нови версии на данните. По този начин можете да работите дълго време с точно този набор от данни, който е актуален в момента на откритие на транзакцията, дори ако хранилището активно продължава да се обновява. В това се състои същността на мултиверсионността, която прави LMDB идеален източник на данни за всички нас. UICollectionView. Когато отворите транзакция, не е нужно да увеличавате memory footprint на приложението, спешно извличайки актуалните данни в някаква in-memory структура, страхувайки се да не останете на сухо. Тази характеристика ясно отличава LMDB от SQLite, който не може да се похвали с такава тотална изолация. Когато отворите две транзакции в SQLite и изтриете определен запис в рамките на едната, този запис вече не може да бъде получен и във втората оставена.
Обратната страна на медала е потенциално значително по-високото потребление на виртуална памет. На слайда е показана как ще изглежда структурата на базата данни, ако тя бъде модифицирана едновременно с 3 отворени транзакции за четене, гледащи на различни версии на базата данни. Тъй като LMDB не може да повторно използва възли, достижими от корените, свързани с актуалните транзакции, хранилището няма какво друго да направи, освен да разположи в паметта още едно четвърто кореново и отново да клонира модифицираните страници.
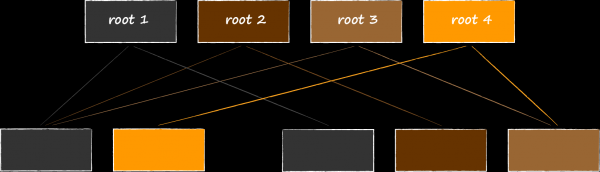
Тук не е излишно да споменем раздела за memory-mapped файлове. Изглежда, че допълнителното потребление на виртуална памет не трябва да ни притеснява особено, тъй като то не допринася за memory footprint на приложението. Въпреки това, беше отбелязано, че iOS е доста стисната при нейното разпределение, и не можем, както на сървър или десктоп, да предоставим LMDB регион от 1 терабайт, без да помислим за тази особеност. По възможност трябва да се стремим да правим срока на живот на транзакциите колкото се може по-кратък.
4. Проектиране на схема от данни над key-value API
Нека да започнем разбор на API с разглеждане на основните абстракции, предоставени от LMDB: среда и бази данни, ключове и стойности, транзакции и курсори.
Забележка за кодовите листинги
Всички функции в публичния API на LMDB връщат резултата от своята работа под формата на код на грешка, но в следващите кодови листинги проверката му е пропусната в името на лаконичността. На практика, ние използвахме свой C++ обвивки , в който грешките се материализират под формата на изключения C++.
Като най-бърз начин за свързване на LMDB с проекта за iOS или macOS предлагам своя CocoaPod .
4.1. Основни абстракции
Среда (environment)
Структура MDB_env е вместилище на вътрешното състояние на LMDB. Семейство функции с префикс mdb_env позволява конfiguration на някои от неговите свойства. В най-простия случай инициализацията на двигателя изглежда по следния начин.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);В приложението Облака Mail.ru променихме стойностите по подразбиране само на два параметъра.
Първият от тях е размерът на виртуалното адресно пространство, в което се отразява файлът за съхранение. За съжаление, дори на едно и също устройство, конкретната стойност може съществено да се различава от стартиране до стартиране. За да се вземе предвид тази особеност на iOS, максималният обем за съхранение се подбира динамично. Започвайки от някаква стойност, той последователно се наполовина до момента, в който функцията mdb_env_open не върне резултат, различен от ENOMEM. В теорията съществува и обратният път — първо да се выдели на двигателя минимум памет, а след това, при получаване на грешки MDB_MAP_FULL, да се увеличи. Въпреки това той е много по-сложен. Причината е, че процедурата за повторно разпределение на паметта (remap) с помощта на функцията mdb_env_set_map_size инвалидира всички съвкупности (курсори, транзакции, ключове и стойности), получени преди това от двигателя. Вземането под внимание на този обрат в кода ще доведе до значително усложняване. Все пак, ако виртуалната памет ви е много скъпа, това може да е причина да се огледате за далеч напреднала версия на форка , където сред обявените функции е «автоматично регулиране на размера на базата данни в движение».
Вторият параметър, стандартната стойност на който не ни подхожда, регулира механиката на осигуряване на безопасност при потоци. За съжаление, поне в iOS 10 има проблеми с поддръжката на thread local storage. По тази причина в примера по-горе хранилището се отваря с флага MDB_NOTLS. Освен това беше необходимо и C++ обвивката , за да се изрежат променливите с този атрибут и в нея.
Бази данни
Базата данни представлява отделен инстанс на B-дерево, за което говорихме по-горе. Нея се отваря вътре в транзакция, което в началото може да се стори малко странно.
MDB_txn *txn;
MDB_dbi dbi;
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn);
mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi);
mdb_txn_abort(txn);Наистина, транзакцията в LMDB е съвкупност на хранилището, а не на конкретната база данни. Тази концепция позволява извършването на атомарни операции над съвкупностите, находящи се в различни бази данни. В теорията това отваря възможността за моделиране на таблици като различни бази, но аз по това време отидох по друг път, описан в подробности по-долу.
Ключове и стойности
Структура MDB_val моделира концепцията както на ключа, така и на стойността. Хранилището няма абсолютно никакво разбиране за тяхната семантика. За него, нещо като нещо друго е просто масив от байтове с определен размер. Максималният размер на ключа е 512 байта.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;С помощта на компаратора хранилището подрежда ключовете по нарастващ ред. Ако не замените собственото си, ще се използва дефолтното, което ги сортира по байтове в лексикографски ред.
Транзакции
Устройството на транзакциите е подробно описано в , затова тук с кратка фраза ще повторя основните им свойства:
- Поддръжка на всички основни свойства : атомарност, последователност, изолация и надеждност. Не мога да не подчертая, че в частта за durability на macOS и iOS има бъг, коригиран в MDBX. Можете да прочетете повече за него в техния .
- Подходът към многопоточността се описва със схемата „единичен пишещ / множество четящи“. Писателите блокират един друг, но не блокират читателите. Читателите не блокират нито писателите, нито един друг.
- Поддръжка на вложени транзакции.
- Поддръжка на много версии.
Много версия в LMDB е толкова добра, че искам да я демонстрирам в действие. От кода по-долу е видно, че всяка транзакция работи именно с версията на базата данни, която е била актуална в момента на откритие, буди се напълно изолирана от всички последващи промени. Инициализацията на хранилището и добавянето на тестовата записка не представляват нищо интересно, затова тези ритуали остават под спойлер.
Добавяне на тестова записка
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;
mdb_env_create(&env);
mdb_env_open(env, "./testdb", MDB_NOTLS, 0664);
mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);
char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;
int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;
mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Отваряме 2 транзакции, всяка от които поглежда
// към версията на базата данни с един запис.
mdb_txn_begin(env, NULL, 0, &txn1); // read-write
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // read-only
// В рамките на първата транзакция изтриваме съществуващ запис от базата данни.
mdb_del(txn1, dbi, &key, NULL);
// Записваме изтриването.
mdb_txn_commit(txn1);
// Отваряме трета транзакция, която гледа
// актуалната версия на базата данни, където записът вече го няма.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Убедяваме се, че записа по търсения ключ вече не съществува.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Завършваме транзакцията.
mdb_txn_abort(txn3);
// Убедяваме се, че в рамките на втората транзакция, отворена в момента
// на съществуването на записа в базата данни, все още може да се намери по ключа.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Проверяваме, че по ключа получаваме не аби какъв боклук, а валидни данни.
assert(*(int *)val.mv_data == 997);
// Завършваме транзакцията, работеща макар и с остаряла, но консистентна база данни.
mdb_txn_abort(txn2);Факултативно препоръчвам да опитате да направите същия трик с SQLite и да видите какво ще се получи.
Мултиверсионността носи много приятни предимства на iOS разработчика. С помощта на това свойство лесно и без усилия можем да регулираме скоростта на обновяване на източника на данни за екранните форми, вземайки предвид потребителското изживяване. За пример ще вземем такава функция на приложението Облака Mail.ru като автоматично зареждане на съдържание от системната медиагалерия. При добро свързване клиентът може да добавя няколко снимки на сървъра за секунда. Ако след всяко зареждане актуализираме UICollectionView с медиаконтента в облака на потребителя, можем да забравим за 60 fps и плавно превъртане по време на този процес. За да предотвратим честите обновления на екрана, е необходимо по някакъв начин да ограничим скоростта на промяна на данните в основата. UICollectionViewDataSource.
Ако базата данни не поддържа многовариантност и позволява работа само с текущото актуално състояние, то за създаване на стабилен snapshot на данните е необходимо да се извърши копиране или в някаква in-memory структура данни, или в временна таблица. Всеки от тези подходи е много скъп. В случая на in-memory хранилище получаваме разходи както по памет, свързани с съхранението на конструираните обекти, така и по време, свързани с излишни ORM преобразования. Що се отнася до временната таблица, то това е още по-скъпо удоволствие, което има смисъл само в нетривиални случаи.
Многовариантността на LMDB решава задачата за поддържане на стабилен източник на данни много елегантно. Достатъчно е просто да се отвори транзакция и voilà — докато не я завършим, наборът от данни е гарантирано фиксиран. Логиката на скоростта на обновяването сега напълно лежи в ръцете на презентационния слой, без значителни разходи за ресурси.
Курсори
Курсорите предоставят механизъм за подредено итериране по двойки ключ-стойност чрез обход на B-дерево. Без тях би било невъзможно ефективно да се моделират таблиците в базата данни, към които се придвижваме.
4.2. Моделиране на таблици
Свойството на подреденост на ключовете позволява изграждането над основните абстракции на такъв високонаболен слой като таблица. Нека разгледаме този процес на примера на основната таблица на облачния клиент, в която е кеширана информация за всички файлове и папки на потребителя.
Схема на таблицата
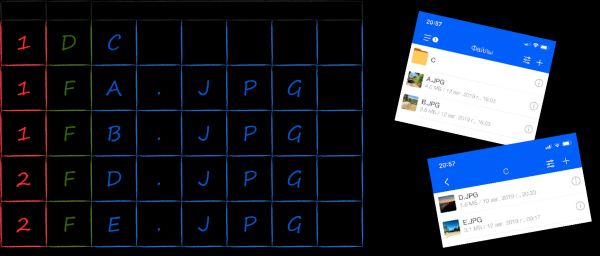
Един от често срещаните сценарии, за които структурата на таблицата с дървото на папките трябва да бъде проектирана, е изборът на всички елементи, разположени в зададена директория. Добра моделна организация на данните за ефективни заявки от този род е . За нейното реализиране над хранилище от ключ-стойност е необходимо да се сортират ключовете на файловете и папките по такъв начин, че да се групират на основата на принадлежността към родителската директория. Освен това, за да се визуализира съдържанието на директорията в познатия на потребителя Windows вид (първо папките, след това файловете, и двете подредени по азбучен ред), е необходимо да се включат съответните допълнителни полета в ключа.
На изображението по-долу се показва как, въз основа на зададената задача, може да изглежда представянето на ключовете под формата на масив от байтове. Първо се разполагат байтовете с идентификатора на родителската директория (в червено), след това – с типа (в зелено) и накрая – с името (в синьо). Когато са сортирани с дефолтния компаратор на LMDB в лексикографски ред, те се подреждат по необходимия начин. Последователният обход на ключовете с един и същи червен префикс ни дава свързаните с тях стойности в реда, в който трябва да бъдат изведени в потребителския интерфейс (вдясно), без да изисква допълнителна постобработка.
Сериализация на ключове и стойности
В света са измислени множество методи за сериализация на обекти. Тъй като нямаме никакво друго изискване, освен бързина, за себе си избрахме най-бързия от възможните - дамп на паметта, заета от инстанс на структура на езика C. Така, ключът на елемента в директорията може да бъде моделиран по следната структура NodeKey.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;За запазване NodeKey в хранилището е нужно да се позиционира указателят на данните на адреса в началото на структурата, а размерът им да се изчисли с функцията MDB_val sizeof MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; }.
В първата глава за критериите за избор на база данни споменах, че важен фактор за избора е минимизирането на динамичните алокации в рамките на CRUD операции. Кодът на функциятаserialize показва как в случая на LMDB могат напълно да се избегнат при вмъкване на нови записи в базата данни. Полученият масив байтове от сървъра първо се трансформира в стекови структури, а след това те тривиално се дампят в хранилището. Имайки предвид, че вътре в LMDB също няма динамични алокации, можем да постигнем фантастичната за iOS ситуация – да използваме само стекова памет за работа с данни по целия им път от мрежата до диска! Подреждане на ключовете с бинарен компаратор
Упорядочаване на ключовете с бинарен компаратор
Редът на ключовете се задава с помощта на специална функция, наречена компаратор. Тъй като машината не знае нищо за семантиката на байтовете, които съдържат, по подразбиране компараторът няма друга алтернатива освен да подреди ключовете в лексикографски ред, използвайки побайтово сравнение. Използването му за подреждане на структури е подобно на бръснене с дялка. Въпреки това, в не много сложни случаи, намирам този метод за приемлив. Алтернативата е описана малко по-долу, а тук ще спомена няколко разпръснати капки по този път.
Първото, което трябва да запомните, е представянето в паметта на примитивните типове данни. Така, на всички устройства Apple, целочислените променливи се съхраняват в формат . Това означава, че най-малкият значим байт ще бъде отляво и не можем да сортираме целите числа, използвайки побайтово сравнение. Например, опитът за сортиране на набор от числа от 0 до 511 ще доведе до следния резултат.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
За решаване на този проблем, целите числа трябва да се съхраняват в ключа в подходящ формат за побайтовия компаратор. Необходимата конверсия може да се извърши с функции от семейството на hton* (в частност, htons за двубайтовите числа от примера).
Форматът на представяне на стрингове в програмирането е, както е известно, цяла . Ако семантиката на стринговете, както и използваната за тяхното представяне в паметта кодировка предполага, че на символ може да се падне повече от един байт, то от идеята да се използва по подразбиране компаратор е най-добре да се откаже веднага.
Второто, което трябва да имате предвид, са на компилятора за полета в структурата. Поради тях в паметта между полетата могат да се образуват байтове с отпадъчни стойности, което, разбира се, разваля побайтовото сортиране. За премахване на отпадъците трябва или да декларирате полета в строго определен ред, имайки предвид правилата за подравняване, или да използвате атрибута в обявлението на структурата packed.
Подреждане на ключовете от външен компаратор
Логиката на сравнение на ключовете може да се окаже прекалено сложна за бинарния компаратор. Една от многото причини е наличието на технически полета в структурите. Ще илюстрирам тяхното възникване с примера на вече познатия ключ за елемент на директория.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Въпреки своята простота, в повечето случаи той консумира твърде много памет. Буферът за имена заема 256 байта, докато средната дължина на имената на файловете и папките рядко надвишава 20-30 символа.
Един от стандартните методи за оптимизация на размера на записа е «подрязването» му до действителния размер. Сътворението на проблема е, че съдържанието на всички променливи дължини се съхранява в края на структурата, а дължините им - в отделни променливи. Според този подход ключът NodeKey се трансформира по следния начин.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
По-нататък при сериализацията като размер на данните се посочва не MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; } цялата структура, а размерът на всички полета с фиксирана дължина плюс размерът на реално използваната част от буфера.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength,
        .mv_data = (void *)key
    };
}
В резултат на извършената рефакторизация получихме значителна икономия на пространството, заето от ключовете. Въпреки това, поради техническото поле nameLength, стандартният бинарен компаратор вече не е подходящ за сравнение на ключовете. Ако не го заменим със собствен, дължината на името ще бъде по-приоритетен фактор при сортирането, отколкото самото име.
LMDB позволява на всяка база данни да зададе своя функция за сравнение на ключове. Това става с помощта на функцията mdb_set_compare строго преди отваряне. Поради очевидни причини, през целия живот на базата данни тя не може да се променя. На входа компараторът получава два ключа в бинарен формат, а на изхода връща резултата от сравнението: по-малко (-1), по-голямо (1) или равни (0). Псевдокодът за NodeKey изглежда така.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey * const aKey = (NodeKey * const)a->mv_data;
    NodeKey * const bKey = (NodeKey * const)b->mv_data;
    return // ...
}
Докато всички ключове в базата данни имат един и същи тип, безусловното преобразуване на байтовото им представяне към типа на прикладната структура на ключа е законно. Тук има един нюанс, но той ще бъде разгледан по-долу в раздела 'Четене на записи'.
Сериализация на стойности
С ключовете на съ хранилищата LMDB работи изключително интензивно. Сравнението между тях се осъществява в рамките на всяка приложна операция и от скоростта на работа на компаратора зависи производителността на цялото решение. В идеалния свят за сравнение на ключовете трябва да е достатъчен стандартният бинарен компаратор, но ако все пак се наложи да използвате собствен, процедурата за десериализация на ключовете в него трябва да бъде възможно най-бърза.
Частта с Value (стойността) на записа не интересува базата данни особено. Преобразуването ѝ от байтова форма в обект става единствено тогава, когато приложният код наистина се нуждае от това, например за показване на екрана. Тъй като това се случва сравнително рядко, изискванията за скоростта на тази процедура не са толкова критични, и в нейното реализиране можем да се съсредоточим повече върху удобството. Например, за сериализиране на метаданни за още не заредени файлове използваме NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Въпреки това, има случаи, когато производителността все пак има значение. Например, при запазване на метаинформация за файловата структура на потребителското облако, използваме същия дамп на паметта на обектите. Особеност на задачата със създаване на тяхното сериализирано представяне е фактът, че елементите на директорията се моделират с иерархия от класове.
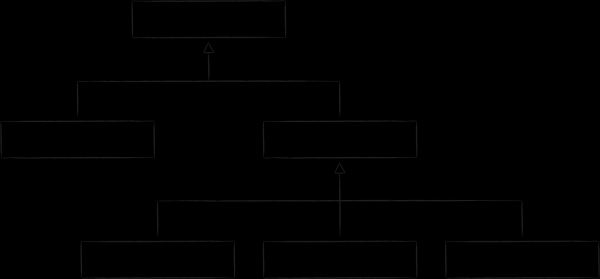
За нейното реализиране на езика C специфичните полета на наследниците се извеждат в отделни структури, а тяхната връзка с базовия клас се задава чрез поле от тип union. Актуалното съдържание на обединението се задава чрез техническия атрибут type.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Добавяне и обновление на записи
Сериализираните ключ и стойност могат да се добавят в хранилището. За това се използва функцията mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);На етапа на конфигуриране на хранилището можете да разрешите или забраните съхраняването на няколко записа с един и същи ключ. Ако дублирането на ключове е забранено, при поставяне на запис можете да определите дали е допустимо обновлението на вече съществуващ запис. Ако презаписването може да се случи само поради грешка в кода, можете да се защитите, като зададете флаг NOOVERWRITE.
Четене на записи
Функцията, предназначена за четене на записи в LMDB, е mdb_get. Ако двойката ключ-стойност вече е представена с дампнати структури, процедурата изглежда по следния начин.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}Представеният листинг показва как сериализация чрез дамп на структури позволява да се избегне динамичната алокация не само при запис, но и при четене на данни. Полученият от функцията mdb_get указателят сочи точно на този адрес на виртуалната памет, където базата данни съхранява байтовото представяне на обекта. В действителност получаваме нещо като ORM, което практически безплатно осигурява много висока скорост на четене на данни. Въпреки цялата красота на подхода, трябва да помним за няколко свързани с него особености.
- За транзакции с само за четене указателят на структурата-стойност ще остане валиден само докато транзакцията не бъде затворена. Както беше отбелязано по-рано, страниците на B-деревото, на които се намира обектът, благодарение на принципа на copy-on-write остават неизменни, докато има поне една транзакция, която ссыла се на тях. В същото време, веднага след като последната свързана с тях транзакция приключи, страниците могат да бъдат повторно използвани за нови данни. Ако е необходимо, обектите да оцеляват извикващата транзакция, ще се наложи да ги копирате.
- За транзакция с четене и запис указателят на получената структура-стойност ще бъде валиден само до първата модифицираща процедура (запис или изтриване на данни).
- Въпреки че структурата
NodeValueне е пълноценна, а намалена (вж. подраздела „Подреждане на ключове с външен компаратор“), чрез указателя може спокойно да се достъпва до нейните полета. Важно е да не я разименувате! - По никакъв начин не трябва да се модифицира структурата чрез получен указател. Всички изменения трябва да се извършват само чрез метода
mdb_put. Въпреки всички усилия, това няма да е възможно, тъй като областта на паметта, в която се намира структурата, е картографирана в режим readonly. - Ремап на файла в адресното пространство на процеса с цел, например, увеличаване на максималния размер на хранилището чрез функция
mdb_env_set_map_sizeизцяло анулира всички транзакции и свързаните с тях сущности изцяло, както и указателите към прочетените обекти в частност.
Накрая, още едно свойство е толкова коварно, че разкритията му не могат просто да се вместят в още една точка. В главата за B-дервото представих схема на устройството на страниците му в паметта. От нея следва, че адресът на началото на буфера със сериализирани данни може да бъде напълно произволен. Поради това указателят към тях, получаван в структурата MDB_val и представен като указател към структура, получава в общия случай не подравнен. В същото време архитектурите на някои чипове (в случая с iOS това е armv7) изискват адресът на всякакви данни да бъде кратен на размера на машинната дума или, с други думи, на битността на системата (за armv7 — това са 32 бита). С други думи, операция като *(int *foo)0x800002 на тях се равнява на бягство и води до разстрел с присъда EXC_ARM_DA_ALIGN. За да се избегне такова tragично развитие, могат да се предприемат два начина.
Първият се състои в предварително копиране на данните в очевидно подравнена структура. Например, в кастомния компаратор това ще се отрази по следния начин.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return // ...
}
Алтернативният подход — предварително да уведомим компилатора, че структурите с ключ и стойност могат да не бъдат подравнени с помощта на атрибута aligned(1). На ARM такъв същия ефект може да и с помощта на атрибута packed. Като се има предвид, че той също така допринася за оптимизацията на заетото от структурата място, този подход ми се струва предпочитан, макар и до увеличаване на разходите за операции с данни.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Range-запроси
За итерация по групата записи в LMDB е предвидена абстракция курсор. Как да работим с него, ще разгледаме на примера на вече познатата ни таблица с метаданни на потребителското облако.
В рамките на показването на списъка с файлове в директорията е необходимо да се намерят всички ключове, с които са асоциирани дъщерните файлове и папки. В предишните подраздели сортирахме ключовете NodeKey така че те първо да са подредени по идентификатора на родителската директория. Следователно, технически, задачата за получаване на съдържанието на папката се свежда до установяване на курсора на горната граница на групата ключове с зададен префикс и следващо итериране до долната граница.
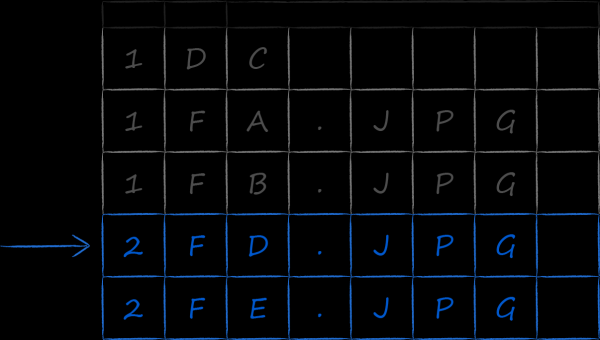
Горната граница може да се намери "на сляпо" с последователно търсене. За това курсорът се установява в началото на целия списък с ключове в базата данни и след това се инкрементира, докато под него не попадне ключ с идентификатора на родителската директория. Този подход има 2 очевидни недостатъка:
- Линейна сложност на търсенето, въпреки че, както е известно, в дърветата като цяло и в B-деревото в частност, това може да се извърши за логарифмично време.
- Напразно се изтеглят в основната памет всички страници, предшествующи исканата, което е изключително скъпо.
За щастие в API LMDB е предвиден ефективен начин за начално позициониране на курсора. За целта е нужно да се формира такъв ключ, чиято стойност ще бъде заведомо по-малка или равна на ключа, находящ се на горната граница на интервала. Например, прилагано към списъка на изображението по-горе, можем да направим такъв ключ, в който полето parentId ще е равно на 2, а всички останали ще бъдат запълнени с нули. Такъв частично запълнен ключ се подава на входа на функцията mdb_cursor_get с указание операция MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Ако горната граница на групата ключове е намерена, продължаваме да итерираме по нея, докато не се срещне или ключ с друг parentId, или ключовете напълно да не свършат.
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
\/\/ processing...
} while (MDB_NOTFOUND != rc && \/\/ check end of table
IsTargetKey(key)); \/\/ check end of keys groupКакто е приятно, при итерация с помощта на mdb_cursor_get, ние получаваме не само ключа, но и стойността. Ако за изпълнението на условията за изтегляне е необходимо да се проверят и полета от частта с стойността, те са напълно на разположение без допълнителни усилия.
4.3. Моделиране на връзките между таблиците
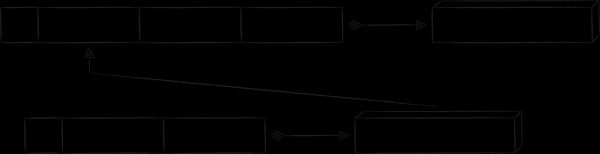
Към момента успяхме да разгледаме всички аспекти на проектирането и работата с еднотаблична база данни. Можем да кажем, че таблицата е набор от подредени записи, състоящи се от еднотипни двойки ключ-стойност. Ако визуализираме ключа като правоъгълник, а свързаната с него стойност като правоъгълен паралелепипед, получаваме визуална схема на базата данни.

Въпреки това, в реалния живот рядко успяваме да се справим с толкова малко усилия. Често в базата данни е необходимо, от една страна, да имаме няколко таблици, а от друга страна, да правим извлечения в ред, различен от основния ключ. Предназначението на тази последна част е да се занимава с въпросите на създаването и свързването на таблиците.
Индексни таблици
В облачното приложение има раздел "Галерия". В него се показва медиен съдържание от цялото облако, сортирано по дата. За оптимална реализация на такова изтегляне до основната таблица е необходимо да създадем още една с нов тип ключове. В тях ще се съдържа поле с датата на създаване на файла, което ще служи за основен критерий за сортиране. Тъй като новите ключове сочат към същите данни, както ключовете в основната таблица, те се наричат индексни. На изображението по-долу те са отбелязани с оранжев цвят.
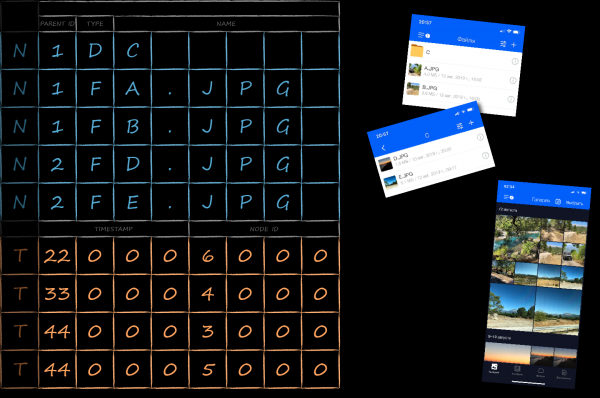
За да отделим ключовете на различните таблици в една база данни, на всички тях е добавено допълнително техническо поле tableId. Като направим него най-приоритетен за сортиране, ще постигнем групиране на ключовете първо по таблици, а след това вътре в таблиците - по наши правила.
Индексният ключ сочи към същите данни, както и основния. Прекият вариант на това свойство чрез асоциация с копие на частта със стойността на основния ключ не е оптимален от няколко гледни точки:
- От гледна точка на заето място, тъй като метаданните могат да бъдат доста обширни.
- От гледна точка на производителността, тъй като при актуализиране на метаданните, нодите ще трябва да направят запис по два ключа.
- От гледна точка на поддръжката на кода, ако забравим да актуализираме данните по един от ключовете, ще получим трудноуловим бъг на несъответствие на данните в хранилището.
Нека разгледаме как да премахнем тези недостатъци.
Организация на връзките между таблиците
За свързването на индексовата таблица с основната е удачен шаблонът «ключ като стойност». Както подсказва името му, в частта стойност на индексния запис се използва копие на стойността на първичния ключ. Този подход неутрализира всички изброени по-горе недостатъци, свързани с възпроизвеждане на стойността на първичния запис. Единствената цена е, че за получаване на стойността по индексния ключ е необходимо да се направят 2 заявки в базата данни вместо една. Получената схема на базата данни изглежда по следния начин.
Друг шаблон за организация на връзките между таблиците е «излишен ключ». Същността му е добавянето на допълнителни атрибути към ключа, които не са предназначени за сортиране, а за възстановяване на свързания ключ. В приложението на Облака Mail.ru има реални примери за използването му, но за да избегнем дълбочинно потапяне в контекста на специфични iOS-фреймворкове, ще дам измислен, но по-разбираем пример.
В облачните мобилни клиенти има страница, на която се показват всички файлове и папки, до които потребителят е предоставил достъп на други хора. Тъй като такъв файлов обем е относително малък, а информацията, свързана с публичността, е много (кому е предоставен достъп, с какви права и т.н.), ще бъде нерационално да утежняваме частта стойност на записа в основната таблица. Въпреки това, ако искаме да показваме тези файлове офлайн, е необходимо да я съхраняваме някъде. Естественият вариант за решение е да се създаде отделна таблица за нея. На схемата по-долу нейният ключ има префикс «P», а плейсхолдерът «propname» може да бъде заменен с по-конкретна стойност «публична информация».
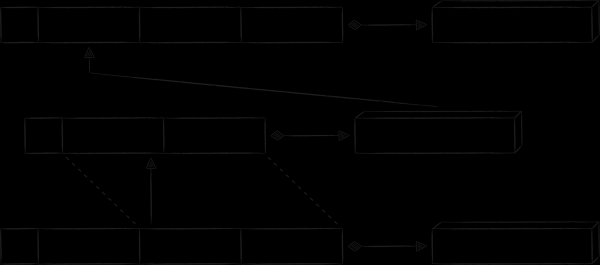
Всички уникални метаданни, за които е създадена новата таблица, се извеждат в value-частта на записа. В същото време не желаем да дублираме данните за файловете и папките, които вече се съхраняват в основната таблица. Вместо това в ключа «P» се добавят излишни данни под формата на полета «node ID» и «timestamp». Благодарение на тях може да се конструира индексен ключ, по който да получим първичен ключ, по който накрая да получим метаданните на нодата.
Заключение
Оценяваме внедряването на LMDB положително. След него броят на зависванията на приложението намаля с 30%.
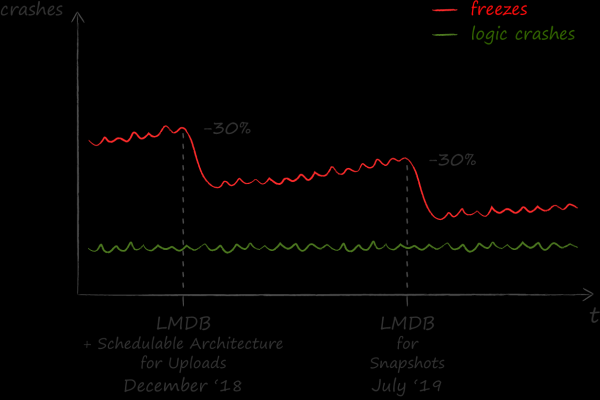
Резултатите от извършената работа намериха отзвук извън екипа по iOS. В момента един от основните раздели «Файлове» в приложението за Android също премина на използване на LMDB, а други части са на път. Язык C, на който е реализирано key-value хранилището, се оказа добро предимство, за да се направи приложен слой около него кросплатформено на C++. За безпроблемна свързаност на получената C++ библиотека с платформения код на Objective-C и Kotlin беше използван кодогенератор от Dropbox, но това вече е съвсем друга история.
Източник: habr.com
