

Здравейте на всички! Казвам се Дмитрий Самсонов, работя като водещ системен администратор в «Одноклассниках». Имаме над 7 хиляди физически сървъри, 11 хиляди контейнера в нашето облако и 200 приложения, които в различни конфигурации формират 700 различни клъстера. Подавляващото мнозинство от сървърите работят под управлението на CentOS 7.
На 14 август 2018 г. беше публикувана информация за уязвимостта FragmentSmack
() и SegmentSmack (). Това са уязвимости с мрежова векторна атака и доста висока оценка (7.5), която заплашва отказ в обслужването (DoS) поради изчерпване на ресурси (CPU). Поправката в ядрото за FragmentSmack по това време не беше предложена, а всъщност излезе значително по-късно след публикуването на информацията за уязвимостта. За отстраняване на SegmentSmack се предложи да се обнови ядрото. Самият пакет с обновлението беше издаден в същия ден, просто оставаше да се инсталира.
Не, ние изобщо не сме против обновлението на ядрото! Въпреки това, има нюанси...
Как обновяваме ядрото на продукция
Общо взето, нищо сложно:
- Свалете пакетите;
- Инсталирайте ги на определен брой сървъри (включително сървърите, които хостват нашето облако);
- Уверете се, че нищо не е счупено;
- Проверете, че всички стандартни настройки на ядрото са приложени без грешки;
- Изчакайте няколко дни;
- Проверете показателите на сървърите;
- Препключете внедряването на новите сървъри на новото ядро;
- Обновете всички сървъри по дата-центрове (един дата-център наведнъж, за да минимизирате ефекта за потребителите в случай на проблеми);
- Рестартирайте всички сървъри.
Повторете за всички версии на наличните ни ядра. В момента това е:
- Стоково CentOS 7 3.10 — за повечето обикновени сървъри;
- Ванилно 4.19 — за нашето , защото ни трябват BFQ, BBR и т.н.;
- Elrepo kernel-ml 5.2 — за , защото 4.19 по-рано се държеше нестабилно, а функциите са същите.
Както може да предположите, най-много време отнема рестартирането на хиляди сървъри. Тъй като не всички уязвимости са критични за всички сървъри, рестартираме само тези, които са директно достъпни от интернет. В облака, за да не ограничаваме гъвкавостта, не свързваме контейнерите, достъпни от външната страна, с отделни сървъри с ново ядро, а рестартираме всички хостове без изключение. За щастие, там процедурата е по-проста в сравнение с обикновените сървъри. Например, stateless-контейнерите могат просто да се преместят на друг сървър по време на ребута.
Въпреки това работата все пак е много и може да отнеме няколко седмици, а при възникване на каквито и да е проблеми с новата версия — до няколко месеца. Злосторниците разбират това отлично, затова е нужен план "Б".
FragmentSmack/SegmentSmack. Workaround
За щастие, за някои уязвимости съществува такъв план "Б", наречен Workaround. Най-често това е изменение на настройки на ядрото/приложенията, които позволяват минимизиране на възможния ефект или напълно изключване на експлоатацията на уязвимости.
В случая с FragmentSmack/SegmentSmack такъв Workaround:
«Можете да промените подразбиращите се стойности 4MB и 3MB в net.ipv4.ipfrag_high_thresh и net.ipv4.ipfrag_low_thresh (и техните аналози за ipv6 net.ipv6.ipfrag_high_thresh и net.ipv6.ipfrag_low_thresh) на 256 kB и 192 kB съответно или по-ниски. Тестовете показват от малък до значителен спад в използването на CPU по време на атака, в зависимост от оборудването, настройките и условията. Въпреки това, може да има известно влияние върху производителността заради ipfrag_high_thresh=262144 bytes, тъй като само две 64K фрагменти могат едновременно да се побират в опашката за повторно сглобяване. Например, има риск приложенията, работещи с големи UDP пакети, да се повредят.».
Самите параметри са описани така:
ipfrag_high_thresh - ДЪЛГО ЦЯЛО ЧИСЛО
     Максималната памет, използвана за повторно сглобяване на IP фрагменти.
ipfrag_low_thresh - ДЪЛГО ЦЯЛО ЧИСЛО
     Максимална памет, използвана за възстановяване на IP фрагменти, преди ядрото
     да започне да премахва непълните опашки на фрагменти, за да освободи ресурси.
     Ядрото все още приема нови фрагменти за дефрагментация.
На продакшън-сервисите нямаме големи UDP трафик. В LAN фрагментирания трафик отсъства, в WAN е налице, но не значителен. Нищо не предвещава — можем да приложим Workaround!
FragmentSmack/SegmentSmack. Първа кръв
Проблемата, с която се сблъскахме първоначално, беше, че облачните контейнери понякога прилагаха новите настройки само частично (само ipfrag_low_thresh) или изобщо не ги прилагаха — просто се проваляха при стартиране. Не успяхме да възпроизведем проблема стабилно (всички настройки се прилагаха без затруднения ръчно). Разбера защо контейнерът се проваля при стартиране, също не беше лесно: нямаше открити грешки. Едно бе абсолютно сигурно: връщането на настройките решава проблема с провалите на контейнерите.
Защо не е достатъчно да приложим Sysctl на хоста? Контейнерът живее в собственото си отделено мрежово пространство, поради което поне в контейнера може да се различава от хоста.
Как точно се прилагат настройките Sysctl в контейнера? Понеже контейнерите ни са непозволени, не можем да променим нито една настройка Sysctl, като влезем в самия контейнер — просто правата не стигат. За стартирането на контейнерите, нашето облако по онова време използваше Docker (в момента вече ). На Docker се предаваха параметрите на новия контейнер чрез API, включително необходимите настройки Sysctl.
В процеса на тестване на версиите, установихме, че API на Docker не връщаше всички грешки (поне в версия 1.10). Когато опитахме да стартираме контейнера чрез “docker run”, най-накрая видяхме нещо:
write /proc/sys/net/ipv4/ipfrag_high_thresh: invalid argument docker: Error response from daemon: Cannot start container : [9] System error: could not synchronise with container process.
Стойността на параметъра е невалидна. Но защо? И защо е невалидна само понякога? Установихме, че Docker не гарантира реда на прилагане на параметрите Sysctl (последната проверена версия — 1.13.1), поради което понякога ipfrag_high_thresh се опитваше да се зададе на 256K, когато ipfrag_low_thresh все още е 3M, т.е. горната граница беше по-ниска от долната, което водеше до грешка.
По това време вече използвахме наш собствен механизъм за конфигуриране на контейнера след стартиране (замразяване на контейнера чрез и изпълнение на команди в пространството на имената на контейнера чрез ), и добавихме в тази част също така задаването на параметрите Sysctl. Проблемът беше решен.
FragmentSmack/SegmentSmack. Първа кръв 2
Докато се опитвахме да разберем приложението на Workaround в облака, започнаха да постъпват първоначалните редки оплаквания от потребители. В този момент бяха изминали няколко седмици от началото на използването на Workaround на първите сървъри. Първоначалното разследване показа, че оплакванията идват от отделни услуги и не от всички сървъри на тези услуги. Проблемът отново придоби изключително неопределен характер.
На първо място, разбира се, опитахме да върнем настройките на Sysctl, но това не даде никакъв ефект. Различни манипулации с настройките на сървъра и приложението също не помогнаха. Помогна reboot. Reboot за Linux е толкова противоестествен, колкото е било нормално условие за работа с Windows в миналото. Въпреки това той помогна и всичко стесихме до „глюк в ядрото“ при прилагането на новите настройки в Sysctl. Каква безразсъдност...
След три седмици проблемът се повтори. Конфигурацията на тези сървъри беше доста проста: Nginx в режим прокси/балансировчик. Трафикът беше малко. Нов акцент: при клиентите все повече нараства броят на 504-те грешки (). На графиката е показан броят на 504-те грешки на ден за тази услуга:
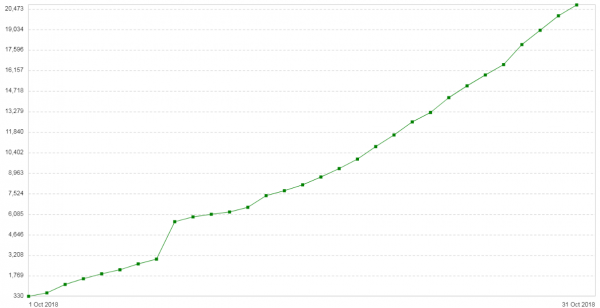
Всички грешки са свързани с един и същ бекенд — този, който се намира в облака. Графикът за потребление на памет под фрагменти на пакети на този бекенд изглеждаше така:
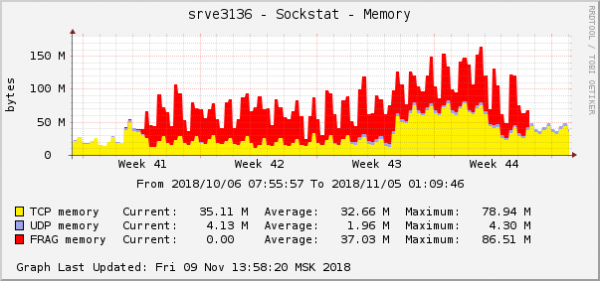
Това е едно от най-очевидните проявления на проблема в графиките на операционната система. В облака точно в това време беше коригиран друг мрежови проблем с настройките на QoS (Traffic Control). На графиката за потребление на памет под фрагменти на пакети тя изглеждаше точно така:
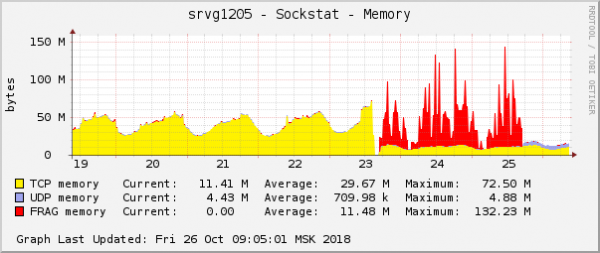
Предположението беше просто: ако в графиките те изглеждат еднакво, то и причината е същата. Тем повече, че каквито и да е проблеми с този тип памет възникват изключително рядко.
Същността на коригирания проблем беше, че използвахме в QoS пакетния шедулдер fq с настройки по подразбиране. По подразбиране за едно съединение той позволява да се добавят в опашката 100 пакета и някои съединения в условията на недостатъчно канал започнаха да запълват опашката до отказ. В този случай пакетите се дропват. В статистиката tc (tc -s qdisc) това се вижда така:
qdisc fq 2c6c: родител 1:2c6c лимит 10000p flow_limit 100p buckets 1024 orphan_mask 1023 quantum 3028 initial_quantum 15140 refill_delay 40.0ms
  Изпратени 454701676345 байта 491683359 пакета (пропуснати 464545, над лимита 0, повторни опити 0)
  backlog 0b 0p повторни опити 0
   1024 потока (1021 неактивни, 0 ограничени)
   0 gc, 0 highprio, 0 ограничени, 464545 flows_plimit
«464545 flows_plimit» е пакетите, които са изпуснати поради превишаване на лимита на опашката на едно съединение, а «dropped 464545» е сумата на всички пропуснати пакети от този шедулър. След увеличаване на дължината на опашката до 1000 и рестартиране на контейнерите, проблемът престана да се проявява. Може да се отпуснете в стола и да изпиете смузи.
FragmentSmack/SegmentSmack. Последна кръв
Първо, след няколко месеца след анонса на уязвимостите в ядрото, най-накрая се появи фикс за FragmentSmack (да припомня, че заедно с анонса през август излезе фикс само за SegmentSmack), което даде шанс да се откажем от Workaround, който ни създаде доста неприятности. Част от сървърите в това време вече бяхме успели да преместим на новото ядро, и сега трябваше да започнем отначало. Защо обновявахме ядрото, без да чакаме фикса за FragmentSmack? Фактът е, че процесът на защита от тези уязвимости съвпадна (и се слея) с процеса на обновление на самия CentOS (което отнема още повече време, отколкото просто обновление на ядрото). Освен това SegmentSmack е по-опасна уязвимост, а фикс за него се появи веднага, така че имаше смисъл във всеки случай. Въпреки това, просто да обновим ядрото на CentOS не можехме, защото уязвимостта FragmentSmack, която се появи по времето на CentOS 7.5, беше поправена само във версия 7.6, затова се наложи да спрем обновлението до 7.5 и да започнем всичко отначало с обновление до 7.6. И така също се случва.
На второ място, върнаха се редки оплаквания от потребители за проблеми. Вече знаем със сигурност, че всички те са свързани с аплодирането на файлове от клиенти на някои наши сървъри. Като че ли през тези сървъри минаваше много малко количество аплодирания от общата маса.
Както помним от разказа по-горе, откатът на Sysctl не помогна. Помогна само reboot, но временно.
Заподозренията относно Sysctl не бяха свалени, но този път беше необходимо да се събере колкото се може повече информация. Освен това много не ни достигаше възможността да възпроизведем проблема с аплода на клиента, за да проучим по-точно какво става.
Анализът на наличната статистика и логове не ни доближи до разбирането на случващото се. Остро ни липсваше възможността да възпроизведем проблема, за да можем да „пипнем“ конкретната връзка. Накрая, на разработчиците от специалната версия на приложението успяха да постигнат стабилно възпроизвеждане на проблемите на тестово устройство при свързване през Wi-Fi. Това стана пробив в разследването. Клиентът се свързваше с Nginx, който проксирваше към бекенда, който беше нашето приложение на Java.
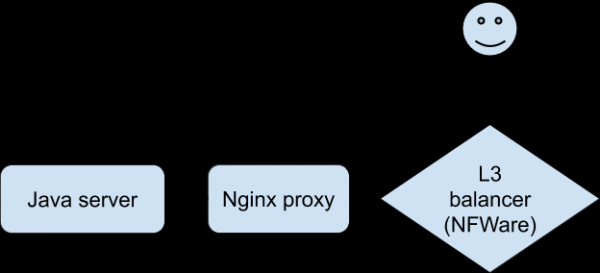
Диалогът при проблеми беше такъв (засечен от страна на Nginx-прокси):
- Клиент: запитване за получаване на информация за доливане на файл.
- Java-сървър: отговор.
- Клиент: POST с файла.
- Java-сървър: грешка.
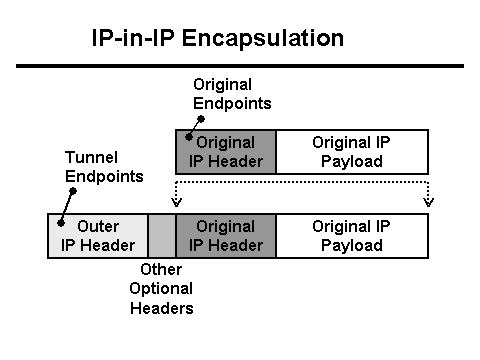
Java-сървърът в същото време пише в логовете, че от клиента е получено 0 байта данни, а Nginx-прокси — че запитването е отнело повече от 30 секунди (30 секунди — това е времето на таймаута на клиентското приложение). Защо тогава таймаут и защо 0 байта? От гледна точка на HTTP всичко работи както трябва, но POST с файла сякаш изчезва от мрежата. И то изчезва между клиента и Nginx. Време е да се въоръжим с Tcpdump! Но първо трябва да разберем конфигурацията на мрежата. Nginx-прокси стои зад L3-балансировчик. . Използва се тунелиране за доставка на пакети от L3-балансировчика до сървъра, което добавя свои хидери в пакетите:
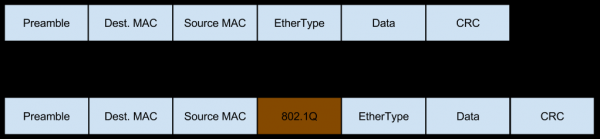
При това мрежата до този сървър постъпва под формата на Vlan-теглиран трафик, който също добавя свои полета в пакетите:
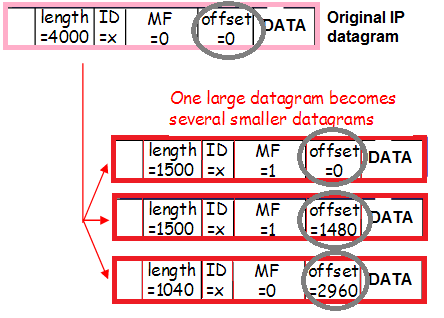
А освен това този трафик може да бъде фрагментиран (този малък процент входящ фрагментиран трафик, за който говорехме при оценка на рисковете от Workaround), което също променя съдържанието на хидерите:
Още веднъж: пакетите са инкапсулирани в Vlan-тег, инкапсулирани в тунел, фрагментирани. За да разберем по-добре как става това, ще проследим маршрута на пакета от клиента до Nginx-прокси.
- Пакетът попада на L3-балансировчика. За правилна маршрутизация вътре в дата центъра пакетът се инкапсулира в тунел и се изпраща към мрежовата карта.
- Тъй като пакетът + хидерите на тунела не влизат в MTU, пакетът се разделя на фрагменти и се изпраща в мрежата.
- Свитчът след L3-балансировчика при получаване на пакета добавя Vlan-тег и го изпраща нататък.
- Комутатор преди Nginx прокси вижда (според настройките на порта), че сървърът очаква Vlan инкапсулиран пакет, затова го изпраща, както е, без да премахва Vlan етикета.
- Linux получава фрагменти от отделни пакети и ги сглобява в един голям пакет.
- След това пакетът попада на Vlan интерфейса, където от него се сваля първият слой — Vlan инкапсулирането.
- След това Linux го изпраща на Tunnel интерфейса, където от него се сваля още един слой — Tunnel инкапсулирането.
Сложността е да се предадат всичките тези данни под формата на параметри в tcpdump.
Да започнем от края: има ли чисти (без излишни заглавия) IP пакети от клиентите, от които е свалено vlan и tunnel инкапсулирането?
tcpdump host
Не, такива пакети на сървъра нямаше. Следователно, проблемът трябва да е по-рано. Има ли пакети с паднало само Vlan инкапсулиране?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx — това е IP адресът на клиента в hex формат.
32:4 — адресът и дължината на полето, в което е записан SCR IP в Tunnel пакета.
Адресът на полето беше подбран на случаен принцип, тъй като в интернет пише за 40, 44, 50, 54, но там IP адреси нямаше. Може също да се погледне един от пакетите в hex (параметр -xx или -XX в tcpdump) и да се изчисли, по какъв адрес известният ви IP.
Има ли фрагменти от пакети без свалено Vlan и Tunnel инкапсулиране?
tcpdump ((ip[6:2] > 0) and (not ip[6] = 64))
Тази магия ще ни покаже всички фрагменти, включително последния. Вероятно и по IP може да се направи филтриране, но не опитвах, тъй като такива пакети не са много и в общия поток лесно намерих нужните ми. Ето ги:
14:02:58.471063 В 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), дължина 1516: (tos 0x0, ttl 63, id 53652, offset 0, флагове [+], протокол IPIP (4), дължина 1500)
     11.11.11.11 > 22.22.22.22: truncated-ip - 20 байта липсват! (tos 0x0, ttl 50, id 57750, offset 0, флагове [DF], протокол TCP (6), дължина 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Флагове [.], seq 0:1448, ack 1, win 343, опции [nop,nop,TS val 11660691 ecr 2998165860], дължина 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 ако..MM.*........
14:02:58.471103 В 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), дължина 62: (tos 0x0, ttl 63, id 53652, offset 1480, флагове [none], протокол IPIP (4), дължина 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
Това са два фрагмента от един пакет (еднакъв ID 53652) с изображение (вижда се думата Exif в първия пакет). Поради факта, че на това ниво пакети има, а в сглобен вид в дамповете — няма, проблемът явно е със сглобяването. Накрая това получава документално потвърждение!
Декодерът на пакети не откри никакви проблеми, пречещи на сглобяването. Опитах тук: . Първо, при опит да се качи нещо там, декодерът не харесва формата на пакета. Оказа се, че имаше две излишни октети между Srcmac и Ethertype (неотнасящи се за информацията за фрагментите). След тяхното премахване декодерът заработи. Въпреки това, не показа никакви проблеми.
Каквото и да правим, освен същите Sysctl, не намерихме нищо друго. Оставаше да намерим начин за идентифициране на проблемните сървъри, за да разберем мащаба и да вземем решение за последващи действия. Доста бързо намерих необходимия брояч:
netstat -s | grep "packet reassembles failed”
Той също е наличен в snmpd под OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
«Броят на неуспехите, открити от алгоритъма за повторно сглобяване на IP (по каквато и да е причина: изтекъл срок, грешки и т.н.)».
Сред групата сървъри, на които се изследваше проблемът, на два този брояч се увеличаваше по-бързо, на два — по-бавно, а на още два изобщо не се увеличаваше. Сравнението на динамиката на този брояч с динамиката на HTTP грешки на Java сървъра разкри корелация. Тоест, броячът можеше да бъде включен в мониторинга.
Наличието на надежден индикатор за проблемите е изключително важно, за да можем точно да определим дали откатът на Sysctl помага, тъй като от предишния разказ знаем, че това не може да бъде разбрано веднага по приложението. Този индикатор би позволил да се открият всички проблемни места в продукцията, преди потребителите да ги забележат.
След отката на Sysctl, мониторинговите грешки спряха, така че причината за проблемите беше доказана, както и че откатът помага.
Ние откатихме настройките за фрагментация на други сървъри, където се включи нов мониторинг, а някъде под фрагменти дори бяха отделили повече памет, отколкото беше по подразбиране преди това (това беше UDP статистика, частичното загубване на която не беше забележимо на фона на общото).
Най-важните въпроси
Защо на L3 балансьора фрагментираме пакетите? Повечето пакети, които идват от потребителите към балансьорите, са SYN и ACK. Размерите на тези пакети са малки. Но тъй като процентът на такива пакети е много голям, не забелязахме наличието на по-големи пакети, които започнаха да се фрагментират.
Причината стана счупеният конфигурационен скрипт на сървъри с Vlan-интерфейси (със сървъри с тагиран трафик в продукция по това време имаше много малко). Advmss позволява да се предаде на клиента информация, че пакетите в нашата посока трябва да бъдат с по-малък размер, за да не се наложи да се фрагментират след прикрепването на заглавията на тунела.
Защо откатът на Sysctl не помогна, а рестартът помогна? Откатът на Sysctl променяше обема на паметта, достъпна за свързването на пакетите. При това, изглежда, самият факт на пренаселената памет за фрагменти водеше до забавяне на връзките, което съответно водеше до дълго задържане на фрагменти в опашката. Тоест процесът се зацикляше.
Рестартът нулираше паметта и всичко си идваше на мястото.
Можеше ли да се мине без Workaround? Да, но има голям риск да оставим потребителите без услуга в случай на атака. Разбира се, приложението на Workaround в резултат доведе до различни проблеми, включително забавяне на един от сервисите при потребителите, но все пак смятаме, че действията бяха оправдани.
Искрени благодарности на Андрей Тимофеев () за помощта в провеждането на разследването, както и на Алексей Кремьов () — за титаничната работа по актуализирането на Centos и ядрото на сървърите. Процес, който в този случай се наложи няколко пъти да започваме отначало, поради което той се удължи с много месеци.
Източник: habr.com
