

С увеличаващото се изчерпване на IPv4 адресите, много телекомуникационни оператори се сблъскват с необходимостта да организират достъпа на своите клиенти до мрежата чрез транслация на адреси. В тази статия ще обясня как може да се постигне производителност на ниво Carrier Grade NAT на commodity сървъри.
Малко история
Темата за изчерпването на адресното пространство IPv4 вече не е нова. В определен момент в RIPE се появиха опашки за адреси (waiting list), след което възникнаха борси, на които се търгуваха блокове адреси и се сключваха сделки за тяхната наемане. Постепенно операторите започнаха да предлагат интернет услуги чрез транслация на адреси и портове. Някои не успяха да получат достатъчно адреси, за да предоставят „бял“ адрес на всеки абонат, докато други започнаха да икономисват средства, отказвайки се от покупката на адреси на вторичния пазар. Производителите на мрежово оборудване подкрепиха тази идея, тъй като тази функционалност обикновено изисква допълнителни разширителни модули или лицензи. Например, при Juniper в гейминга на рутерите MX (освен последните MX104 и MX204), NAPT може да бъде извършен на отделна сервизна карта MS-MIC, при Cisco ASR1k е необходима лицензия CGN license, а при Cisco ASR9k — отделен модул A9K-ISM-100 и лицензия A9K-CGN-LIC за него. Общо взето, удоволствието струва немалко пари.
IPTables
Задачата за извършване на NAT не изисква специализирани изчислителни ресурси, тя може да бъде решена от обикновени процесори, които са инсталирани, например, в един домашен рутер. На ниво телеком оператор, тази задача може да бъде решена, използвайки commodity сървъри с FreeBSD (ipfw/pf) или GNU/Linux (iptables). Няма да разглеждаме FreeBSD, тъй като отдавна съм се отказал от ползването на тази ОС, така че ще се спрем на GNU/Linux.
Включването на транслацията на адреси не е сложно. Първо, необходимо е да запишете правило в iptables в таблицата nat:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
Операционната система ще зареди модула nf_conntrack, който ще следи за всички активни връзки и ще извършва необходимите преобразувания. Има няколко нюанса. Първо, тъй като става дума за NAT на ниво телекомуникационен оператор, е необходимо да се коригират таймаутите, защото с подразбиращите се стойности размерът на таблицата за преобразувания бързо ще нарасне до катастрофални размери. По-долу е пример за настройки, които използвах на моите сървъри:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
И второ, тъй като по подразбиране размерът на таблицата за преобразувания не е проектиран за работа на ниво телекомуникационен оператор, той трябва да бъде увеличен:
net.netfilter.nf_conntrack_max = 3145728
Също така е необходимо да се увеличи и броят на buckets за хеш-таблицата, съхраняваща всички преобразувания (това е опция на модула nf_conntrack):
options nf_conntrack hashsize=1572864
След тези прости манипулации се получава напълно работеща конструкция, която може да трансформира голямо количество клиентски адреси в пул от външни. Въпреки това, производителността на това решение оставя желателна. В своите първи опити за използване на GNU/Linux за NAT (около 2013 г.) успях да постигна производителност около 7Gbit/s при 0.8Mpps на един сървър (Xeon E5-1650v2). Оттогава в мрежовия стек на ядрото на GNU/Linux бяха направени много различни оптимизации, производителността на един сървър на същото оборудване нарасна практически до 18-19 Gbit/s при 1.8-1.9 Mpps (това бяха крайни стойности), но нуждата от обема на трафика, обработван от един сървър, нарасна много по-бързо. В крайна сметка бяха разработени схеми за баланс на натоварването на различни сървъри, но всичко това увеличи сложността на настройката, поддръжката и поддържането на качеството на предоставяните услуги.
NFTables
В момента модното направление в програмирането на „прехвърляне на пакети“ е използването на DPDK и XDP. По тази тема са написани много статии, направени са различни презентации и се появяват търговски продукти (например, СКАТ от VasExperts). Но в условията на ограничени ресурси на програмистите при операторите на свързаност, създаването на собствена „изработка“ на базата на тези структури е доста проблематично. Последващото експлоатиране на такова решение ще бъде много по-трудно, особено ще се наложи разработването на диагностични инструменти. Например, стандартният tcpdump с DPDK просто няма да заработи, а пакети, изпратени обратно в проводниците с помощта на XDP, няма да бъдат „видени“. На фона на всичките разговори за нови технологии за предаване на пакети в потребителското пространство, остана незабелязано и Пабло Нейра Айусо, поддържащия iptables, за разработването на flow offloading в nftables. Нека разгледаме този механизъм по-подробно.
Основната идея е, че ако рутерът е пропуснал пакети от една сесия в двете посоки на потока (TCP сесията е преминала в състояние ESTABLISHED), няма нужда да пропускаме последващите пакети от тази сесия през всички правила на firewall, тъй като всички тези проверки все пак ще завършат с предаване на пакета към рутинга. И също така, изборът на маршрут не е необходим — вече знаем в кой интерфейс и на кой хост да прехвърлим пакетите в рамките на тази сесия. Остава само да запазим тази информация и да я използваме за маршрутизиране на ранния етап на обработка на пакета. При изпълнение на NAT е необходимо допълнително да се запази информацията за промените в адресите и портовете, преобразувани от модула nf_conntrack. Да, разбира се, в този случай спират да работят различни полисери и други информационно-статистически правила в iptables, но в рамките на задачата на отделен NAT или, например, бордера — това не е толкова важно, тъй като услугите са разпределени по устройствата.
Конфигурация
За да се възползваме от тази функция, трябва да:
- Използваме ново ядро. Въпреки че самият функционал се появи още в ядрото 4.16, доста дълго време той беше много „несъвършен“ и редовно предизвикваше kernel panic. Всичко се стабилизира около декември 2019 година, когато излязоха LTS ядрата 4.19.90 и 5.4.5.
- Препишете правилата на iptables в формат nftables, използвайки достатъчно нова версия на nftables. Работи точно в версия 0.9.0
Ако с първата точка всичко е в основни линии ясно, важно е да не забравите да включите модула в конфигурацията при компилация (CONFIG_NFT_FLOW_OFFLOAD=m), то втората точка изисква допълнителни обяснения. Правилата на nftables се описват съвсем по-различен начин от iptables. разкрива практически всички моменти, има и специализирани направила от iptables в nftables. Затова ще посоча само пример за настройка на NAT и flow offload. Небольшая легенда за примера: <i_if>, <o_if> — това са мрежовите интерфейси, през които преминава трафик, в действителност може да има повече от две. <pool_addr_start>,<pool_addr_end> — началният и крайният адрес на диапазона на "белите" адреси.
Конфигурацията на NAT е много проста:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
С flow offload е малко по-сложно, но напълно разбираемо:
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
Ето, собствено, и цялата настройка. Сега целият TCP/UDP трафик ще попада в таблицата fastnat и ще се обработва много по-бързо.
Резултати
За да стане ясно колко "по-бързо" е това, ще приложа скрийншот на натоварването на два реални сървъра, с идентична конфигурация (Xeon E5-1650v2), еднакво настроени, използващи едно и също ядро на Linux, но изпълняващи NAT в iptables (NAT4) и в nftables (NAT5).
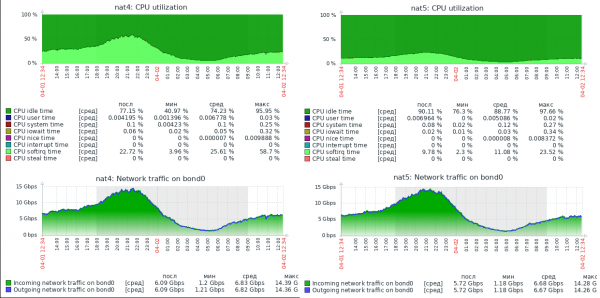
На скрийншота няма график на пакетите в секунда, но в профила на натоварванията на тези сървъри средният размер на пакета е около 800 байта, затова стойностите достигат до 1.5Mpps. Както се вижда, производителността на сървера с nftables е огромна. В момента този сървър обработва до 30Gbit/s при 3Mpps и определено може да достигне физическото ограничение на мрежата от 40Gbps, като същевременно има свободни ресурси на CPU.
Надявам се, че този материал ще бъде полезен на мрежовите инженери, опитващи се да подобрят производителността на своите сървъри.
Източник: habr.com
