

Capacity Tier (или както го наричаме вътре в Veeam – каптир) се появи още по времето на Veeam Backup and Replication 9.5 Update 4 под името Archive Tier. Идеята, заложена в него, е да се даде възможност за преместване на бекъпи, които са извън т. нар. operational restore window, в обектни хранилища. Това помагаше за освобождаване на дисково пространство на онези потребители, които го имаха в ограничени количества. Тази опция се нарича Move Mode.
За да се извърши това несложно (както изглежда) действие, е необходимо да се спазят два условия: всички точки от преместваемия бекъп трябва да са извън гореспоменатия operational restore window, който се задава явно в потребителския интерфейс. И второ: верижката трябва да бъде в т. нар. «запечатан вид» (sealed backup chain или Inactive Backup Chain). Тоест с течение на времето в тази верига не се извършват промени.
Но в VBR v10 концепцията се допълни с нови функции – появиха се Copy Mode, Sealed Mode и концепцията с трудно произносимото име Immutability.
Тук именно за тези интересни неща ще говорим днес. Първо за това, как работеше в VBR9.5u4, а след това за промените в десетата версия.
И да ме простят защитниците на чистия език, но прекалено много термини не могат да се преведат.
Така че тук ще има много англицизми.
И много гифки.
И картинки.
- Без ни най-малко съжаление. Авторът на статията.
Как беше
Ну добре, започваме с разглеждането на operational restore window и sealed backup (или както ги наричат в документацията Inactive Backup Chain). Без тяхното разбиране по-нататъшното обяснение няма да е възможно.
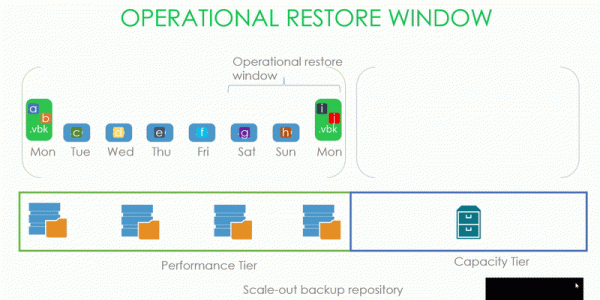
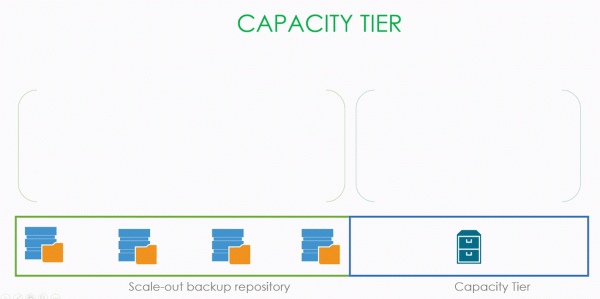
Както виждаме на картинката, имаме някаква бекъп верига с блокове данни, която е разположена на Performance tier SOBR репозитория, свързан с Capacity Tier. Нашето операционно бекъпно прозорец е равно на три дни.
Съответно, създаденият в понеделник .vbk запечатва предишната верига, чийто прозорец е определен за три дни. И, следователно, спокойно може да започнете да пренасочвате в капастийния тир всичко, което е по-старо от тези три дни.
Но какво точно се имаше предвид под запечатаната верига и какво можеше да бъде изпратено в капастийния тир в update 4?
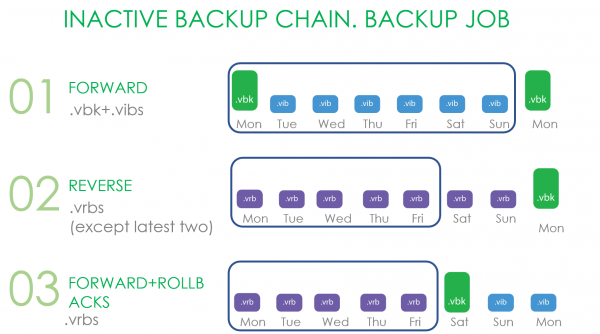
За Forward Incremental признак за запечатване на верига е създаването на нов фул бекъп. И няма значение как се получава този фул бекъп: считат се както синтетичните, така и активните фул бекъпи.
В случай на Reverse, това са всички файлове, които не попада в операционното прозорец.
В случай на Forward increment с роллбеками, всички роллбеки и .vbk, ако на перфоманс екстенте има още един .vbk
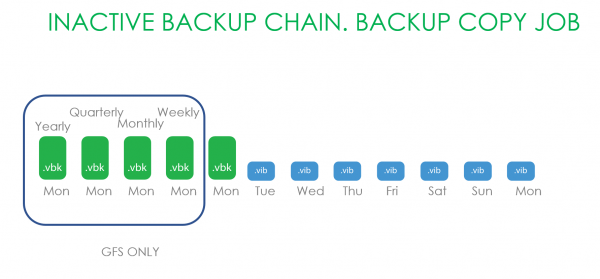
Сега нека разгледаме варианта на работа с Backup Copy вериги. Тук беше предоставяно само това, което попада под GFS задържане. Защото всичко, което се съхранява в по-новите Backup Copy вериги, може да бъде по един или друг начин променено.
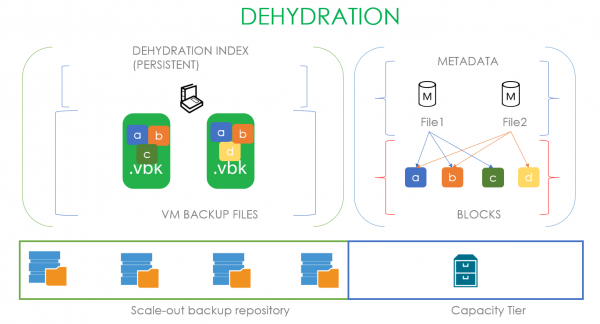
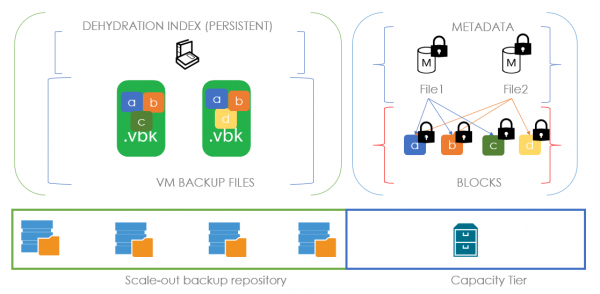
Сега да погледнем под капака. Там се извършва процес, наречен дегидратация - оставяне на празни резервни файлове на екстента и прехвърляне на блокове от тези файлове на капасити тир. За оптимизация на този процес се използва така нареченият индекс на дегидратация, който позволява да не се копират блокове, които вече са били копирани в капасити тир.
Нека разгледаме как изглежда това на пример: да предположим, че имаме .vbk, излязъл извън операционния прозорец и принадлежащ на запечатана верига. Значи, имаме пълното право да го пренесем в капасити тир. При преместването се създава файл с метаданни в капасити тира и блоковете на прехвърляния файл. В файла с метаданни на ниво препратки се описва, от какви блокове се състои нашият файл. В случая на изображението, нашият първи файл се състои от блокове a, b, c и в метаданните са разположени препратки към тези блокове. Когато получим втори .vbk файл, готов за преместване и състоящ се от блокове a, b и d, анализирайки индекса на дегидратация, разбираме, че трябва да преместим само блок d. А файлът с метаданни ще съдържа препратки към два предишни блока и един нов.
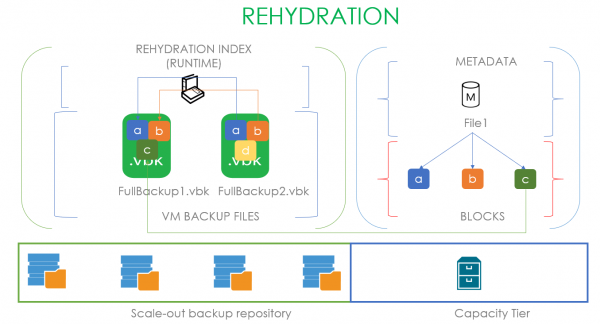
Съответно, процесът на обратно запълване на тези празни места с данни се нарича регидратация. Тук се използва вече собствен индекс на регидратация, базиран на най-стария .vbk файл на локалния перфоманс екстент. Тоест, ако потребителят иска да върне файл от капасити тира, първо създаваме индекс на блоковете на най-стария пълен бекъп и прехвърляме от капасити тира само липсващите блокове. В случая, представен на изображението, за да регидрираме FullBackup1.vbk според индекса на регидратация, ни липсва само блок С, който взимаме от капасити тира. Ако капасити тирът е облачен обект за съхранение, това позволява значителни спестявания.
Тук може да изглежда, че тази технология е идентична на използваната в WAN ускорители, но всъщност не е така. В ускорителите дедупликацията е глобална, докато тук се използва локална в рамките на всеки файл по определен офсет. Това се дължи на разликата в решаваните задачи: тук трябва да копираме големи файлове с пълни резервни копия и според нашите изследвания, дори ако между тях има дълъг период от време, такъв алгоритъм за дедупликация дава най-добри резултати.
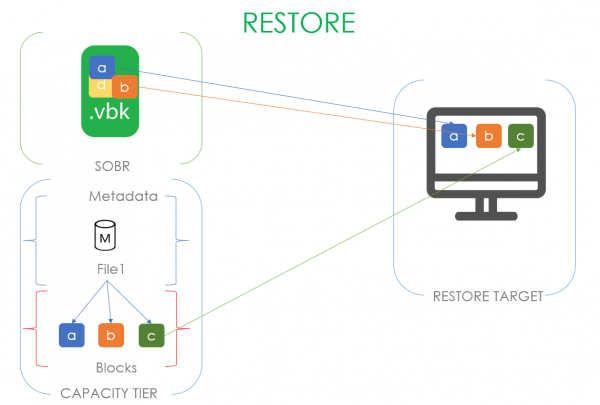
Но повече индекси на бога на индексите! Има още и индекс за възстановяване на данни! Когато стартираме възстановяване на машина, разположена в капацитетен тир, ще четем само уникалните блокове данни, които не са налични в производствения тир.
Както стана
На това с въведението всичко. То е доста подробно, но, както беше казано по-горе, без тези подробности не можем да обясним как работят новите функции. Затова, без излишни предисловия, преминаваме към първото.
Режим на копиране
Въз основа на съществуващите технологии, той обаче носи съвсем различна логика на използване.
Целта на този режим е да гарантира, че всички данни, разположени на локалния екстент, имат копие в капацитетния тир.
Ако сравним директно режимите Move и Copy, се получава следното:
- Може да се мести само запечатана верига. В случая на режима за копиране се прехвърля абсолютно всичко, независимо от това, какво става в резервната работа.
- Прехвърлянето сработва, когато файловете излязат извън границите на резервното окно, а копирането сработва веднага, щом се появи резервен файл.
- Проследяването на нови данни за копиране става постоянно, а за прехвърляне сработва на всеки 4 часа.
При разглеждането на новия режим предлагам да преминем от прости примери към сложни.
В най-простия случай просто се появяват нови файлове с инкременти и ние просто ги копираме в капацитетния тир. Независимо от режима, използван в резервната работа, независимо от факта, че принадлежи на запечатаната част на веригата или не, независимо от това дали нашето оперативно окно е изтекло. Просто взехме и копирахме.
Процесът, който стои зад това, остава дегидратация в същата форма, описана по-горе. В режим копиране той също следи да не копираме блокове, които вече са на нашето обектно хранилище. Единствената разлика е, че в режим преместване заменяхме реални файлове с файлове с нулево съдържание, докато тук не ги пипаме и оставяме всичко както е. В противен случай, това е точно такъв индекс на дегидратация, който старателно се опитва да спести вашите пари и време.
Възниква въпросът — ако погледнем в интерфейса, там има възможност да изберем и двете опции едновременно. Как ще работи този комбиниран режим?
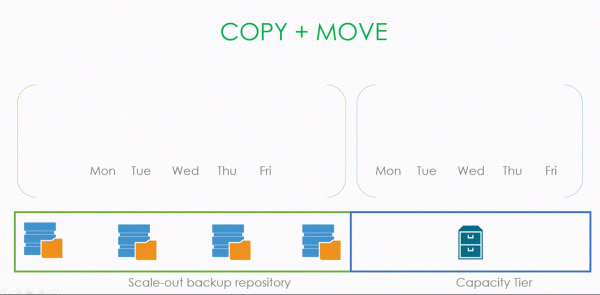
Нека разберем.
Започваме стандартно: създава се файл за резервно копие и веднага се копира. Към него се създава инкремент и също се копира. Това продължава, докато не разберем, че файловете са излезли от нашия оперативен прозорец и е възникнала печатна верига. В този момент изпълняваме операция на дегидратация и заменяме тези файлове с файлове с нулево съдържание. Разбира се, повторно на капасити тир нищо не копираме.
Цялата тази увлекателна логика се свежда до една единствена отметка в интерфейса: Copy backups to object storage as soon as they are created.
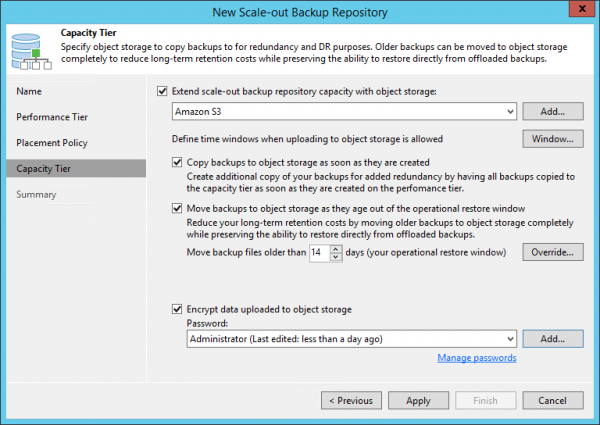
А защо ни е този режим на копиране?
Дори по-добре да преформулираме въпроса — от какви рискове се закриляне с него? Каква проблема помага да решим?
Отговорът е очевиден: разбира се, че е възстановяване на данни. Ако имаме пълно копие на локалните данни в обектното хранилище, не е важно какво се случва с нашето прод, винаги можем да възстановим данните от файловете, разположени в условното амазон.
Така че да разгледаме възможните сценарии, от най-простия до по-сложния.
Най-простата беда, която може да се стовари на главата ни — е недостъпността на един от файловете в резервната верига.
По-печална история е, ако сме загубили един от екстентите на нашето SOBR хранилище.
Още по-лошо става, когато цялото SOBR хранилище стане недостъпно, но капасити тир работи.
И съвсем всичко е зле — е когато умира резервният сървър и първото ти желание е да пробваш да достигнеш канадската граница за десет минути.
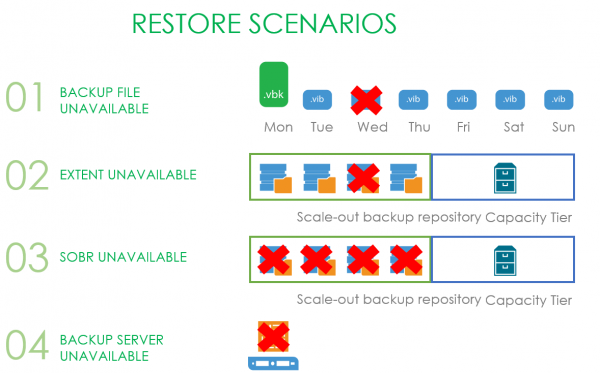
А сега нека разгледаме всяка ситуация поотделно.
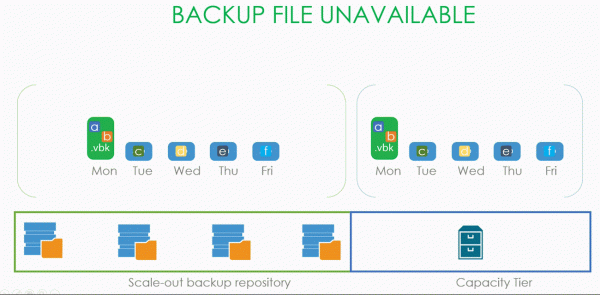
Когато загубим един (да, нека бъде дори няколко) бекъп файлове, ще е достатъчно да стартираме процеса на наново сканиране на репозитория и загубеният файл ще бъде заменен с файл-празна стойност. А с помощта на процеса на регидратация (за който беше споменато в началото на статията), потребителят ще може да изтегли данни от капасити тира в локалното хранилище.
Сега ситуацията е по-сложна. Да предположим, че нашият SOBR се състои от два екстента, работещи в режим Performance, което означава, че нашите .vbk и .vib са разпределени по тях с доста неравномерен слой. И в определен момент един от екстентите става недостъпен, а на потребителя му е необходимо спешно да възстанови машина, част от данните на която се намират именно на този екстент.
Потребителят стартира майстора за възстановяване, избира точката, до която иска да възстанови, и в процеса на работа, майсторът осъзнава, че нямат всички необходими данни за възстановяване локално и следователно трябва да ги изтегли от капасити тира. При това блоковете, които са останали на локалното хранилище, няма да се изтеглят от облака. Слава на restore индекса (да, и за него също беше споменато в началото на статията).
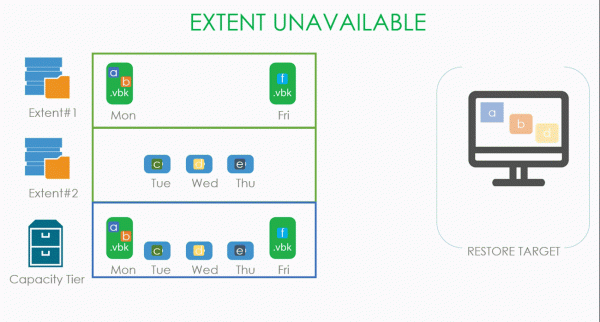
Подвид на този случай — изцяло недостъпен е SOBR репозитория. В такъв случай нямаме какво да копираме от локалните хранилища и всички блокове се изтеглят от облака.
И най-интересната ситуация — бекъпният сървър е умрял. Тук има два варианта: администраторът е свършил работа и е правил конфигурационни бекъпи, или администраторът сам е лошият Буратино и не е правил конфигурационен бекъп.
В първия случай му е достатъчно просто някъде да разположи чиста инсталация на VBR и да възстанови базата си от бекъп с помощта на стандартните средства. В завършек на този процес всичко ще се върне на старото си място. Или ще бъде възстановено по един от сценарите по-горе.
Но ако администраторът е враг на себе си или резервното копие на конфигурацията е претърпяло обичайната неуспех, даже и тук няма да го оставим на произвола на съдбата. За този случай сме въвели нова процедура, която се казва Import Object Storage. Тя позволява да пропуснем ръчния процес на възстановяване на SOBR хранилището и свързването му с капасити тиер, последвано от рескан, а просто да добавим обектно хранилище в интерфейса на Вима и да стартираме процедурата Import Storage Repository. Единственото, което може да застане между вас и вашите резервни копия, е искането за въвеждане на парола, ако вашите резервни копия са шифровани.
С това относно Copy Mode, вероятно, е всичко и преминаваме към
Sealed Mode
Основната идея е, че на избрания екстент на SOBR хранилището не могат да се появяват нови резервни копия. Преди v10 имахме само Maintenance Mode, при който всякаква работа с хранилището е напълно забранена. Той представлява хардкорен режим за изключване на хранилището, при който единствената достъпна опция е Evacuate, която единствено прехвърля резервните копия на друг екстент.
А Sealed mode е своеобразен 'мек' вариант: забраняваме създаването на нови резервни копия и постепенно изтриваме стари в съответствие с избраната ретеншън политика, но в процеса не губим възможността да се възстановим от съхранените точки. Много полезен вариант, когато ни изтичаше срокът на живота на хардуера и трябваше да го заменим, или просто трябваше да освободим място за нещо по-важно, а не можем просто да прехвърлим всичко наведнъж. Или не можем да изтрием.
Съответно, принципът на работа е доста прост: трябва да забраним всички write операции (появяване на нови данни), оставяйки read (възстановявания) и delete (ретеншън).
И двата режима могат да се използват едновременно, но е важно да се отчита, че Maintenance има по-висок приоритет.
Като пример, нека разгледаме SOBR, състоящ се от два екстента. Да предположим, че в първите четири дни създавахме резервни копия в режим Forward Forever Incremental, а след това запечатваме екстента. Това води до иницииране на създаване на нов ектив фул на втория наличен екстент. Ако нашата ретеншън политика е четири, когато цялата верига, разположена на запечатания екстент, излезе извън него, тя с добра съвест се изтрива.
Има ситуации, когато изтриването става по-рано. Например, това е Forward incremental с периодични фул бекъпи. Ако през първите два дни създадохме фул бекъпи, а в четвъртък решаваме да затворим репозитория, то в петък, когато ще бъде създаден нов фул, файлът за понеделник ще бъде изтрит, тъй като до тази точка няма зависимости. И самата точка не зависи от никого. След това изчакваме да бъдат създадени четири точки на достъпния екстент и изтриваме останалите три, които не могат да бъдат изтрити независимо една от друга.
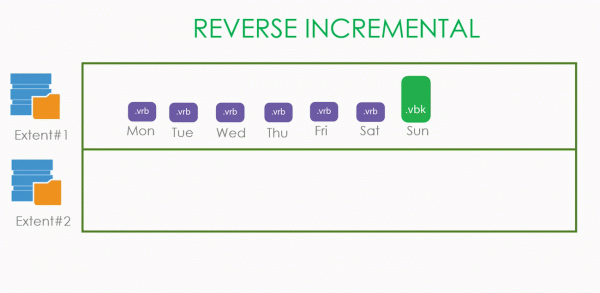
По-просто е с Reverse Incremental. В него най-старите точки не зависят от нищо и могат спокойно да бъдат изтрити. Затова, щом бъде създаден нов .vbk на новия екстент, старите .vrb ще бъдат изтривани една по една.
Между другото, защо всеки път създаваме нов .vbk: ако не го създаваме, а продължаваме старата верига на инкременти, старият .vbk ще остане за безкрайно дълго време в какъвто и да е режим, като пречи на неговото изтриване. Затова беше взето решението, че щом се затвори екстент, създаваме фул бекъп на свободния екстент.
По-сложни са нещата с капасити тира.
Първо ще разгледаме copy mode. Да предположим, че четири дни активно сме създавали бекъпи, а след това капасити тирът е бил затворен. Ние не изтриваме нищо, а търпеливо спазваме ретеншън периода, след което изтриваме данните от капасити тира.
При move mode става нещо подобно — изчакваме ретеншън, изтриваме старото в локалното хранилище, изтриваме съхраняваното в обектния сторидж.
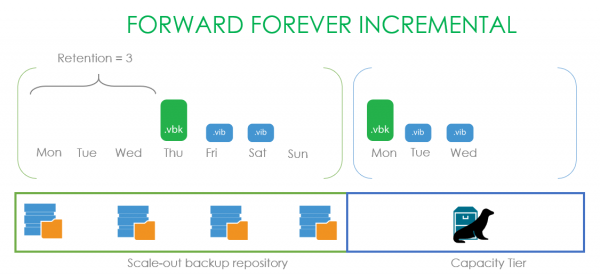
Интересен пример с Forever forward incremental. Установяваме ретеншън на три точки и започваме от понеделник да правим бекъпи, които коректно се копират в облака. След затваряне на хранилището, бекъпите продължават да се създават, спазвайки три точки, но данните, съхранявани в капасити тира, остават зависими и не могат да бъдат изтрити. Затова изчакваме четвъртък, когато нашият .vbk излиза извън рамките на ретеншн, и едва тогава спокойно изтриваме цялата запазена верига.
И малка уговорка: всички примери тук са показани с една машина. Ако имате няколко в бекъпа, тогава ретеншънът при тях ще се различава в зависимост от това дали е направен Active Full или не.
Това е всичко. Така че преминаваме към най-хардкорната функция —
Immutability
Как и с предишните точки, първо ще обсъдим какъв проблем решава тази функция. Веднага щом изтеглим резервните копия на друго място за съхранение, възниква спешна нужда да гарантираме тяхната безопасност, тоест физически да забраним тяхното изтриване и всяка модификация през зададения период на задържане. Включително от администраторите, включително под техните рут акаунти. Това позволява да ги защитим от случайно или умишлено повреждане. Който работи с AWS, може да се е срещал със подобна функция под името Object Lock.
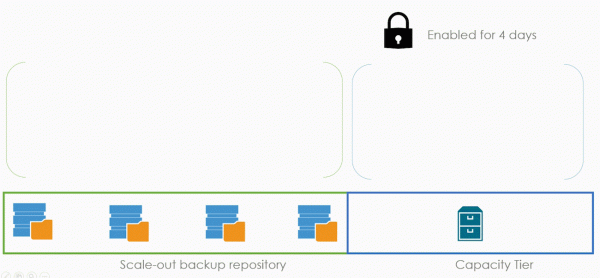
Сега да разгледаме режима в общи линии, а след това да се задълбочим в подробностите. В нашия пример, Immutability ще бъде включен за нашия капацитет с период на задържане от четири дни. А в резервното копие е активиран режим Copy.
Immutability никак не взаимодейства с общия период на задържане. Например, той не добавя допълнителни точки или нещо такова. Просто през четирите дни човек не може да изтрива файловете на резервните копия. Ако в понеделник направим резервно копие, то файлът може да бъде изтрит едва в петък.
Всички преди това обяснени концепции за дегидрация, индекси и метаданни продължават да работят по същия начин. Но с едно условие — блокът се поставя не само за данните, но и за метаданните. Това е направено в случай, че злонамерен нападател реши да изтрие нашата база с метаданни и за да блоковете с данни не се превърнат в безполезна бинарна каша.
И сега настъпи отличен момент да обясним нашата технология за генериране на блокове. Или block generation. За това разгледайте ситуацията, която доведе до нейното появяване.
Нека вземем времева линия от шест дни и отдолу да отбележим времето на очакваното изтичане на immutability. На първия ден създаваме файл, състоящ се от блок данни а, и неговите метаданни. Ако immutability е зададен на три дни, логично е да предположим, че на четвъртия ден данните ще бъдат отключени и изтрити. На втория ден добавяме нов file2, състоящ се от блок b с идентични настройки. Блок а все още трябва да бъде изтрит на четвъртия ден. Но на третия ден се случва нещо ужасно — създава се файл File3, състоящ се от нов блок d и линк към стария блок а. Това означава, че флагът immutability за блок а трябва да бъде пренастроен на нов срок, който се премества на шестия ден. И тук възниква проблем — в реални бекъпи на такива блокове се появява огромно количество. А за да удължим периода на immutability, трябва всеки път да изпращаме огромно количество заявки. Всъщност това ще бъде почти безкраен ежедневен процес, тъй като с голяма вероятност при всяко копиране ще откриваме големи количества дедуплицирани блокове. А какво означава голямо количество заявки от доставчиците на обектни хранилища? Правилно! Огромна сметка в края на месеца.
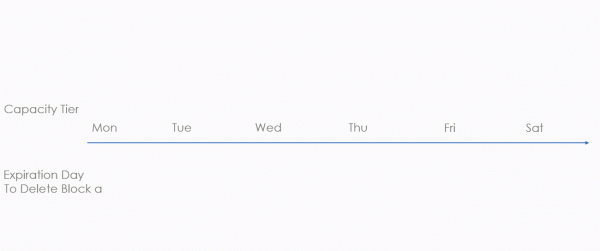
И за да не начисляваме сериозни разходи на любимите си клиенти без причина, бе измислен механизмът за генериране на блокове. Това е допълнителен период, който добавяме към зададения период на immutability. В примера по-долу този период е равен на два дни. Но това е само за пример. В реалността се използва собствена формула, която дава приблизително десет допълнителни дни при месечен локаут.
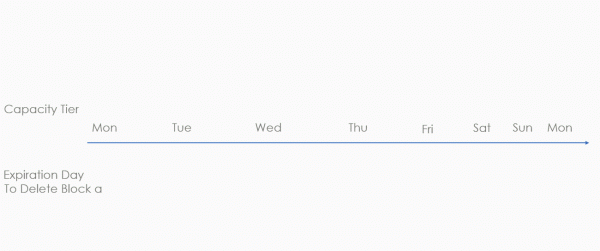
Нека да разгледаме същата ситуация, но с block generation. На първия ден създаваме file1 от блок а и метаданни. Струпваме периода на поколенията и immutability - това означава, че възможността за изтриване на файла ще бъде на шестия ден. Ако на втория ден създадем File2, състоящ се от блок b и връзка към блок а, то с предварително определената дата на изтриване нищо не се случва. Тя остава на шестия ден, както беше. По този начин се опитваме да спестим средства от броя на заявките. Единствената ситуация, в която срокът може да бъде преместен, е ако крайният срок на поколенията е изтекъл. Тоест, ако на третия ден новият File3 съдържа връзка към блок а, то ще бъде добавено generation 2, тъй като Gen1 вече е изтекъл. Очакваната дата на изтриване на блок а ще се измести на осмия ден. Това ни позволява драстично да намалим броя на заявките за удължаване на срока на живот на дедуплицираните блокове, което спестява значителни средства на клиентите.
Самата технология е достъпна за потребителите на S3 и S3-съвместимо оборудване, производителите на което гарантират, че тяхната реализация не се различава отAmazon. Оттук и отговорът на законния въпрос, защо не se поддържа Azure - те имат подобна функция, но тя работи на ниво контейнери, а не на отделни обекти. Между другото, в самия Amazon обект лок е наличен в два режима: compliance и governance. Във втория случай остава възможността, най-великият администратор над администраторите и root над root-овете, независимо от object lock, все още да изтрива данни. В случай на compliance всичко е здраво заковани и резервните копия не могат да бъдат изтрити от никого, дори от администраторите на Amazon (по техните официални изявления). Ние поддържаме именно този режим.
И, традиционно, малко полезни връзки:
- За във всички подробности.
- Цялата информация за в най-добрия вид
- О в детайли
Източник: habr.com
