

Днес съществуват 100500 курса по Data Science и вече е известно, че най-много пари в Data Science може да се спечелят именно от курсовете по Data Science (защо да копаем, когато можем да продаваме лопати?). Основният минус на тези курсове е, че те нямат нищо общо с реалната работа: никой няма да ви предостави чисти, обработени данни в нужния формат. И когато завършите курсовете и започнете да решавате истинска задача — възникват много нюанси.
Затова започваме серия от бележки „Какво може да се обърка с Data Science“, основани на реални събития, случили се с мен, моите приятели и колеги. Ще разгледаме на реални примери типични задачи по Data Science: как всъщност се случва. Днес ще започнем с задачата за събиране на данни.
И първото, в което се спъват хората, когато започнат да работят с реални данни — е собствено събирането на тези съответни данни. Ключовото послание на тази статия:
Систематично подценяваме времето, ресурсите и усилията за събиране, почистване и подготовка на данни.
А най-вече, ще обсъдим какво да правим, за да не позволим това.
Според различни оценки, почистването, трансформацията, data processing, feature engineering и т.н. отнемат 80-90% от времето, а анализът 10-20%, докато практически всичките учебни материали са фокусирани изключително върху анализа.
Нека разгледаме как типичен пример — проста аналитична задача в три варианта и да видим какви могат да бъдат „облекчаващите обстоятелства“.
И за пример отново, ще разгледаме подобни варианти на задача за събиране на данни и сравнение на общности за:
- Два сабреддита в Reddit
- Два раздела в Хабра
- Две групи в Однокласници
Условен подход в теорията
Да отворим сайта и да прочетем примери, ако е разбираемо, да отделим няколко часа за четене, няколко часа за код по примери и отладка. Да добавим няколко часа за събиране. Да накиснем няколко часа за запас (да умножим по два и да добавим N часа).
Ключов момент: времевата оценка се основава на предположения и догадки относно това колко време ще отнеме.
Да започнем анализа на времето е необходимо с оценка на следните параметри за условната задача, описана по-горе:
- Какъв е размерът на данните и колко е нужно физически да се събират (*вижте по-долу*).
- Какво е времето за събиране на една запис и колко време е необходимо да се чака, преди да може да се събере втора.
- Заложете ли написание на код, който запазва състоянието и започва повторно, когато (а не ако) всичко се срине.
- Трябва ли да разберем, дали ни е необходима авторизация и да предвидим времето за достъп през API-то.
- Заложете количество грешки, като функция на сложността на данните — оценете по конкретна задача: структура, колко преобразувания, какво и как ще извлечем.
- Заложете мрежови грешки и проблеми с нетипичното поведение на проекта.
- Оценете, ако нужните функции са в документацията и ако не, то колко време и какво е нужно за обход.
Най-важното е, че за оценка на времето — наистина трябва да отделите време и усилия за „разузнаване“ — само тогас вашето планиране ще бъде адекватно. Затова, каквото и да ви подтикват да кажете „колко време е нужно за събиране на данни“ — дайте си време за предварителен анализ и аргументирайте с това, колко времето ще варира в зависимост от реалните параметри на задачата.
И сега ще демонстрираме конкретни примери, където тези параметри ще се променят.
Ключовият момент: оценката се основава на анализа на ключови фактори, влияещи на обема и сложността на работата.
Оценката, основана на предположения — е добър подход, когато функционалните елементи са сравнително малки и няма много фактори, които да могат да повлияят съществено на структурата на задачата. Но в случая с редица задачи по Data Science, такива фактори стават изключително много и подобен подход става неадекватен.
Сравнение на общностите в Reddit
Започваме с най-простия случай (както после ще се окаже). Всъщност, ако сме искрени, пред нас е почти идеален случай, проверяваме нашия чеклист за сложност:
- Има чист, разбираем и документиран API.
- Изключително лесно, а освен това автоматично се получава токен.
- Има — с куп примери.
- Общността, която се занимава с анализ и събиране на данни в Reddit (включително YouTube видеа, обясняващи как да се използва python wrapper) .
- Нужните методи вероятно съществуват в API. Освен това, кодът изглежда компактен и чист, ето пример за функция, която събира коментари към поста.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Пропущено %d MoreComments (%d коментаря)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Взето от сборник удобни утилити за обвивка.
Въпреки че пред нас е най-добрият случай, все пак трябва да вземем предвид редица важни фактори от реалния живот:
- API лимити — ние сме принудени да взимаме данни на партиди (да почиваме между заявките и т.н.).
- Време за събиране — за пълен анализ и сравнение ще трябва да предвидим значително време просто за паяка да премине през субреддита.
- Ботът трябва да работи на сървъра — не можете просто да го стартирате на лаптоп, да го сложите в раницата и да отидете на работа. Затова стартирах всичко на VPS. С промокод habrahabr10 можете да спестите още 10% от цената.
- Физическа недостъпност на някои данни (те са видими само за администраторите или са твърде трудни за събиране) — това трябва да се вземе предвид, не всички данни могат да се съберат в разумно време.
- Грешки в работата на мрежата: работата с мрежата — това е болка.
- Това са реални живи данни — те не са чисти.
Разбира се, необходимо е да се предвидят изброените нюанси в разработката. Конкретните часове/дни зависят от опита на разработчика или от опита по подобни задачи, все пак виждаме, че задачата е изцяло инженерна и не изисква допълнителни усилия за решаване — всичко може да бъде много добре оценено, написано и направено.
Сравнение на разделите на Хабра
Преминаваме към по-интересния и нестандартен случай за сравнение на потоци и/или раздели на Хабра.
Нека проверим нашия чеклист за сложност — тук, за да разберем всеки пункт, ще трябва да се потопим малко в самата задача и да експериментираме.
- Първоначално си мислите, че има API, но такъв няма. Да-да, Хабра има API, но той е недостъпен за потребителите (или може би изобщо не работи).
- След това просто започвате да парсите html — «import requests», какво може да се обърка?
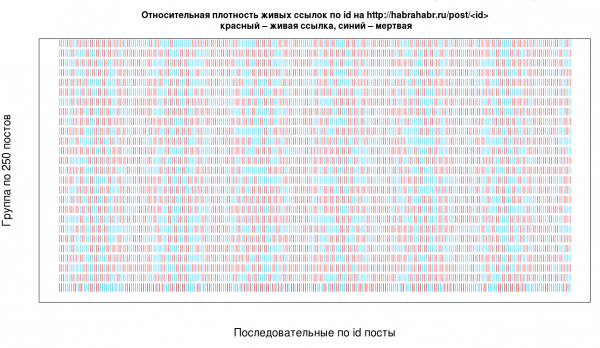
- А как изобщо да парсите? Най-простият и често използван подход — да се итерира по ID, отбелязваме, че не е най-ефективният и ще трябва да се обработват различни случаи — ето за пример плътността на реалните ID сред всички съществуващи.

Взето от статията. - Суровите данни, обвити в HTML върху мрежата — това е проблем. Например, искате да съберете и запазите оценката на статия: изскубвате score от html и решавате да го запазите като число за по-нататъшна обработка:
1) int(score) хвърля грешка: тъй като на Хабр минус, какъвто е, например, в реда "–5" — това е кратко тире, а не знак минус (неочаквано, нали?), затова в някой момент трябваше да активирам парсера с такъв ужасен фикс.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
Датите, плюсовете и минусите може изобщо да липсват (както виждаме по функцията check_date и това се е случвало).
2) Неекранираните специални символи — те ще дойдат, трябва да сте подготвени.
3) Структурата се променя в зависимост от типа пост.
4) Старите постове могат да имат **странна структура**.
- В същността на обработката на грешки и какво може или не може да се случи, ще трябва да обработвате и не можете точно да предскажете какво ще се обърка и каква може да бъде структурата и къде ще се счупи — просто трябва да пробвате и да вземете предвид грешките, които парсерът хвърля.
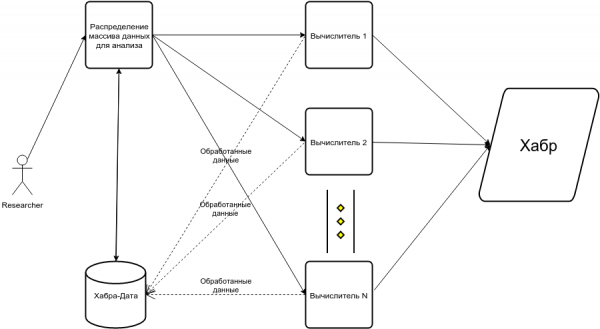
- После осъзнавате, че трябва да парсите в няколко потока, в противен случай парсването в един поток ще отнеме 30+ часа (това е само времето за изпълнение на работещия еднопоточен парсер, който спи и не попада под никакви бани). В статията, това отведе в някой момент до подобна схема:
Общо взето, списъкът с проверки за сложност:
- Работа с мрежата и парсинг на html с итерация и обхождане по ID.
- Документите имат нееднородна структура.
- Много места, където кодът може лесно да се срине.
- Необходимо е да пишете || код.
- Липсва необходимата документация, примери за код и/или общност.
Условната оценка на времето за тази задача ще бъде 3-5 пъти по-висока, отколкото за събиране на данни от Reddit.
Сравнение на групи в Одноклассники
Да преминем към най-технически интересния случай от описаните. За мен той беше интересен именно заради това, че на пръв поглед изглежда доста тривиално, но изобщо не е такъв — веднага щом го натиснете с пръчка.
Ще започнем с нашия списък с проверки за сложност и ще отбележим, че много от тях ще се окажат много по-сложни, отколкото изглеждат в началото:
- API има, но в него почти напълно липсват необходимите функции.
- За определени функции трябва да молите за достъп по имейл, т.е. предоставянето на достъп не е моментално.
- Той е ужасно документиран (да започнем с това, че навсякъде се смесват руски и английски термини, и то абсолютно непоследователно — понякога трябва просто да познаеш какво искат от теб), и освен това не е подходящ по дизайн за извличане на данни, например, .
- Изисква сесия в документацията, а всъщност не я използва — и няма начин да разбереш всичките нюанси на API режимите, освен да опитваш и да се надяваш, че нещо ще работи.
- Липсват примери и общност, единствената точка за информация е малък на Python (без много примери за употреба).
- Най-работещият вариант изглежда е Selenium, тъй като много от необходимите данни са защитени.
1) Тоест авторизацията става чрез фиктивен потребител (и ръчна регистрация).2) Въпреки това с Selenium няма гаранции за коректна и повтаряема работа (в случая с ok.ru определено).
3) Сайтът Ок.ру съдържа JavaScript грешки и понякога се държи странно и непос последователно.
4) Нужно е да се занимаваш с пагинация, зареждане на елементи и т.н.…
5) Грешките на API, които предоставя wrapper-a, трябва да се обработват хакерски, например, по следния начин (парче експериментален код):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#има смисъл да се следят вече обработените дискусии
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Любимата ми грешка беше:
OdnoklassnikiError("Грешка(code: 'None', описание: 'HTTP грешка', метод: 'discussions.getComments', параметри: …)")6) В крайна сметка вариантът Selenium + API изглежда най-разумният.
- Необходимо е запазване на състоянието и рестарт на системата, обработка на множество грешки, включително непоследователното поведение на сайта — а тези грешки са доста трудни за предвиждане (ако не пишеш парсери професионално, разбира се).
Условната оценка на времето за тази задача ще бъде 3-5 пъти по-висока, отколкото за събиране на данни от Хабра. Въпреки че в случая с Хабра използваме директен подход с парсене на HTML, а в случая с ОК можем в критични места да работим с API.
Изводи
Каквото и да изискват от вас да оцените срока на място (в крайна сметка днес планираме!) за обемния модул на пайплана за обработка на данни, времето за изпълнение практически никога не може да се оцени качествено без анализ на параметрите на задачата.
Ако се говори малко по-философски, стратегиите за оценка в agile са подходящи за инженерни задачи, но при по-експерименталните и, в известен смисъл, "творчески" и изследователски задачи, т.е. по-малко предсказуеми, възникват трудности, подобни на примерите, които разгледахме тук.
Разбира се, събирането на данни е просто ярък илюстративен пример - обикновено задачата изглежда невероятно проста и технически несложна, а именно в детайлите тук често се крие дяволът. И точно по тази задача можем да покажем целия спектър от възможни варианти за това, което може да тръгне наопаки и как точно работата може да се забави.
Ако прегледате характеристиките на задачата без допълнителни експерименти, Reddit и ОК изглеждат сходно: имат API, python обвивка, но в същността си разликата е огромна. Ако съдим по тези параметри, парсването на Хабра изглежда по-сложно от ОК - а на практика е точно обратното и именно това може да се установи чрез простите експерименти по анализ на параметрите на задачата.
Според моя опит най-ефективният подход е приблизителната оценка на времето, което ще ви е нужно за предварителния анализ и първоначалните експерименти, четене на документация - именно те ще ви позволят да дадете точна оценка за цялата работа. В термини на популярната методология agile - моля, създайте ми тикет за “оценка на параметрите на задачата”, на базата на който мога да дам оценка за това, което може да се изпълни в рамките на “спринта” и да дам по-точна оценка за всяка задача.
Затова най-ефективният аргумент изглежда да е този, който показва на "нетехническия" специалист колко много ще варират времето и ресурсите в зависимост от параметрите, които все още предстои да се оценят.
Източник: habr.com
