

Пазарът на разпределени изчисления и големи данни, ако вярваме , нараства с 18-19% годишно. Затова изборът на софтуер за тези цели остава актуален. В тази публикация ще започнем с основите на разпределените изчисления, по-подробно ще разгледаме избора на ПО, ще говорим за приложението на Hadoop чрез Cloudera и накрая ще обсъдим избора на хардуер и как той влияе по различни начини на производителността.
Защо са нужни разпределени изчисления в обикновения бизнес? Тук всичко е просто и сложно едновременно. Просто - защото в повечето случаи извършваме относително несложни изчисления на единица информация. Сложно - защото информацията е много. Много е. Вследствие на това По този начин сценарии на използване са доста универсални: изчисленията могат да бъдат приложими навсякъде, където е нужно да се вземат предвид голям брой метрики на още по-голямо количество данни.
Един от последните примери: веригата пицарии Додо Пица въз основа на анализа на базата от поръчки на клиентите, че при избора на пица с произволна плънка потребителите обикновено оперират само с шест основни комплекта съставки плюс няколко случайни. В съответствие с това пицарията настрои своите доставки. Освен това, успя по-добре да препоръчва на клиентите допълнителни продукти, предлагани на етапа на поръчка, което увеличи печалбата.
Друг пример: артикулите позволиха на магазина H&M да намали асортимента в отделни магазини с 40%, запазвайки същевременно нивото на продажби. Това беше постигнато чрез изключването на слабо продаващите се артикули, като в изчисленията беше отчетен сезонният фактор.
Избор на инструмент
Отрасловият стандарт за такива изчисления е Hadoop. Защо? Защото Hadoop е отличен, добре документиран фреймуърк (същият Хабр предоставя множество подробни статии по тази тема), който идва с набор от утилити и библиотеки. Можете да подавате огромни набори от структурирани и неструктурирани данни, а системата сама ще ги разпределя между изчислителните мощности. Освен това, тези мощности могат да бъдат увеличавани или изключвани по всяко време - именно тази хоризонтална мащабируемост в действие.
През 2017 година влиятелната консултантска компания Gartner , прогнозира, че Hadoop скоро ще се изчерпа. Причината е доста банална: аналитиците смятат, че компаниите масово ще преминат към облака, тъй като там ще могат да плащат в зависимост от използването на изчислителни мощности. Вторият важен фактор, за който твърдят, че би могъл да „погребе“ Hadoop, е скоростта на работа. Защото решения като Apache Spark или Google Cloud DataFlow работят по-бързо от MapReduce, който е в основата на Hadoop.
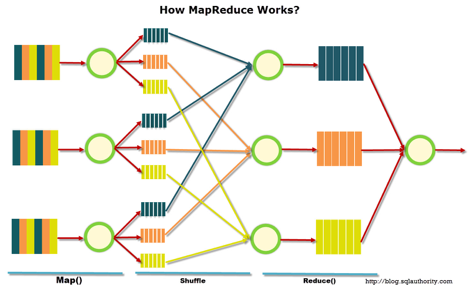
Hadoop се основава на няколко стълба, като най-значимите от тях са технологиите MapReduce (система за разпределение на данни за изчисления между сървъри) и файловата система HDFS. Последната е специално предназначена за съхранение на информация, разпределена между възлите на кластера: всеки блок с фиксиран размер може да бъде разположен на няколко възли, а благодарение на репликацията системата осигурява устойчивост към откази на отделни възли. Вместо таблица с файлове се използва специален сървър, наречен NameNode.
На илюстрацията по-долу е представена схема на работа на MapReduce. На първия етап данните се разделят по определен признак, на втория — разпределят се по изчислителни мощности, на третия — се извършват изчисления.
Първоначално MapReduce е разработена от Google за нуждите на своята търсачка. След това MapReduce премина в открит код, а проекта пое Apache. А Google постепенно преминава на други решения. Интересен нюанс: в момента Google има проект, наречен Google Cloud Dataflow, позициониран като следваща стъпка след Hadoop, като бърза неговата замяна.
При по-подробно разглеждане се вижда, че Google Cloud Dataflow се базира на разновидност на Apache Beam, в същото време Apache Beam включва добре документиран фреймуърк Apache Spark, което позволява да говорим за практически еднаква скорост на изпълнение на решения. А Apache Spark работи отлично на файловата система HDFS, което позволява да се разгръща на сървъри с Hadoop.
Добавяйки обема на документацията и готовите решения по Hadoop и Spark в сравнение с Google Cloud Dataflow, изборът на инструмент става очевиден. Повече от това, инженерите сами могат да решават кой код — за Hadoop или Spark — да изпълняват, в зависимост от задачата, опита и квалификацията.
Облако или локален сървър
Тенденцията за всеобщо преминаване в облака роди интересния термин Hadoop-as-a-service. В такъв сценарий администрирането на свързаните сървъри стана изключително важно. За съжаление, въпреки популярността си, чистият Hadoop е доста сложен за настройка инструмент, тъй като много неща трябва да се правят на ръка. Например, необходимо е отделно да се конфигурират сървърите, да се следят техните показатели и да се настройват внимателно множество параметри. С една дума, работата е за запалени ентусиасти и има голям риск нещо да се обърка или да се загуби.
Затова голяма популярност придобиха различни дистрибуции, които първоначално идват с удобни средства за разгръщане и администриране. Един от най-популярните дистрибуции, които поддържат Spark и опростяват всичко, е Cloudera. Той има както платена, така и безплатна версия — и в последната е достъпна цялата основна функционалност, без ограничения на броя на узлите.
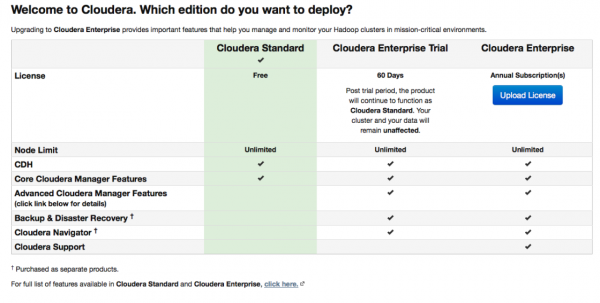
По време на настройката Cloudera Manager ще се свързва по SSH с вашите сървъри. Интересен момент: при инсталацията е добре да укажете, че тя да се извършва чрез пакети: специални компоненти, в които са включени всички необходими елементи, настроени да работят помежду си. По същество това е подобрена версия на пакетния мениджър.
След инсталацията получавате конзола за управление на клъстера, на която можете да видите телеметрия за клъстерите, инсталираните услуги, плюс ще можете да добавяте/премахвате ресурси и да редактирате конфигурацията на клъстера.
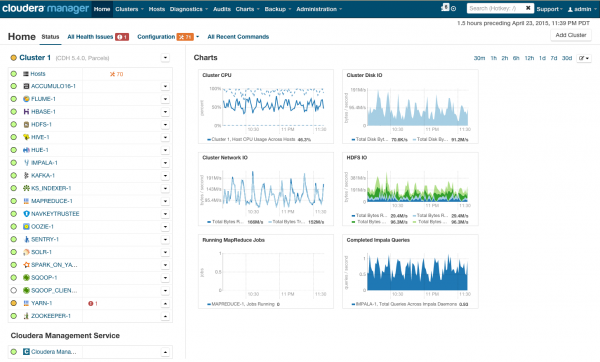
В резултат пред вас се появява разрез на тази ракета, която ще ви отведе в светлото бъдеще на BigData. Но преди да кажем „да се движим“, нека да загледаме под капака.
Изисквания към хардуера
На своя сайт Cloudera споменава различни възможни конфигурации. Общите принципи, по които те се изграждат, са показани на илюстрацията:
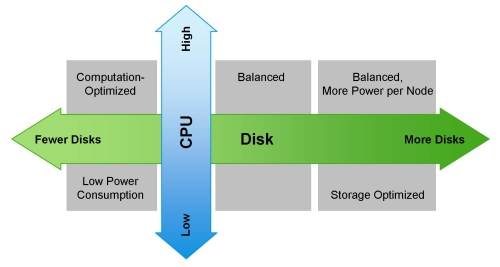
Оптимистичната картина може да бъде помрачена от MapReduce. При втори поглед на схемата от предишния раздел, става очевидно, че почти винаги задачата MapReduce може да се сблъска с "бутилката" при четене на данни от диск или мрежа. Това също е споменато в блога на Cloudera. В резултат на това, за всякакви бързи изчисления, включително и чрез Spark, който често се използва за изчисления в реално време, скоростта на входа/изхода е от съществено значение. Ето защо, при използване на Hadoop, е много важно в кластера да влязат балансирани и бързи машини, което, меко казано, не винаги е гарантирано в облачната инфраструктура.
Балансът в разпределението на натоварванията се постига чрез използване на виртуализацията Openstack на сървъри с мощни многоядрени CPU. На дата-нодовете са отделени техни процесорни ресурси и определени дискове. В нашето решение Atos Codex Data Lake Engine се постига широка виртуализация, от която печелим както по производителност (влиянието на мрежовата инфраструктура се минимизира), така и по TCO (изключват се излишните физически сървъри).
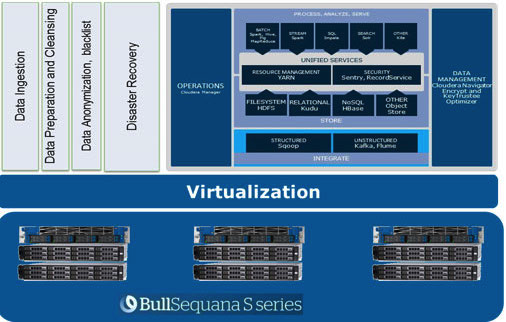
При използване на сървъри BullSequana S200 получаваме доста равномерно натоварване, лишено от част от тесните места. В минималната конфигурация влизат 3 сървъра BullSequana S200, всеки с два JBOD, плюс опционално свързване на допълнителни S200, съдържащи по четири дата-нодове. Ето пример за натоварване в теста TeraGen:
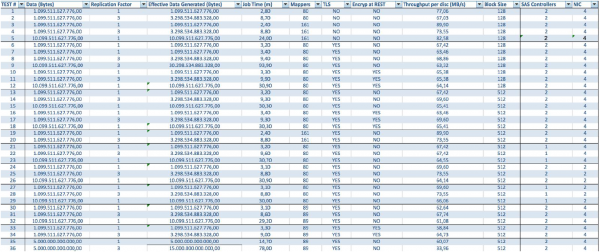
Тестовете с различни обеми данни и стойности на репликация показват идентични резултати по отношение на разпределението на натоварването между нодовете на клъстера. По-долу е графика на разпределението на достъпа до диска по тестовете за производителност.
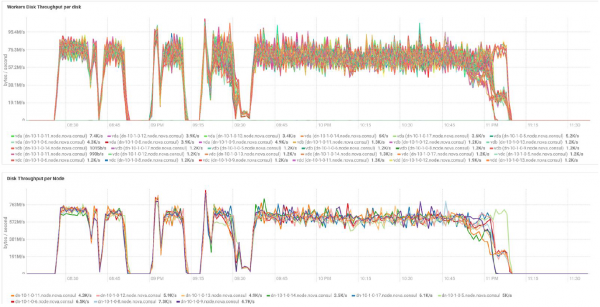
Изчисленията са извършени на базата на минималната конфигурация от 3 сървъра BullSequana S200. Тя включва 9 дата-нодове и 3 главни нода, както и резервирани виртуални машини в случай на разгръщане на защита на базата на OpenStack Virtualization. Резултатът от теста TeraSort: размер на блока 512 MB с коефициент на репликация три с криптиране е 23,1 мин.
Как можете да разширите системата? За Data Lake Engine са налични различни видове разширения:
- Нода за предаване на данни: за всеки 40 TB полезно пространство
- Аналитични нодове с възможност за инсталиране на графичен процесор
- Други опции в зависимост от нуждите на бизнеса (например, ако е необходим Kafka и подобно)
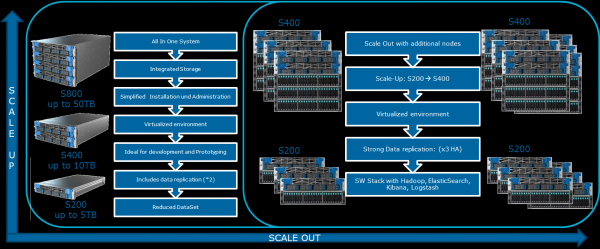
Съставът на комплекса Atos Codex Data Lake Engine включва както самите сървъри, така и предварително инсталирания софтуер, включително пакета Cloudera с лицензия; самия Hadoop, OpenStack с виртуални машини на базата на ядрото на RedHat Enterprise Linux, системи за репликация на данни и резервно копиране (включително с помощта на нодата за резервно копиране и Cloudera BDR — Backup and Disaster Recovery). Atos Codex Data Lake Engine стана първото решение с използване на виртуализация, което беше сертифицирано .
Ако ви интересуват подробности, ние ще се радваме да отговорим на въпросите ви в коментарите.
Източник: habr.com
