

На 9 януари беше пусната версия Pandas 1.0.0rc. Предишната версия на библиотеката е 0.25.
Първият мажорен релиз съдържа множество удивителни нововъведения, включително подобрено автоматично обобщаване на датафреймове, повече формати на изхода, нови типове данни и дори нов сайт за документация.
Всички промени могат да бъдат видяни , в статията ще се ограничим до кратък, по-малко технически преглед на най-важното.
Инсталирането на библиотеката може да стане както обикновено с помощта на pip, но тъй като по време на написването на статията Pandas 1.0 все още е release candidate, ще трябва изрично да укажете версията:
pip install --upgrade pandas==1.0.0rc0Внимавайте: тъй като релизът е мажорен, обновлението може да повредят стара кодова база!
Струва си да се спомене, че с тази версия окончателно е спряна поддръжката на Python 2 (което може да бъде добра причина — заб. на преводача.). Pandas 1.0 изисква поне Python 3.6+, така че ако не сте сигурни, уточнете коя версия е инсталирана при вас:
$ pip --version
pip 19.3.1 от /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Най-лесно е да проверите версията на Pandas по следния начин:
>>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Подобрено автоматично обобщаване с DataFrame.info
Любимото ми нововъведение е актуализацията на метода DataFrame.info. Функцията стана много по-четима, което прави процеса на анализ на данни още по-лесен:
>>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Извод на таблици в формат Markdown
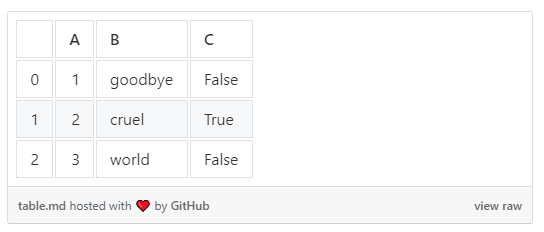
Не по-малко приятно нововъведение е възможността за експортиране на датафреймове в таблици Markdown с помощта на DataFrame.to_markdown.
>>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
Това значително опростява публикуването на таблици на сайтове като Medium, използвайки github gists.
Нови типове за стрингове и логически стойности
В релиза Pandas 1.0 бяха добавени и нови експериментални типове. Неговият API все още може да се промени, така че го използвайте с внимание. Но по принцип Pandas препоръчва използването на новите типове, където има смисъл.
Все още е необходимо явното преобразуване:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Обърнете внимание как колоната Dtype показва новите типове — стринг и bool.
Най-полезната функция на новия тип стринг е възможността за избор само на колоните със стринг от DataFrame-овете. Това може значително да опрости анализа на текстови данни:
df.select_dtypes("string")Преди, колоните със стринг не можеха да се избират без явно указване на имената им.
Повече за новите типове можете да прочетете .
Благодаря, че прочетохте! Пълният списък с промените, както вече споменахме, можете да видите .
Източник: habr.com
