

Определението на DevOps е много сложно, затова всяка поредна дискусия по темата започва от нулата. Само в Хабра има хиляда публикации по този въпрос. Но ако четете това, вероятно знаете какво е DevOps. Защото аз - не. Здравейте, аз съм Александър Титов (@), и просто ще поговорим за DevOps и ще споделя опита си.
Дълго се замислях как да направя разказа си полезен, затова тук ще има много въпроси - тези, които сам си задавам, и тези, които задавам на клиентите на нашата компания. Отговаряйки на тях, разбирането става по-добро. Ще разкажа защо е нужен DevOps от моята гледна точка, какво представлява, отново от моята позиция, и как да разберете, че напредвате към DevOps - отново от моята гледна точка. Последният пункт ще бъде чрез въпроси. Отговаряйки на тях самостоятелно, ще можете да разберете дали вашата компания напредва към DevOps или някъде има проблеми.
По едно време се лутех по вълните на сливането и придобиванията. Първо работех в малкия стартъп Qik, след което той беше купен от по-голямата компания Skype, която след това беше закупена от още по-голямата компания Microsoft. В този момент ми стана достъпно виждането как се трансформира представата за DevOps в компании с различен размер. След това ми стана интересно да гледам на DevOps от перспективата на пазара, и ние с колегите организирахме компанията Експрес 42. Вече 6 години плаваме на нея по вълните на пазара.
Освен всичко останало, аз съм един от организаторите на общността DevOps Moscow и организатор на DevOps Days 2017, но през 2018 не организирах. Експрес 42 работи с много компании. Ние развиваме DevOps там, наблюдаваме как се случва, правим изводи, анализираме, разказваме изводите си на всички, обучаваме хора в DevOps практики. Общо взето, всячески увеличаваме опита и експертизата в тази сфера.
Защо DevOps
Първият въпрос, който е преследвал всички и винаги - защо? Мнозина смятат, че DevOps е просто автоматизация или нещо подобно, което вече е в компанията.
— При нас имаше Continuous Integration - това означава, че вече имахме DevOps, и защо ни е всичката тази работа? Там в чужбина се забавляват, а на нас ни пречат да работим!
През последните 9 години на развитие на общността и методологията вече стана ясно, че това наистина не са маркетингови блестящи неща, но все пак не е напълно ясно защо е необходим. Както при всякакъв инструмент и процес, DevOps има конкретни цели, които в крайна сметка решава.
Всичко това е свързано с факта, че светът се променя. Той се отдалечава от подхода на предприятията, когато компаниите бързат към мечтата, както пя нашият Санктпетербургски класик, от точка А до точка В по определена стратегия, със специално изградена структура за това.
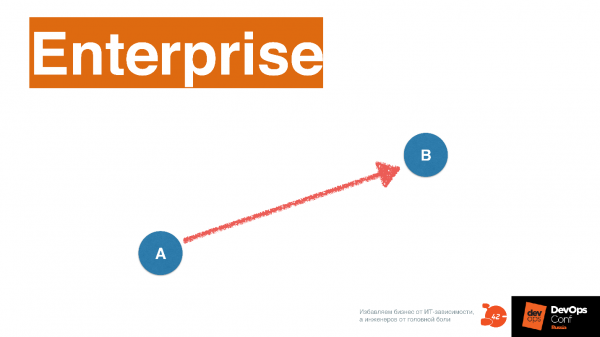
В принцип последният подход трябва да бъде основен в IT сферата. Тук IT се използва изключително за автоматизация на процеси.
Автоматизацията не се променя често, защото когато компанията се движи по утвърдената колея - какво да променяме? Работи - не пипай. В момента в света подходите се променят, и този, който наричаме Agile, казва, че крайна точка В не се вижда веднага.
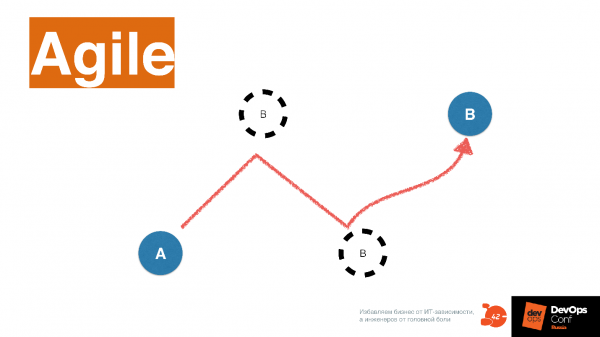
Когато компанията се движи на пазара, работи с клиента - тя постоянно проучва пазара и променя крайна точка В. Освен това, колкото по-често компанията променя посоката си, толкова по-успешна става, защото избира повече пазарни ниши.
Стратегията е демонстрирана от интересна компания, за която научих наскоро. One Box Shave - услуга за доставка на самобръсначки и принадлежности по подписка в кутийка. Те могат да персонализират своята "кутия" за различни клиенти. За това се грижи определен софтуер, който след това изпраща поръчката до корейска фабрика, произвеждаща продукта.
Този продукт беше закупен от компания Unilever за 1 милиард долара. В момента той конкурира с Gillette и е отнел значителен дял на потребителите на американския пазар. One Box Shave казват:
— 4 остриета? Наистина ли? Защо ви е необходимо това - не подобрява качеството на бръснене. Специално подбран крем, аромат и качествена самобръсначка с две остриета решават много повече проблеми, отколкото тези глупави 4 остриета на Gillette! Скоро ли ще стигнем до 10?
Така се променя светът. Unilever заявяват, че имат страхотна IT система, която позволява това. В крайна сметка това изглежда като концепцията Time-to-market, за която вече кой ли не е говорел.
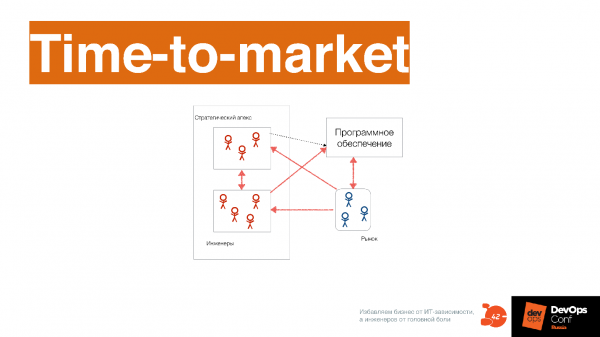
Смисълта на Time-to-market не е в това, колко често извършваме деплой. Може да се деплойва често, но в същото време цикълът на релизите ще бъде дълъг. Ако тримесечните цикли на релизите се наслагват един върху друг с отлагане с една седмица, се получава, че компанията сякаш деплойва веднъж седмично. А от идеята до окончателната реализация минават 3 месеца.
Time-to-market е за минимизиране на времето от идеята до окончателната реализация.
В този случай софтуерът взаимодейства с пазара. Така One Box Shave взаимодейства с клиента чрез сайта си. Нямат продавачи – просто сайт, където посетителят клика и оставя пожелания. Следователно, на сайта трябва постоянно да се публикува нещо ново, да се обновява в съответствие с пожеланията. Например, в Южна Корея се бръснат по различен начин от Русия и им харесва мирисът не на бор, а на моркови с ванилия.
Тъй като е необходимо бързо да се променя съдържанието на сайта, разработката на софтуер се променя значително. Чрез софтуера трябва да разберем какво иска клиентът. Преди това го разбирахме по заобиколни пътища, например чрез бизнес мениджмънт. След това проектирахме, въвеждахме изискванията в IT системата и всичко беше чудесно. Сега е различно – софтуерът се проектира от всички, включени в процеса, включително инженери, тъй като те разбират чрез техническите характеристики как работи пазарът и също споделят своите прозрения с бизнеса.
Например, в компания Qik изведнъж научихме, че на хората много им харесва да качват списъци с контакти на сървъра и те ни предложиха приложение. Първоначално не се бяхме замислили за това. В класическа компания всички биха решили, че това е грешка, защото в спецификацията не е посочено, че това трябва да работи отлично и всъщност е реализирано набързо, щяха да изключат функционалността и да кажат: „Това никому не е нужно, най-важното е, че основната функционалност работи“. А технологичната компания вижда в това възможност и започва да променя софтуера в съответствие с това.
През 1968 година прозорливият човек Мелвин Конвей формулира следната идея.
Организацията, която създава система, е ограничена от дизайна, който копира структурата на комуникацията в тази организация.
Ако искате да произвеждате системи от друг тип, е необходимо да имате и комуникационна структура от различен тип. Ако комуникационната ви структура е строго йерархична, то това няма да ви позволи да създавате системи, които да осигуряват много високи показатели за Time-to-market.
Прочетете може . Той е важен за разбирането на културата или философията на DevOps, тъй като единственото, което основно се променя в DevOps, е именно структурата на комуникацията между екипите..
От гледна точка на процеса, до DevOps всички етапи: анализ, разработка, тестване, експлоатация, преминаваха линейно.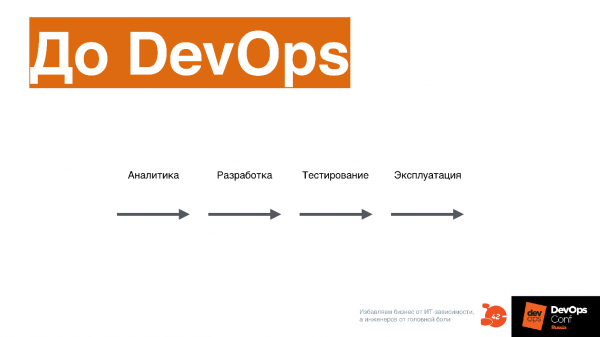
В случая с DevOps, всички тези процеси протичат едновременно.
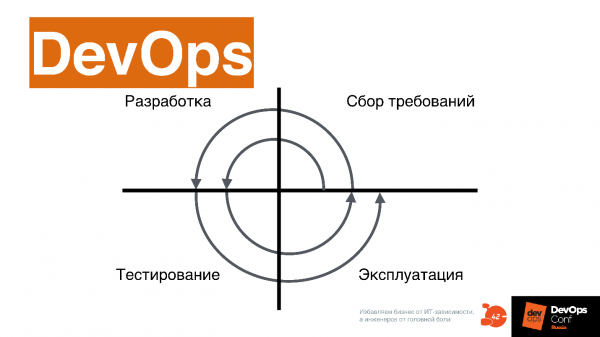
Time-to-market може да бъде постигнат само по този начин. За хората, които са работили в стария процес, това изглежда донякъде абсурдно, и изобщо не е просто.
И така, защо е нужен DevOps?
За разработката на цифрови продукти.Ако вашата компания няма цифров продукт, DevOps не е нужен - това е много важно.
DevOps преодолява ограниченията на последователната схема на производство на софтуер.В него всички процеси протичат едновременно.
Сложността се увеличава. Когато евангелистите на DevOps твърдят, че с него ще ви е по-лесно да пускате софтуер - това е глупост.
С DevOps всичко ще стане само по-сложно.
На конференцията на щанда на Авито можете да видите какво означава да деплойнете Docker контейнер - нереална задача. Сложността става необичайна, нужно е да жонглирате с много топки едновременно.
DevOps напълно променя процеса и организацията в компанията, по-точно, не DevOps променя всичко, а цифровият продукт. За да достигнете до DevOps, е необходимо да промените напълно този процес.
Въпроси за специалиста
А какво при вас? Въпросите, които можете да си зададете, работейки в компания и развивайки се като специалист.
Имате ли стратегия за създаване на цифров продукт? Ако имате - вече е добре. Това означава, че вашата компания се движи в посока DevOps.
Вашата компания вече ли създава цифров продукт? Това означава, че можете да се издигнете на още едно ниво, да се занимавате с по-интересни работи - от гледна точка на DevOps пак. Говоря само от тази гледна точка.
Вашата компания един от лидерите на пазара в нишата с цифров продукт? Spotify, Яндекс, Uber — компании, които в момента са на върха на технологичния напредък.
Задайте си тези въпроси и, ако всички отговори са отрицателни, може би не е нужно да се занимавате с DevOps в тази компания. Ако обаче темата DevOps ви интересува наистина, може би е време да се прехвърлите в друга компания? Ако вашата компания иска да навлезе в DevOps, но на всички въпроси отговорите са „Не“, то тя напомня на онзи прекрасен носорог, който никога няма да се промени.
Организацията
Както вече казах, по закона на Конвей в компанията се променя организацията. Ще започна с това, което пречи на DevOps да проникне вътре в компанията именно от организационна гледна точка.
Проблемата на „колодците“
Английската дума „Silo“ тук е преведена на български като „колодец“. Същността на този проблем е, че между екипите няма обмен на информация.Всяка команда дълбае своята експертиза дълбоко, без да създава обща карта, по която да се ориентира.
Нещо подобно е на човек, който току-що е пристигнал в Москва и още не умее да се ориентира по картата на метрото. Москвичите обикновено прекрасно познават района си, а в цяла Москва се ориентират по картата на метрото. Когато пристигнете в Москва за първи път, нямате този навик и просто сте дезориентирани.
DevOps предлага да се премине през този момент на дезориентация и всички звена заедно да изградят обща карта на взаимодействието.
На този процес пречат два фактора.
Следствие на корпоративната система на управление. Тя е построена от отделни йерархични „колодци“. Например, в компаниите има определени KPI, които поддържат тази система. От друга страна, пречат и съзнанията на хората, на които им е трудно да излязат извън пределите на своята експертиза и да се ориентират в цялата система. Това просто е дискомфортно. Представете си, че сте в летище Банкок — там бързо не можете да се ориентирате. В DevOps също е трудно да се ориентирате, и затова хората казват, че е необходимо да намерят водач, за да стигнат до там.
Но най-важното е, че проблемът на „колодците“ за инженер, който е усетил духа на DevOps, е прочел Фаулър и още куп книги, се изразява в това, че „колодците“ не позволяват да се правят „очевидни“ неща.Често се събираме след DevOps Moscow, разговаряме помежду си и хората се оплакват:
Искахме просто да стартираме CI, а се оказа, че на ръководството не му е нужно.
Това се случва точно заради това, че CI и Процес на непрекъсната доставка се намират на границата на много експертизи. Просто не преодолявайки проблема с 'кладенците' на организационно ниво, няма да можете да напреднете, независимо какво правите и колко тъжно е това.
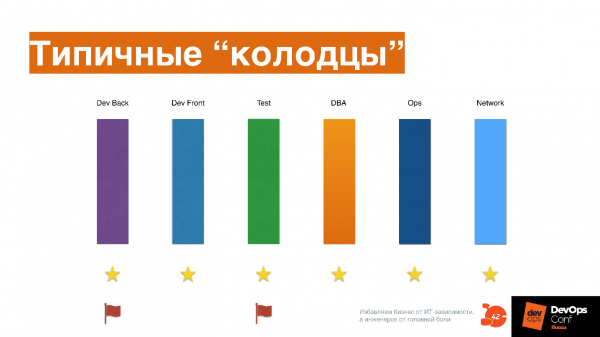
Всеки участник в процеса в компанията: бекенд и фронтенд разработчици, тестове, DBA, експлоатация, мрежа, копае в своята посока, а никой, освен ръководителя, не притежава обща карта, която да наблюдава и управлява чрез метода 'разделяй и владей'.
Хората се борят за някакви звездички или флагове, всеки копае своята експертиза.
В крайна сметка, когато се появи задачата да се свържат всичко това заедно и да се изгради общ пайплайн, и за звездичките и флаговете вече не е нужно да се борим, възниква въпросът – какво всъщност да правим? Трябва да намерим начин да се договаряме, а как се прави това, никой не ни е учил в училище. Още от училище сме научени: осми клас – ох! – в сравнение с седми клас! Тук е същото.
При вас в компанията също ли е така?
За да проверите това, можете да си зададете следните въпроси.
Използват ли екипите общи инструменти, допринасят ли за промените в тези общи инструменти?
Насколько често екипите се реформира – един специалист от един екип преминава в друг екип? В DevOps среда това става нормално, защото понякога човек просто не може да разбере с какво се занимава друга зона на експертиза. Той преминава в друг отдел, работи там две седмици, за да създаде карта на ориентация и взаимодействие с този отдел.
Може ли да се създаде комитет за промяна и да се променят неща? Или за това се нуждае от силна ръка на най-висшето ръководство и разпореждане? Наскоро написах в Facebook как един малко известен банк чрез разпореждания внедрява инструменти: написали разпореждане, година внедряват, наблюдават какво се случва. Това, разбира се, е бавно и тъжно.
Насколько важно е за мениджърите да получават лични постижения, независимо от постиженията на компанията?
Ако отговорите на тези въпроси, ще стане по-ясно, дали имате такъв проблем в компанията.
Инфраструктура като код
След като този проблем бъде решен, първата важна практика, без която е трудно да се напредва в DevOps, е инфраструктура като код.
Най-често инфраструктурата като код се възприема така:
— Нека автоматизираме всичко с bash, намажем се с скриптове, за да имаме по-малко ръчна работа за администраторите!
Но това не е така.
Инфраструктурата като код предполага, че IT системата, с която работите, описвате в код, за да разбирате постоянно нейното състояние.
В сътрудничество с други екипи създавате карта в код, която е понятна на всички и по която можете да се ориентирате, навигирате. Без значение на какво е направена — Chef, Ansible, Salt или се използват YAML файлове в Kubernetes — няма значение.
На конференцията колегата от 2GIS разказваше как са създали свой вътрешен инструмент за Kubernetes, който описва устройството на отделни системи. За да опишат 500 системи, им е нужен специален инструмент, който генерира това описание. Когато имат това описание, всеки може да сверява с друг, да следи промените, как да го промени и подобри, какво не им достига.
Съгласете се, отделните bash скриптове обикновено не дават това разбиране. В една от фирмите, където работех, имаше дори название „write only“ скрипт — когато скриптът е написан, а прочитането му вече е невъзможно. Мисля, че и на вас ви е познато.
Инфраструктурата като код е код, който описва актуалното състояние на инфраструктурата. Над този код заедно работят множество продуктов, инфраструктурен и сервизен екип, и най-важното, всички те трябва да разбират как този код всъщност работи.
Кодът се поддържа според най-добрите практики за работа с код: съвместна разработка, код ревю, XP програмиране, тестване, пул реквести, CI за инфраструктура от код — всичко това е стойностно и може да се използва.
Кодът става общ език за всички инженери.
Промяната на инфраструктурата в код не отнема много време. Да, в инфраструктурния код също може да има технически дълг. Обикновено екипите се сблъскват с него около година и половина след като започнат внедряването на „инфраструктурата като код“ под формата на купчина скриптове или дори Ansible, който пишат като спагети код, и още bash скриптове добавят в огъня!
Важно: ако все още не сте пробвали това, запомнете, че Ansible не е bash! Внимателно прочетете документацията, проучете какво всъщност пишат за това.
Инфраструктурата като код е разделение на инфраструктурния код на отделни слоеве.
В нашата компания определяме 3 основни слоя, които са много ясни и прости, но могат да бъдат и повече. Можете да разгледате своя инфраструктурен код и да кажете дали имате това условие или не. Ако не се отделят никакви слоеве, трябва да отделите време и да рефакторите малко.
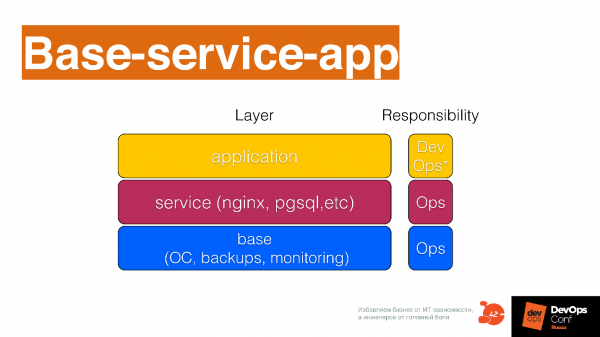
Основен слой — това е как се настройва ОС, бекъпи и други нискоуровневи неща, например как се разгръща Kubernetes на основно ниво.
Уровен на услуги — това са услугите, които предоставяте на разработчика: логване като услуга, мониторинг като услуга, база данни като услуга, балансировчик като услуга, опашка като услуга, Непрекъсната доставка като услуга — куп услуги, които отделни екипи могат да предоставят на разработката. Всичко това трябва да се описва отделно в системата ви за управление на конфигурацията.
Слой, където се изграждат приложения и се описва как ще се разгръщат над двата предишни слоя.
Контролни въпроси
Имате ли във вашата компания общ инфраструктурен репозиторий? Контролирате ли техническия дълг в инфраструктурата? Използвате ли практики на разработката в инфраструктурния репозиторий? Разделена ли е вашата инфраструктура на слоеве? Може да се сверите със схемата Base-service-APP. Насколько сложно внести изменение?
Ако сте се сблъсквали с това, че извършването на промени е отнемало ден и половина, това означава, че имате технически дълг и трябва да работите по него. Вие точно сте натъкнали на грабли на техническия дълг в инфраструктурния код. Помня много такива истории, когато за да смените нещо в CCTL, трябва да пренапишете половината от инфраструктурния код, защото творчеството и желанието да автоматизирате всичко са довели до това, че навсякъде е закорежда, всички ръчки са свалени, и е нужно рефакториране.
Непрекъсната доставка
Нека започнем с основите на инфраструктурата. Първоначално ще видите описание на инфраструктурата, което може да бъде доста основно. Не е необходимо да описвате всичко в детайли, но основно описание е задължително, за да можете да работите с него. В противен случай няма да разберете върху какво ще изградите непрекъснатото поставяне. Всички тези практики се развиват едновременно, когато се насочите към DevOps, но трябва да започнете с разбирането на наличното и как да го управлявате. Това е практика за инфраструктура като код.
След като установите какво имате и как да го управлявате, започвате да измисляте как да изпратите кода на разработчика възможно най-бързо в продукция. Имам предвид заедно с разработчика – не забравяйте за проблема с "колодците", тъй като не отделни хора измислят това, а екип.
Когато се Ваня Евтухович видяхме първата книга Джез Хамбъл и група автори «Непрекъснато доставка», която излезе през 2009 година, дълго мислехме как да преведем заглавието ѝ на български. Искахме да преведем като «Постоянна доставка», но, за съжаление, преведохме като «Непрекъсната доставка». Смятам, че в нашето заглавие има нещо типично българско, с енергия.
Постоянната доставка означава,
Кодът, който е в продуктовия репозиторий, винаги може да бъде изтеглен в продукция. Той може да не бъде изтеглен, но винаги е готов за това. Следователно, винаги пишете код с трудно обяснимо чувство на известно безпокойство. То често се появява, когато разпределяте инфраструктурен код. Това чувство на безпокойство трябва да присъства – то предизвиква мозъчни процеси, които ви позволяват да пишете код малко по-различно. Това трябва да бъде фиксирано в правилата на разработката.
За да осигурите постоянна доставка, е необходим формат на артефакта, който преминава през инфраструктурната платформа. Ако хвърляте различни формати на "отпадъци от жизнената дейност" в инфраструктурната платформа, тя става неунифицирана, трудно за поддръжка, и възниква проблем с техническия дълг. Форматът на артефакта трябва да бъде стандартизиран – това е също колективна задача: трябва всички заедно да се съберем, да раздвижим ума и да измислим този формат.
Артефакт непрекъснато се усъвършенства и променя под продукционната среда по време на преминаването през доставната пайплайн. Когато артефактът преминава през пайплайна, той постоянно среща някакви неудобни за него неща, които наподобяват на тези, с които се сблъсква артефактът, който вие пускате в продукция. Ако в класическата разработка това е в ръцете на системен администратор, който извършва пускане, в процеса на DevOps това се случва постоянно: тук го озадачават с тестове, тук го пускат в Kubernetes клъстер, който е повече или по-малко подобен на продукцията, тук внезапно стартират натоварващо тестиране.
Това наподобява играта Пакман - артефактът преминава през някаква история. Важно е да се следи дали кодът наистина минава през история и дали тя е свързана с вашата продукция. Историите с продукцията могат да бъдат добавени в процеса на Continuous Delivery: така беше, когато нещо се провали, сега да програмираме този сценарий вътре в системата. Всеки път кодът ще преминава през този сценарий и вие няма да се сблъскате с този проблем следващия път. Ще научите за него много по-рано, отколкото ще достигне до вашия клиент.
Различни стратегии за разгръщане. Например, вие използвате AB тестване или канарейски разгръщания, за да "измервате" кода на различни клиенти, получавайки информация за това как кодът работи, и много по-рано, отколкото когато бъде пуснат за 100 милиона потребители.
"Постоянното доставяне" изглежда така.
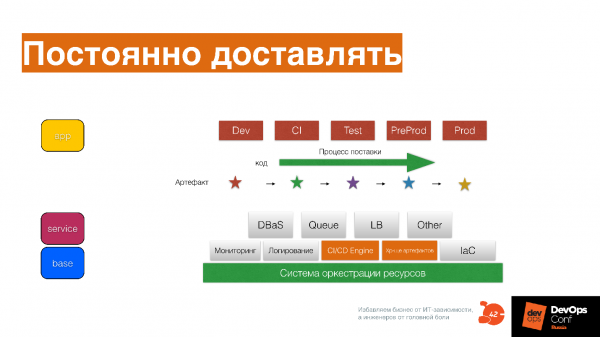
Процесът на доставка Dev, CI, Test, PreProd, Prod не е отделна среда, а етапи или станции с незабавни суми, по които преминава вашият артефакт.
Ако разполагате с инфраструктурен код, описан като Base Service APP, то той помага да не забравяте всички сценарии, и да ги запишете също като код за този артефакт, да напредвате артефакта и да го променяте по време на движението.
Въпроси за самопроверка
Времето от описанието на функцията до пускането в продукция в 95% от случаите по-малко от седмица ли е? Повишава ли се качеството на артефакта на всеки етап от пайплайна? Има ли история, по която той преминава? Използвате ли различни стратегии за разгръщане?
Ако на всички въпроси отговорите с "да", вие сте невероятно страхотни! Напишете отговорите в коментарите - ще се радвам.
Обратная связь
Това е най-сложната практика от всички. На конференцията DevOpsConf, колегата от Infobip, говорейки за нея, малко се заплете в думите, защото това наистина е много сложна практика, свързана с необходимостта да се наблюдава всичко!
Например, отдавна, когато работех в Qik и осъзнахме, че трябва да наблюдаваме всичко. Направихме го и в Zabbix имаме 150 000 items, които се наблюдават постоянно. Беше страшно, техническият директор въртеше пръст на слепоочието:
— Хей, момчета, защо мъчите сървъра с неразбираеми неща?
Но след това се случи случай, който показа, че това е наистина много добра стратегия.
Един от сервисите започна да пада непрекъснато. Първоначално не падаше, което е интересно, защото код не беше добавян, тъй като това беше базов брокер, в който практически нямаше бизнес функционалност — просто преместваше съобщения между отделните услуги. Сервисът не се беше променял 4 месеца и изведнъж започна да пада с грешка „Segmentation fault“.
Бяхме в шок, отворихме графиките в Zabbix и установихме, че всъщност, преди половин месец, поведението на заявките в API сервиса, който използва този брокер, беше се променило значително. След това видяхме, че честотата на изпращане на определен тип съобщения се е променила. След това установихме, че става въпрос за android клиенти. Попитахме:
— Хей, момчета, какво се случи преди половин месец?
В отговор чухме интересна история, като че ли бяха преработили UI. Малко е вероятно някой веднага да каже, че е променил HTTP библиотеката. За android клиентите е като да сменяте сапуна в банята — просто не си спомнят. В крайна сметка, след 40 минути разговор, установихме, че те наистина са сменили HTTP библиотеката и настройки по подразбиране. Това доведе до промяна в поведението на трафика на API сървър, което и предизвика ситуация, която доведе до състезание в брокера и той започна да пада.
Без дълбочинно наблюдение, това изобщо не може да бъде открито.. Ако в организацията все още има проблеми с „колодците“, когато всеки прехвърля проблемите на друг, това може да продължи с години. Вие просто рестартирате сървъра, защото е невъзможно да решите проблема. Когато наблюдавате, проследявате, следите всички събития, които имате, и използвате наблюдението като тестиране — пишете код и веднага задавате как да го наблюдавате, също в формата на код (при нас вече има инфраструктура като код), всичко става ясно като на длан. Дори такива сложни проблеми лесно се проследяват.
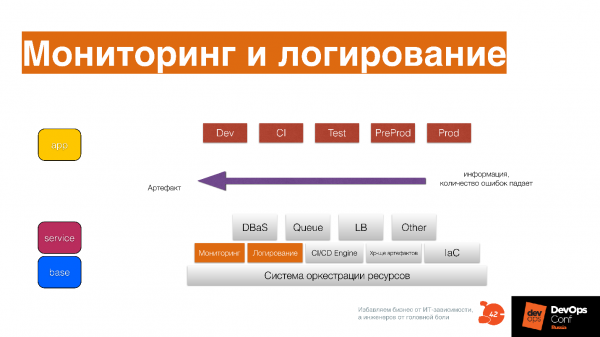
Събирайте цялата информация за това, което се случва с артефакта на всяка степен от процеса на доставяне — не в производствена среда.
Наблюдението заредете в CI, и там вече ще бъдат видими някои основни неща. След това ще ги видите и в Test, и в PredProd, и в тестовете под натоварване. Събирайте информация на всички етапи, като не само метрики, статистика, но и логовете: как е било разпространено приложението, аномалии — събирайте всичко.
В противен случай ще бъде трудно да се справите. Вече споменах, че DevOps е по-голяма сложност. За да се справите с тази сложност, е необходимо да имате нормална аналитика..
Въпроси за самооценка.
Вашето наблюдение и логване — това средство за разработка ли е за вас? Вашите разработчици, и вие в техния ред, когато пишат код, мислят ли за това как да го наблюдават?
Разбирате ли проблемите от клиентите? Разбирате ли клиента по-добре от наблюдението и логването? Разбирате ли системата по-добре от наблюдението и логването? Променяте ли системата просто защото видяхте, че трендът в системата расте и разбирате, че още 3 седмици и всичко ще се провали?
Когато имате тези три компонента, можете да помислите за това, каква инфраструктурна платформа имате в компанията си.
Инфраструктурна платформа.
Смисълът не е в това, че това е набор от разпръснати инструменти, които има в кажда компания.
Смисълът на инфраструктурната платформа е в това, че всички екипи ползват тези инструменти и ги развиват заедно.
Ясно е, че има отделни екипи, които носят отговорност за развитието на отделни части от инфраструктурната платформа. Но въпреки това отговорността за развитието, работоспособността, популяризирането на инфраструктурната платформа носи всеки инженер. На вътрешно ниво това се превръща в общ инструмент..
Всички екипи развиват инфраструктурна платформа и се отнасят с грижа към нея, както към собственото си IDE.. В своето IDE вие поставяте различни плъгини, за да е всичко красиво и бързо, настройвате горещите клавиши. Когато отворите Sublime, Atom или Visual Studio Code, кодът ви показва грешки и вие разбирате, че е изцяло невъзможно да работите, веднага става тъжно и бягате да поправяте своето IDE.
Същото отношение трябва да има и към вашата инфраструктурна платформа. Ако разбирате, че с нея нещо не е наред, подавайте заявка, ако не можете да поправите сами. Ако обаче е нещо просто – поправяйте сами, изпращайте pull request – момчетата разглеждат и добавят. Това е малко по-различен подход към инженерния инструментариум в съзнанието на разработчика.
Инфраструктурната платформа осигурява пренос на артефакт от разработката до клиента с постоянно повишаване на качеството.. В ИП е програмиран набор от истории, които се случват с кода в продукция. През годините на разработка тези истории стават наистина много, част от тях са уникални и се отнасят само до вас – те не могат да бъдат намерени в интернет.
В този момент инфраструктурната платформа става вашето конкурентно предимство., защото в нея е заложено това, което липсва в инструмента на конкурента. Колкото по-дълбока е вашата ИП, толкова повече е вашето конкурентно предимство по отношение на Time-to-market. Тук се появява проблемът с vendor lock.: можете да вземете чужда платформа, но използвайки чуждия опит, няма да разберете колко е релевантен за вас. Да, не всяка компания може да изгради платформа като Amazon. Това е сложна граница, където опитът на компанията е релевантен на нейното положение на пазара, и не бива да допускате vendor lock там. За това също е важно да се помисли.
Схема
Това е основната схема на инфраструктурната платформа, която ще ви помогне да установите всички практики и процеси в DevOps компания.
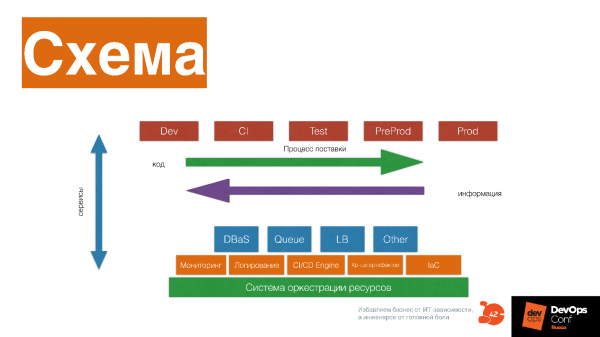
Нека разгледаме от какво се състои.
Система за оркестрация на ресурси, която предоставя CPU, памет, диск на приложенията и другите услуги. Над това – услуги от по-ниско ниво: мониторинг, логиране, CI/CD Engine, хранилище за артефакти, инфраструктура като код системи.
Услуги от по-високо ниво.: база данни като услуга, опашки като услуга, Load Balance като услуга, преоразмеряване на изображения като услуга, Big Data фабрика като услуга. Върху това – поток, който постоянно предоставя модифициран код на вашия клиент.
Вие получавате информация за това как вашият софтуер работи при клиента, променяте, отново предоставяте този код, получавате информация – и така постоянно развивате както инфраструктурната платформа, така и вашия софтуер.
На схемата delivery pipeline се състои от множество етапи. Но това е принципна схема, приведена за пример – не е нужно да я повтаряте еднакво. Етапите взаимодействат със сервизите, като със сервизи – всеки блок на платформата носи своя история: как се разпределят ресурсите, как приложението стартира, работи с ресурсите, мониторира се, променя се.
Важно е да разбирате, че всяка част от платформата носи история, и да се питате – каква история носи този блок, може би трябва да го изхвърлим и заменим с външен сервиз. Например, може ли вместо блока да поставим Okmeter? Възможно е момчетата вече да са развили тази експертиза много повече от нас. Но може и да не е така – може би имаме уникална експертиза, трябва да внедрим Prometheus и да развиваме това по-нататък.
Създаване на платформа
Това е сложен комуникационен процес. Когато имате основни практики, стартирате общуването между различни инженери и специалисти, които разработват изисквания и стандарти, и постоянно ги изменят към различни инструменти и подходи. Тук е важна културата, която съществува в DevOps.
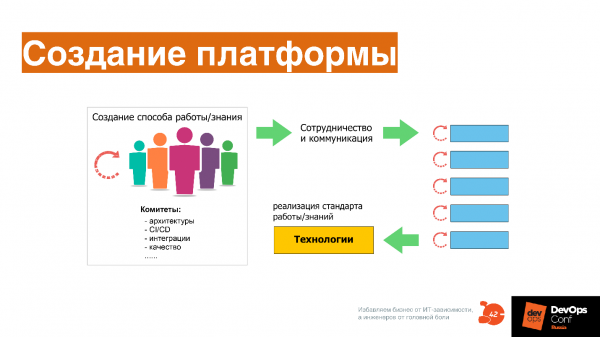
С културата всичко е много просто – това е сътрудничество и комуникация, тоест желание да работим в общо поле помежду си, желание да овладеем един инструмент заедно. Няма никаква rocket science – всичко е много просто, банално. Например, ние всички живеем в един вход и поддържаме чистота – такова е нивото на културата.
А как е при вас?
Отново въпроси, които можете да си зададете.
Изолирана ли е инфраструктурната платформа? Кой отговаря за нейното развитие? Разбирате ли конкурентните предимства на вашата инфраструктурна платформа?
Тези въпроси трябва постоянно да си задавате. Ако нещо може да бъде изнесено на външни услуги – трябва да бъде изнесено, ако външната услуга започне да блокира вашето движение, тогава трябва да изградите система вътре в себе си.
И така, DevOps…
… това е сложна система, която трябва да включва:
- Цифров продукт.
- Бизнес модули, които развиват този цифров продукт.
- Продуктови екипи, които пишат код.
- Практики за Непрекъсната Доставка.
- Платформи като услуга.
- Инфраструктура като услуга.
- Инфраструктура като код.
- Отделни практики за поддържане на надеждността, внедрени в DevOps.
- Практика за обратна връзка, която описва всичко това.
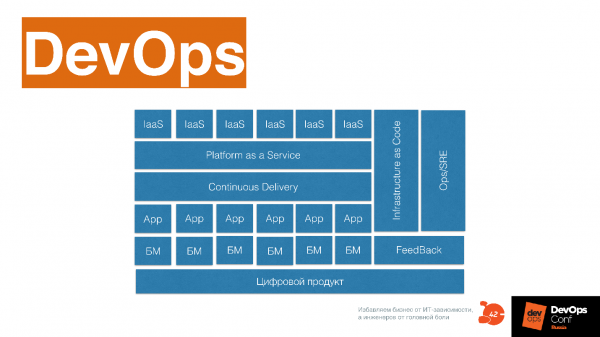
Можете да използвате тази схема, оцветявайки в нея това, което вече имате в компанията в някаква форма: то се е развило или все още трябва да се развие.
Вече след няколко седмици ще се проведе . в състава на РИТ++. Заповядайте на конференцията, където ви очакват много интересни лекции за непрекъсната доставка, инфраструктура като код и DevOps трансформация. , крайният срок за цени е 20 май
Източник: habr.com
