

На 10 август в Слёрм започна , в който разглеждаме всичко — от основните абстракции до мрежовите параметри.
В тази статия ще говорим за историята на появата на Docker и неговите основни абстракции: Image, Cli, Dockerfile. Лекцията е предназначена за начинаещи, затова едва ли ще е интересна за опитни потребители. Тук няма да има кръв, апендикс и дълбочинно разглеждане. Само основите.
Какво е Docker
Нека да видим определението на Docker от Wikipedia.
Docker е софтуер за автоматизация на разгръщането и управлението на приложения в среди, поддържащи контейнеризация.
От това определение не става ясно нищо. Особено неясно е какво означава «в среди, поддържащи контейнеризация». За да разберем, нека да се върнем в миналото. Ще започнем от епохата, която наричам «Монолитна ера».
Монолитна ера
Монолитната ера — това е началото на 2000-те, когато всички приложения бяха монолитни, с множество зависимости. Разработката отнемаше дълго време. В същото време не беше толкова много сървърите, познавахме ги по име и ги наблюдавахме. Има едно интересно сравнение:
Pets — това са домашни любимци. В монолитната ера се отнасяхме към нашите сървъри, както към домашни любимци, грижехме се за тях, бяхме изключително внимателни. А за по-добро управление на ресурсите използвахме виртуализация: взимахме сървър и го разделяхме на няколко виртуални машини, осигурявайки по този начин изолация на средата.
Виртуализационни системи на базата на хипервизор
Вероятно всички са чували за виртуализационни системи: VMware, VirtualBox, Hyper-V, Qemu KVM и др. Те осигуряват изолация на приложенията и управление на ресурсите, но имат и недостатъци. За да извършите виртуализация, необходим е хипервизор. А хипервизорът е ресурсен наклад. И самата виртуална машина обикновено е цяла махина — тежък образ, на който е инсталирана операционна система, Nginx, Apache, възможно и MySQL. Образът е голям, неудобно е да се оперира с виртуалната машина. В резултат работата с виртуалките може да бъде бавна. За да решат този проблем, създадоха системи за виртуализация на ядрото.
Системи за виртуализация на ядрото
Виртуализацията на ядрото се поддържа от системи като OpenVZ, Systemd-nspawn, LXC. Ясен пример за такава виртуализация е LXC (Linux Containers).
LXC е система за виртуализация на ниво операционна система, която позволява стартирането на няколко изолирани инстанции на операционната система Linux на един хост. LXC не използва виртуални машини, а създава виртуална среда със собствено пространство за процеси и мрежов стек.
Всъщност, LXC създава контейнери. Каква е разликата между виртуалните машини и контейнерите?
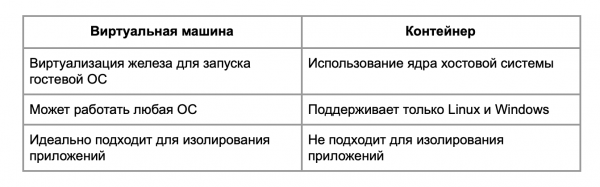
Контейнерът не е подходящ за изолиране на процеси: в системите за виртуализация на ниво ядро се откриват уязвимости, които позволяват излизане от контейнера на хоста. Затова, ако трябва да изолирате нещо, е по-добре да използвате виртуална машина.
Разликите между виртуализацията и контейнеризацията могат да се видят на схемата.
Има хардуерни хипервизори, хипервизори над операционната система и контейнери.
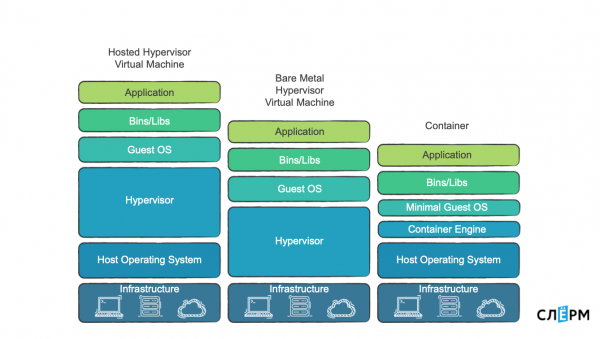
„Хардуерните“ хипервизори са нещо страхотно, ако наистина искате да изолирате нещо. Тъй като там имате възможността да изолирате на ниво страници на паметта и процесори.
Има хипервизори като програми и има контейнери, за които ще говорим по-нататък. В системите за контейнеризация няма хипервизор, а има Container Engine, който създава контейнери и ги управлява. Тази система е по-лека, затова поради работата с ядрото разходите са по-малки или изобщо ги няма.
Какво се използва за контейнеризация на ниво ядро
Основните технологии, които позволяват създаването на изолиран от другите процеси контейнер, са Namespaces и Control Groups.
Namespaces: PID, Networking, Mount и User. Има и други, но за опростяване на разбирането ще се спрем на тези.
PID Namespace ограничава процесите. Когато например създаваме PID Namespace и поставяме там процес, той получава PID 1. Обикновено в системите PID 1 е systemd или init. Съответно, когато поставим процес в новия namespace, той също получава PID 1.
Networking Namespace позволява ограничаване/изолиране на мрежата, а вътре в него да разполагате свои интерфейси. Mount е ограничение по файловата система. User е ограничение по потребителите.
Control Groups: Memory, CPU, IOPS, Network — общо около 12 настройки. Иначе се наричат Cgroups ("C-групи").
Control Groups управляват ресурсите за контейнера. Чрез Control Groups можем да укажем, че контейнерът не трябва да консумира повече от определено количество ресурси.
За да функционира контейнеризация пълноценно, се използват допълнителни технологии: Capabilities, Copy-on-write и други.
Capabilities е, когато казваме на процеса какво може и какво не може да прави. На ниво ядро, това е просто битова карта с много параметри. Например, потребителят root има пълни привилегии и може да прави всичко. Сървърът на времето може да променя системното време: той има capabilities за Time Capsule и готово. С помощта на привилегии можем гъвкаво да настроим ограничения за процесите и по този начин да се защитим.
Системата Copy-on-write ни позволява да работим с Docker образи, като ги използваме по-ефективно.
В момента Docker има проблеми със съвместимостта на Cgroups v2, затова в статията ще разгледаме именно Cgroups v1.
Но нека се върнем към историята.
Когато се появиха системите за виртуализация на ниво ядро, те започнаха да се прилагат активно. Oвърхедът на хипервизорите изчезна, но някои проблеми останаха:
- големи образи: в OpenVZ се натъпкват операционни системи, библиотеки, куп различен софтуер и в крайна сметка образът пак става доста голям;
- няма нормален стандарт за опаковане и доставка, затова остава проблемът с зависимостите. Има ситуации, когато два кода ползват една библиотека, но с различни версии. Между тях може да възникне конфликт.
За да решим всички тези проблеми, дойде следващата ера.
Ерата на контейнерите
С настъпването на Ерата на контейнерите се смени философията на работа с тях:
- Един процес — един контейнер.
- Всички зависимости, нужни на процеса, се доставят в неговия контейнер. Това изисква разпадане на монолити на микросервизи.
- Колкото по-малък е образът, толкова по-добре — по-малко възможни уязвимости, по-бързо разгръщане и така нататък.
- Инстансите стават ефимерни.
Спомняте ли си, че говорих за pets vs cattle? Преди инстансите бяха като домашни любимци, а сега станаха като cattle — добитък. Преди имаше монолит — едно приложение. Сега това са 100 микросервиза, 100 контейнера. Някои от контейнерите може да имат по 2-3 реплики. За нас не е толкова важно да контролираме всеки контейнер. По-скоро, важно ни е достъпността на самата услуга: това, което прави този набор от контейнери. Това променя подходите в мониторинга.
През 2014-2015 година настъпи разцветът на Docker — технологията, за която ще говорим сега.
Docker промени философията и стандартизира опаковането на приложенията. С Docker можем да опаковаме приложение, да го изпратим в хранилище, да го изтеглим оттам и да го разпънем.
В Docker-контейнера включваме всичко необходимо, затова проблемът със зависимостите се решава. Docker гарантира възпроизводимост. Мисля, че много хора са се сблъсквали с невъзпроизводимост: всичко работи при вас, но след като го пускате в продукция, там спира да работи. С Docker този проблем изчезва. Ако вашият Docker-контейнер се стартира и прави това, което трябва, то с голяма вероятност той ще стартира и в продукция и там ще направи същото.
Отклонение за оверхед
По въпроса за оверхед постоянно се водят спорове. Някои смятат, че Docker не носи допълнително натоварване, тъй като използва ядрото на Linux и всички его процеси, необходими за контейнеризация. Казват: "ако твърдите, че Docker е оверхед, то тогава и ядрото на Linux е оверхед".
От друга страна, ако се задълбочим, в Docker наистина има някои неща, за които с известна доза натягане може да се каже, че това е оверхед.
Първото е PID пространство. Когато поставим процес в пространство, му се присвоява PID 1. В същото време този процес има и друг PID, който се намира в хостовото пространство, извън контейнера. Например, стартираме Nginx в контейнера, той става PID 1 (мастър-процес). А на хоста той има PID 12623. И е трудно да се каже доколко това е оверхед.
Второто нещо е Cgroups. Да вземем Cgroups за памет, тоест възможността да ограничаваме паметта на контейнера. При активирането им се активират броячи, memory accounting: на ядрото му трябва да разбере колко страници са разпределени и колко още свободни са за този контейнер. Това е възможен оверхед, но не съм срещал точни изследвания за това как той влияе на производителността. И сам не съм забелязал, че приложение, стартирано в Docker, рязко да губи производителност.
И още едно забележка за производителността. Някои параметри на ядрото се предават от хоста в контейнера. По-конкретно, някои мрежови параметри. Затова, ако искате да стартирате нещо с висока производителност в Docker, например нещо, което активно ще използва мрежата, трябва поне да коригирате тези параметри. Някакъв nf_conntrack, например.
За концепцията на Docker
Docker се състои от няколко компонента:
- Docker Daemon — това е Container Engine; стартира контейнери.
- Docker CII — инструмент за управление на Docker.
- Dockerfile — инструкция за изграждане на образ.
- Image — образ, от който се разгръща контейнер.
- Контейнер.
- Docker registry — хранилище на образи.
Схематично, това изглежда по следния начин:
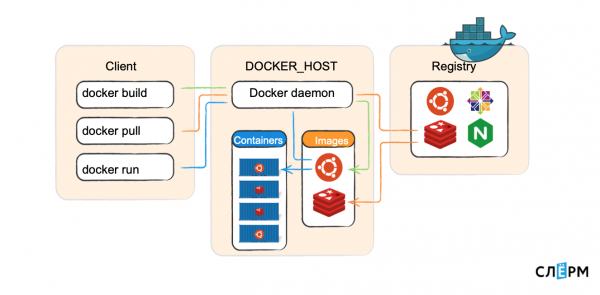
На Docker_host работи Docker daemon, който стартира контейнери. Има Client, който предава команди: изграждане на образ, сваляне на образ, стартиране на контейнер. Docker daemon проверява в registry и изпълнява тях. Docker клиентът може да се свърже както локално (към unix-сокет), така и по TCP от отдалечена хост машина.
Нека разгледаме всеки компонент.
Docker daemon (демон) — това е сървърната част, работеща на хост машината: сваля образи и стартира контейнери, създава мрежа между контейнерите, събира логове. Когато казваме „създай образ“, това също е задача на демона.
Docker CLI — клиентската част на Docker, конзолен инструмент за работа с демона. Повтарям, той може да работи не само локално, но и по мрежата.
Основни команди:
docker ps — показва контейнерите, които в момента са стартирани на Docker хоста.
docker images — показва локално изтеглените образи.
docker search <> — търсене на образ в registry.
docker pull <> — сваляне на образ от registry на машината.
docker build <<\/path\/to\/dir>> — изграждане на образ.
docker run <> — стартиране на контейнер.
docker rm <> — изтриване на контейнер.
docker logs <> — логове на контейнера
docker start\/stop\/restart <> — работа с контейнера
Ако усвоите тези команди и уверено ги използвате, считайте, че сте овладели Docker на потребителско ниво на 70%.
Dockerfile — инструкция за създаване на образ. Почти всяка команда в инструкцията — нов слой. Нека видим на примера.
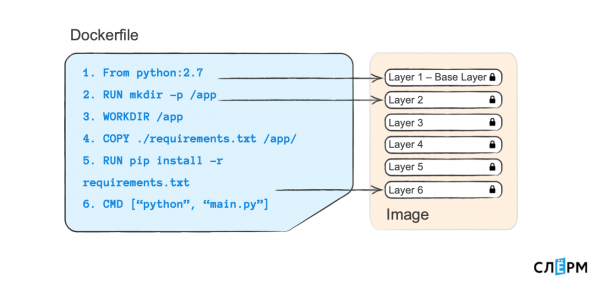
Ето как изглежда Dockerfile: отляво командите, отдясно — аргументите. Всяка команда, която тук присъства (и която изобщо се пише в Dockerfile), създава нов слой в Image.
Дори заглеждайки лявата част, можете да разберете какво се случва. Казваме: „създай ни папка“ — това е един слой. „Направи папката работна“ — това е още един слой и така нататък. Слоестият пай простира живота. Ако създам още един Dockerfile и променя нещо в последния ред — вместо "python" "main.py" да пусна нещо друго или да инсталирам зависимости от друг файл — предишните слоеве ще се преизползват, като кеш.
Снимка — това е опаковка на контейнер, от която се стартират контейнерите. Ако разглеждаме Docker като пакетен мениджър (с все едно работим с deb или rpm пакети), то образът (image) е по същество rpm пакет. Чрез yum install можем да инсталираме приложение, да го премахваме, да го търсим в хранилището, да го изтегляме. Тук е подобно: от образа се стартират контейнерите, те се съхраняват в Docker registry (подобно на yum, в хранилището), и всеки образ има SHA-256 хеш, име и таг.
Образът се изгражда по инструкции от Dockerfile. Всяка инструкция от Dockerfile създава нов слой. Слоевете могат да бъдат използвани повторно.
Docker registry — това е хранилище на Docker образи. Подобно на ОС, Docker има обществен стандартен регистър — dockerhub. Но може да съберете свое собствено хранилище, свой Docker registry.
Контейнер — това, което се стартира от образа. По инструкциите от Dockerfile изградихме образ, след това го стартираме от този образ. Този контейнер е изолиран от останалите контейнери и трябва да съдържа всичко необходимо за работата на приложението. В същото време един контейнер — един процес. Случва се понякога да се налага да правим два процеса, но това малко противоречи на идеологията на Docker.
Изискването "един контейнер — един процес" е свързано с PID Namespace. Когато в Namespace стартира процес с PID 1, ако той изведнъж умре, тогава целият контейнер също умира. Но ако там са стартирани два процеса: единият оцелее, а вторият е умрял, контейнерът все пак ще продължи да живее. Но това е въпрос на Best Practices, за които ще говорим в други материали.
По-подробно изследване на особеностите и пълната програма на курса можете да намерите на линка: "».
Автор: Марсел Ибраев, сертифициран администратор Kubernetes, практикуващ инженер в компанията Southbridge, лектор и разработчик на курсове в Слёрм.
Източник: habr.com
