

Нека да обсъдим защо CI инструментите и CI действително представляват съвсем различни неща.
Каква болка се стреми да разреши CI, откъде дойде идеята, какви са последните доказателства, че работи, как да разберем, че имаме практика, а не просто инсталиран Jenkins.
Мисълта за доклад относно Continuous Integration се появи преди година, когато посещавах интервюта за работа. Разговарях с 10-15 компании, от които само една можа да обясни какво е CI и как разбраха, че нямат такова нещо. Останалите обясняваха неразбираемо за Jenkins 🙂 Е, имаме Jenkins, той прави сборки, CI! В доклада ще се опитам да обясня какво всъщност е Continuous Integration и защо Jenkins и подобни инструменти имат много слабо отношение към това.
И така, какво обикновено идва на ум, когато чуете CI? На повечето хора им идва на ум Jenkins, Gitlab CI, Travis и т.н.
Дори и да потърсим в Google, също ще ни предложат тези инструменти.
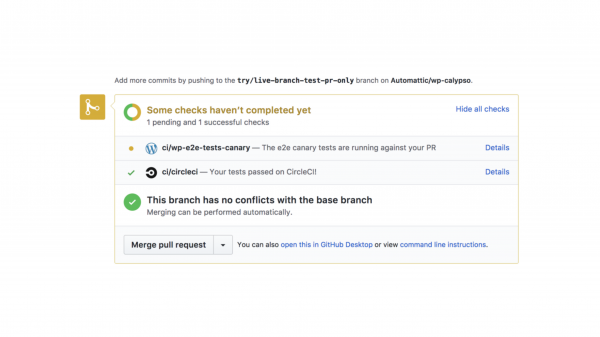
Ако питате познати, след като изброят инструментите, ще ви кажат, че CI е когато в Pull Request за комит се извършва сборка и тестове.
Continuous Integration не е свързано с инструментите, не е за сборки с тестове в клон! Continuous Integration е практика за много честа интеграция на нов код и за нейното приложение не е необходимо да строите Jenkins-и, GitLab-и и т.н.
Преди да разберем как изглежда пълноценно CI, нека първо се потопим в контекста на хората, които го измислиха, и усетим болката, която се опитваха да разрешат.
А те разрешаваха болката от съвместната работа в екип!
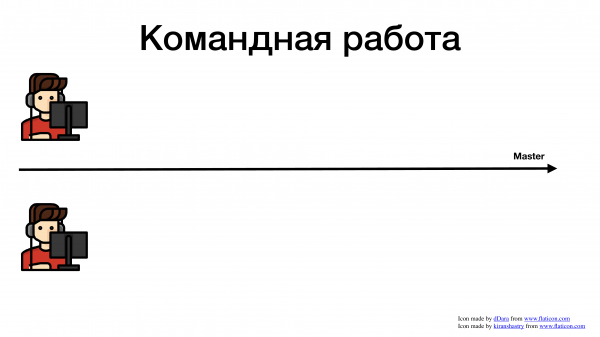
Нека да разгледаме примери за трудностите, с които се сблъскват разработчиците при екипна работа. Имаме проект, основен клон в git и двама разработчици.
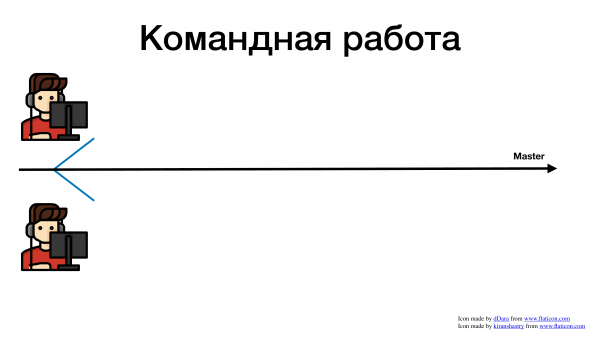
И те започват да работят както всички отдавна сме свикнали. Взимат задача в JIRA, създават feature branch и пишат код.
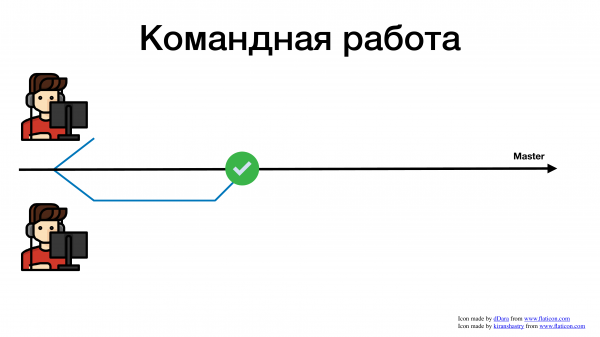
Един завършва функцията по-бързо и я слива в master.
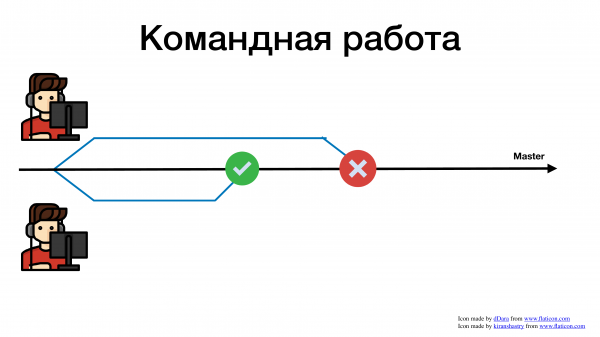
На другия му отнема повече време, той се слива по-късно и получава конфликт. Вместо да пише нужните на бизнеса функции, разработчикът губи времето и силите си за разрешаване на конфликти.
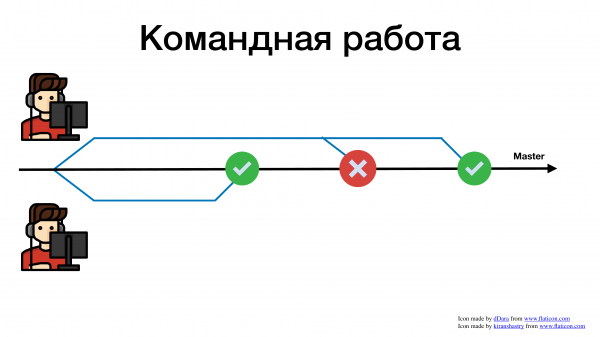
Колкото по-сложно е да се интегрира вашата функция с общия мастер, толкова повече време ще отнеме това. А това е един сравнително прост пример, в който разработчиците са само двама. Представете си, ако в компанията има 10, 15 или 100 души, които пишат в едно репо. Ще полудеете, опитвайки се да разрешите всички тези конфликти.
Има малко по-различен случай. Имаме мастер и няколко разработчици, които правят нещо.
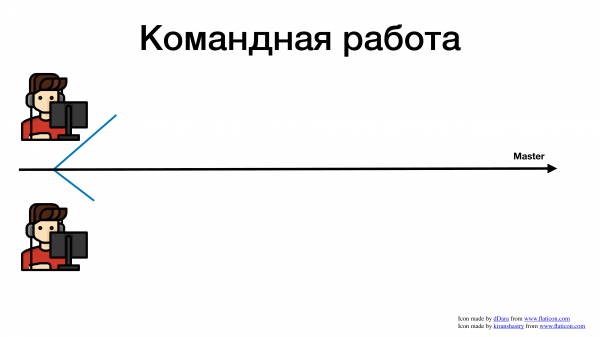
Те създадоха по един клон.
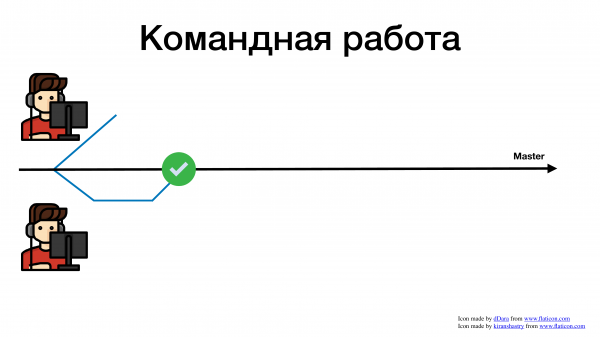
Един се е слел, всичко е наред, той предаде задачата си.
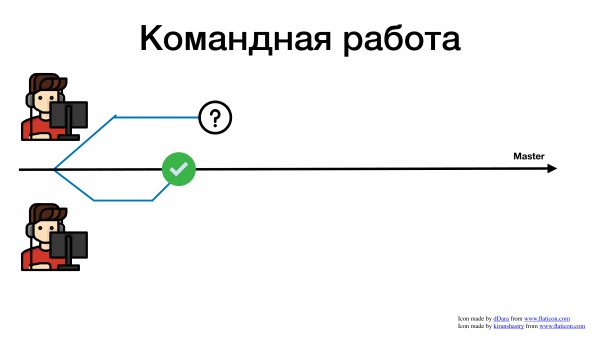
Междувременно вторият разработчик е предал задачата си. Да предположим, че е подал я за ревю. В много компании има практика - ревю. От една страна, това е добра и полезна практика, от друга страна, това ни забавя в много отношения. Няма да навлизаме в това, но ето един чудесен пример за това какви последици може да доведе странната история с ревюто. Подадохте pull request за ревю. На разработчика не му остава нищо друго за правене. Какво започва да прави? Започва да взима други задачи.
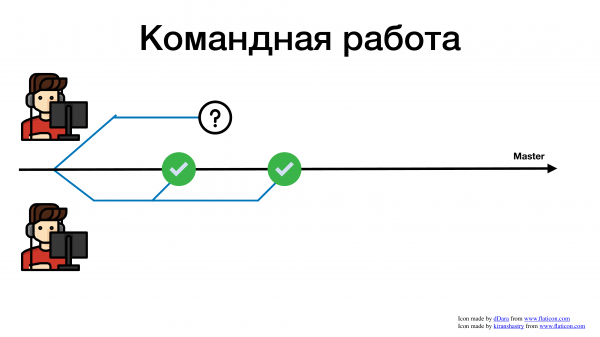
През това време вторият разработчик е направил нещо друго.
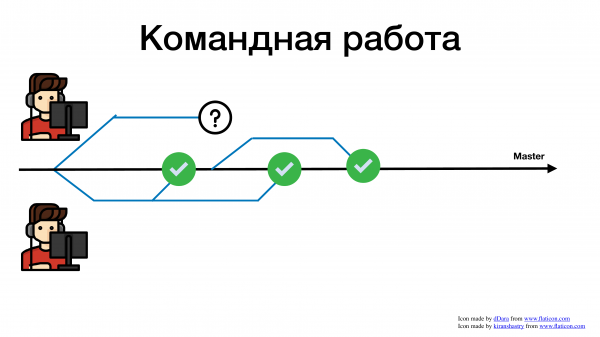
Първият е изпълнил третата задача.
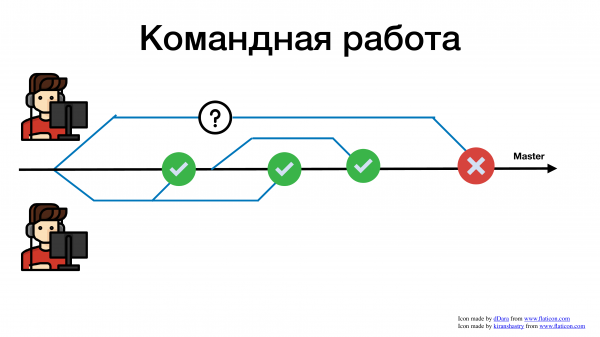
И след известно време, неговото ревю е тестирано и той се опитва да се слее. И какво се случва? Хваща огромно количество конфликти. Защо? Защото докато неговият pull request е висял за ревю, в кода вече е станало много промени.
Освен историята с конфликтите, има и история с комуникацията. Докато вашият клон вися на ревю, докато чака нещо, докато продължавате да работите по функцията, спирате да проследявате какво още се променя в кодовата база на вашата услуга. Може би това, което в момента се опитвате да решите, вече е решено вчера и можете да вземете и да преизползвате някакъв метод. Но няма да го видите, защото винаги работите с остарял клон. И този остарял клон винаги води до това, че ще трябва да разрешите merge conflict.
Получава се, че ако работим в екип, т.е. ако не един човек се заиграва с репото, а 5-10 души, то колкото по-дълго не добавяме нашия код в мастер, толкова повече страдаме от факта, че в крайна сметка трябва да се слеем нещо. И колкото повече конфликти имаме, и с по-стара версия работим, толкова повече проблеми имаме.
Да правим нещо заедно е трудно! Винаги си пречим.
На този проблем обърнаха внимание преди повече от 20 години. Първото споменаване на практиката Continuous Integration намерих в екстремното програмиране.
Екстремното програмиране е първият agile framework. Страницата се появи през 96-та година. Целта беше да се използват различни практики на програмиране, планиране и други, за да се разработи софтуерът възможно най-гъвкаво, позволявайки ни да реагираме по-бързо на промени и изисквания от клиентите. И те преди 24 години започнаха да се сблъскват с проблема, че ако правиш нещо много дълго и встрани, влагаш повече време, защото имаш конфликти.
Сега ще разгледаме термина 'Continuous Integration' по отделни думи. Ако преведем буквално, получава се непрекъсната интеграция. Обаче колко точно е непрекъсната, не е много ясно, тя е доста прекъсната. Доколко е интеграция също не е съвсем очевидно.
И затова в момента ви представям цитати от екстремното програмиране. Ще разгледаме двете думи поотделно.
Integration — Както вече споменах, целим всеки инженер да работи с най-актуалната версия на кода, да добавя своя код възможно най-често в основната клонка, така че това да са малки клонки. Защото ако клонките са големи, можем лесно да заседнем за седмица с мерж-конфликти. Особено, ако имаме дълъг цикъл на разработка, тип waterfall, където разработчикът е изчезнал за месец, за да реализира някаква голяма функция. И в етапа на интеграция може да заседне за много дълго.
Integration – това е, когато взимаме своя клон и го интегрираме с мастера, мержим го. Съществува и крайният вариант, когато трансформираме разработчика, при който целим да пишем директно в мастера без излишни клонки.
В общи линии, integration – това е да вземеш своя код и да го принесеш в мастера.
Какво се има предвид под термина «непрекъснат» и какво означава непрекъснатост? Практиката предполагава, че разработчикът се стреми да интегрира кода си възможно най-бързо. Това е неговата цел при изпълнението на всяка задача - да гарантира, че кодът му ще се появи в основния клон възможно най-бързо. В идеалния свят разработчиците ще правят това на всеки няколко часа. Т.е. взимаш малка задача, сливаш я в основния клон. Всичко е чудесно. Ти се стремиш към това. И трябва да го правиш непрекъснато. Щом направиш нещо, веднага го слагаш в основния клон.
И разработчикът, който извършва нещо, носи отговорност за това, което е направил, за да работи и да не счупи нещо. Тук обикновено се появява въпросът с тестовете. Искаме да пуснем някакви тестове на нашия комит, на нашето сливане, за да се уверим, че всичко работи. И тук може да ти помогне Jenkins.
Но с историите: нека промените да са малки, нека задачите да са малки, нека направим задачата и веднага опитаме да я слеем в основния клон – тук нищо не може да ти помогне, дори Jenkins. Защото Jenkins може да ти помогне единствено да стартира тестовете.
Можеш да се справиш и без тях. Това никак няма да ти пречи. Защото целта на практиката е да се сливаш възможно най-често, за да не губиш много време за конфликти в бъдеще.
Да предположим, че имаме 2020 година, по някаква причина без интернет. И работим локално. Нямаме Jenkins. Това е наред. Все още можеш да вземеш и да създадеш локален клон. Написал си някакъв код в него. Изпълнил си задача за 3-4 часа. Превключил си на основния клон, направил си git pull, слял си своя клон. Готово. Ако правиш това често – поздравления, имаш Непрекъсната Интеграция!
Какви доказателства има в съвременния свят, че си струва да се влагат усилия в това? Защото общо взето е сложно. Ако се опиташ да работиш по този начин, ще разбереш, че ще се наложи да планираш, ще ти отнеме повече време детайлно да декомпозираш задачите. Защото ако правиш man…, няма да можеш бързо да се слееш и съответно ще попаднеш в затруднено положение. Няма да имаш практиката.
И това ще струва скъпо. Работа по Continuous Integration няма да започне от утре. Всички вие ще свиквате много дълго, много дълго ще се учите да разглобявате задачите, много дълго ще се учите да преработвате практиката на ревюто, ако я имате. Защото нашата цел е да се слеят днес. А ако правите ревю в рамките на три дни, то имате проблеми и Continuous Integration не работи.
Но имаме актуални доказателства точно сега, които ни казват, че инвестиране в тази практика има смисъл?
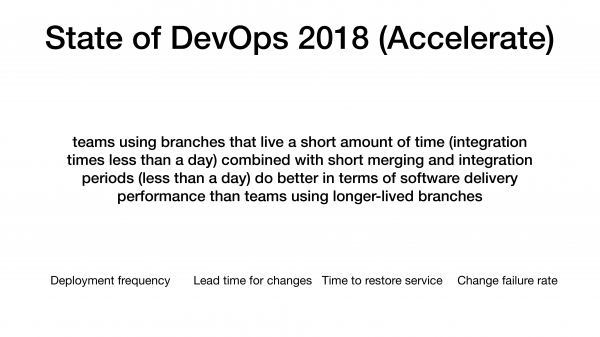
Първото, което ми дойде на ум, е State of DevOps. Това е проучване, което момчетата правят вече 7 години. Сега го правят като независима организация, но под Google.
И тяхното проучване от 2018 година показа корелация между компаниите, които се опитват да използват краткоживеещи клонове, които се интегрират бързо и често, имат по-добри показатели на производителността на IT.
Какви са тези показатели? Това са 4 метрики, които те получават от всички компании в своите анкети: честота на внедряване, време за промени, време за възстановяване на услугата, процент на неуспешни промени.
И на първо място, имаме тази корелация, знаем, че компаниите, които често се сливат, имат значително по-добри тези метрики. И те имат разделение на компаниите на няколко категории: бавни компании, които произвеждат нещо бавно; средно представящи се; високо представящи се и елита. Елита – това са Netflix, Amazon, които са супер бързи, правят всичко бързо, красиво и качествено.
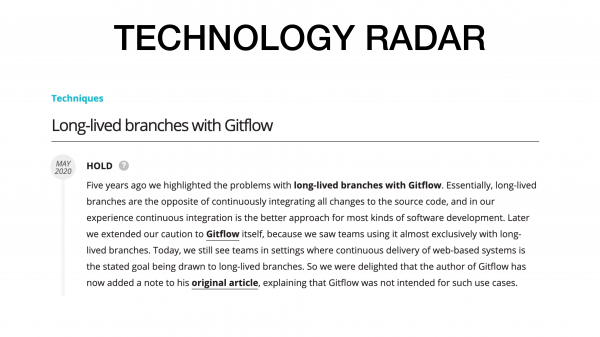
Втората история, която се случи преди месец. В Technology Radar се появи забележителна бележка за Gitflow. Gitflow се различава от всички останали, тъй като неговите клонове живеят дълго. Има релизни клонове, които живеят дълго, клоновете с функции също живеят дълго. Тази практика в Technology Radar се премести в HOLD. Защо? Защото хората се сблъскват с проблеми при интеграцията.
Ако клонът ти живее много дълго, той застоява, остарява, и започваме да харчим повече време, за да внесем в него някаква промяна.
И наскоро автор на Gitflow заяви, че ако търсите Continuous Integration и искате да внедрявате нови функции колкото се може по-често, Gitflow не е добър избор. Той допълва в статията, че ако имате бекенд, за който можете да се стремите към това, Gitflow за вас е излишен, защото ще ви забави и ще ви създаде проблеми с интеграцията.
Това не означава, че Gitflow е лош и не трябва да се използва. Той е подходящ за други случаи. Например, когато трябва да поддържате множество версии на услуга или приложение, т.е. когато трябва да осигурите поддръжка за продължителен период от време.
Но ако поговорите с хора, които поддържат такива услуги, ще чуете много оплаквания относно това, че версия 3.2, която беше преди 4 месеца, не включва този фикс и сега, за да го включите, трябва да направите куп промени. И те отново попадат в задънена улица и прекарат седмица в опити да смесват нова функция.
Както Александър Ковалев правилно отбеляза в чата, корелацията не е равно на причинно-следствената връзка. Тоест, няма пряка връзка, че ако имате Continuous Integration, всички метрики ще са страхотни, не е така. Но има положителна корелация, че ако едното е налице, вероятно и другото също. Не е сигурно, но е вероятно. Това е просто корелация.
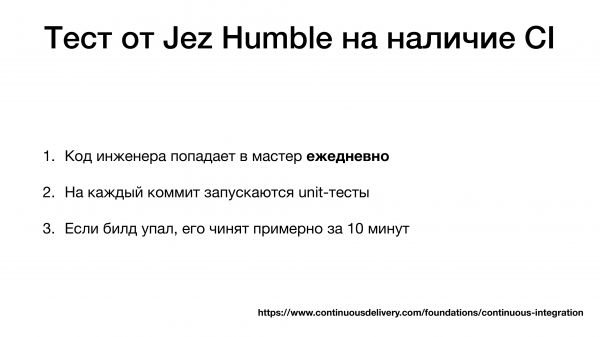
Изглежда, че вече правим нещо, изглежда, че вече се смесваме, но как да разберем, че всъщност имаме Continuous Integration и че правим сливане достатъчно често?
Джез Хъмбъл е автор на ръководството, Accelerate, сайта Continuous Delivery и книгата „Continuous Delivery“. Той предлага следния тест:
- Кодът на инженерите попада в основния клон ежедневно.
- При всеки комит стартирате unit тестове.
- Билдът в основния клон е провален и е поправен за около 10 минути.
Той предлага да се използва такъв тест, за да се уверите, че практиката ви наистина съществува.
Накрая намирам това малко спорно. Тоест, ако можете да го поправите за 10 минути, значи че имате Continuous Integration, звучи малко странно, според мен, но в това има смисъл. Защо? Защото, ако често правите merge, това означава, че промените са ви малки. Ако малка промяна доведе до счупване на билд на мастера, тогава ще можете бързо да намерите примера, защото промените са малки. Имали сте малък merge, в него са се променили 20-30 реда. И, съответно, можете бързо да разберете в какво е бил проблемът, защото промените са малки, имате много малка област за търсене на проблема.
И дори ако след релиза prod се развали, то ако имаме практика на Continuous Integration, ще ни е много по-лесно да действаме, защото промените са малки. Да, това ще засегне планирането. Ще бъде болезнено. И вероятно най-трудното в тази практика е да свикнеш да разбиваш задачите, т.е. как да вземеш нещо и да го свършиш за няколко часа, и същевременно да преминеш през ревю, ако има такова. Ревюто е отделна болка.
Unit-тестовете са просто помощник, който ви помага да разберете – дали вашата интеграция е успешна, дали нищо не е счупено. Според мен, това също не е съвсем задължителна точка, защото смисълът на практиката не е в това.
Това е набързо за Continuous Integration. Това е всичко, което има в практиката. Готов съм за въпроси.
Накратко още веднъж ще обобщя:
- Continuous Integration не е Jenkins, не е Gitlab.
- Това не е инструмент, това е практика за това, че ние колкото се може по-често слепваме нашия код в мастера.
- Правим това, за да избегнем огромната болка, която възниква с merge-овете в бъдеще, т.е. ние изпитваме малка болка сега, за да не изпитваме голяма в бъдеще. В това е целият смисъл.
- Отстрани комуникацията минава през кода, но рядко го виждам, но за това също е замислено.
Въпроси
Какво да правим с недекомпозирани задачите?
Декомпозирайте. Какъв е проблемът? Можете ли да приведете пример, че има задача и тя не се декомпозира?
Има такива задачи, които не могат да бъдат декомпозирани от дума 'абсолютно', например тези, които изискват много дълбока експертиза и които реално могат да се решават в продължение на месец до някакъв приемлив резултат.
Ако те разбрах правилно, значи имаш някаква голяма и сложна задача, чийто резултат ще е видим само след месец?
Да, всичко е точно. Да, резултатът може да се оцени не по-рано от месец.
Добре. По принцип това не е проблем. Защо? Защото в този случай, когато говорим за клонове, не говорим за клон с функция. Функциите понякога са големи и сложни. Те може да засягат много компоненти. И, възможно е, да не можем да ги направим във един клон напълно. Това е нормално. Просто трябва да разделим историята. Ако функцията не е напълно готова, това не означава, че не можем да обединим някои нейни части. Например, добавил си миграция и вътре в функцията има някакви стъпки. Имаш, например, стъпка – направи миграция, добави нов метод. И тези неща вече можеш да обединяваш ежедневно.
Добре. Какъв е смисълът тогава?
Какъв е смисълът да обединяваш малки неща ежедневно?
Да.
Ако нещо е счупило код, го виждаш веднага. Имаш малка част, която е счупила нещо, по-лесно е да я поправиш. Смисълът е, че е много по-лесно да обединиш малка част сега, отколкото нещо голямо след няколко седмици. И третият смисъл е, че другите инженери ще работят с актуалната версия на кода. Те ще виждат, че тук са добавени миграции, а тук е появил някакъв метод, който може и те да искат да използват. Всички ще виждат какво става в кода. Именно заради тези три неща се прави практиката.
Благодаря, въпросът е закрит!
(Олег Сорока) Може ли да добавя нещо? Всичко, което каза, е вярно, искам само да добавя една фраза.
Така.
При Continuous Integration кодът се обединява в общия клон не когато функцията е напълно готова, а когато билдът не се чупи. И спокойно комитвате в master колкото искате пъти на ден. Вторият аспект е, ако не можете по някаква причина да разделите месечната задача на задачи поне по три дни, да не говоря за три часа, означава, че имате огромен проблем. И фактът, че нямате Continuous Integration – това е най-малкия от тези проблеми. Това означава, че имате проблеми с архитектурата и инженерните практики са на нула. Защото дори и да става въпрос за изследвания, всяка цена трябва да бъде оформена под формата на хипотези или цикли.
Говорили сме за 4 метрики, които отличават успешните компании от изоставащите. До тези 4 метрики трябва да се стигне. Ако при вас средната задача отнема месец, то първо бих се концентрирал върху тази метрика. Ще я сваля първо до 3 дни. И след това ще започна да мисля за Continuous.
Правилно ли те разбрах, че мислиш, че е безсмислено да инвестираш в инженерни практики, ако всяка задача отнема месец?
Имаш Continuous Integration. И там има такава тема, че за 10 минути или поправяш грешката, или я връщаш. Представи си, че си го пуснал. Освен това имаш continuous deployment, пуснал си го в продукта и едва след това забелязваш, че нещо не е наред. И трябва да го върнеш, а вече си направил миграция на базата данни. Вече имаш схема на базата данни от следващата версия, а даже и някакъв бекъп е минал, а и данни са записани там.
И каква алтернатива имаш? Ако връщаш назад кода, той вече не може да работи с тази актуализирана база данни.
Базата се движи само напред, да.
При хората с лоша инженерна практика вероятно те също не са чели дебелата книга за… Какво да правиш с бекъпа? Ако се възстановяваш от бекъп, значи губиш данни, събрани през това време. Например, работил си три часа с новата версия на базата данни, потребители са се регистрирали там. Отказваш стария бекъп, защото с новата версия схемата не работи, следователно тези потребители ги губиш. А те са недоволни и се оплакват.
За да овладеете целия спектър от практики, които подкрепят Continuous Integration и Continuous Delivery, не е достатъчно просто да научите как да пишете… На първо място, може да станат много, което ще е непрактично. Освен това, има куп други практики, като Scientific. Има такава практика, която GitHub я популяризира много. Това е, когато имате едновременно стар код и нов код. Когато правите недовършена функция, но тя може да връща някаква стойност: или като функция, или като Rest API. Изпълнявате новия код, изпълнявате стария код и сравнявате разликата между тях. И ако има разлика, я логвате. По този начин знаете, че новата функция е готова да бъде внедрена върху старата, ако в течение на определено време не е имало разминавания между тези две.
Има стотици такива практики. Бих предложил да започнете с transbase development. Тя не е 100% свързана с Continuous Integration, но практиките са едни и същи, без едното другото трудно съществува.
Ти посочи transbase development като пример, където може да се видят практики, или предлагаш на хората да започнат да използват transbase development?
Да се види, тъй като не могат да я използват. За да я използват, трябва да прочетат много неща. И когато човек задава въпрос: „Какво да правя с функция, която отнема месец“, това означава, че не е чел за transbase development. И не бих препоръчал за момента. Бих посъветвал да се концентрират изцяло на темата как да се разбива архитектурно големи задачи на по-малки. В това е същността на декомпозицията.
Декомпозицията е един от инструментите на архитекта. Първо правим анализ, после декомпозиция, после синтез, а след това интеграция. По този начин всичко се сглобява. И до Continuous Integration трябва да се израсне през декомпозиция. Въпросите на първия етап възникват, а ние вече говорим за четвъртия етап, т.е. колкото по-често правите интеграция, толкова по-добре. Рано е още за нея, не е лошо първо да нарежете монолита си.
Трябва да нарисувате определено количество стрелки и квадратчета на някаква схема. Не можете да кажете, че сега ще покажа архитектурна схема на ново приложение и да покажа само едно квадратче, в което има зелена бутонка за приложението. Във всеки случай трябва да има повече квадратчета и стрелки. На всяка схема, която съм виждал, имаше повече от едно. И декомпозицията дори на ниво графично представяне вече се извършва. Затова квадратчетата могат да бъдат независими. Ако не, значи имам сериозни въпроси към архитекта.
Има въпрос от чата: «Ако ревюто е задължително и отнема дълго време, повече от ден?»
Имате проблеми с практиката. Не трябва да отнема ревюто повече от ден. Това е същата история като предишния въпрос, само малко по-мек. Ако ревюто отнема ден, значи, вероятно, става дума за много голямо изменение. Значи, трябва да се прави по-малко. В transbase development, който Олег препоръча, има такава концепция, наречена непрекъснато ревю. Идеята е, че правим толкова малък pull request умишлено, защото се стремим да се сливаме постоянно и на малки части. И следователно pull request променя една абстракция или 10 реда. Благодарение на това ревюто ни отнема няколко минути.
Ако ревюто отнема повече от ден, значи нещо не е наред. Първо, може да имате проблеми с архитектурата. Или е голямо парче код, на 1000 реда, например. Или архитектурата е толкова сложна, че човек не може да я разбере. Това е леко страничен проблем, но и той трябва да бъде решен. Може дори да не е необходимо ревю. Трябва да се помисли и над това. Ревюто е нещо, което ви забавя. То носи свои плюсове в общи линии, но трябва да разберете защо го правите. Това е начин за бързо предаване на информация, установяване на вътрешни стандарти или какво? Защо ви е нужно? Защото ревюто трябва да бъде или много бързо, или въобще да се отмени. Това е като transbase development – много красив принцип, но само за напреднали хора.
Относно 4-те метрики, бих препоръчал да ги измерите, за да разберете какво води до това. Да се погледне в цифрите, да се види картината, колко зле е всичко.
(Дмитрий) Готов съм да водя дискусия по този въпрос с теб. Цифрите и метриките са страхотни, практиките също. Но трябва да разберем – необходимо ли е това на бизнеса. Има бизнеси, на които не им трябва такава скорост на промяна. Знам компании, в които не могат да правят промени на всеки 15 минути. Не защото са лоши, а защото това е жизнен цикъл. И за да реализираш фича branches, фича toggle, са нужни дълбоки познания.
Трудно е. Ако искаш да прочетеш историята за фича toggle по-подробно, много я препоръчвам. . И има чудесна статия на Мартин Фаулър за фичите toggle: за различните видове, жизнените им цикли и т.н. Фича toggle – това е сложно.
И все пак не отговори на въпроса: "Нужен ли е Jenkins или не?"
Jenkins всъщност не е необходим в никакъв случай. Ако бъдем сериозни, инструментите: Jenkins, Gitlab ще ти донесат удобство. Ще можеш да видиш дали сборката е успешна или не. Те могат да ти помогнат, но няма да ти осигурят практиката. Могат да ти дадат просто кръгчета – Ок, не Ок. И то, ако пишеш тестове, защото ако нямаш тестове, това е почти безсмислено. Затова е нужен, просто защото е по-удобно, но като цяло можеш и без него, няма да загубиш много.
Т. е. ако имаш практики, значи, че той не ти е нужен?
Изцяло вярно. Препоръчвам теста на Jez Humble. И имам двусмислено отношение към последния пункт. Но като цяло, ако имаш три неща: постоянно се сливате, пускаш тестове на комити в майстора, бързо поправяш билд в майстора, тогава вероятно не ти трябва нищо повече.
Докато чакаме въпроси от участниците, имам въпрос. Говорихме за продуктовия код. А използвал ли си за инфраструктурния код? Това е същият код, с същите принципи и жизнен цикъл, или има ли различни жизнени цикли и принципи? Обикновено, когато всички говорят за Непрекъсната Интеграция и Развитие, всички забравят, че има и инфраструктурен код. И в последно време той става все повече. И трябва ли да внесем всички тези правила там?
Не само, че трябва, но това ще бъде страхотно, защото точно така ще улесни живота. Щом работим с код, а не с bash скриптове, а имаме нормален код.
Стоп-стоп, bash скриптът също е код. Не пипайте моя стара любов.
Добре, няма да стъпча спомените ти. Имам лична неприязън към bash. Той се проваля грозно и страшно постоянно. И се проваля често непредсказуемо, затова го недолюбвам. Но добре, да предположим, че имаш код на bash. Може би наистина не разбирам и там има нормални фреймворкове за тестване. Просто не съм запознат. И получаваме същите предимства.
В момента когато работим с инфраструктурата като код, получаваме всички същите проблеми като разработчиците. Преди няколко месеца се сблъсках с ситуация, в която колега ми изпрати pull request от 1 000 реда на bash. И ти засядаш на ревюто за 4 часа. Проблемите съвпадат. Все още е код. И все още е съвместна работа. Засядаме с pull request и засядаме с решаването на същите merge конфликти на същия bash, например.
В момента много активно наблюдавам всичко това във възможно най-красивото програмиране на инфра. Сега внедрих Pulumi в инфраструктурата. Това е чисто програмиране. Там е още по-привлекателно, защото имам всички възможности на езика за програмиране, т.е. с помощта на същите if-и направих красиви превключватели и всичко е наред. Т.е. моето изменение вече е в мастера. Всички го виждат. Други инженери са запознати с него. То вече е повлияло на нещо. Но в същото време не е активирано за всички инфраструктури. Активирано е за моите тестови среди, например. Следователно отговаряйки на въпроса ти отново, необходимо е. То определено ни улеснява живота като инженери, работещи с код.
Има ли още въпроси?
Имам въпрос. Искам да продължа дискусията с Олег. Всъщност мисля, че си прав, че ако задачата ти отнема месец, имаш проблем с архитектурата, имаш проблем с анализа, декомпозицията, планирането и т.н. Но имам чувството, че ако започнеш да се опитваш да живееш по Continuous Integration, ще започнеш да коригираш проблемите с планирането, защото няма да можеш да избягаш от тях.
(Олег) Да, така е. По трудоемкост тази практика е сравнима с всяка друга сериозна практика, която променя културата. Най-трудното в преодоляването е навиците, особено лошите навици. И ако за внедряването на тази практика е необходимо сериозно изменение на навиците на околните: разработчици, ръководство, мениджър на продукцията, ви чакат изненади.
Какви могат да бъдат изненадите? Да предположим, че решавате да правите интеграция по-често. И на интеграцията са свързани други неща, да речем, артефакти. А в компанията ви, например, има политика, че всеки артефакт трябва да бъде по някакъв начин отчетен в система за складиране на артефакти. И това отнема известно време. Човекът трябва да сложи отметка, че той, като мениджър на релиза, е одобрил този артефакт за готовност за пускане в продукция. Ако това отнема 5-10-15 минути, но в същото време правите издаване веднъж седмично, то да отделяте половин час веднъж седмично е малък данък.
Ако правите Continuous Integration 10 пъти на ден, трябва да умножите 10 пъти по 30 минути. И това надвишава работното време на този мениджър на релизите. Той просто се уморява да го прави. Има постоянни разходи за някои практики. И всичко.
И вие трябва или да отмените това правило, за да не се занимавате с подобни неща, т.е. да не присвоявате ръчно степен на съответствие на нещо на нещо. Вие напълно разчитате на някакъв автоматизиран набор от тестове за готовност.
И ако ви трябва от някого потвърждение, за да го подпише главният, и вие не влизате в продукция без разрешението на Васил и т.н. – всичко това е пречка за практиките. Защото, ако има свързани като данък активности, всичко увеличава 100 пъти. Затова промяната ще бъде възприета не от всички радостно. Защото навиците на хората е трудно да се коригират.
Когато човек извършва своята рутинна работа, той я прави почти без да мисли. Неговата когнитивна натовареност е равна на нула. Той просто действа по готовите инструкции, в главата му вече има чек-лист, той го е правел хиляди пъти. И веднага щом дойдеш и му кажеш: „Нека отменим тази практика и от понеделник внедрим нова“, за него това става огромно когнитивно натоварване. Освен това то настъпва веднага за всички.
Затова най-простото, разбира се, не всеки може да си позволи тази луксозна възможност, но аз винаги правя точно така. Когато стартира нов проект, обикновено веднага в него се вкарват всички непроверени практики. Докато проектът е млад, ние не рискуваме особено. Продуктът все още не е наличен, няма какво да се срине. Затова може да се използва като тренировка. Този подход работи. Но не всички компании имат възможност да стартират такива проекти често. Въпреки че това също е малко странно, защото сега постоянно се извършва цифрова трансформация, всички трябва да стартират експерименти, за да настигнат конкурентите.
Тук се сблъскваш с това, че първо трябва да имаш разбиране за това, което трябва да направиш. Светът не е перфектен, продуктът също не е перфектен.
Да, тези неща са свързани.
Бизнесът също не винаги има разбиране, че трябва да се насочи в определена посока.
Има ситуация, при която никакви промени не са възможни. Това е ситуация, в която натискът върху екипа е по-голям. Екипът е доста изтощен вече. Той няма никакво резервно време за експерименти. От сутрин до вечер се работи по нови функции. А ръководството иска все повече и повече функции. В такава ситуация никакви промени не са възможни. Екипът може само да бъде информиран, че утре ще работим по същия начин, както и вчера, просто трябва да направим повече функции. Никакви преходи към каквито и да е практики в този смисъл не са възможни. Това е класическа ситуация, когато няма време да се точи брадвата, трябва да се секат дървета, затова се секат със счупен нож. Тук няма прости съвети.
(Дмитрий) Ще прочета уточнение от чата: «Но е нужно голямо покритие с тестове на различни нива. Колко време се отдава на тестовете? Как-то скъпо, отнема много време».
(Олег) Това е класическо заблуждение. Тестовете трябва да са достатъчни, за да имате собствена увереност. Непрекъснатата интеграция не е нещо, при което първо трябва да има 100% тестове и едва след това да започнете да прилагате тази практика. Непрекъснатата интеграция намалява когнитивната ви тежест, тъй като всяка от промените, които виждате, е толкова очевидна, че разбирате дали ще счупи нещо или не, дори и без тестове. Вие можете да го тествате бързо в главата си, защото са малки промени. Дори ако имате само ръчни тестери, на тях също е по-лесно. Вие изкарвате нова версия и казвате: 'Погледни, не е ли счупено?'. Те проверяват и казват: 'Не, няма нищо счупено'. Защото тестерът знае къде да гледа. Имате един комит, свързан с един фрагмент код. И това експлоатира конкретно поведение.
Тук, разбира се, ти малко украсих.
(Дмитрий) Тук не съм съгласен. Има практика - разработка през тестиране, която точно от това ще ви спаси.
(Олег) Ето, до това не бях стигнал. Първата илюзия е, че трябва да напишете точно 100% тестове или изобщо да не се занимавате с непрекъсната интеграция. Това е лъжа. Това са две паралелни практики. И те не зависят пряко една от друга. Вашето покритие на тестове трябва да е оптимално. Оптимално означава, че вие самите сте уверени, че качеството на майстора, което остава след комита, позволява с увереност да натиснете бутона 'Deploy' в петък вечер в нетрезво състояние. Как постигате това? Чрез ревю, чрез покритие, чрез добро наблюдение.
Добро наблюдение не се различава от тестовете. Ако стартирате тестовете веднъж на pre prod, те проверяват всичките ви потребителски сценарии само веднъж. А ако ги стартирате в безкраен цикъл, това е вашата разширена система за мониторинг, която непрекъснато тестира – паднало ли е или не. В този случай разликата е само в еднократността или многократността. Много добър набор от тестове…, стартирани безкрайно, това е мониторинг. И правилното наблюдение трябва да бъде такова.
И затова как точно ще постигнете това състояние, когато в петък вечер ще се разположите и ще си тръгнете вкъщи, е друг въпрос. Може би, просто сте смел идиот.
Нека да се върнем малко назад към Continuous Integration. Избягали сме в една по-сложна практика.
Илюзия номер две е, че MVP трябва да се прави бързо, затова тестовете изобщо не са нужни. Не е съвсем така. Работата е там, че когато пишете user story за MVP, можете да я разработите или на чисто, т.е. чули сте за нея и веднага започвате да я кодите, или да работите по TDD. И по TDD, както показва практиката, не отнема повече време, т.е. тестовете са страничен ефект. Практиката на TDD не е да тества. Въпреки че се нарича Test Driven Development, става дума не за тестове. По-скоро това е архитектурен подход. Това е метод за писане на точно това, което е необходимо, и за избягване на ненужното. Тази практика фокусира вниманието върху следващата итерация на вашето развитие в контекста на създаването на архитектурата на приложението.
Така че не е лесно да се избавим от тези илюзии. MVP и тестовете не се изключват взаимно. Даже напротив, ако правите MVP по практиката на TDD, ще го направите по-добре и по-бързо, отколкото ако работите изцяло на опип.
Това е много неочевидна и сложна мисъл. Когато чуете, че сега ще пишете и тестове, и че ще свършите нещо по-бързо, звучи абсолютно неадекватно.
(Дмитрий) Много хора, когато говорят за MVP, просто им мързи да пишат нещо смислено. Това все пак са различни неща. Не трябва да превръщате MVP в нещо лошо, което не работи.
Да-да, прав си.
А после изведнъж MVP в продукция.
Завинаги.
А TDD звучи много необичайно, когато слушате, че пишете тестове и уж правите повече работа. Звучи много странно, но в действителност така наистина става по-бързо и по-привлекателно. Когато пишете тест, в главата си вие много мислите за това какъв код ще използвате и как ще бъде извикван, а също и какво поведение очаквате от него. Не казвате просто, че сте написали някаква функция и тя прави нещо. Първо мислите за условията й, за начина, по който ще бъде извикана. Тук покривате тестовете и от това разбирате как ще изглеждат интерфейсите във вашия код. Това силно влияе на архитектурата. Кодът ви автоматично става по-модулен, защото първо се опитвате да разберете как ще го тествате, а едва след това го пишете.
При мен с TDD се получи така, че в някакъв момент наех ментор по Ruby, когато все още бях програмист на Ruby. Той каза: „Нека ти да правиш по TDD“. И си помислих: „Чудесно, сега ще трябва да пиша нещо допълнително“. И се споразумяхме, че в продължение на две седмици ще пиша целия работен код на Python по TDD. След две седмици разбрах, че вече не искам обратно. След две седмици опити да прилагам това, осъзнаваш колко по-лесно стана дори просто да мислиш. Но това не е очевидно, затова препоръчвам на всички, които мислят, че TDD е сложно, дълго и ненужно, да опитат да се придържат към него поне две седмици. На мен ми стигнаха две за това.
(Дмитрий) Можем да разгърнем тази идея от гледна точка на експлоатацията на инфраструктурата. Преди да пуснем нещо ново, правим мониторинг, а след това пускаме. В този случай мониторингът става нормално тестване. И има разработка чрез мониторинг. Но почти всички казват, че е дълго, мързи ги, създават временно черново. Ако направим нормален мониторинг, разбираме състоянието на CI системата. А в CI системата има много мониторинг. Разбираме състоянието на системата, разбираме какво има вътре. И по време на разработката точно правим системата така, че да достигне нужното състояние.
Тези практики са известни отдавна. Обсъждахме ги преди около 4 години. Но през последните 4 години почти нищо не се е променило.
Но на тази нотка предлагам официалната дискусия да приключим.
Видео (включено като медийен елемент, но по някаква причина не работи):
Източник: habr.com
