

Темата DevOps в момента е на бум. Конвейер за непрекъсната интеграция и доставка я се внедрява от всички, които имат желание. Но повечето не винаги обръщат достатъчно внимание на осигуряването на надеждността на информационните системи на различните етапи от CI/CD Pipeline. В тази статия искам да споделя своя опит в автоматизацията на проверки за качеството на софтуера и реализирането на възможни сценарии за неговото 'самовъзстановяване'.
Работя като инженер в отдела за управление на ИТ услуги в компанията . Основната ми насоченост е внедряване на различни системи за мониторинг на производителността и достъпността на приложенията. Често общувам с ИТ клиенти от различни сегменти на пазара относно актуалните въпроси за мониторинг на качеството на техните ИТ услуги. Основната цел е да се минимизира времето за цикъла на издаване и да се увеличи честотата на техните версии. Това, разбира се, е добре: повече издания – повече нови функции – повече доволни потребители – повече печалба. Но в действителност не всегда всичко върви гладко. При много високи темпове на разгръщане веднага възниква въпросът за качеството на нашите издания. Дори при напълно автоматизиран конвейер, един от най-големите проблеми е преминаването на услугите от тестова фаза към въвеждане в експлоатация, без да се засяга времето на безотказна работа и взаимодействието на потребителите с приложението.
След многобройни разговори с клиенти мога да кажа, че контролът на качеството на изданията, проблемът с надеждността на приложението и възможността за 'самовъзстановяване' (например, възстановяване на стабилна версия) на различни етапи от CI/CD конвейера - сред най-важните и актуални теми.
Наскоро работих от страната на клиента - в службата за поддръжка на приложен софтуер в онлайн банка. В архитектурата на нашето приложение беше използвано голямо количество самостоятелно написани микросървиси. Най-тъжното е, че не всички разработчици се справяха с високите темпове на разработка, качеството на някои микросървиси страдаше, което поръждаваше комични прякори за тях и техните създатели. Появяваха се истории за материалите, от които са създадени тези продукти.
«Формулиране на задача»
Честотата на релизите и голямото количество микросервизи създават трудности в разбирането на работата на приложението като цяло, както на етапа на тестване, така и на етапа на експлоатация. Промените настъпват постоянно и контролът им без наличието на добри инструменти за мониторинг е много труден. Често след нощен релиз утрото разработчиците седят като на барутен барел и чакат нищо да не се счупи, въпреки че на етапа на тестване всички проверки са били успешни.
Има още един момент. На етапа на тестване проверяват работоспособността на софтуера: изпълнението на основните функции на приложението и отсъствието на грешки. Качествените оценки за производителността или отсъстват, или не отчитат всички аспекти на работата на приложението и интеграционния слой. Някои метрики изобщо може да не се проверяват. В резултат на това, когато настъпи повреда в продуктивната среда, техническият екип за поддръжка научава за това едва когато реалните потребители започнат да се оплакват. Искаме да сведем до минимум влиянието на некачествения софтуер върху крайните потребители.
Един от начините за разрешаване на проблема е да се внедрят процеси за проверка на качеството на софтуера на различни етапи от CI/CD конвейера, да се добавят различни сценарии за възстановяване на системата при възникване на аварии. Също така помним, че имаме DevOps. Бизнесът очаква максимално бързо получаване на нов продукт. Поради това всички наши проверки и сценарии трябва да бъдат автоматизирани.
Задачата се разбива на две съставни части:
- контрол на качеството на сборките на етапа на тестване (автоматизиране на процеса по откриване на некачествени сборки);
- контрол на качеството на софтуера в продуктивна среда (механизми за автоматично откриване на проблеми и възможни сценарии за тяхното самовъзстановяване).
Инструмент за мониторинг и събиране на метрики
За да реализираме поставените задачи, е необходима система за мониторинг, способна да открива проблеми и да ги предава на системи за автоматизация на различни етапи от конвейера CI/CD. Също така положителен аспект би бил, ако тази система предостави полезни метрики за различни екипи: разработки, тестване, експлоатация. И би било наистина чудесно, ако и за бизнеса.
За събиране на метрики можете да използвате набор от различни системи (Prometheus, ELK Stack, Zabbix и др.), но според мен най-подходящи за тези задачи са решенията от клас APM (), които могат значително да улеснят живота ви.
В рамките на работата ми в обслужващия сектор започнах да разработвам аналогичен проект, използвайки решение от клас APM на компанията Dynatrace. Сега, работейки в интегратор, имам добро познание за пазара на мониторингови системи. Личното ми мнение е, че Dynatrace е най-подходящ за решаване на такива задачи.
Решението Dynatrace предоставя хоризонтално изобразяване на всяка потребителска операция с дълбочина на детайлите до ниво изпълнение на кода. Можете да проследите цялата верига на взаимодействие между различни информационни услуги: от нивата на фронтенд уеб и мобилни приложения, back-end сървъри на приложения, интеграционни шини до конкретни извиквания в базата данни.
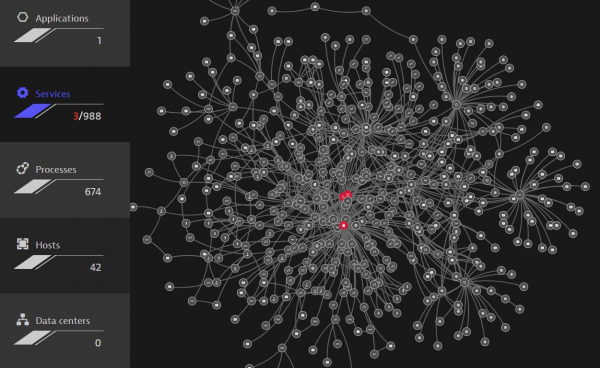 . Автоматично изграждане на всички зависимости между компонентите на системата
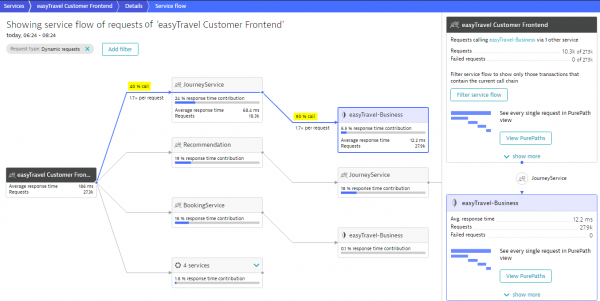 . Автоматично определяне и изграждане на пътя на операцията на услугата
Също така помним, че трябва да интегрираме с различни инструменти за автоматизация. Тук решението има удобен API, който позволява да се задават и получават различни метрики и събития.
Нека преминем към по-подробно разглеждане на това как да решим поставените задачи с помощта на системата Dynatrace.
Задача 1. Автоматизация на контрола на качеството на сборките на етапа на тестване
Първата задача е да открием проблемите възможно най-рано на етапите на конвейера за доставка на приложения. Само "добрите" сборки на кода трябва да достигат до продукционната среда. За това в вашия pipeline на етапа на тестване трябва да бъдат включени допълнителни монитори за проверка на качеството на вашите услуги.
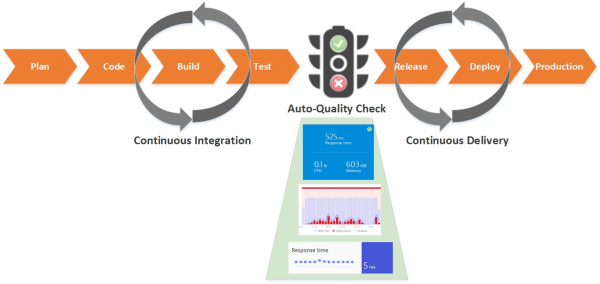
Нека разгледаме стъпките как да реализираме и автоматизираме този процес:
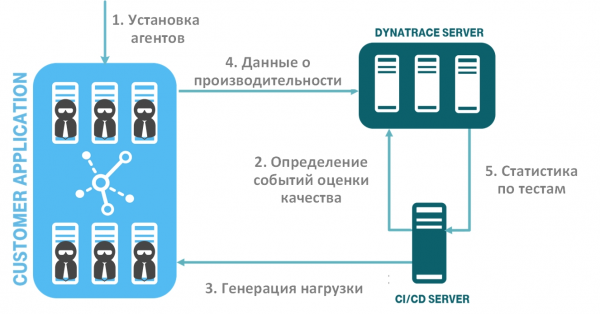
На изображението е показан поток от автоматизирани стъпки за проверка на качеството на софтуера:
- разгръщане на мониторингова система (инсталация на агенти);
- определяне на събития за оценка на качеството на вашия софтуер (метрики и прагова стойност) и предаване на системата за мониторинг;
- генериране на натоварване и тестове за производителност;
- събиране на данни за производителността и достъпността в системата за мониторинг;
- предаване на данни за тестове, основани на събития, за оценка на качеството на софтуера, от системата за мониторинг в системата CI/CD. Автоматичен анализ на сборките.
Стъпка 1. Разгръщане на системата за мониторинг
Първо е необходимо да инсталирате агентите в тестовата среда. В това отношение решението Dynatrace има приятно предимство – то използва универсалния агент OneAgent, който се инсталира на операционната система (Windows, Linux, AIX), автоматично открива вашите услуги и започва да събира данни за мониторинг относно тях. Не е нужно да конфигурирате отделно агент за всеки процес. Подобна ситуация ще е и за облачни и контейнерни платформи. В същото време можете да автоматизирате процеса на инсталиране на агентите. Dynatrace прекрасно се вписва в концепцията за „инфраструктура като код“ (): вече съществуват готови скриптове и инструкции за всички популярни платформи. Вградете агента в конфигурацията на вашата услуга, и при нейното разгръщане получавате нова услуга с вече работещ агент.
Стъпка 2. Определяне на събитията за оценка на качеството на вашето софтуер
Сега е необходимо да определите списъка с услуги и бизнес операции. Важно е да се вземат под внимание именно онези операции на потребителите, които са критични за бизнеса на вашата услуга. Тук препоръчвам да се консултирате с бизнес и системни анализатори.
След това е необходимо да определите кои метрики искате да включите в проверката за всеки от нивата. Например, това могат да бъдат времето за изпълнение (разделено на средно, медиана, перцентили и др.), грешки (логически, услужни, инфраструктурни и др.) и различни инфраструктурни метрики (memory heap, garbage collector, thread count и др.).
За автоматизация и удобство за екипа DevOps се появява концепцията „Мониторинг като код“. Какво имам предвид – разработчик/тестировчик може да напише прост JSON файл, който определя показателите за проверка на качеството на софтуера.
Нека да разгледаме пример за такъв JSON файл. Като двойка ключ/стойност се използват обекти от Dynatrace API (описанието на API можете да видите тук ).
{
   "timeseries": [
   {
      "timeseriesId": "service.ResponseTime",
      "aggregation": "avg",
      "tags": "Frontend",
      "severe": 250000,
      "warning": 1000000
   },
   {
      "timeseriesId": "service.ResponseTime ",
      "aggregation": "avg",
      "tags": "Backend",
      "severe": 4000000,
      "warning": 8000000
   },
   {
      "timeseriesId": "docker.Container.Cpu",
      "aggregation": "avg",
      "severe": 50,
      "warning": 70
   }
  ]
}
Файлът представлява масив от определения на времеви редове (timeseries):
- timeseriesId – проверяваната метрика, например, време за отговор, брой грешки, използвана памет и т.н.;
- aggregation — нивото на агрегация на метриките, в нашия случай avg, но можете да използвате всяко необходимо за вас (avg, min, max, sum, count, percentile);
- tags – етикет на обект в системата за мониторинг или може да се посочи конкретен идентификатор на обект;
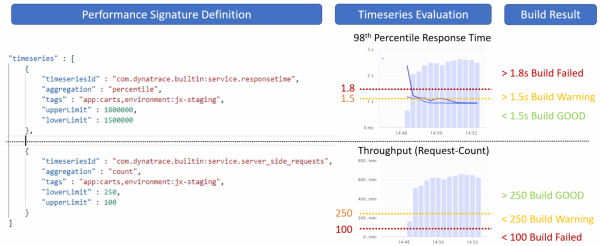
- severe и warning – тези показатели регулират праговите стойности на нашите метрики, ако стойността на тестовете надвишава прага severe, нашият сбор проверка се обозначава като неуспешен.
На следващата рисунка е представен пример за използване на такива прагове.
Стъпка 3. Генериране на натоварване
След като определим нивата на качество на нашия сервис, е необходимо да генерираме тестово натоварване. Можете да използвате всякакви удобни за вас инструменти за тестване, например Jmeter, Selenium, Neotys, Gatling и т.н.
Системата за мониторинг Dynatrace позволява да се улавят различни метаданни от вашите тестове и да се разпознае кой тест се отнася до кой цикъл на релиз и за кой сервис. Препоръчва се да добавяте допълнителни заглавия в HTTP заявките на теста.
На следващата рисунка е представен пример, в който с помощта на допълнителното заглавие X-Dynatrace-Test обозначаваме, че този тест се отнася за тестването на операцията по добавяне на продукт в количката.
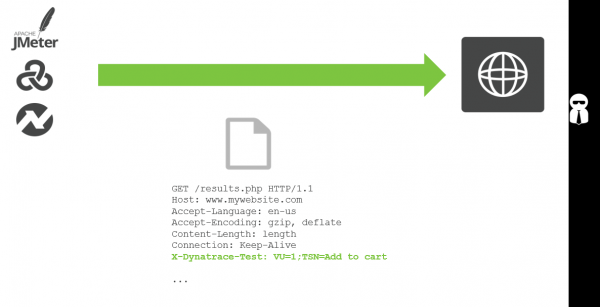
При стартиране на всеки тест за натоварване изпращате допълнителна контекстуална информация в Dynatrace с помощта на API събитие от сървъра CI/CD. По този начин системата може да различава различните тестове помежду си.
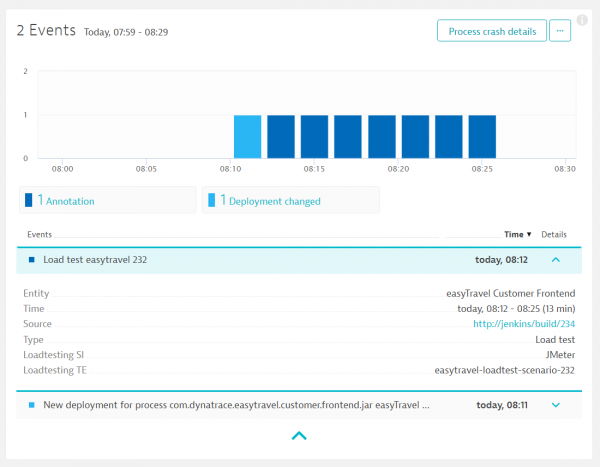 . Събитие в системата за мониторинг за стартиране на натоварващо тестване
Стъпка 4-5. Събиране на данни за производителността и предаване на данни в системата CI/CD
Заедно с генерирания тест в системата за мониторинг се предава събитие за необходимостта от събиране на данни за проверка на показателите за качество на услугата. Също така се посочва нашият JSON файл, в който са определени ключовите метрики.
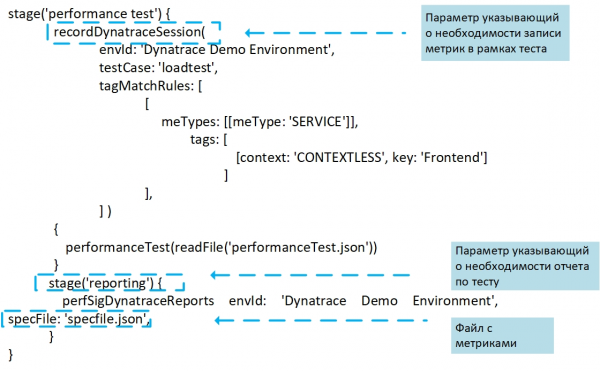 Събитие за необходимостта от проверка на качество на софтуер, генерирано на CI/CD сървъра за изпращане в системата за мониторинг.
В нашия пример събитие за проверка на качеството се нарича perfSigDynatraceReport (Performance_Signature) – това е готово за интеграция с Jenkins, разработено от екипа на T-Systems Multimedia Solutions. Всяко събитие за стартиране на проверка съдържа информация за услугата, номера на версията, времето за тестване. Плъгинът събира стойности на производителността по време на сборката, оценява ги и сравнява резултата с предишни сборки и нефункционални изисквания.
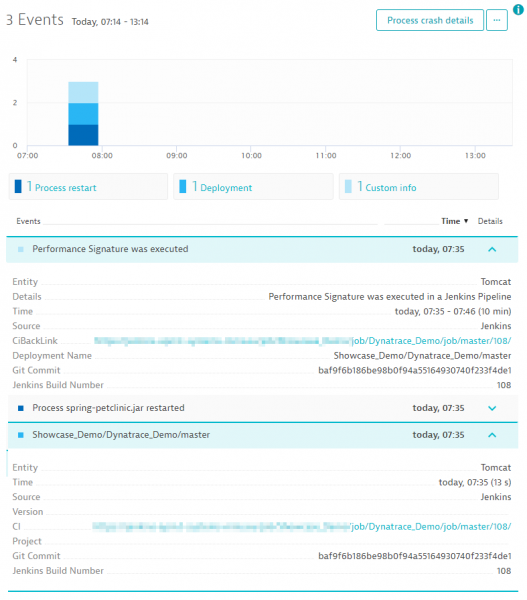 Събитие в системата за мониторинг за стартиране на проверка на качеството на версията.
След завършване на теста всички метрики за оценка на качеството на софтуера се предават обратно на системата за непрекъсната интеграция, например, Jenkins, която формулира отчет за резултатите.
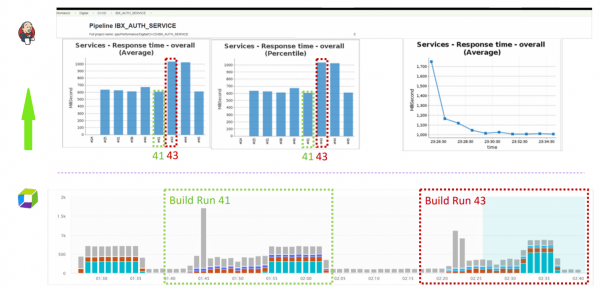 Резултат от статистиката на версиите на CI/CD сървъра.
За всяка отделна версия виждаме статистика за всяка зададена от нас метрика по време на целия тест. Виждаме и ако са имали нарушения в определени прагови стойности (warning и severe-thresholds). На базата на обобщените показатели, всяка версия се маркира като стабилна, нестабилна или провалена. Също така за удобство можете да добавите в отчета показатели за сравнение на текущата версия с предишната.
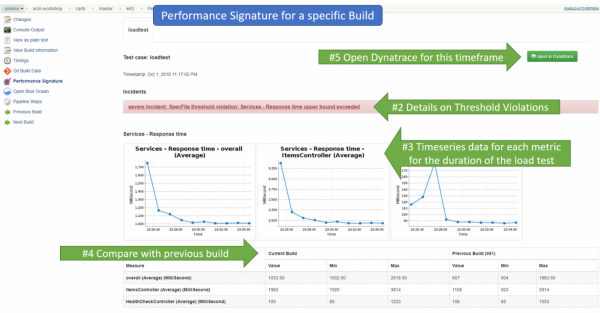 Преглед на детайлната статистика за версиите на CI/CD сървъра.
Детайлно сравнение на две версии.
При необходимост можете да преминете в интерфейса на Dynatrace и там по-детайлно да прегледате статистиката за всяка ваша версия и да ги сравните помежду им.
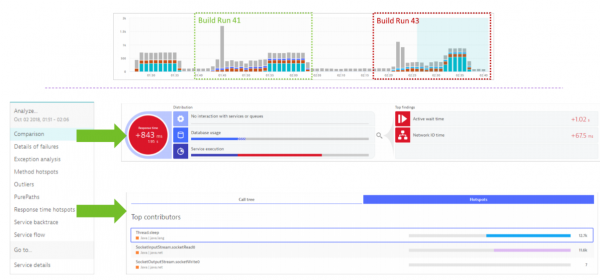 Сравнение на статистиката за версиите в Dynatrace.
Изводи
В крайна сметка получаваме услуга „мониторинг като услуга“, автоматизирана в конвейера на непрекъсната интеграция. Разработчикът или тестерът само трябва да определи списък от метрики в JSON файл, а всичко останало става автоматично. Получаваме прозрачен контрол на качеството на релизите: всички уведомления за производителността, потребление на ресурси или архитектурни регресии.
Задача 2. Автоматизация на контрола на качеството на софтуера в прод среда.
И така, решихме задачата как да автоматизираме процеса на мониторинг на етапа на тестване в Pipeline. По този начин минимизираме процента на некачествените версии, стигащи до прод среда.
Но какво да правим, ако лошият софтуер все пак достигне до продукционна среда или просто нещо се счупи. За нашата утопия искахме да присъстват механизми за автоматично откриване на проблеми и по възможност системата сама да възстанови работоспособността си, поне през нощта.
За това трябва да предвидим автоматични проверки за качество на софтуера в продукционна среда и да заложим сценарии за самовъзстановяване на системата.
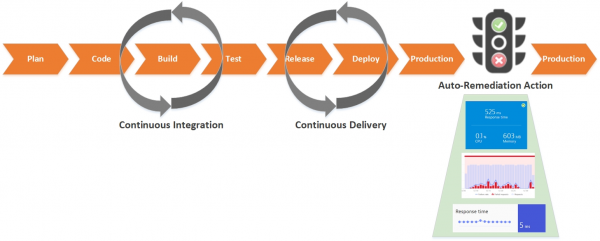
Автоисправяне като код
В повечето компании вече съществува натрупана база знания по различни типове разпространени проблеми и списък с действия за тяхното отстраняване, например, рестартиране на процеси, почистване на ресурси, откат на версии, възстановяване на неправилни промени в конфигурацията, увеличаване или намаляване на броя на компонентите в клъстера, превключване между син или зелен контур и др.
Въпреки че тези опции за употреба са известни на много екипи от години, малко от тях са се замислили и вложили средства в тяхната автоматизация.
Ако помислим, реализирането на процеси за самовъзстановяване на работоспособността на приложението не е нищо сложно; необходимо е вече известните сценарии на вашите администратори да се представят под формата на кодови сценарии (концепцията „автоисправяне като код“), които вече сте написали за всеки конкретен случай. Сценариите за автоматично коригиране трябва да бъдат насочени към отстраняване на първопричината за проблема. Вие сами определяте правилните действия за отговор на инцидента.
Като тригер за стартиране на сценария може да служи всяка метрика от вашата система за мониторинг; важно е, че тези метрики точно определят, че нещата не са наред, тъй като не бихте искали да получите фалшиви срабатывания в продукционната среда.
Можете да използвате всяка система или комбинация от системи: Prometheus, ELK Stack, Zabbix и т.н. Но ще дам няколко примера на базата на решение APM (в качеството на пример отново ще бъде Dynatrace), което също ще помогне за облекчаване на живота ви.
На първо място, тук има всичко, свързано с работоспособността от гледна точка на работата на приложението. Решението предоставя стотици метрики на различни нива, които можете да използвате като тригери:
- потребителски ниво (браузери, мобилни приложения, IoT устройства, поведение на потребителите, конверсии и т.н.);
- ниво на услугата и операциите (производителност, достъпност, грешки и т.н.);
- ниво на инфраструктурата на приложението (OS метрики на хост, JMX, MQ, уеб-сървър и т.н.);
- ниво на платформите (виртуализация, облак, контейнери и т.н.).
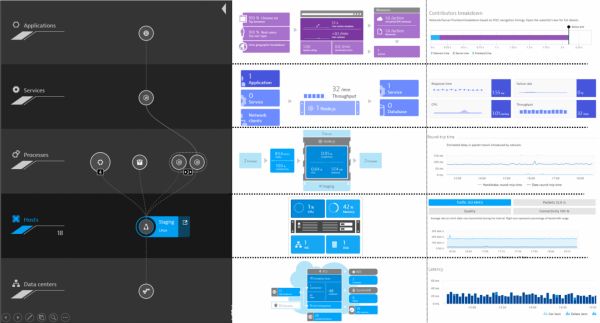 Нива на мониторинг в Dynatrace.
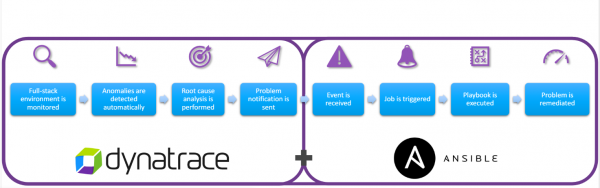
На второ място, както вече казах, Dynatrace има отворен API, който позволява много удобно интегриране с различни външни системи. Например, изпращане на уведомление до системата за автоматизация при превишаване на контролни параметри.
По-долу е даден пример за взаимодействие с Ansible.
След това ще дам няколко примера за автоматизации, които могат да бъдат реализирани. Това е само част от възможните случаи, списъкът в вашата среда може да бъде ограничен само от вашето въображение и възможностите на вашите мониторингови инструменти.
1. Лош deployment – върнати версии
Дори да проверим много добре в тестова среда, все още има шанс новото издание да убие вашето приложение в производствената среда. Човешкият фактор също е в сила.
На следващата илюстрация виждаме, че времето за изпълнение на операциите на услугата рязко се увеличава. Началото на този скок съвпада с времето на разгръщане на приложението. Цялата тази информация я предаваме в системата за автоматизация като събития. Ако работоспособността на услугата не се нормализира в зададения от нас срок, автоматично се извиква скрипт, който извършва връщане на версия до предишната.
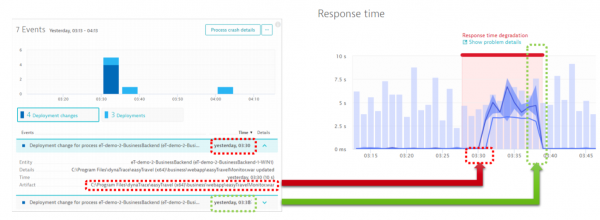 Деградация на производителността на операциите след разгръщане.
2. Загрузка на ресурсите до 100% – добавяне на нода в маршрутизацията
На следващия пример мониторинговата система определя, че на един от компонентите се наблюдава натоварване на CPU до 100%.
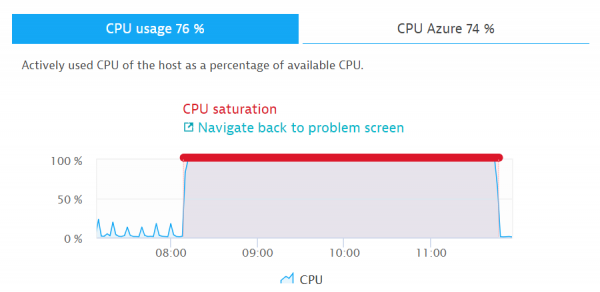 Натоварване на CPU 100%
По даденото събитие е възможно няколко различни сценария. Например, мониторинговата система проверява допълнително дали недостигът на ресурси е свързан с увеличение на натоварването на услугата. Ако е така, се изпълнява скрипт, който автоматично добавя нода в маршрутизацията, като по този начин възстановява работоспособността на системата като цяло.
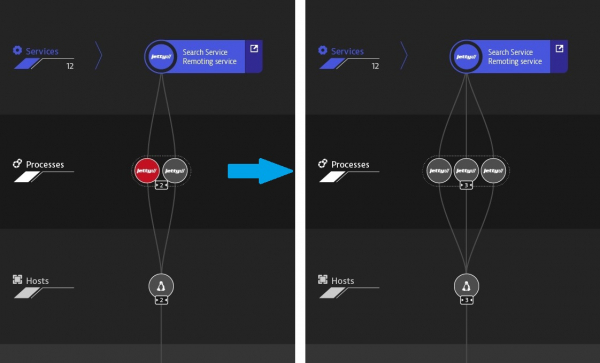 Мащабиране след инцидент
3. Липса на място на твърдия диск – почистване на диска
Мисля, че тези процеси вече са автоматизирани от много хора. С помощта на APM също можем да следим за свободното място в дисковата подсистема. При отсутствие място или бавна работа на диска, извикваме скрипт за почистване или добавяме място.
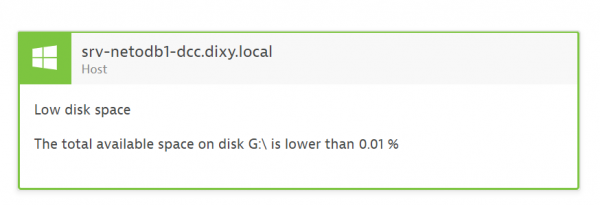
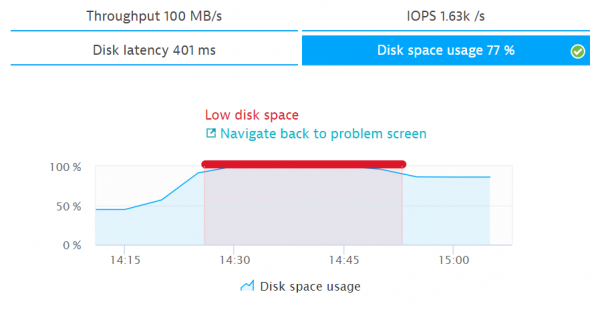 Заемането на диска 100%
4. Ниска активност на потребителите или ниска конверсия – превключване между синята и зелената линия
Често срещам клиенти, които използват два контура (blue-green deploy) за приложения в продукционна среда. Това позволява бързо превключване между клоновете при доставка на нови релизи. Често след деплой могат да настъпят радикални промени, които не се забелязват веднага. В същото време деградация по производителност и достъпност може да не се наблюдава. За бърза реакция на такива промени е по-добре да се използват различни метрики, отразяващи поведението на потребителите (брои на сесиите и действията на потребителите, конверсия, bounce rate). На следващата рисунка е показан пример, при който при спадането на конверсията се извършва превключване между клоновете на софтуера.
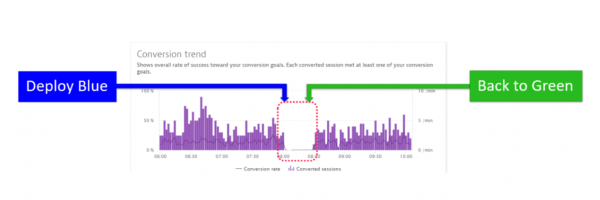 Спад на конверсията след превключване между клоновете на софтуера.
Механизми за автоматично определяне на проблеми
В края ще представя още един пример, за който най-много ми харесва Dynatrace.
В частта от разказа ми за автоматизация на проверката на качеството на сборките в тестова среда, всички прагови стойности определяхме ръчно. За тестова среда това е нормално, тестерът сам определя показателите преди всяка проверка в зависимост от натоварването. В продукционна среда е желателно проблемите да се откриват автоматично, като се вземат предвид различни механизми за baseline.
Dynatrace разполага с интересни вградени инструменти за изкуствен интелект, които на базата на механизми за определяне на аномални метрики (baselining) и изграждане на карта на взаимодействието между всички компоненти, съпоставяйки и корелирайки събития помежду им, определят аномалии в работата на услугата ви и предоставят детайлна информация за всеки проблем и коренна причина.
Чрез автоматичен анализ на зависимостите между компонентите, Dynatrace определява не само дали проблемната услуга е основната причина, но и нейната зависимост от други услуги. В следващия пример Dynatrace автоматично следи и оценява работоспособността на всяка услуга в рамките на транзакциите, идентифицирайки услугата Golang като основна причина.
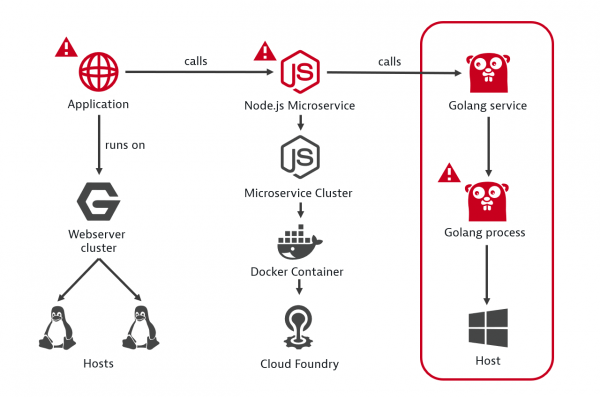 Пример за определяне на коренната причина за неуспех.
На следващата схема е изобразен процесът на мониторинг на проблемите с вашето приложение от момента на инцидента.
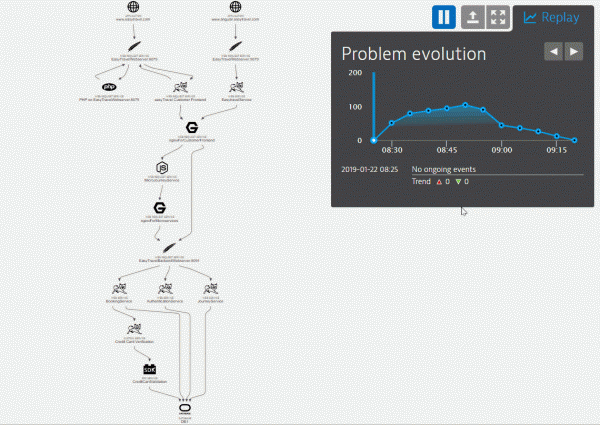 Визуализация на възникналия проблем с показване на всички компоненти и събития по тях.
Системата за мониторинг е събрала пълна хронология на събитията по възникналия проблем. В прозореца под времевата графика виждаме всички ключови събития на всеки от компонентите. По тези събития може да зададете процедури за автоматично отстраняване под формата на кодови сценарии.
Допълнително препоръчвам интегрирането на системата за мониторинг с Service Desk или баг-трекер. При възникване на проблем разработчиците бързо получават пълна информация за анализа на ниво код в продуктивната среда.
Заключение
В крайна сметка получихме конвейер CI/CD с вградени автоматизирани проверки на качеството на софтуера в Pipeline. Минимизираме броя на некачествените версии, подобряваме надеждността на системата като цяло и, ако все пак работоспособността на системата бъде нарушена, включваме механизми за нейното възстановяване.
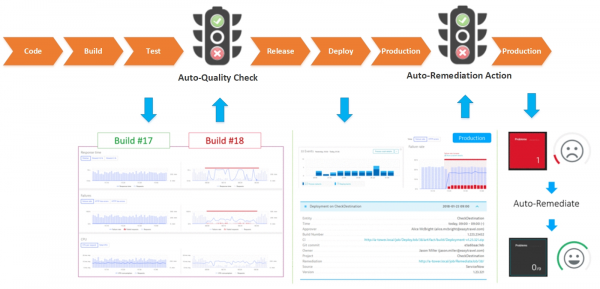
Автоматизацията на мониторинга на качеството на софтуера определено заслужава усилията, не винаги е бърз процес, но с времето ще донесе свои плодове. Препоръчвам, след решаване на нов инцидент в продуктивната среда, веднага да обмислите какви мониторни средства да добавите за проверки в тестовата среда, за да избегнете навлизането на некачествена версия в продуктивната, както и да съставите скрипт за автоматично отстраняване на тези проблеми.
Надявам се моите примери да ви помогнат в начинанията ви. Също така ще ми бъде интересно да видя вашите примери за използвани метрики за реализиране на самоотстраняване на работоспособността на системите.
Източник: habr.com
