

Прим. прев.: Тази поучителна история на Omio — европейски агрегатор на пътувания — води читателите от основите до увлекателните практически подробности в конфигурацията на Kubernetes. Запознаването с подобни случаи не само разширява хоризонтите, но и предотвратява нетривиални проблеми.
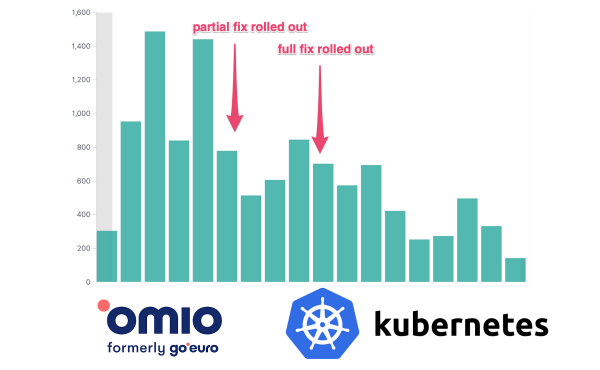
Случвало ли ви се е да срещате ситуация, в която приложението зацикля, спира да отговаря на запитвания за състоянието (health check) и не можете да разберете причината за такова поведение? Едно от възможните обяснения е свързано с лимита на ресурсите на CPU. Именно за него ще стане дума в тази статия.
TL;DR:
Настоятелно препоръчваме да се откажете от лимитите на CPU в Kubernetes (или да деактивирате квотите CFS в Kubelet), ако използвате версия на Linux Kernel с бъг CFS-квот. В ядрото добре известен.
буг, който води до прекомерно тротлинг и забавяне. В Omioвсичката инфраструктура се управлява от Kubernetes. Всички наши stateful и stateless натоварвания работят изцяло на Kubernetes (използваме Google Kubernetes Engine). През последните шест месеца започнахме да наблюдаваме случайни забавяния. Приложенията замръзват или спират да отговарят на health check, губят свързаност с мрежата и т.н. Такова поведение дълго време ни поставяше в безизходица и, накрая, решихме да се заемем с проблема сериозно.
Кратко резюме на статията:
- Няколко думи за контейнерите и Kubernetes;
- Как са реализирани CPU request и limit;
- Как работи CPU limit в среди с множество ядра;
- Как да следим тротлинга на CPU;
- Решение на проблема и нюансите.
Няколко думи за контейнерите и Kubernetes
Kubernetes, по същество, е съвременният стандарт в света на инфраструктурата. Неговата основна задача е оркестрацията на контейнерите.
Контейнери
В миналото трябваше да създаваме артефакти като Java JAR/WAR, Python Egg или изпълними файлове за последващо стартиране на сървъри. Обаче, за да ги накараме да работят, трябваше да правим допълнителна работа: инсталиране на среда на изпълнение (Java/Python), разполагане на нужните файлове на необходимите места, осигуряване на съвместимост с конкретна версия на операционната система и т.н. С други думи, трябваше да отделяме внимание на управлението на конфигурациите (което често служеше за причина за конфликти между разработчиците и системните администратори).
Контейнерите промениха всичко. Сега артефактът е контейнерен образ. Може да се представи като разширен изпълним файл, съдържащ не само програмата, но и пълна среда за изпълнение (Java/Python/…) и необходимите файлове/пакети, предварително инсталирани и готови за стартиране. Контейнерите могат да се разгръщат и стартират на различни сървъри без никакви допълнителни действия.
Освен това контейнерите работят в собствена среда-пясъчник. Те имат собствен виртуален мрежов адаптер, собствена файловая система с ограничен достъп, собствена йерархия на процесите, собствени ограничения за CPU и памет и т.н. Всичко това се реализира благодарение на специална подсистема на ядрото на Linux — namespaces (простанства на имена).
Kubernetes
Както беше споменато по-рано, Kubernetes е оркестратор на контейнери. Работи по следния начин: предоставяте му пул от машини и след това казвате: „Ей, Kubernetes, стартирай десет копия на контейнера ми с 2 процесора и 3 ГБ памет на всяко, и поддържай ги в работно състояние!“. Kubernetes ще се погрижи за всичко останало. Той ще намери свободни ресурси, ще стартира контейнерите и ще ги рестартира при необходимост, ще пусне обновление при смяна на версии и т.н. По същество, Kubernetes позволява да се абстрахирате от хардуерната съставна част и прави цялото разнообразие от системи подходящо за разгръщане и работа с приложения.
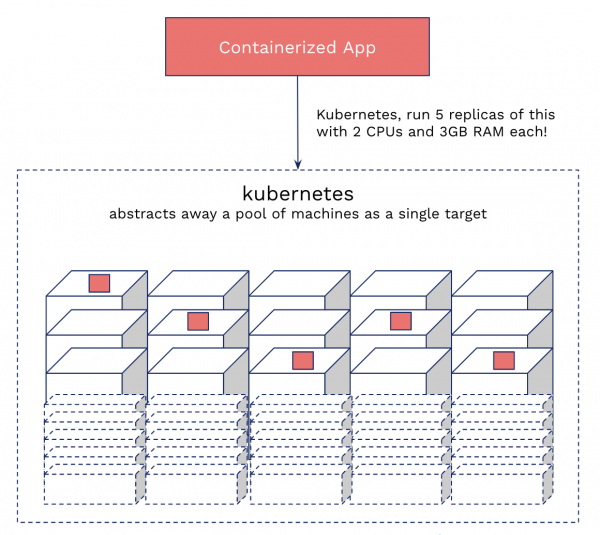
Kubernetes от гледна точка на обикновения гражданин
Какво представляват request-ите и limit-ите в Kubernetes
Добре, разбрахме за контейнерите и Kubernetes. Също така знаем, че няколко контейнера могат да бъдат на една машина.
Може да се направи аналогия с общо жилище. Взема се просторно помещение (машини/възли) и се отдава под наем на няколко наематели (контейнери). Kubernetes играе ролята на брокер на имоти. Въпросът е как да се предотвратят конфликтите между наемателите? Какво ще стане, ако един от тях, да кажем, реши да заеме банята за половин ден?
Тук влизат в игра request-ите и limit-ите. CPU Request е необходим единствено за планиране. Това е нещо като "списък с желания" на контейнера и се използва за избора на най-подходящия възел. В същото време CPU Лимит може да се сравни с договор за наем — щом намерим възел за контейнера, той не може да надвишава установените граници. И тук възниква проблемът...
Как са реализирани заявките и лимитите в Kubernetes
Kubernetes използва вграден в ядрото механизъм за тротлинг (пропуск на тактове време) за реализиране на лимити за CPU. Ако приложението надхвърли лимита, се активира тротлинг (т.е. получава по-малко тактове CPU). Заявките и лимитите за паметта са организирани по различен начин, затова е по-лесно да се открият. Достатъчно е да проверите последния статус на рестарта на pod-а: не е ли «OOMKilled». С тротлинга на CPU нещата не са толкова прости, тъй като K8s предоставя само метрики за употреба, а не за cgroups.
CPU заявка
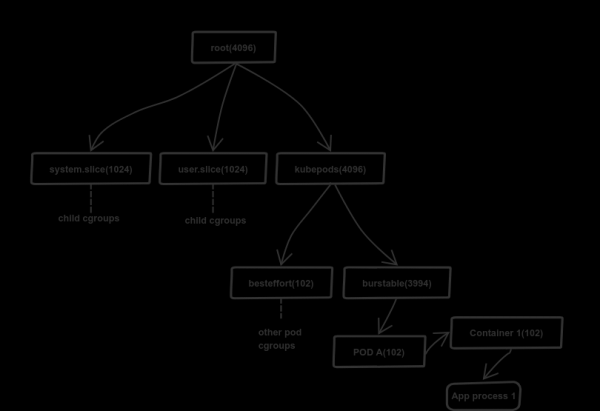
Как е реализирана CPU заявката
За простота да разгледаме процеса на примера на машина с 4-ядрен CPU.
K8s използва механизъм за контролни групи (cgroups) за управление на разпределението на ресурсите (памет и процесор). За него е налична йерархическа модел: потомък наследява лимитите на родителската група. Подробности за разпределението се съхраняват във виртуалната файлова система (/sys/fs/cgroup). В случая на процесора това /sys/fs/cgroup/cpu,cpuacct/*.
K8s използва файла cpu.share за разпределение на ресурсите на процесора. В нашия случай коренната контролна група получава 4096 дялове от ресурсите на CPU — 100% от наличната мощност на процесора (1 ядро = 1024; това е фиксирана стойност). Коренната група разпределя ресурсите пропорционално в зависимост от дяловете на потомците, посочени в cpu.share, а те, от своя страна, постъпват по аналогичен начин с техните потомци и т.н. В типичен възел Kubernetes коренната контролна група има три потомка: system.slice, user.slice и kubepods. Двете първи подгрупи се използват за разпределение на ресурсите между критично важни системни натоварвания и потребителски приложения извън K8s. Последната — kubepods — се създава от Kubernetes за разпределение на ресурсите между pod-овете.
На схемата по-горе се вижда, че първата и втората подгрупи са получили по 1024 дялове, като подгрупата kubepod е получила 4096 дялове. Как е възможно това: нали на коренната група са достъпни само 4096 дялове, а сумата от дяловете на нейните потомци значително надвишава това число (6144)? Фактът е, че стойността има логически смисъл, затова планировчикът на Linux (CFS) го използва за пропорционално разпределение на ресурсите на CPU. В нашия случай първите две групи получават по 680 реални дялове (16,6% от 4096), а kubepod получава останалите 2736 дялове. В случай на простои първите две групи няма да използват определените ресурси.
За щастие, в планировщика има механизъм, който позволява да се избегне загубата на неизползвани ресурси CPU. Той прехвърля "изчакващите" мощности в глобален пул, от който те се разпределят на групи, които се нуждаят от допълнителни процесорни мощности (прехвърлянето става на партиди, за да се избегнат загуби от закръгляване). Подобен метод се прилага и за всички потомци на потомците.
Този механизъм осигурява справедливо разпределение на процесорните мощности и следи да не се "крадат" ресурси от други процеси.
CPU Limit
Въпреки че конфигурациите на лимитите и заявките в K8s изглеждат подобно, тяхната реализация е коренно различна: това е най-заблуждаващата и най-слабо документирана част.
K8s използва за реализиране на лимитите. Техните настройки се задават в файлове cfs_period_us и cfs_quota_us в директорията cgroup (там също се намира файлът cpu.share).
В отличие от cpu.share, квотата е основана на период от време, а не на достъпната мощност на процесора. cfs_period_us задава продължителността на периода (епохата) — тя винаги е 100000 мкс (100 мс). В K8s има възможност да се промени тази стойност, но в момента е налична само в алфа-версия. Планировчикът използва епохата, за да рестартира използваните квоти. Вторият файл, cfs_quota_us, задава наличното време (квотата) за всяка епоха. Обърнете внимание, че тя също така се посочва в микросекунди. Квотата може да надвишава продължителността на епохата; с други думи, тя може да бъде повече от 100 мс.
Нека да разгледаме два сценария на 16-ядрени машини (най-разпространеният тип компютри при нас в Omio):
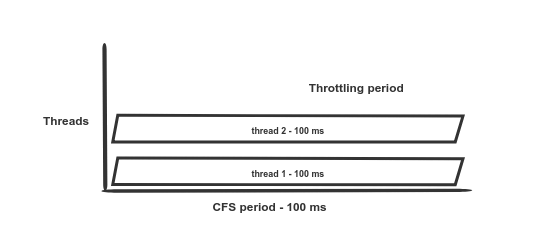
Сценарий 1: 2 потока и лимит от 200 мс. Без тротлинг
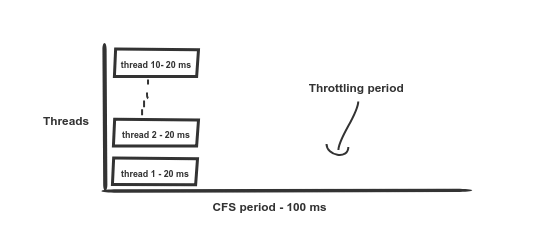
Сценарий 2: 10 потока и лимит от 200 мс. Тротлингът започва след 20 мс, достъпът до ресурсите на процесора се възобновява още след 80 мс
Предположим, че сте задали лимит на CPU на 2 ядра; Kubernetes ще преобразува тази стойност в 200 мс. Това означава, че контейнерът може да използва максимум 200 мс процесорно време без тротлинг.
И тук започва най-интригуващото. Както беше споменато по-горе, наличната квота е 200 мс. Ако имате десет потока на 12-ядрена машина (вижте иллюстрацията на сценарий 2), докато всички останали pod’и изчакват, квотата ще бъде изчерпана само след 20 мс (тъй като 10 * 20 мс = 200 мс), и всички потоци на този pod ще "забавят" (throttle) (ограничение) на следващите 80 мс. Усложнява ситуацията вече споменатият , поради който се случва излишен тротлинг и контейнерът не може да произведе дори наличната квота.
Как да оценим тротлинга в подовете?
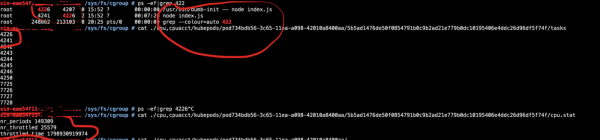
Просто влезте в пода и изпълнете cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— общ брой периоди на планиране; -
nr_throttled— брой на периодите с тротлинг в съставаnr_periods; -
throttled_time— общо време на тротлинг в наносекунди.
Какво всъщност се случва?
В крайна сметка получаваме висок тротлинг във всички приложения. Понякога той е в 1.5 пъти по-силен от пресметнатото!
Това води до различни грешки — сривове на проверките за готовност, закачания на контейнерите, разкъсвания на мрежовите връзки, тайм-аутове в рамките на сервисните повиквания. В крайна сметка това се изразява в увеличена закъснение и повишаване на броя на грешките.
Решение и последствия
Тук всичко е просто. Отказахме се от лимитите на CPU и се заехме с обновление на ядрото на ОС в кластерите до най-новата версия, в която багажът беше поправен. Броят на грешките (HTTP 5xx) в нашите услуги веднага значително спадна:
Грешки HTTP 5xx
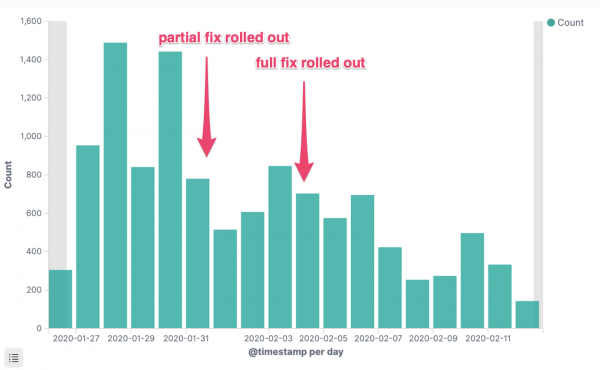
Грешки HTTP 5xx на един критично важен сервис
Време за отговор p95
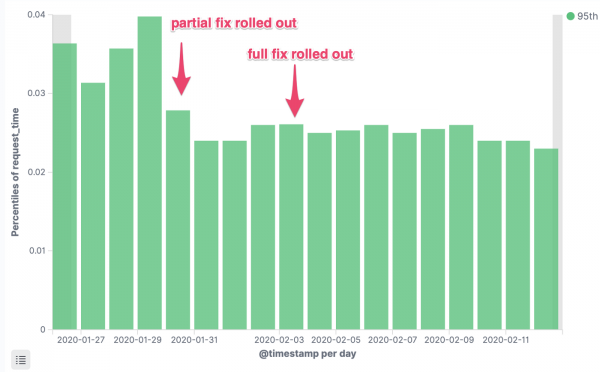
Закъснение на заявките на критично важен сервис, 95-ти процентил
Разходи за експлоатация
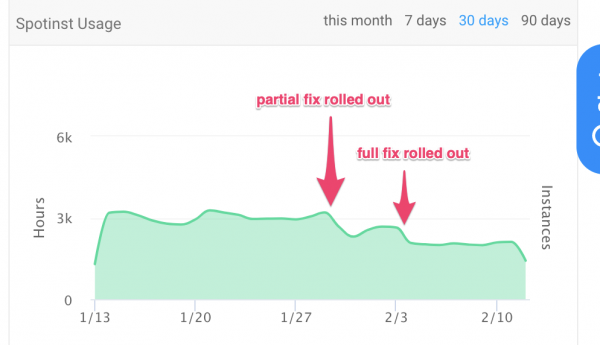
Брой изразходвани екземпляро-часа
Каква е уловката?
Както бе споменато в началото на статията:
Може да се направи аналогия с комунална квартира… Kubernetes играе ролята на брокер на имоти. Но как да предотвратим кварталниците да влизат в конфликти помежду си? Какво, ако един от тях реши да заеме банята за половин ден?
Ето къде е уловката. Един непослушен контейнер може да погълне всички налични ресурси на процесора в машината. Ако разполагате с качествен стек приложения (например, правилно настроени JVM, Go, Node VM), тогава това не е проблем: може да се работи в такива условия продължително време. Но ако приложенията не са оптимизирани добре или изобщо не са оптимизирани (FROM java:latest), ситуацията може да излезе извън контрол. В Omio разполагаме с автоматизирани базови Dockerfiles с адекватни настройки по подразбиране за стека на основните езици, затова подобна проблематика не е съществувала.
Препоръчваме да следите метриките (използване, насищане и грешки), закъснения на API и честота на възникване на грешки. Уверете се, че резултатите отговарят на очакванията.
Връзки
Такава е нашата история. Следващите материали значително помогнаха да разберем какво се случва:
- ;
- ;
- ;
- ;
- — търсете „cpu throttling“.
Доклади за грешки в Kubernetes:
- ;
- ;
- .
Срещали ли сте подобни проблеми в практиката си или имате опит, свързан с тротлинга в контейнеризирани production среди? Споделете историята си в коментарите!
P.S. от преводача
Прочетете също в нашия блог:
- «»;
- «»;
- «».
Източник: habr.com
