

Точно такива забележки чух от нашите разработчици. Най-интересното е, че това се оказа вярно, поставяйки началото на продължително разследване. Става въпрос за SQL servers, които работят на нашия VMware.
Собствено, е лесно да се постигне ситуация, в която production server остава много назад от лаптопа. Изпълнете (не на tempdb и не в база с включена Delayed Durability) кода:
set nocount on
create table _t (v varchar(100))
declare @n int=300000
while @n>0 begin
  insert into _t select 'Каква бавност!'
  delete from _t
  set @n=@n-1
  end
GO
drop table _t
На десктопа ми той се изпълнява за 5 секунди, а на production server — за 28 секунди. Защото SQL трябва да изчака физическото приключване на записа в transaction log, а ние правим много кратки транзакции. Грубо казано, вкарахме голям мощен камион в градския трафик и наблюдаваме как го изпреварват доставчици на пица на скутери — тук не важи throughput, важна е само latency. А нито един мрежов сторидж, колкото и нули да има цената му, не може да спечели по latency спрямо локалния SSD.
(в коментарите стана ясно, че лъгах — в двете места имам включена delayed durability. Без delayed durability се получава:
Desktop — 39 секунди, 15K tr/sec, 0.065ms/io roundtrip
PROD — 360 секунди, 1600 tr/sec, 0.6ms
Трябваше да обърна внимание, че е твърде бързо)
Обаче в този случай имаме работа с тривиални нули на функцията на Риман с тривиален пример. В примера, който ми предоставиха разработчиците, имаше различно. Убедих се, че са прави, и започнах да изчиствам от примера цялата им специфика, свързана с бизнес логиката. В даден момент разбрах, че мога напълно да изхвърля тяхния код и да напиша своя — който демонстрира същия проблем — на production той се изпълнява 3-4 пъти по-бавно:
create function dbo.isPrime (@n bigint)
returns int
as
  begin
  if @n = 1 return 0
  if @n = 2 return 1
  if @n = 3 return 1
  if @n % 2 = 0 return 0
  declare @sq int
  set @sq = sqrt(@n)+1 -- check odds up to sqrt
  declare @dv int = 1
  while @dv < @sq
    begin
	set @dv=@dv+2
	if @n % @dv = 0 return 0
	end
  return 1
  end
GO
declare @dt datetime set @dt=getdate()
select dbo.isPrime(1000000000000037)
select datediff(ms,@dt,getdate()) as ms
GO
Ако всичко е наред, проверката за простота ще се изпълнява 6-7-8 секунди. Така беше в редица сървъри. Но на някои отнемаше 25-40 секунди. Интересно е, че нямаше сървъри, при които изпълнението да отнема, да кажем, 14 секунди — кодът работеше или много бързо, или много бавно, тоест проблемът беше, така да се каже, черно-бял.
Какво направих? Потопих се в метриките на VMware. Всичко изглеждаше наред - ресурсите бяха в изобилие, времето за готовност = 0, всичко е достатъчно, по време на теста и на бързи, и на бавни сървъри CPU=100 на един vCPU. Направих тест за изчисление на числото Pi - тестът показа еднакви резултати на всички сървъри. Започна да мирише на черна магия.
Излезе на DEV фермата и започнах да играя с сървърите. Открих, че vMotion от хост на хост може да "излекува" сървър, но може и обратното, да превърне "бърз" сървър в "бавен". Изглежда, ето го - някои хостове имат проблем... но... не. Някакъв виртуал машина забавяше на хост A, но работеше бързо на хост B. А друга виртуал машина обратното - работеше бързо на A и забавяше на B! На хост често ряботеха и "бързи", и "бавни" машинки!
От този момент във въздуха ясно запахна на сяра. Защото проблемът не можеше да бъде приписан на виртуалката (например Windows пачове) - тя се превръщаше в "бърза" при vMotion. Но проблемът също не можеше да бъде приписан на хоста - защото на него можеха да бъдат както "бързи", така и "бавни" машинки. Също така не беше свързано с натоварването - успях да получа "бавна" машина на хост, където освен нея изобщо нямаше нищо.
От отчаяние стартирах Process Explorer от Sysinternals и погледнах стека на SQL. На бавните машинки веднага ми слезе на очите редът:
ntoskrnl.exe!KeSynchronizeExecution+0x5bf6
ntoskrnl.exe!KeWaitForMultipleObjects+0x109d
ntoskrnl.exe!KeWaitForMultipleObjects+0xb3f
ntoskrnl.exe!KeWaitForSingleObject+0x377
ntoskrnl.exe!KeQuerySystemTimePrecise+0x881 < — !!!
ntoskrnl.exe!ObDereferenceObjectDeferDelete+0x28a
ntoskrnl.exe!KeSynchronizeExecution+0x2de2
sqllang.dll!CDiagThreadSafe::PxlvlReplace+0x1a20
… пропуснато
sqldk.dll!SystemThread::MakeMiniSOSThread+0xa54
KERNEL32.DLL!BaseThreadInitThunk+0x14
ntdll.dll!RtlUserThreadStart+0x21
Това вече беше нещо. Беше написана програма:
    class Program
    {
        [DllImport("kernel32.dll")]
        static extern void GetSystemTimePreciseAsFileTime(out FILE_TIME lpSystemTimeAsFileTime);

        [StructLayout(LayoutKind.Sequential)]
        struct FILE_TIME
        {
            public int ftTimeLow;
            public int ftTimeHigh;
        }

        static void Main(string[] args)
        {
            for (int i = 0; i < 16; i++)
            {
                int counter = 0;

                var stopwatch = Stopwatch.StartNew();

                while (stopwatch.ElapsedMilliseconds  0)
                {
                    Console.WriteLine("{0}", counter);
                }
            }
        }
    }
Тази програма демонстрираше дори по-забележимо забавяне – на "бързите" машини показва 16-18 милиона цикъла в секунда, докато на бавните – един и половина милиона, а даже и 700 хиляди. Тоест разликата е 10-20 пъти (!!!). Това вече беше малка победа: във всеки случай нямаше заплаха да заседнем между поддръжката на Microsoft и VMware, така че те да си прехвърлят отговорността един на друг.
След това напредъкът спря – отпуск, важни дела, вирусна истерия и рязко нарастване на натоварването. Често споменавах магическия проблем на колегите, но понякога ми се струваше, че те дори не винаги ми вярват – твърдението, че VMware забавя кода 10-20 пъти, беше твърде чудовищно.
Опитвах се сам да разбера какво точно забавя. Понякога ми се струваше, че съм открил решение – включването и изключването на Hot plugs, променянето на обема памет или броя на процесорите често превръщаше машината в "бърза". Но не завинаги. Но какво се оказа истина – е, че е достатъчно да излезеш и да почукаш по колелото – т.е. да промениш всеки параметър на виртуалната машина
Накрая, моите американски колеги изведнъж намериха основната причина.
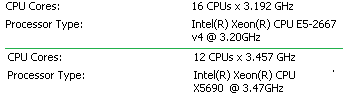
Хостовете се различаваха по честота!
- Обикновено, това не е страшно. Но: при прехвърлянето от 'родния' хост на хост с 'друга' честота, VMware трябва да коригира резултата на GetTimePrecise.
- Обикновено това не е страшно, освен ако не се окаже, че има приложение, което запитва точно време милиони пъти в секунда, като SQL сървър.
- Но и това не е страшно, тъй като SQL сървър не прави това твърде често (вж. Заключение)
Но има случаи, когато тези капани сериозно удрят. И наистина, като почукам по колелото (поменяйки нещо в настройките на VM) принуждавах VMware да 'пресчита' конфигурацията, и честотата на текущия хост ставаше 'родна' честота на машината.
Решение
Когато деактивирате виртуализацията на TSC, четенето на TSC от виртуалната машина връща TSC стойността на физическата машина, а писането на TSC от виртуалната машина няма ефект. Прехвърлянето на виртуалната машина на друг хост, възобновяването ѝ от суспендирано състояние или възстановяването до моментни снимки причинява TSC да скочи дискретно. Някои гостуващи операционни системи не успяват да се стартират или проявяват други проблеми с времето, когато виртуализацията на TSC е деактивирана. В миналото, тази функция понякога е била препоръчвана, за да се подобри производителността на приложения, които често четат TSC, но производителността на виртуалния TSC е подобрена значително в настоящите продукти. Функцията също е била препоръчвана за използване при провеждане на измервания, които изискват прецизен източник на реално време във виртуалната машина.
С други думи, трябва да добавите параметър
monitor_control.virtual_rdtsc = FALSE
Заключение
Навярно сте се запитали: защо SQL извиква GetTimePrecise толкова често?
Нямам изходни кода на SQL сървър, но логиката говори следното. SQL е почти операционна система с кооперативна конкурентност, при която всеки поток трябва от време на време да "устъпва". А къде е най-добре да се направи това? Там, където има естествено изчакване — заключване или входно-изходни операции. Добре, а какво, ако въртим изчислителни цикли? Тогава очевидното и почти единствено място е в интерпретатора (това не е съвсем интерпретатор), след изпълнението на следващата команда.
Обикновено, SQL сървърът не се използва за забиване на пирони в чисто изчисление и това не е проблем. Но цикли с работа с всякакви временни таблици (които веднага се кешират) превръщат кода в последователност от много бързо изпълнявани оператори.
Между другото, ако функцията бъде опакована в NATIVELY COMPILED, тя спира да запитва за времето и скоростта ѝ се увеличава 10 пъти. А какво стана с кооперативния мултитаскинг? Ами за natively compiled код в SQL бе наложено да се създаде PREEMPTIVE MULTITASKING.
Източник: habr.com
