

При сложна обработка на големи набори от данни (различни : импорти, конвертиране и синхронизиране с външен източник) често възниква необходимост временно „да запомним“ и веднага бързо да обработим нещо обемисто.
Типичната задача от този род обикновено звучи ето така: „Ето тук последните постъпления, трябва бързо да ги качим на сайта и да ги свържем с сметките“
Но когато обемът на това „нещо“ започне да се измерва в стотици мегабайти, а услугата трябва да продължи да работи с базата в режим 24×7, възникват много странични ефекти, които ще развалят живота ви.
За да се справим с тях в PostgreSQL (а и не само в него), можем да използваме някои възможности за оптимизация, които ще позволят да се обработи всичко по-бързо и с по-малко разход на ресурси.
1. Къде да качим?
Първо нека определим къде можем да заредим данните, които искаме „да обработим“.
1.1. Временни таблици (TEMPORARY TABLE)
По принцип, за PostgreSQL временните таблици са същите като всички останали. Затова суеверията, че „те се съхраняват само в паметта и тя може да свърши“не са верни. Но има и няколко съществени разлики.
Свой „именен пространство“ за всяко свързване към БД
Ако две свързвания се опитат одновременно да изпълнят CREATE TABLE x, то някой непременно ще получи грешка за уникалност на обектите на БД.
Ако обаче и двете се опитат да изпълнят CREATE ВРЕМЕНЕН ТАБЛИЦА x, то и двете ще го направят успешно и всяко ще получи своя екземпляр на таблицата. И нищо общо между тях няма да бъде.
„Самоизтриване“ при разединяване
При затваряне на свързването всички временни таблици автоматично се изтриват, затова „ръчно“ да извършвате DROP TABLE x няма никакъв смисъл, освен…
Ако работите през pgbouncer в режим на транзакция, то базата все още смята, че това свързване е активно и в него тази времетна таблица все още съществува.
Затова опитът да я създадете отново, вече от друго свързване към pgbouncer, ще доведе до грешка. Но това може да бъде заобиколено със СЪЗДАЙТЕ ВРЕМЕННА ТАБЛИЦА АКО НЕ КАТО x.
Истината е, че е по-добре да не се прави по този начин, защото след време може да „откриете“ там данни, останали от „предишния собственик“. Вместо това е много по-добре да прочетете ръководството и да видите, че при създаване на таблица има възможност да добавите ПРИ СЪХРАНЕНИЕ DROP — то есть при завършване на транзакцията, таблицата ще бъде автоматично изтрита.
Не-репликация
Поради принадлежността само на определено свързване, временните таблици не се репликират. Вместо това това освобождава от необходимостта от двоично записване на данни в heap + WAL, така че INSERT/UPDATE/DELETE в нея е значително по-бързо.
Но тъй като временната — все пак е "почти обикновена" таблица, не може да бъде създадена и на репликата. Поне засега, макар съответният патч отдавна да се разпространява.
1.2. Нежурналируеми таблици (UNLOGGED TABLE)
Но какво да правим, например, ако имате някакъв обемен ETL процес, който не може да бъде реализиран в рамките на една транзакция, и имате pgbouncer в режим на транзакция?..
Или потокът от данни е толкова голям, че пропускателната способност на едно свързване с БД (четете, един процес на CPU) не е достатъчна?.
Или част от операциите отиват асинхронно в различни свързвания?.
Тук вариантът е само един — временно да се създаде не-временна таблица. Каламбур, а? Тоест:
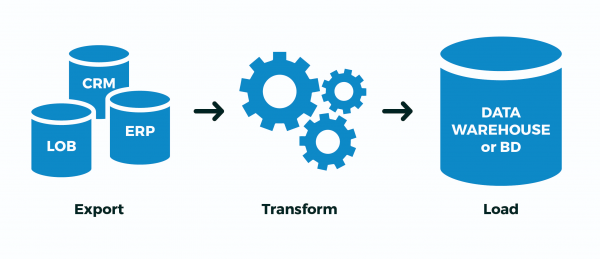
- създадох "своите" таблици с максимално случайни имена, за да не се пресекат с никого
- Extract: заредих в тях данни от външен източник
- Transform: преобразувах, попълних ключовите свързващи полета
- Load: преливам готовите данни в целевите таблици
- изтрих "моите" таблици
А сега — лъжичка катран. Всъщност, всичко записване в PostgreSQL става два пъти — , след това в телата на таблиците/индекси. Всичко това е направено за поддръжка на ACID и коректна видимост на данните между COMMIT‘нутите и ROLLBACK‘нутите транзакции.
Но на нас ни е необходима само единствено това! Целият процес или изцяло успешно е преминал, или не. Не е важно колко ще има междинни транзакции — не ни интересува "да продължим процеса от средата", особено когато не е ясно къде е бил.
За целта разработчиците на PostgreSQL още в версия 9.1 въвведоха нещо като :
С тази индикация таблицата се създава като нежурналируема. Данните, записвани в нежурналируеми таблици, не преминават през журнала на предзаписа (вижте Глава 29), в резултат на което такива таблици работят значително по-бързо от обикновените.Въпреки това, те не са защитени от срив; при срив или аварийно изключване на сървъра, нежурналируемата таблица автоматично се отрязва.Освен това, съдържанието на нежурналируемата таблица не се репликира за водещи сървъри. Всякакви индекси, създадени за незаписваема таблица, автоматично стават незаписваеми.
Накратко, ще бъде значително по-бързо, но ако сървърът на БД “падне” — ще бъде неприятно. Но колко често се случва това и може ли вашият ETL процес да го обработи коректно “от средата” след “съживяване” на БД?..
Ако не, и горният случай прилича на вашия — използвайте UNLOGGED, но никога не включвайте този атрибут при реални таблици, данните от които ви интересуват.
1.3. ON COMMIT { DELETE ROWS | DROP }
Тази конструкция позволява при създаване на таблица да зададете автоматично поведение при завършване на транзакцията.
За ПРИ СЪХРАНЕНИЕ DROP както вече написах по-горе, тя генерира DROP TABLE, а тук ПРИ СЪХРАНЕНИЕ Премахване на редове ситуацията е по-интересна — тук се генерира TRUNCATE TABLE.
Тъй като цялата инфраструктура за съхранение на метаописанията на временната таблица е точно такава, каквато е при обикновена, то постоянното създаване и изтриване на временни таблици води до силно “разбухване” на системните таблици pg_class, pg_attribute, pg_attrdef, pg_depend,…
Сега си представете, че имате работник на пряка връзка с БД, който всяка секунда отваря нова транзакция, създава, напълва, обработва и изтрива временна таблица… Отпадъците в системните таблици ще се натрупат в изобилие, а това ще доведе до допълнителни забавяния при всяка операция.
Със сигурност, не правете така! В този случай е много по-ефективно CREATE TEMPORARY TABLE x ... ON COMMIT DELETE ROWS да изнесете извън цикъла на транзакции — така в началото на всяка нова транзакция таблиците вече ще съществуват (пестим извикването CREATE), но ще бъде празна, благодарение на TRUNCATE (и извикването му спестихме) при завършване на предишната транзакция.
1.4. LIKE… INCLUDING …
Споменах в началото, че един от типичните случаи на използване на временни таблици — това са различни видове импорти — и разработчикът уморено копира и поставя списъка с полета на целевата таблица в декларацията на своята временна…
Но мързелът е движеща сила на прогреса! Затова създаването на нова таблица “по образец” може да бъде много по-просто:
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Тъй като в тази таблица могат да бъдат генерирани наистина много данни, търсенето в нея ще стане никак не бързо. Но против това има традиционно решение — индексите! И, да, временната таблица също може да има индекси.
Тъй като често необходимите индекси съвпадат с индексите на целевата таблица, просто можете да напишете КАТО target_table ВКЛЮЧИТЕЛНО ИНДЕКСИТЕ.
Ако ви трябват още и DEFAULT- стойности (например, за попълване на стойности за основен ключ), можете да използвате КАТО target_table ВКЛЮЧИТЕЛНО СТАНДАРТНИ. Или просто — КАТО target_table ВКЛЮЧВАЙКИ ВСИЧКО — копиране на стойностите по подразбиране, индексите, ограниченията,…
Но тук вече трябва да разберем, че ако сте създали импортна таблица веднага с индекси, тогава вкарването на данни ще отнеме повече време, отколкото ако първо добавите всичко и чак след това добавите индексите — вижте за пример как го прави .
В общи линии, !
2. Как да пишете?
Ще кажа просто — използвайте - поток вместо «пакет» INSERT, . Можете дори директно от предварително форматиран файл.
3. Как да обработвате?
И така, да приемем, че нашето начало изглежда приблизително така:
- в базата ви се съхранява таблица с клиентски данни на 1M записа
- всеки ден клиентът ви изпраща нов пълен «образ»
- по опит знаете, че от път до път се променят не повече от 10K записа
Класически пример за подобна ситуация е — има много адреси, но в седмичния експорт на промени (преименувания на населени места, сливания на улици, появи на нови сгради) има съвсем малко изменения дори в мащабите на цялата страна.
3.1. Алгоритъм за пълна синхронизация
За простота да приемем, че не ви е нужно дори да реструктурирате данните — просто да приведете таблицата в необходимия вид, а именно:
- да изтрие всичко, което вече не съществува
- да актуализират всичко, което вече е било и трябва да се обнови
- вмъкване всичко, което още не е имало
Защо именно в този ред трябва да правите операциите? Защото точно по този начин размерът на таблицата ще се увеличи минимално ().
DELETE FROM dst
Не, разбира се, може да се справите с само две операции:
- да изтрие (
DELETE) всичко - вмъкване всички от новия образ
Но при това, благодарение на MVCC, размерът на таблицата ще се увеличи точно два пъти! Получаването на +1M образа записи в таблицата заради обновяване на 10K — нека да не е излишък...
TRUNCATE dst
По-опитен разработчик знае, че цялата таблица може да бъде почистена достатъчно евтино:
- изчисти (
TRUNCATE) цялата таблица - вмъкване всички от новия образ
Методът е ефективен, , но има един проблем... Вкарването на 1M записа ще отнеме много време, така че не можем да си позволим таблицата да остане празна през цялото това време (както ще стане без обграждане в единна транзакция).
А следователно:
- започваме дълга транзакция
TRUNCATEналага AccessExclusive- блокировка- дълго правим вмъкване, а всички останали по това време не могат дори
SELECT
Нещо не е наред...
ALTER TABLE… RENAME… / DROP TABLE ...
Като вариант — да качим всичко в отделна нова таблица, а после просто да я преименуваме на мястото на старата. Няколко неприятни детайли:
- и това също AccessExclusive, макар и значително по-малко по време
- се изтриват всички планове за заявки/статистика на тази таблица,
- се разрушават всички външни ключове (FK) на таблицата
Имаше WIP-патч от Simon Riggs, който предлагаше да направим ALTER-операция за замяна на съдържанието на таблицата на файлово ниво, без да се засяга статистиката и FK, но не събра кворум.
DELETE, UPDATE, INSERT
И така, спираме на неблокиращия вариант с три операции. Почти три… Как да го направим най-ефективно?
-- всичко го правим в рамките на транзакция, за да не види никой "промеждутъчните" състояния
BEGIN;

-- създаваме времена таблица с внасяните данни
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- по образец и подобие, заедно с индексите
) ON COMMIT DROP; -- извън транзакцията не ни е нужна

-- бързо заливаме новия образ чрез COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- изтриваме липсващите
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- полета на първичния ключ
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "антиджойн"

-- обновяваме останалите
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- не е нужно да обновяваме съвпадащите

-- вмъкваме липсващите
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Постобработка на вноса
В същия КЛАДР всичките променени записи трябва допълнително да се подложат на постобработка — да се нормализират, да се извлекат ключови думи, да се приведат в нужните структури. Но как да разберем — какво точно се е променяло, без да усложняваме кода за синхронизация, идеално – изобщо не го засягаме?
Ако достъпът за запис в момента на синхронизация е само за вашия процес, можете да използвате тригер, който да събере всички промени за нас:
-- целеви таблици
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- таблици с история на промените
CREATE TABLE kladr$log(
  ro kladr, -- тук лежат цялостни образи на записи "стара/нова"
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- обща функция за логване на промените
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- проверяваме необходимостта от логване при обновление на записа
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- създаваме запис в лог файла
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Сега можем преди началото на синхронизацията да наложим (или включим чрез ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
След това спокойно извличаме всички необходими промени от log-таблиците и ги пускаме през допълнителни обработчици.
3.3. Импорт на свързани набори
По-горе разгледахме случаи, когато структурата на данните на източника и приемника съвпадат. Но какво да правим, ако износа от външната система има формат, различен от структурата на съхранение при нас в базата?
Да вземем за пример съхранение на клиенти и фактури по тях, класически вариант "много към едно":
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
А ето, че износа от външен източник идва при нас в вид "всичко в едно":
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Очевидно е, че данните за клиентите могат да се дублират в такъв вариант, а основната запис е "фактурата":
0123456789;Вася;A-01;2020-03-16;1000.00
9876543210;Петя;A-02;2020-03-16;666.00
0123456789;Вася;B-03;2020-03-16;9999.00
За модела просто ще вкараме нашите тестови данни, но помним — COPY по-ефективно!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Вася', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Петя', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Вася', 'B-03', '2020-03-16', 9999.00);
Първо ще извлечем онези „разрези“, на които нашите „факти“ се отнасят. В нашия случай фактурите се отнасят на клиенти:
СЪЗДАЙТЕ ВРЕМЕННА ТАБЛИЦА client_import КАТО
ИЗБЕРЕТЕ ОТЛИЧАВАЩИ СЕ client_inn
-- може просто ИЗБЕРИМ ОТЛИЧАВАЩИ, ако данните са определено нес противоречиви
  client_inn inn
, client_name "name"
ОТ
  invoice_import;
За да свържем правилно фактурите с ID на клиентите, трябва първо да разберем или генерираме тези идентификатори. Ще добавим полета за тях:
ALTER TABLE invoice_import ДОБАВИ КОЛОНА client_id integer;
ALTER TABLE client_import ДОБАВИ КОЛОНА client_id integer;
Нека използваме описания по-горе метод за синхронизация на таблиците с малко корекция — няма да обновяваме и изтриваме нищо в целевата таблица, тъй като импорта на клиенти е "само добавяне":
-- задаваме в таблицата за импортиране ID на вече съществуващи записи
UPDATE
  client_import T
SET
  client_id = D.client_id
OT
  client D
WHERE
  T.inn = D.inn; -- уникален ключ

-- добавяме липсващи записи и задаваме техните ID
С С ins КАТО (
  INSERT INTO client(
    inn
  , name
  )
  ИЗБЕРИ
    inn
  , name
  ОТ
    client_import
  WHERE
    client_id IS NULL -- ако ID не е зададен
  ВРЪЩАНЕ *
)
UPDATE
  client_import T
SET
  client_id = D.client_id
OT
  ins D
WHERE
  T.inn = D.inn; -- уникален ключ

-- задаваме ID на клиентите на записи с фактури
UPDATE
  invoice_import T
SET
  client_id = D.client_id
OT
  client_import D
WHERE
  T.client_inn = D.inn; -- приложен ключ
Всъщност, всичко — в invoice_import сега полето за свързване е запълнено client_id, с което ще добавим фактурата.
Източник: habr.com
