

Винаги ми е било интересно как мога да организирам книгите в електронната си библиотека. Накрая стигнах до вариант с автоматично преброяване на страниците и някои допълнителни функции. Всички заинтересовани моля да продължат по-долу.
Част 1. Dropbox
Всички книги се съхраняват в Dropbox. Има 4 категории, на които съм ги разделил: Учебник, Справочник, Художествена литература, Нехудожествена литература. Но справочниците не ги добавям в таблицата.
По-голямата част от книгите са .epub, останалите — .pdf. Тоест окончателното решение трябва някак да покрива и двата формата.
Пътищата до книгите ми изглеждат приблизително така:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Ако книгата е художествена, то категорията (например «Дизайн» в горния случай) отпада.
Реших да не се задълбочавам с API на Dropbox, тъй като имам инсталирано тяхно приложение, което синхронизира папката. Тоест планът е следният: взимаме книгите от папката, всяка книга преминава през брояча на думи, добавяме я в Notion.
Част 2. Добавяне на ред
Самата таблица трябва да изглежда приблизително по следния начин. ВНИМАНИЕ: заглавията на колоните е по-добре да са на латиница.
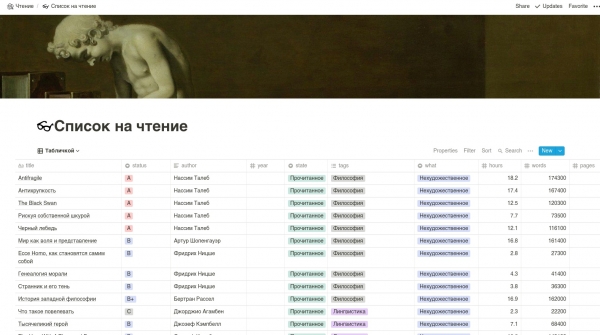
Ще използваме неофициалното API на Notion, тъй като официалното все още не е налично.

Отиваме в Notion, натискаме Ctrl + Shift + J, отиваме в Application -> Cookies, копираме token_v2 и го наричаме TOKEN. След това отиваме на нужната страница с таблицата на библиотеката и копираме линка. Наричаме го NOTION.
После ще напишем кода за свързване с Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
След това да напишем функция за добавяне на ред в таблицата.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Художествена литература":
            row.author = tags[2]

        elif tags[0] == "Нехудожествена литература":
            row.tags = tags[2]

        elif tags[0] == "Учебници":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Какво се случва тук. Вземаме и добавяме нов ред в таблицата на първия ред. След това разделяме пътя по «/» и получаваме таговете. Таговете са в смисъл на «Художествена литература», «Дизайн», кой е автор и така нататък. След това задаваме всички необходими полета на таблицата.
Част 3. Преброяване на думи, часове и други благини
Това е малко по-сложна задача. Както помним, имаме два формата: епаб и пдф. Ако с епаб всичко е ясно — думите вероятно със сигурност съществуват, то за пдф нещата не са толкова ясни: той може да се състои просто от слепени изображения.
Така че функцията за преброяване на думи в пдф ще изглежда по следния начин: взимаме броя на страниците и го умножаваме по определена константа (среден брой думи на страница).
Ето я:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Това е WORDS_PER_PAGE за A4 страница, който е приблизително равен на 300.
Сега нека напишем функция за преброяване на страниците. Ще използваме .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
След това ще напишем нещо за преброяване на страниците в епаб. Ще използваме . Тук взимаме книгата, конвертираме я в редове и за всеки ред броим думите.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Сега да направим преброяване на времето. Взимаме любимото ни количество думи и го делим на вашата скорост на четене.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Част 4. Свързване на всички части
Трябва да обходим всички възможни пътища в нашата папка с книги. Да проверим дали книгата вече е в Notion: ако е, реда няма да създаваме.
След това ни трябва да определим типа файл, в зависимост от него да преброим броя на думите. Накрая да добавим книгата.
Ето какъв код получаваме:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
А функцията за проверка дали книгата е добавена изглежда така:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Заключение
Благодаря на всички, които прочетоха тази статия. Надявам се тя да ви помогне да четете повече 🙂
Източник: habr.com
