

Здравейте! По време на курсовата си работа се занимавах с изследванията на възможностите на българската облачна платформа . Платформата предлага различни услуги за решаване на практични задачи. Въпреки това, понякога е необходимо на основата на тези услуги да настроите собственото си облачно приложение с достатъчно сложна инфраструктура. В тази статия искам да споделя опита си в разгръщането на такова приложение.
Какво желаем да постигнем?
— мощен инструмент за решаване на аналитични задачи или за мониторинг на определени системи. В своята базова конфигурация това е виртуална машина с уеб-сървър Grafana, а също така база данни (ClickHouse, InfluxDB и др.) с набор от данни, по който ще се изгражда аналитиката.
След стартиране на виртуалната машина с уеб-сървъра можете да влезете в нейния хост и да получите красив потребителски интерфейс, да посочите базите данни като източници за по-нататъшна работа, да създадете табла и графики.
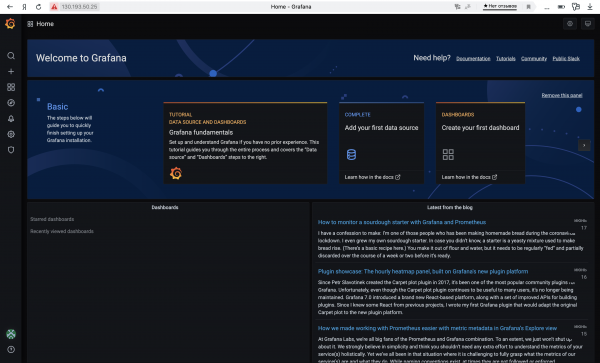
Базовата версия има един съществен недостатък — тя не е напълно отказоустойчива. Тоест, цялата работоспособност на приложението зависи от жизнеспособността на една виртуална машина. Ако тя се провали или 10 души открият интерфейса едновременно, ще възникнат проблеми.
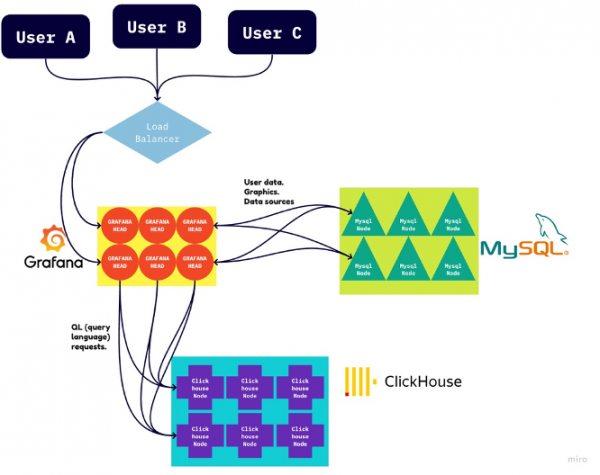
Те се решават просто: нужно е само... да разположите много идентични виртуални машини с уеб-сървъра и да ги поставите под L3-балансер. Но не всичко е толкова просто. Grafana съхранява потребителските настройки (пътища към базите данни, табла, графики и т.н.) директно на диска на своята виртуална машина. Така че, ако промените някакви настройки в интерфейса, тези промени ще се отразят само на тази виртуална машина, към която ни е насочил балансерът. Това ще доведе до неконсистентни настройки на нашето приложение и ще възникнат проблеми с пускането и използването му.
Тук на помощ идва още една база данни, например MySQL или нейният аналог. Казваме на Grafana, че трябва да съхранява потребителските настройки именно в тази "резервна" база. След това ще е достатъчно веднъж да укажем на всяка машина пътя към тази база данни, а всички останали потребителски настройки можем да редактираме на всяка от виртуалните машини и те ще се разпространяват на останалите.
Ето схемата на финалната инфраструктура на приложението:
Ще научим как да разположим ръчно
MySQL и ClickHouse
Преди да разгръщате такова приложение с натискането на един бутон, трябваше да научите как да стартирате ръчно всеки от неговите компоненти и да ги интегрирате помежду си.
Тук на помощ идва Яндекс.Облако, което предоставя L3-балансьори, ClickHouse и MySQL като managed-сервизи. На потребителя само му е нужно да зададе параметрите и да изчака, докато платформата ги направи работещи.
Регистрирах се, създадох облак и платежен акаунт. След това влязох в облака и стартирах кластери MySQL и ClickHouse с минимални настройки. Изчаках, докато станат активни.
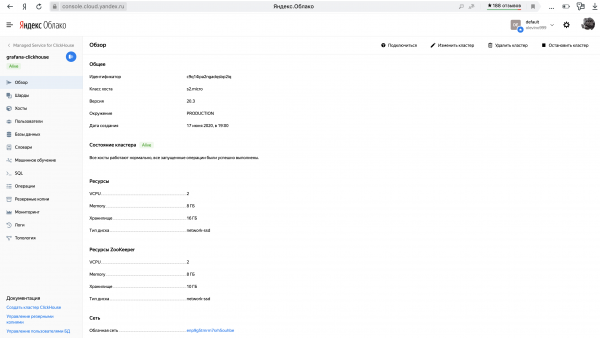
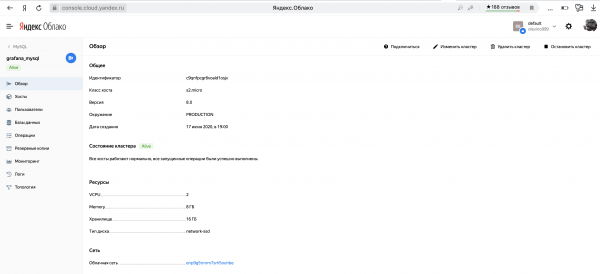
Също така трябва да не забравя да създам база данни във всеки кластер и да настроя достъпа до нея с логин и парола. Няма да влизам в детайли тук — в интерфейса всичко е доста очевидно.
Неочевиден детайл беше, че тези БД имат множество хостове, които осигуряват тяхната отказоустойчивост. Въпреки това, Grafana изисква точно един хост за всяка БД, с която работи. Облакът ми помогна да намеря решение. Оказва се, че хостът от вида c-<cluster_id>.rw.mdb.yandexcloud.net се мапва към текущия активен главен хост на кластер с съответния идентификатор. Именно него ще предоставим на Grafana.
Уеб сървър
Сега остава да настроим уеб сървъра. Ще стартираме обикновена виртуална машина с Linux и ръчно ще настроим Grafana на нея.
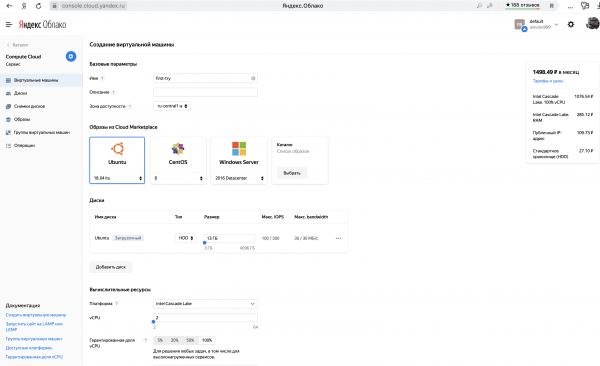
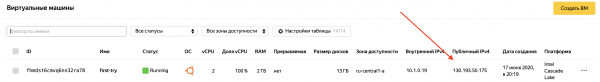
Свързваме се чрез ssh и инсталираме необходимите пакети.
sudo apt-get install -y apt-transport-https software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
След това стартираме Grafana с systemctl и инсталираме плъгин за работа с ClickHouse (да, той не е включен в основната компилация).
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
Всичко, след това с простата команда
sudo service grafana-server startстартираме уеб сървъра. Сега може да въведем външния ip адрес на виртуалната машина, да посочим порт 3000 и да видим красивия UI на Grafana.
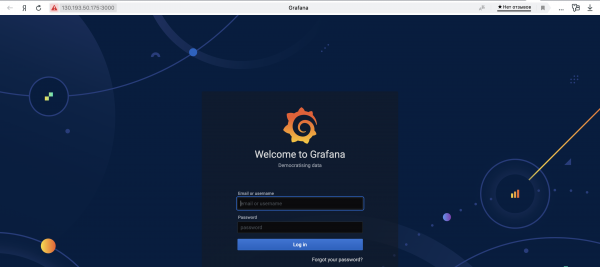
Но не бързайте, преди да настроите Grafana, трябва да не забравите да посочите пътя към MySQL, за да се съхраняват настройки там.
Всичката конфигурация на уеб сървъра на Grafana се намира в файла /etc/grafana/grafana.ini. Нужният ред изглежда така:
;url =Настройваме хост за кластера MySQL. В този файл се намират потребителското име и паролата за достъп до Grafana, посочени на изображението по-горе, които по подразбиране са равни. админ.
Можете да използвате командите sed:
sudo sed -i "s#.*;url =.*#url = mysql://{MYSQL_USERNAME}:{MYSQL_PASSWORD}@{MYSQL_CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = {GRAFANA_USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = {GRAFANA_PASSWORD}#" /etc/grafana/grafana.ini
Сега е времето да рестартираме уеб сървъра!
sudo service grafana-server restartСега в UI на Grafana ще зададем ClickHouse като DataSource.
Успях да постигна работеща конфигурация с следните настройки:
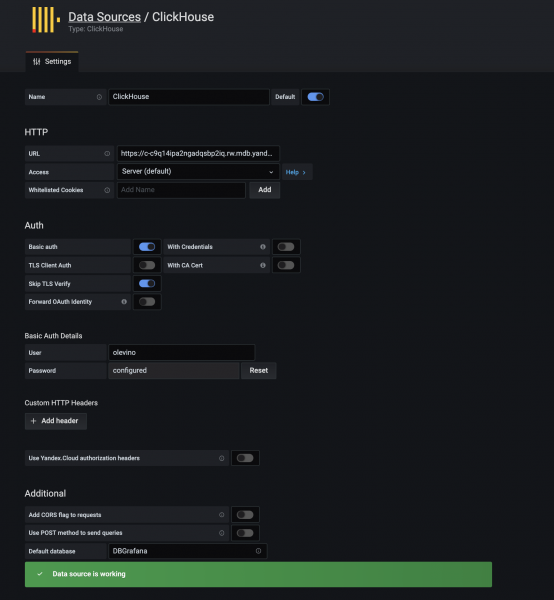
Като URL зададох https://c-.rw.mdb.yandexcloud.net:8443
Готово! Имаме една работеща виртуална машина с уеб сървър, свързан с CH и MySQL. Вече можем да качим dataset в ClickHouse и да изградим dashboards. Все пак не сме достигнали целта си и не сме развили пълноценна инфраструктура.
Packer
Yandex.Cloud позволява да създадете образ на диска на съществуващата виртуална машина, а на базата на него — неограничен брой идентични машини. Именно това ще използваме. За удобно събиране на образа, ще вземем инструмента от HashiCorp. Той приема JSON файл с инструкции за изграждане на образа.
Нашият JSON файл ще се състои от два блока: builders и provisioners. Първият блок описва параметрите на самия образ като сущност, а вторият — инструкциите за попълване с необходимото съдържание.
Builders
{
"builders": [
    {
      "type": "yandex",
      "endpoint": "{{user `endpoint`}}",
      "folder_id": "",
      "subnet_id": "{{user `subnet_id`}}",
      "zone": "{{user `zone`}}",
      "labels": {},
      "use_ipv4_nat": true,
      "use_internal_ip": false,
      "service_account_key_file": "",
      "image_name": "grafana-{{timestamp}}",
      "image_family": "grafana",
      "image_labels": {},
      "image_description": "GRAFANA",
      "source_image_family": "ubuntu-1804-lts",
      "disk_size_gb": 3,
      "disk_type": "network-hdd",
      "ssh_username": "ubuntu"
    }
  ],
...
}
В този шаблон трябва да зададете идентификатор на секцията в облака, където искате да създадете образ, както и пътя към файла с ключовете от сервизния акаунт, предварително създаден в тази секция. Повече информация относно създаването на сервизни акаунти и ключове в файл можете да намерите в съответния раздел. .
Тази конфигурация казва, че образът на диска ще бъде събран на базата на платформата ubuntu-1804-lts, и ще бъде поставен в съответната секция на потребителя в семейството на образите GRAFANA с името grafana-{{timestamp}}.
Provisioners
Сега по-интересната част на конфигурацията. В нея ще бъде описана последователността от действия, които трябва да се извършат на виртуалната машина, преди да замразите нейното състояние в образ на диск.
{
...,
"provisioners": [
    {
            "type": "shell",
            "pause_before": "5s",
            "scripts": [
                "prepare-ctg.sh"
            ]
        },
    {
            "type": "file",
            "source": "setup.sh",
            "destination": "\/opt\/grafana\/setup.sh"
        },
        {
            "type": "shell",
        "execute_command": "sudo {{ .Vars }} bash '{{ .Path }}'",
            "pause_before": "5s",
            "scripts": [
                "install-packages.sh",
                "grafana-setup.sh",
                "run-setup-at-reboot.sh"
        ]
        }
  ]
}
Тук всички действия са разделени на 3 етапа. На първия етап се изпълнява прост скрипт, който създава помощна директория.
prepare-ctg.sh:
#!/bin/bash
sudo mkdir -p /opt/grafana
sudo chown -R ubuntu:ubuntu /opt/grafana
На следващия етап в тази директория поставяме скрипт, който ще трябва да бъде стартиран веднага след стартиране на виртуалната машина. Този скрипт ще зададе потребителските променливи, които трябва да бъдат записани в конфигурацията на Графана и ще рестартира уеб сървъра.
setup.sh:
#!/bin/bash
CLUSTER_ID="<cluster_id>"
USERNAME="<username>"
PASSWORD="<password>"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@c-${CLUSTER_ID}.rw.mdb.yandexcloud.net#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
След това остава да се направят 3 неща:
1) инсталиране на пакетите
2) добавяне на Графана под systemctl и инсталиране на плъгина ClickHouse
3) поставяне на скрипт setup.sh в опашката за стартиране веднага след включване на виртуалната машина.
install-packages.sh:
#!/bin/bash
sudo systemd-run --property='After=apt-daily.service apt-daily-upgrade.service' --wait /bin/true
sudo apt-get install -y apt-transport-https
sudo apt-get install -y software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
grafana-setup.sh:
#!/bin/bash
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
run-setup-at-reboot.sh:
#!/bin/bash
chmod +x /opt/grafana/setup.sh
cat > /etc/cron.d/first-boot <<EOF
PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin:/usr/games:/usr/local/games
@reboot root /bin/bash /opt/grafana/setup.sh > /var/log/yc-setup.log 2>&1
EOF
chmod +x /etc/cron.d/first-boot;
Сега остава да стартирате Packer и на изхода да получите образ, поставен в указания дял. При създаване на виртуална машина можете да го изберете като зареден диск и след стартиране да получите готов уеб сървър на Графана.
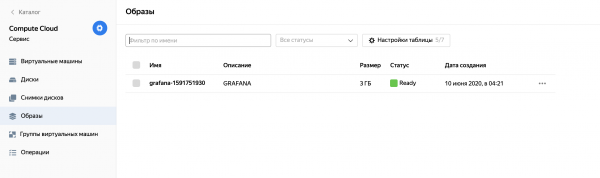
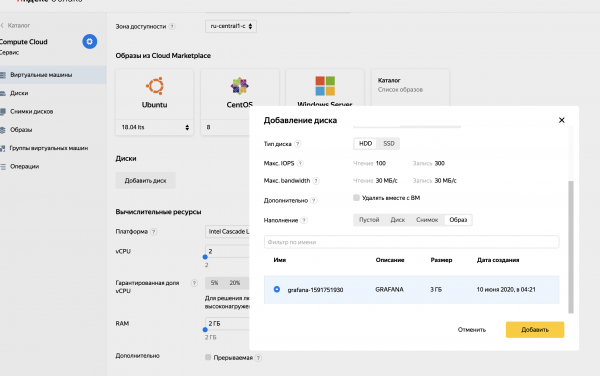
Група инстанции и балансьор
След като се появи изображението на диска, което позволява създаването на множество еднакви уеб сървъри на Графана, можем да създадем група инстанции. На платформата на Яндекс.Облако с този термин се обозначава обединение на виртуални машини с еднакви характеристики. При създаване на група инстанции се конфигурира прототип на всички машини в тази група, а след това и характеристики на самата група (например, минимален и максимален брой активни машини). Ако текущото количество не отговаря на тези критерии, групата инстанции сама ще премахне ненужните машини или ще създаде нови по образ и подобие.
В рамките на нашата задача ще създадем група инстанции на уеб сървъри, които ще бъдат генерирани от създадения по-рано образ на диска.
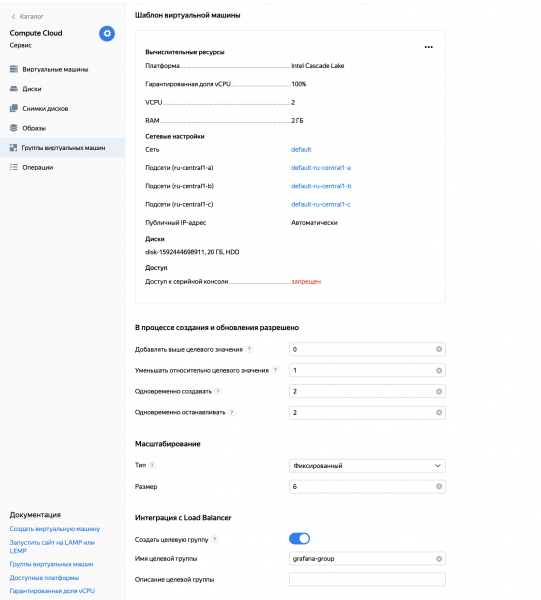
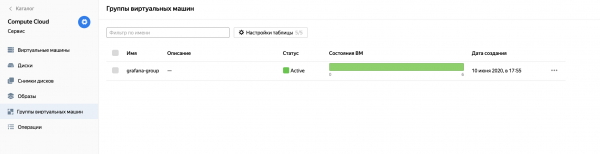
Наистина забележителна е последната настройка на инстанс-групата. Целевата група в интеграцията с Load Balancer ще помогне с натискането на няколко бутона да конфигурирате L3-балансер върху виртуалните машини в тази група.
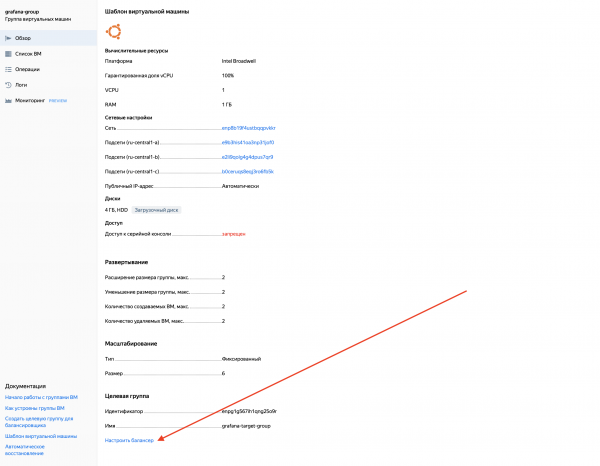
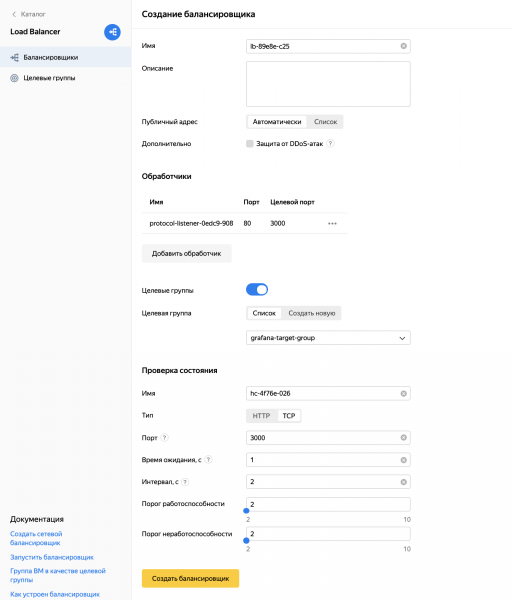
При настройването на балансера реализирах два важни момента:
- Настроих така, че балансерът да приема потребителски трафик на 80 порта и да го препраща на 3000 порта на виртуалните машини, точно там, където се намира Grafana.
- Настроих проверка на жизнеспособността на машините, пингвайки ги на 3000 порта.
Мини-итог
Накрая успяхме ръчно да разположим желаната инфраструктура на приложението и сега имаме високоустойчив сервис Grafana. Необходимо е само да знаем IP адреса на балансера като входна точка към приложението и хоста на клъстера ClickHouse, за да заредим сет данни.
Изглежда като победа? Да, победа. Но нещо все пак притеснява. Цялостният процес изисква много ръчни действия и изобщо не е мащабируем, иска се да бъде автоматизиран, доколкото е възможно. На това ще бъде посветена следващата част.
Интеграция с Terraform
Отново ще използваме инструмента на компанията HashiCorp, наречен . Той ще помогне с натискане на бутон за разгръщане на цялата приложна инфраструктура, базирана на няколко променливи, предадени от потребителя. Нека напишем рецепта, която може да се стартира многократно в различни раздели за различни потребители.
Цялата работа с Terraform се свежда до написването на конфигурационен файл (*.tf) и създаването на инфраструктура на неговата основа.
Променливи
В самото начало на файла ще изведем променливи, от които зависи къде и как ще бъде разположена бъдещата инфраструктура.
variable "oauth_token" {
    type = string
    default = ""
}
variable "cloud_id" {
    type = string
    default = ""
}
variable "folder_id" {
    type = string
    default = ""
}
variable "service_account_id" {
    type = string
    default = ""
}
variable "image_id" {
    type = string
    default = ""
}
variable "username" {
    type = string
    default = ""
}
variable "password" {
    type = string
    default = ""
}
variable "dbname" {
    type = string
    default = ""
}
variable "public_key_path" {
    type = string
    default = ""
}
Целият процес на разгръщане на приложението ще се състои в изграждане на образ на диска и задаване на тези променливи. Ще обясня за какво отговарят:
oauth_token — токен за достъп до облака. Може да се получи чрез .
cloud_id — идентификатор на облака, в който ще разгръщаме приложението
folder_id — идентификатор на раздела, където ще разгръщаме приложението
service_account_id — идентификатор на сервисния акаунт в съответния облачен раздел.
image_id — идентификатор на образа на диска, който е получен с помощта на Packer
username и password — име на потребителя и парола за достъп до двете бази данни и уеб сървъра на Grafana
dbname — име на базата данни в кластерите CH и MySQL
public_key_path — пътят до файла с вашия публичен ssh ключ, по който можете да се свързвате с име ubuntu към виртуалните машини с уеб сървъри
Настройка на провайдера
Сега трябва да настроим провайдера на Terraform — в нашия случай Yandex:
provider "yandex" {
  token     = var.oauth_token
  cloud_id  = var.cloud_id
  folder_id = var.folder_id
  zone      = "ru-central1-a"
}
Може да се забележи, че тук използваме променливите, зададени по-горе.
Мрежа и клъстери
Сега ще създадем мрежа, в която елементите на нашата инфраструктура ще комуникират, три подсетки (по една във всеки регион) и ще стартираме клъстери CH и MySQL.
resource "yandex_vpc_network" "grafana_network" {}

resource "yandex_vpc_subnet" "subnet_a" {
  zone           = "ru-central1-a"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.1.0.0\/24"]
}

resource "yandex_vpc_subnet" "subnet_b" {
  zone           = "ru-central1-b"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.2.0.0\/24"]
}

resource "yandex_vpc_subnet" "subnet_c" {
  zone           = "ru-central1-c"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.3.0.0\/24"]
}

resource "yandex_mdb_clickhouse_cluster" "ch_cluster" {
  name        = "grafana-clickhouse"
  environment = "PRODUCTION"
  network_id  = yandex_vpc_network.grafana_network.id

  clickhouse {
    resources {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 16
    }
  }

  zookeeper {
    resources {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 10
    }
  }

  database {
    name = var.dbname
  }

  user {
    name     = var.username
    password = var.password
    permission {
      database_name = var.dbname
    }
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}

resource "yandex_mdb_mysql_cluster" "mysql_cluster" {
  name        = "grafana_mysql"
  environment = "PRODUCTION"
  network_id  = yandex_vpc_network.grafana_network.id
  version     = "8.0"

  resources {
    resource_preset_id = "s2.micro"
    disk_type_id       = "network-ssd"
    disk_size          = 16
  }

  database {
    name = var.dbname
  }

  user {
    name     = var.username
    password = var.password
    permission {
      database_name = var.dbname
      roles         = ["ALL"]
    }
  }

  host {
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }
  host {
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }
  host {
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}
Както може да се забележи, всеки от двата клъстера е създаден с достатъчна отказоустойчивост благодарение на разположението си в три зони на достъпност.
Уеб сървъри
На пръв поглед, бих могъл да продължа по същия начин, но се сблъсках със сложност. Преди това първо стартирах MySQL клъстер и едва след това, знаейки неговия ID, събирах образ на диска с необходимата конфигурация, където посочвах хост на клъстера. Но сега не знаем ID на клъстера преди стартирането на Terraform, включително и в момента на събиране на образа. Затова се налага да прибегна до следния .
Използвайки услугата за метаданни от Amazon, ще предадем на виртуалната машина някои параметри, които тя ще приеме и обработи. Необходимо е, след стартиране, машината да посети метаданните за хоста на MySQL клъстера и за потребителското име и парола, които потребителят е посочил във файла Terraform. Няма да променяме съдържанието на файла значително. setup.sh, който се стартира при включване на виртуалната машина.
setup.sh:
#!/bin/bash
CLUSTER_URI="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/mysql_cluster_uri)"
USERNAME="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/username)"
PASSWORD="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/password)"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@${CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
Инстанс-група и балансер
След като пресъздадем нов образ на диска, най-накрая можем да допълним нашия файл за Terraform.
Ще посочим, че искаме да използваме съществуващ образ на диска:
data "yandex_compute_image" "grafana_image" {
  image_id = var.image_id
}
Сега ще създадем инстанс-група:
resource "yandex_compute_instance_group" "grafana_group" {
  name               = "grafana-group"
  folder_id          = var.folder_id
  service_account_id = var.service_account_id
  instance_template {
    platform_id = "standard-v1"
    resources {
      memory = 1
      cores  = 1
    }
    boot_disk {
      mode = "READ_WRITE"
      initialize_params {
        image_id = data.yandex_compute_image.grafana_image.id
        size     = 4
      }
    }
    network_interface {
      network_id = yandex_vpc_network.grafana_network.id
      subnet_ids = [yandex_vpc_subnet.subnet_a.id, yandex_vpc_subnet.subnet_b.id, yandex_vpc_subnet.subnet_c.id]
      nat = "true"
    }
    metadata = {
      mysql_cluster_uri = "c-${yandex_mdb_mysql_cluster.mysql_cluster.id}.rw.mdb.yandexcloud.net:3306/${var.dbname}"
      username = var.username
      password = var.password
      ssh-keys = "ubuntu:${file("${var.public_key_path}")}"
    }
    network_settings {
      type = "STANDARD"
    }
  }

  scale_policy {
    fixed_scale {
      size = 6
    }
  }

  allocation_policy {
    zones = ["ru-central1-a", "ru-central1-b", "ru-central1-c"]
  }

  deploy_policy {
    max_unavailable = 2
    max_creating    = 2
    max_expansion   = 2
    max_deleting    = 2
  }

  load_balancer {
    target_group_name = "grafana-target-group"
  }
}
Важно е да се отбележи как предадохме в метаданните cluster_uri, username и password. Именно те виртуалната машина ще извлече и постави в конфигурацията на Grafana при стартиране.
Сега остава задачата за балансера.
resource "yandex_lb_network_load_balancer" "grafana_balancer" {
  name = "grafana-balancer"

  listener {
    name = "grafana-listener"
    port = 80
    target_port = 3000
    external_address_spec {
      ip_version = "ipv4"
    }
  }

  attached_target_group {
    target_group_id = yandex_compute_instance_group.grafana_group.load_balancer.0.target_group_id

    healthcheck {
      name = "healthcheck"
      tcp_options {
        port = 3000
      }
    }
  }
}
Малко захар
Остана малко. След като инфраструктурата бъде разгърната, ще трябва да отидем в интерфейса на Grafana и ръчно да добавим клъстер CH (ID-то на който още трябва да извадим) като Data Source. Но ID-то на клъстера знае Terraform. Поръчваме му да доведе работата до край.
Добавяме нов провайдер — Grafana, а като хост ще ѝ предоставим IP адреса на балансера. Всички изменения, които Terraform направи на машината, определена от балансера, ще се отразят в MySQL, а следователно и на всички останали машини.
provider "grafana" {
  url  = "http://${[for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0}"
  auth = "${var.username}:${var.password}"
}

resource "grafana_data_source" "ch_data_source" {
  type          = "vertamedia-clickhouse-datasource"
  name          = "grafana"
  url           = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
  basic_auth_enabled = "true"
  basic_auth_username = var.username
  basic_auth_password = var.password
  is_default = "true"
  access_mode = "proxy"
}
Преобразуваме
Ще изведем IP адреса на балансера и хоста на ClickHouse клъстера
output "grafana_balancer_ip_address" {
  value = [for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0
}

output "clickhouse_cluster_host" {
  value = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
}
Може да започваме
Готово! Нашият конфигурационен файл е готов и можем, задавайки променливите, да кажем на Terraform да стартира всичко, което описахме по-горе. Целият процес отне около 15 минути.
В края можем да видим красиво съобщение:
Apply complete! Ресурси: 9 добавени, 0 променени, 0 унищожени.
Изходи:

clickhouse_cluster_host = https://c-c9q14ipa2ngadqsbp2iq.rw.mdb.yandexcloud.net:8443
grafana_balancer_ip_address = 130.193.50.25
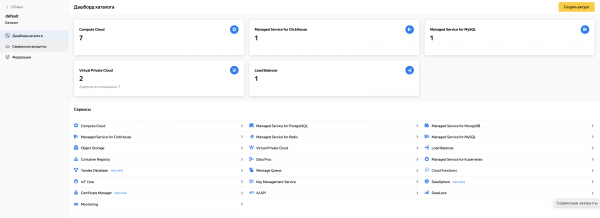
А в облака ще са видими елементите на създадената инфраструктура:
Нека обобщим
Сега на примера на Grafana всеки от вас може да разгръща приложения с разширена облачна архитектура на платформата Yandex.Cloud. В това могат да помогнат полезни инструменти от HashiCorp като Packer и Terraform. Надявам се, че на някого тази статия ще се стори полезна 🙂
P.S. По-долу ще приложа линк към хранилище, в което можете да намерите готови рецепти за Packer и Terraform, части от които представих в тази статия.
Източник: habr.com
