

Онлайн препоръчителна система за видеосъдържание, върху която работим, е затворена търговска разработка и технически представлява многокомпонентен клъстър от собствени и open source компоненти. Целта на написването на тази статия е да опише внедряването на системата за клъстериране Docker Swarm в staging среда, без да нарушава установения workflow на нашите процеси в условия на ограничено време. Представеното на вашето внимание повествование е разделено на две части. Първата част описва CI/CD преди използването на Docker Swarm, а втората — процеса на неговото внедряване. Който не е заинтересован да прочете първата част, може смело да премине към втората.
Част I
В далечната година се наложи да настроим процеса CI/CD възможно най-бързо. Едно от условията беше да не използваме Docker за деплойване на разработваните компоненти по няколко причини:
- за по-надеждна и стабилна работа на компонентите в Production (т.е. по същество условие за не използване на виртуализация)
- ведущите разработчици не искали да работят с Docker (странно, но точно така беше)
- по идейни съображения на ръководството на R&D
Инфраструктурата, стекът и примерните изходни изисквания за MVP бяха представени така:
- 4 сървъра Intel® X5650 с Debian (една по-мощна машина изцяло за разработка)
- Разработката на собствени кастомни компоненти се извършва на C++, Python3
- Основните използвани 3rdparty инструменти: Kafka, Clickhouse, Airflow, Redis, Grafana, Postgresql, Mysql, …
- Pipelines за изграждане и тестване на компонентите поотделно за debug и release
Един от първите въпроси, които трябва да решим в началната фаза, е как ще се осъществява разгръщането на кастомните компоненти в някаква среда (CI/CD).
Външните компоненти решиха да се инсталират системно и да се обновяват по системен начин. Персонализираните приложения, разработени на C++ или Python, могат да се разгръщат по няколко начина. Сред тях, например: създаване на системни пакети, изпращане на тези пакети в хранилище с готови образи и последваща инсталация на сървърите. По неизвестна причина беше избран друг метод, а именно: с помощта на CI се компилират изпълними файлове на приложенията, създава се виртуална среда на проекта, инсталират се py-модули от requirements.txt и всички тези артефакти се изпращат заедно с конфигурации, скриптове и свързаната среда на приложенията на сървърите. Следва стартиране на приложенията от виртуален потребител без администраторски права.
Като система CI/CD беше избран Gitlab-CI. Полученият pipeline изглеждаше приблизително така:
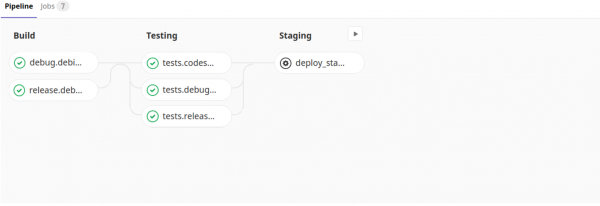
Структурно gitlab-ci.yml изглеждаше по следния начин
---
variables:
  # минимална версия на CPU на сървърите, където се разгръща клъстерът
  CMAKE_CPUTYPE: "westmere"

  DEBIAN: "MYREGISTRY:5000/debian:latest"

before_script:
  - eval $(ssh-agent -s)
  - ssh-add  ~/.ssh/config

stages:
  - build
  - testing
  - deploy

debug.debian:
  stage: build
  image: $DEBIAN
  script:
    - cd builds/release && ./build.sh
    paths:
      - bin/
      - builds/release/bin/
    when: always
release.debian:
  stage: build
  image: $DEBIAN
  script:
    - cd builds/release && ./build.sh
    paths:
      - bin/
      - builds/release/bin/
    when: always

## testing stage
tests.codestyle:
  stage: testing
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - /bin/bash run_tests.sh -t codestyle -b "${CI_COMMIT_REF_NAME}_codestyle"
tests.debug.debian:
  stage: testing
  image: $DEBIAN
  dependencies:
    - debug.debian
  script:
    - /bin/bash run_tests.sh -e codestyle/test_pylint.py -b "${CI_COMMIT_REF_NAME}_debian_debug"
  artifacts:
    paths:
      - run_tests/username/
    when: always
    expire_in: 1 week
tests.release.debian:
  stage: testing
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - /bin/bash run_tests.sh -e codestyle/test_pylint.py -b "${CI_COMMIT_REF_NAME}_debian_release"
  artifacts:
    paths:
      - run_tests/username/
    when: always
    expire_in: 1 week

## staging stage
deploy_staging:
  stage: deploy
  environment: staging
  image: $DEBIAN
  dependencies:
    - release.debian
  script:
    - cd scripts/deploy/ &&
        python3 createconfig.py -s $CI_ENVIRONMENT_NAME &&
        /bin/bash install_venv.sh -d -r ../../requirements.txt &&
        python3 prepare_init.d.py &&
        python3 deploy.py -s $CI_ENVIRONMENT_NAME
  when: manual
Важно е да се отбележи, че сборката и тестовете се извършват на собствен образ, където вече са инсталирани всички необходими системни пакети и са направени други настройки.
Въпреки че всеки от тези скриптове в job-овете е интересен по своему, няма да говоря за тях, разбира се, описанието на всеки от тях би отнело значително време и не е целта на статията. Ще подчертая само, че етапът на деплойване се състои от последователност от извиквания на скриптове:
- createconfig.py — създава файл settings.ini с настройки на компонентите в различни среди за последващо деплойване (Preproduction, Production, Testing, …)
- install_venv.sh — създава виртуална среда за py-компоненти в определен директория и я копира на отдалечените сървъри
- prepare_init.d.py — подготвя скриптове за стартиране-спиране на компонентите на базата на шаблон
- deploy.py — разполага и рестартира новите компоненти
Минаваше време. Етапът staging беше заменен с preproduction и production. Беше добавена поддръжка на продукта на още един дистрибутив (CentOS). Добавиха се още 5 мощни физически сървъра и десетина виртуални. А на разработчиците и тестерите ставаше все по-трудно да тестват задачите си в среда, близка до работното състояние. В това време стана ясно, че не можем да минем без него...
Част II
Така че, нашият кластер представлява истинско зрелище — система от няколко десетки отделни компоненти, не описани в Dockerfile-ове. Конфигурирането му за деплой на определена среда може да се направи само изцяло. Нашата задача е да деплоим кластера в staging-среда, за да го тестваме преди предварителното тестиране.
Теоретично, могат да работят няколко клъстера едновременно: толкова, колкото са задачите в завършено състояние или близки до завършване. Ресурсите, които имаме на разположение, позволяват стартирането на няколко клъстера на всеки сървър. Всеки staging-клъстер трябва да бъде изолиран (не трябва да има припокриване по портове, директории и т.н.).
Най-ценният ресурс е нашето време, а то беше малко.
За по-бърз старт избрахме Docker Swarm заради простотата и гъвкавостта на архитектурата. Първото, което направихме, беше да създадем мениджър и няколко ноди на отдалечените сървъри:
$ docker node ls
ID                            HOSTNAME            STATUS              AVAILABILITY        MANAGER STATUS      ENGINE VERSION
kilqc94pi2upzvabttikrfr5d     nop-test-1     Готов               Активен                                  19.03.2
jilwe56pl2zvabupryuosdj78     nop-test-2     Готов               Активен                                  19.03.2
j5a4yz1kr2xke6b1ohoqlnbq5 *   nop-test-3     Готов               Активен              Лидер              19.03.2
След това създадохме мрежа:
$ docker network create --driver overlay --subnet 10.10.10.0/24 nw_swarm
След това свързахме Gitlab-CI и нодовете на Swarm по отношение на отдалеченото управление на нодовете от CI: инсталиране на сертификати, настройване на секретни променливи, както и настройка на Docker услугата на управляващия сървър. Това ни спести много време.
След това добавихме job-ове за създаване и унищожаване на стека в .gitlab-ci.yml.
В .gitlab-ci.yml се добавиха още няколко job
## staging stage
deploy_staging:
  stage: testing
  before_script:
    - echo "override global 'before_script'"
  image: "REGISTRY:5000/docker:latest"
  environment: staging
  dependencies: []
  variables:
    DOCKER_CERT_PATH: "/certs"
    DOCKER_HOST: tcp://10.50.173.107:2376
    DOCKER_TLS_VERIFY: 1
    CI_BIN_DEPENDENCIES_JOB: "release.centos.7"
  script:
    - mkdir -p $DOCKER_CERT_PATH
    - echo "$TLSCACERT" > $DOCKER_CERT_PATH/ca.pem
    - echo "$TLSCERT" > $DOCKER_CERT_PATH/cert.pem
    - echo "$TLSKEY" > $DOCKER_CERT_PATH/key.pem
    - docker stack deploy -c docker-compose.yml ${CI_ENVIRONMENT_NAME}_${CI_COMMIT_REF_NAME} --with-registry-auth
    - rm -rf $DOCKER_CERT_PATH
  when: manual

## stop staging stage
stop_staging:
  stage: testing
  before_script:
    - echo "override global 'before_script'"
  image: "REGISTRY:5000/docker:latest"
  environment: staging
  dependencies: []
  variables:
    DOCKER_CERT_PATH: "/certs"
    DOCKER_HOST: tcp://10.50.173.107:2376
    DOCKER_TLS_VERIFY: 1
  script:
    - mkdir -p $DOCKER_CERT_PATH
    - echo "$TLSCACERT" > $DOCKER_CERT_PATH/ca.pem
    - echo "$TLSCERT" > $DOCKER_CERT_PATH/cert.pem
    - echo "$TLSKEY" > $DOCKER_CERT_PATH/key.pem
    - docker stack rm ${CI_ENVIRONMENT_NAME}_${CI_COMMIT_REF_NAME}
    # TODO: need check that stopped
  when: manual
От горепосочения фрагмент от кода е видно, че в Pipelines са добавени две бутона (deploy_staging, stop_staging), изискващи ръчно действие.
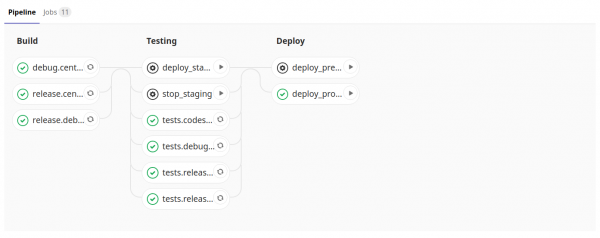
Името на стека съответства на името на клон и тази уникалност трябва да е достатъчна. Услугите в стека получават уникални IP адреси, а портовете, директориите и т.н. ще бъдат изолирани, но еднакви от стек на стек (тъй като конфигурационния файл е еднакъв за всички стеки) — това, което искахме. Стек (кластър) разгръщаме с помощта на docker-compose.yml, в който е описан нашия кластер.
docker-compose.yml
---
version: '3'

services:
  userprop:
    image: redis:alpine
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:
  celery_bcd:
    image: redis:alpine
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  schedulerdb:
    image: mariadb:latest
    environment:
      MYSQL_ALLOW_EMPTY_PASSWORD: 'yes'
      MYSQL_DATABASE: schedulerdb
      MYSQL_USER: ****
      MYSQL_PASSWORD: ****
    command: ['--character-set-server=utf8mb4', '--collation-server=utf8mb4_unicode_ci', '--explicit_defaults_for_timestamp=1']
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  celerydb:
    image: mariadb:latest
    environment:
      MYSQL_ALLOW_EMPTY_PASSWORD: 'yes'
      MYSQL_DATABASE: celerydb
      MYSQL_USER: ****
      MYSQL_PASSWORD: ****
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

  cluster:
    image: $CENTOS7
    environment:
      - CENTOS
      - CI_ENVIRONMENT_NAME
      - CI_API_V4_URL
      - CI_REPOSITORY_URL
      - CI_PROJECT_ID
      - CI_PROJECT_URL
      - CI_PROJECT_PATH
      - CI_PROJECT_NAME
      - CI_COMMIT_REF_NAME
      - CI_BIN_DEPENDENCIES_JOB
    command: >
      sudo -u myusername -H /bin/bash -c ". /etc/profile &&
        mkdir -p /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME &&
        cd /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME &&
            git clone -b $CI_COMMIT_REF_NAME $CI_REPOSITORY_URL . &&
            curl $CI_API_V4_URL/projects/$CI_PROJECT_ID/jobs/artifacts/$CI_COMMIT_REF_NAME/download?job=$CI_BIN_DEPENDENCIES_JOB -o artifacts.zip &&
            unzip artifacts.zip ;
        cd /storage1/$CI_COMMIT_REF_NAME/$CI_PROJECT_NAME/scripts/deploy/ &&
            python3 createconfig.py -s $CI_ENVIRONMENT_NAME &&
            /bin/bash install_venv.sh -d -r ../../requirements.txt &&
            python3 prepare_init.d.py &&
            python3 deploy.py -s $CI_ENVIRONMENT_NAME"
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    tty: true
    stdin_open: true
    networks:
      nw_swarm:

networks:
  nw_swarm:
    external: true
Тук се вижда, че компонентите са обединени в една мрежа (nw_swarm) и са достъпни помежду си.
Системните компоненти (основаващи се на redis, mysql) са отделени от общия пул на персонализираните компоненти (в плановете е предвидено и персонализирането им като услуги). Етапът на внедряване на нашия клъстер изглежда като предаване на CMD в нашия един голям конфигуриран имидж и по същество почти не се различава от внедряването, описано в Част I. Подчертавам разликите:
- git clone … — получаваме файлове, необходими за извършване на внедряване (createconfig.py, install_venv.sh и т.н.)
- curl… && unzip … — сваляме и разархивираме артефактите от компилацията (скомпилирани утилити)
Остава само една неизяснена проблема: компонентите, които имат уеб интерфейс, не са достъпни от браузърите на разработчиците. Решаваме този проблем с reverse proxy по следния начин:
В .gitlab-ci.yml след деплой на стека на клъстера добавяме реда за деплой на балансировчика (който при комити само обновява своята конфигурация (създава нови конфигурационни файлове nginx по шаблон: /etc/nginx/conf.d/${CI_COMMIT_REF_NAME}.conf) — виж кода docker-compose-nginx.yml)
- docker stack deploy -c docker-compose-nginx.yml ${CI_ENVIRONMENT_NAME} --with-registry-auth
docker-compose-nginx.yml
---
version: '3'

services:
  nginx:
    image: nginx:latest
    environment:
      CI_COMMIT_REF_NAME: ${CI_COMMIT_REF_NAME}
      NGINX_CONFIG: |-
            server {
                listen 8080;
                server_name staging_${CI_COMMIT_REF_NAME}_cluster.dev;

                location / {
                    proxy_pass http://staging_${CI_COMMIT_REF_NAME}_cluster:8080;
                }
            }
            server {
                listen 5555;
                server_name staging_${CI_COMMIT_REF_NAME}_cluster.dev;

                location / {
                    proxy_pass http://staging_${CI_COMMIT_REF_NAME}_cluster:5555;
                }
            }
    volumes:
      - /tmp/staging/nginx:/etc/nginx/conf.d
    command:
      /bin/bash -c "echo -e "$$NGINX_CONFIG" > /etc/nginx/conf.d/${CI_COMMIT_REF_NAME}.conf;
        nginx -g "daemon off;";
        /etc/init.d/nginx reload"
    ports:
      - 8080:8080
      - 5555:5555
      - 3000:3000
      - 443:443
      - 80:80
    deploy:
      replicas: 1
      placement:
        constraints: [node.id == kilqc94pi2upzvabttikrfr5d]
      restart_policy:
        condition: none
    networks:
      nw_swarm:

networks:
  nw_swarm:
    external: true
На компютрите на разработчиците обновяваме /etc/hosts; записваме URL до nginx:
10.50.173.106 staging_BRANCH-1831_cluster.dev
И така, деплой на изолирани staging клъстери е реализиран и разработчиците вече могат да ги стартират в достатъчно голямо количество за проверка на задачите си.
Следващи планове:
- Да разделим компонентите си на услуги
- Да направим за всеки Dockerfile
- Автоматично да се определят по-малко натоварени възли в стека
- Да задаваме възлите по шаблона на името (а не да използваме ID, както в статията)
- Да добавим проверка, че стекът е унищожен
- …
Отделна благодарност за .
Източник: habr.com
