

Част 1: Web / Android
Забележка: тази статия е превод на руски език на оригиналната статия Въпреки това, всички илюстрации, линкове, цитати и термини са запазени на оригиналния език, за да се избегне изкривяване на смисъла при превода на руски. Желая ви приятно изучаване!
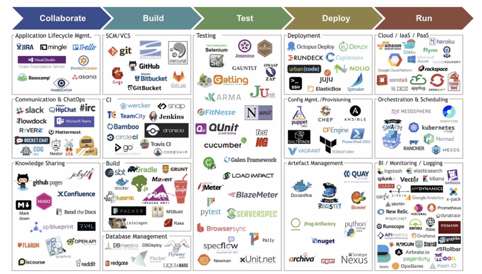
В момента професията DevOps е една от най-търсените в ИТ индустрията. Ако отворите популярни сайтове за търсене на работа и зададете филтър за заплатите, ще видите, че обявите, свързани с DevOps, са в началото на списъка. Но е важно да се разбере, че това основно се отнася до позицията 'Senior', което предполага, че кандидатът притежава високо ниво на умения, познания за технологии и инструменти. С това е свързана и висока степен на отговорност, свързана с безпроблемната работа на production. Но забравяме какво всъщност е DevOps. Първоначално това не е бил конкретен човек или департамент. Ако потърсите определения на термина, ще намерите много красиви и правилни съществителни, като методология, практики, културна философия, група концепции и така нататък.
Моята специализация е инженер по автоматизация на тестове (QA automation engineer), но смятам, че тя не трябва да бъде свързана само с написването на авто-тестове или разработването на архитектура на тестовия фреймуърк. През 2020 година знанията за инфраструктурата за автоматизация също са необходими. Това позволява нарастването на процеса на автоматизация самостоятелно, започвайки от стартиране на тестовете и завършвайки с предоставянето на резултатите на всички заинтересовани лица в съответствие с поставените цели. В резултат, уменията DevOps са задължителен фактор за изпълнението на тази работа. И всичко това е чудесно, но за съжаление съществува проблем (спойлер: тази статия се опитва да опрости този проблем). Той се състои в това, че DevOps е сложен. И това е очевидно, защото компаниите няма да платят много за нещо, което е лесно да се направи… В света на DevOps има много инструменти, термини, практики, които трябва да се овладеят. Особено това е трудно в началото на кариерата и зависи от натрупания технически опит.
Източник:
Тук вероятно ще завършим с въведението и ще се фокусираме върху целта на тази статия.
За какво е тази статия
В тази статия ще споделя опита си по изграждане на инфраструктура за автоматизация на тестове. В интернет можете да намерите много източници на информация за различни инструменти и как да ги използвате, но бих искал да разгледам тях изключително в контекста на автоматизацията. Сигурен съм, че много инженери по автоматизация познават ситуацията, в която разработените тестове, освен вас, никой не изпълнява и не се грижи за тяхната поддръжка. В резултат на това тестовете стават остарели и се налага да се губи време за тяхното актуализиране. Отново в началото на кариерата, това може да бъде доста сложна задача: правилно да се прецени кои инструменти могат да спомогнат за решаването на този проблем, как да бъдат избрани, конфигурирани и поддържани. Някои тестери се обръщат за помощ към DevOps (хората) и, да бъдем честни, такъв подход работи. В много случаи това може да бъде единственият вариант, тъй като нямаме видимост върху всички зависимости. Но, както знаем, DevOps са много заети хора, защото трябва да се грижат за инфраструктурата на цялата компания, разгръщане, мониторинг, микросервизи и други подобни задачи в зависимост от организацията/екипа. Както обикновено, автоматизацията не е приоритет. В такъв случай трябва да се опитаме да направим всичко възможно от наша страна от начало до край. Това ще намали зависимостите, ще ускори работния процес, ще усъвършенства уменията ни и ще ни позволи да видим по-широката картина на събитията.
В статията са представени най-използваните и популярни инструменти и как да ги използвате за стъпка по стъпка изграждане на инфраструктура за автоматизация. Всяка група е представена с инструменти, които са били проверени на личен опит. Но това не означава, че трябва да използвате същите. Самите инструменти не са важни, те се появяват и остаряват. Нашата инженеринговата задача е да разберем основните принципи: защо ни е нужна тази група инструменти и какви работни задачи можем да решим с тяхна помощ. Затова в края на всяка секция оставям връзки към подобни инструменти, които, може би, се използват във вашата организация.
Какво липсва в тази статия
Още веднъж повтарям, че статията не е за конкретни инструменти, така че тук няма да има кодови вставки от документацията и описания на конкретни команди. Но в края на всяка секция оставям линкове за подробно проучване.
Това е направено по причина, че:
- този материал е много лесно да се намери в различни източници (документация, книги, видео курсове);
- ако започнем да навлизаме в дълбочина, ще трябва да напишем 10, 20, 30 части от тази статия (тъй като в плановете са 2-3);
- просто не искам да губя времето ви, тъй като, възможно, вие искате да използвате други инструменти за постигане на същите цели.
Практика
Много бих искал този материал да бъде полезен за всеки читател, а не просто да бъде прочетен и забравен. В всяко изучаване практиката е много важна съставка. Затова подготвих. Освен това ви чака домашна работа, за да сте сигурни, че не сте копирали безразсъдно редовете на изпълняваните команди.
План
Стъпка
Технология
Инструменти
1
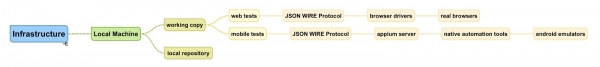
Локално стартиране (подготовка на уеб / андроид демонстрационни тестове и локално изпълнение)
Node.js, Selenium, Appium
2
Системи за контрол на версиите
Git
3
Контейнеризация
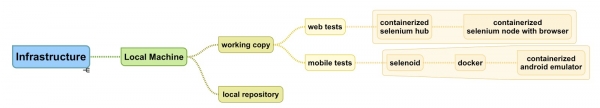
Docker, Selenium grid, Selenoid (Web, Android)
4
CI / CD
GitLab CI
5
Облачни платформи
Google Cloud Platform
6
Оркестрация
Kubernetes
7
Инфраструктура като код (IaC)
Terraform, Ansible
Структура на всяка секция
За поддържане на разказа в нагледен вид, всяка секция е описана по следния план:
- кратко описание на технологията,
- стойност за инфраструктурата на автоматизацията,
- илюстрация на текущото състояние на инфраструктурата,
- линкове за изучаване,
- аналогични инструменти.
1. Локално стартиране на тестове
Кратко описание на технологията
Това е просто подготвителна стъпка за стартиране на демонстрационните тестове локално и за проверка, че те се изпълняват успешно. В практическата част се използва Node.js, но езикът за програмиране и платформата също не са важни и можете да използвате тези, които се използват във вашата фирма.
Въпреки това, като инструменти за автоматизация, препоръчвам да използвате Selenium WebDriver за уеб платформи и Appium за Android платформата, тъй като на следващите стъпки ще използваме Docker образи, които са предназначени да работят конкретно с тези инструменти. Освен това, като се позовавам на изискванията в обявите за работа, тези инструменти са най-търсени на пазара.
Както може да сте забелязали, разглеждаме само уеб и Android тестове. За съжаление, IOS е съвсем различна история (благодарим на Apple). Планирам да демонстрирам решения и практики, свързани с IOS, в следващите части.
Стойност за инфраструктурата на автоматизацията
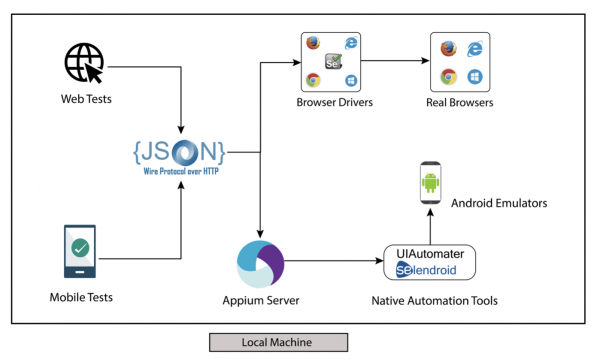
От гледна точка на инфраструктурата, локалният старт не носи никаква стойност. Просто проверявате, че тестовете работят на локалната машина в локални браузъри и симулатори. Но във всеки случай това е необходима отправна точка.
Илюстрация на настоящото състояние на инфраструктурата
Връзки за изучаване
Аналогични инструменти
- всеки език за програмиране, който предпочитате, в комбинация с Selenium/Appium — тестове;
- всички тестове;
- всякакъв тест-ранър.
2. Системи за контрол на версиите (Git)
Кратко описание на технологията
Няма да е изненада за никого, ако кажа, че системата за контрол на версиите е изключително важна част от разработката, както в екип, така и индивидуално. Базирайки се на разнообразни източници, можем с увереност да кажем, че Git е най-популярният представител. Системата за контрол на версиите предлага множество предимства, като споделяне на код, запазване на версии, възстановяване на предишни клонове, проследяване на историята на проекта, резервни копия. Няма да разглеждаме всяка точка в детайли, тъй като съм сигурен, че вие сте добре запознати с това и го използвате в ежедневната си работа. Но ако случайно не сте, препоръчвам да прекъснете четенето на тази статия и възможно най-скоро да попълните този пропуск.
Стойност за инфраструктурата на автоматизацията
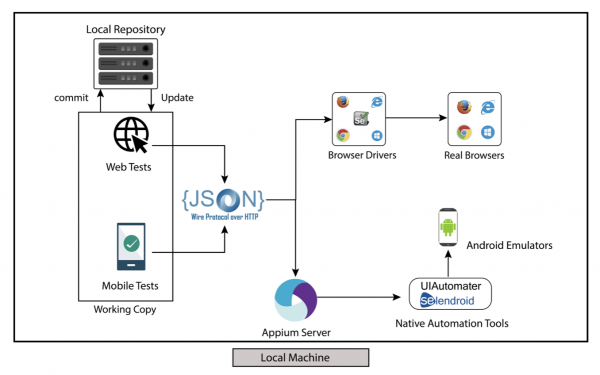
И тук можете да зададете основателния въпрос: «Защо ни говори за Git? Всички го знаят и използват както за разработка на код, така и за код на автоматизирани тестове». Ще бъдете напълно прави, но в тази статия говорим за инфраструктура и този раздел играе ролята на предварителен преглед за раздел 7: «Инфраструктура като код (IaC)». За нас това означава, че цялата инфраструктура, включително тестовата, се описва под формата на код, съответно можем да приложим системите за версииране и да получим преходни предимства, както за разработката на код, така и за автоматизацията.
Ние ще разгледаме IaC по-подробно на стъпка 7, но дори сега можете да започнете да използвате Git локално, като създадете локално хранилище. Общата картина ще бъде разширена, когато добавим отдалечено хранилище към инфраструктурата.
Илюстрация на настоящото състояние на инфраструктурата
Връзки за изучаване
Аналогични инструменти
3. Контейнеризация (Docker)
Кратко описание на технологията
За демонстрация на това как контейнеризацията промени правилата на играта, нека се пренесем назад в няколко десетилетия. В миналото хората купуваха и използваха сървърни машини, за да стартират приложения. Но в повечето случаи необходимите ресурси за стартиране не бяха известни предварително. В резултат на това компаниите харчеха пари за закупуване на скъпи мощни сървъри, но част от тези мощности не бяха напълно използвани.
Следващият етап от еволюцията бяха виртуалните машини (VM), които решиха проблема с разходите за неизползвани ресурси. Тази технология позволи да се стартират приложения независимо едно от друго в рамките на един сървър, като се отдели напълно изолирано пространство. Но, за съжаление, всяка технология има свои недостатъци. Стартирането на VM изисква пълноценна операционна система, която консумира CPU, RAM, хранилище и, в зависимост от ОС, трябва да се вземат предвид разходите за лиценз. Тези фактори влияят на скоростта на зареждане и усложняват преносимостта.
И ето, стигнахме до контейнеризацията. Отново тази технология реши предишния проблем, тъй като контейнерите не използват пълноценна ОС, което позволява да се освободят значителни количества ресурси и предлага бързо и гъвкаво решение за преносимост.
Разбира се, технологията на контейнери не е нещо ново и за първи път беше представена в края на 70-те години. Тогава се проведоха много изследвания, разработки и опити. Но именно Docker адаптира тази технология и я направи лесно достъпна за масите. В наши дни, когато говорим за контейнери, в повечето случаи имаме предвид Docker. Когато говорим за Docker контейнери, подразбираме Linux контейнери. Можем да използваме Windows и macOS системи за стартиране на контейнери, но е важно да разберем, че в този случай се появява допълнителен слой. Например, Docker на Mac незабелязано стартира контейнери в рамките на лека Linux VM. Ще се върнем на тази тема, когато обсъждаме стартирането на Android емулатори в контейнери, тъй като тук възниква много важен нюанс, който трябва да разгледаме по-подробно.
Стойност за инфраструктурата на автоматизацията
Установихме, че контейнеризацията и Docker са страхотни. Нека да разгледаме това в контекста на автоматизацията, тъй като всеки инструмент или технология трябва да решава някакъв проблем. Нека посочим очевидните проблеми на автоматизацията на тестовете в контекста на UI тестовете:
- огромно количество зависимости при инсталирането на Selenium и особено Appium;
- проблеми с съвместимостта между версиите на браузърите, симулаторите и драйверите;
- липса на изолирано пространство за браузъри/симулатори, което е особено критично за паралелното стартиране;
- трудно е да се управлява и поддържа, ако трябва да стартирате 10, 50, 100 или дори 1000 браузъри едновременно.
Но тъй като Selenium е най-популярният инструмент за автоматизация, а Docker – най-популярният инструмент за контейнеризация, не би трябвало да е изненада, че някой е опитал да ги обедини, за да получи мощен инструмент за решаване на споменатите по-горе проблеми. Нека да разгледаме тези решения по-подробно.
Selenium grid в docker
Този инструмент е най-популярният в света Selenium за стартиране на множество браузъри на различни машини и управление на тях от един централен възел. За стартиране е необходимо да се регистрират поне 2 части: Hub и Node(s). Hub е централният възел, който получава всички заявки от тестовете и ги разпределя на съответните Nodes. За всеки Node можем да настроим конкретна конфигурация, например, указвайки желания браузър и неговата версия. Въпреки това, все още трябва сами да се погрижим за съвместимите драйвери за браузърите и да ги инсталираме на нужните Nodes. По тази причина Selenium grid не се използва в чист вид, освен в случаите, когато трябва да работим с браузъри, които не могат да бъдат инсталирани на Linux OS. За всички останали случаи значително по-гъвкавото и правилно решение е използването на Docker образи за стартиране на Selenium grid Hub и Nodes. Този подход значително опростява управлението на възлите, тъй като можем да изберем необходимия образ с вече инсталирани съвместими версии на браузери и драйвери.
Въпреки негативните отзиви относно стабилността на работата, особено при стартиране на голям брой Nodes паралелно, Selenium grid все още остава най-популярният инструмент за паралелно стартиране на Selenium тестове. Важно е да се отбележи, че в open-source постоянно се появяват различни доработки и модификации на този инструмент, които се борят с различните тесни места.
Selenoid за Web
Този инструмент е пробив в света на Selenium, тъй като работи веднага след инсталиране и значително улеснява живота на много инженери по автоматизация. Първо, това не е просто поредната модификация на Selenium grid. Вместо това разработчиците са създали напълно нова версия на Selenium Hub на езика Golang, което в комбинация с леките Docker изображения за различни браузъри е дало тласък на развитието на автоматизацията на тестовете. Освен това, при Selenium Grid трябва да определим всички необходими браузъри и техните версии предварително, което не е проблем, когато работим само с един браузър. Но когато става въпрос за няколко поддържани браузъра, Selenoid е решение номер едно благодарение на функцията 'браузер при поискване'. Всичко, от което се нуждаем, е предварително да изтеглим нужните изображения с браузъри и да актуализираме конфигурационния файл, с който работи Selenoid. След като Selenoid получи заявка от тестовете, той автоматично ще стартира необходимия контейнер с нужния браузър. Когато тестът приключи, Selenoid ще спре контейнера, освобождавайки ресурси за следващите заявки. Такъв подход напълно елиминира известния проблем с 'деградацията на възлите', който често срещаме в Selenium grid.
Но, за съжаление, Selenoid все още не е сребърна куршум. Получихме функция 'браузер при поискване', но функцията 'ресурси при поискване' все още не е налична. За да използваме Selenoid, трябва да го разгърнем на физическо оборудване или на VM, което означава, че трябва предварително да знаем колко ресурси трябва да отделим. Смятам, че това не е проблем за малки проекти, които стартират 10, 20 или дори 30 браузъра едновременно. Но какво ще стане, ако ни трябват 100, 500, 1000 и повече? Няма смисъл да поддържаме и плащаме за толкова много ресурси постоянно. В секция 5 и 6 на тази статия ще обсъдим решения, които позволяват мащабиране, значително намалявайки разходите на компанията.
Selenoid за Android
След успеха на Selenoid като инструмент за уеб автоматизация, хората искаха нещо подобно за Android. И това се случи – Selenoid беше пуснат с поддръжка за Android. От високо ниво, принципът на работа е подобен на уеб автоматизацията. Единствената разлика е, че вместо контейнери с браузъри, Selenoid стартира контейнери с Android емулатори. На мой поглед, в момента това е най-мощният безплатен инструмент за стартиране на Android тестове паралелно.
Много не искам да говоря за негативните страни на този инструмент, тъй като наистина ми харесва. Но все пак тук съществуват същите недостатъци, свързани с уеб автоматизацията, свързани с мащабируемостта. Освен това трябва да спомена още едно ограничение, което може да бъде изненада, ако настройваме инструмента за първи път. За стартиране на Android образи ни е нужна физическа машина или VM с поддръжка на nested virtualization. В практическото ръководство ще демонстрирам как да го активирам в Linux VM. Въпреки това, ако сте потребител на macOS и искате да разположите Selenoid локално, то за стартиране на Android тестове това ще бъде невъзможно. Но винаги можете да стартирате Linux VM локално с настроена 'nested virtualization' и да разположите Selenoid вътре.
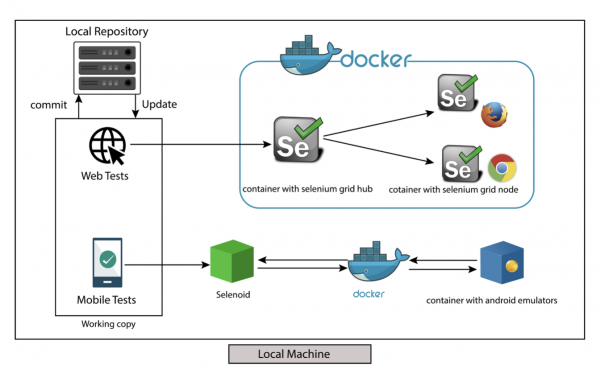
Илюстрация на настоящото състояние на инфраструктурата
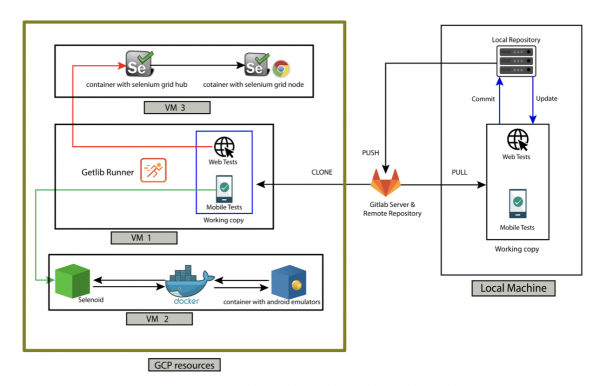
В контекста на тази статия ще добавим 2 инструмента за илюстрация на инфраструктурата. Това е Selenium grid за уеб тестове и Selenoid за Android тестове. В ръководството в GitHub също ще покажа как да използвате Selenoid за стартиране на уеб тестове.
Връзки за изучаване
Аналогични инструменти
- Съществуват и други инструменти за контейнеризация, но Docker е най-популярният. Ако искате да опитате нещо друго, имайте предвид, че инструментите, които разгледахме за паралелно стартиране на Selenium тестове, няма да работят от кутията.
- Както вече бе споменато, съществуват много модификации на Selenium grid, например,.
4. CI / CD
Кратко описание на технологията
Практиката на непрекъсната интеграция е доста популярна в разработката и стои наравно с системите за контрол на версиите. Въпреки това, чувствам, че съществува объркване в терминологията. В този параграф бих искал да опиша 3 модификации на тази технология от моя ъгъл. В интернет можете да намерите много статии с различни интерпретации и е абсолютно нормално, ако вашето мнение се различава. Най-важното е да бъдете на една и съща вълна с колегите си.
И така, има 3 термина: CI — Continuous Integration (непрекъсната интеграция), CD — Continuous Delivery (непрекъсната доставка) и отново CD — Continuous Deployment (непрекъснато разгръщане). (По-нататък ще използвам тези термини на английски език). Всяка модификация добавя няколко допълнителни стъпки към вашия разработен конвейер. Но думата continuous (непрекъсната) е най-важната. В този контекст имаме предвид нещо, което се случва от начало до край, без прекъсвания или ръчно вмешателство. Нека разгледаме CI & CD и CD в този контекст.
- Непрекъсната интеграция – е първата стъпка в еволюцията. След изпращане на нов код на сървъра, очакваме бърза обратна връзка, че с нашите промени всичко е наред. Обикновено CI включва стартиране на инструменти за статичен анализ на кода и модулни/вътрешни API тестове. Това позволява да получим информация за нашия код само няколко секунди/минути по-късно.
- Continuous Delivery е по-напредналата стъпка, на която стартираме интеграционни/UI тестове. Въпреки това на този етап не получаваме резултатите толкова бързо, колкото в случая с CI. Първо, тези типове тестове изискват повече време за преминаване. На второ място, преди стартиране трябва да разгръщаме нашите промени на test/staging среда. Освен това, ако говорим за мобилна разработка, се добавя допълнителен етап за създаване на сборка на нашето приложение.
- Непрекъснато разгръщане предполагава, че автоматично публикуваме (release) нашите промени в продукция, ако всички приемателни тестове са преминали в предишните етапи. В допълнение, след етапа release, можем да конфигурираме различни етапи, като стартиране на smoke тестове в продукция и събиране на интересуващи метрики. Continuous Deployment е възможен само при добро покритие с автоматизирани тестове. Ако се изискват ръчни намеси, включително тестиране, то това вече не Непрекъснато (непрекъснато). Тогава можем да говорим, че нашият конвейер отговаря само на практиката Continuous Delivery.
Стойност за инфраструктурата на автоматизацията
В този раздел трябва да уточня, че когато говорим за end-to-end UI тестове, това означава, че трябва да внедрим нашите промени и свързаните услуги в тестови среди. Continuous Integration — процесът не е приложим за тази задача и трябва да се погрижим за внедряване на поне практики Continuous Delivery. Continuous Deployment също има смисъл в контекста на UI тестовете, ако планираме да ги стартираме в продукция.
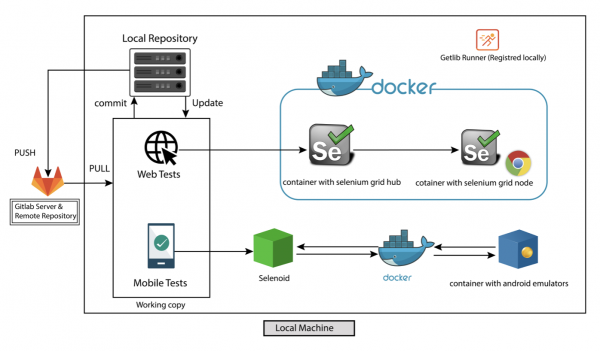
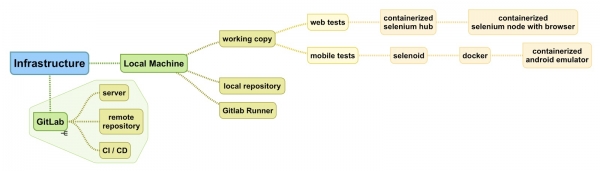
И преди да разгледаме илюстрация на измененията в архитектурата, искам да кажа няколко думи за GitLab CI. За разлика от други CI/CD инструменти, GitLab предоставя отдалечен репозиторий и много други допълнителни функции. Така GitLab е повече от CI. Той включва вградени управление на изходния код, Agile управление, CI/CD pipelines, инструменти за логване и събиране на метрики. Архитектурата на GitLab се състои от GitLab CI/CD и GitLab Runner. Показвам кратко описание от официалния сайт:
Gitlab CI/CD е уеб приложение с API, което съхранява своето състояние в база данни, управлява проекти/построявания и предоставя потребителски интерфейс. GitLab Runner е приложение, което обработва строежите. То може да бъде внедрено отделно и работи с GitLab CI/CD чрез API. За изпълнението на тестовете са ви необходими както инстанцията на Gitlab, така и Runner.
Илюстрация на настоящото състояние на инфраструктурата
Връзки за изучаване
Аналогични инструменти
- И много други
5. Облачни платформи
Кратко описание на технологията
В този раздел ще говорим за популярната тенденция, наречена 'публични облаци'. Въпреки огромната полза, която предлагат описаните по-горе технологии за виртуализация и контейнеризация, все още имаме нужда от компютърни ресурси. Компаниите купуват скъпи сървъри или наемат дата центрове, но в такъв случай е необходимо да се направят изчисления (понякога нереалистични) колко ресурси ще ни трябват, дали ще ги използваме 24/7 и за какви цели. Например, за продукция е необходим работещ 24/7 сървър, но нуждаем ли се от подобни ресурси за тестване по време на неработно време? Това също зависи от типа на извършваното тестване. Пример за това са натоварващи/стресови тестове, които планираме да проведем в неработно време, за да получим резултати на следващия ден. Но, определено, 24-часовата достъпност на сървъри не е необходима за end-to-end авто-тестове и особено за среди за ръчно тестване. За такива ситуации би било добре да получаваме толкова ресурси, колкото е необходимо при поискване, да ги използваме и да спираме да плащаме, когато не са повече нужни. Освен това, би било прекрасно да получаваме ресурсите моментално, с няколко клика на мишката или като пуснем няколко скрипта. За това се използват публичните облаци. Нека да разгледаме определението:
«Публичният облак се определя като компютърни услуги, предлагани от трети страни чрез публичния интернет, което ги прави достъпни за всеки, който иска да ги използва или закупи. Те могат да бъдат безплатни или продавани при поискване, позволявайки на клиентите да плащат само за използването на CPU цикли, съхранение или честотна лента, които консумират».
Счита се, че публичните облаци са скъпи. Но основната им идея е намаляване на разходите на компанията. Както бе споменато по-рано, публичните облаци позволяват получаване на ресурси при поискване и плащане само за времето на тяхното използване. Също така, понякога забравяме, че служителите получават заплати, а специалистите също са скъпоценен ресурс. Необходимо е да се има предвид, че публичните облаци значително улесняват поддръжката на инфраструктурата, което позволява на инженерите да се фокусират върху по-важни задачи.
Стойност за инфраструктурата на автоматизацията
Какви конкретно ресурси необходими за end-to-end UI тестовете? Основно това са виртуални машини или клъстери (ще говорим за Kubernetes в следващия раздел) за стартиране на браузъри и емулатори. Колкото повече браузъри и емулатори искаме да стартираме едновременно, толкова повече CPU и памет е необходима, и толкова повече средства ще трябва да платим за тях. Така че публичните облаци в контекста на автоматизацията на тестовете ни позволяват да стартираме голям брой (100, 200, 1000...) браузъри/емулатори при поискване, да получаваме резултатите от тестовете възможно най-бързо и да спираме плащането за такива изключително ресурсозатратни мощности.
Най-популярните облачни доставчици са Amazon Web Services (AWS), Microsoft Azure, Google Cloud Platform (GCP). В практическия наръчник са представени примери за използване на GCP, но в общи линии не е важно какво точно ще използвате за задачите по автоматизация. Всички те предоставят приблизително еднакъв функционал. Обикновено при избора на доставчик наръчникът се фокусира върху цялата инфраструктура на компанията и бизнес изискванията, което е извън обсега на тази статия. За инженерите по автоматизация ще бъде по-интерсно да сравнят използването на облачните доставчици с използването на облачни платформи по-конкретно за целите на тестовете, като Sauce Labs, BrowserStack, BitBar и т.н. Така че нека да направим това! Според мен, Sauce Labs е най-известната ферма за облачни тестове, затова я избрах за сравнение.
GCP срещу Sauce Labs за цели на автоматизация:
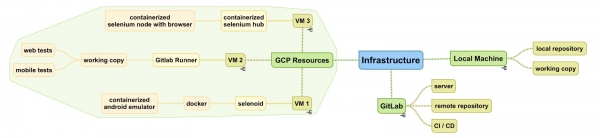
Представете си, че трябва да стартираме едновременно 8 уеб теста и 8 Android теста. За целта ще използваме GCP и ще стартираме 2 виртуални машини с Selenoid. На първата ще инсталираме 8 контейнера с браузъри. На втората – 8 контейнера с емулатори. Нека погледнем цените:
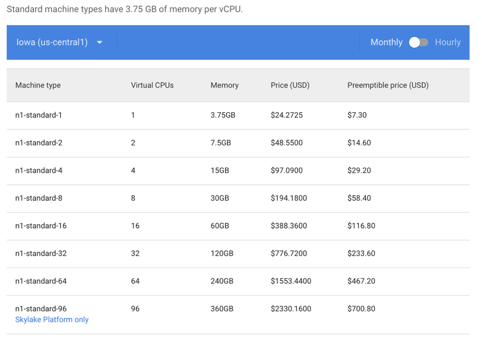
За стартиране на един контейнер с Chrome, е необходимо n1-standard-1 машина. При Android това ще бъде n1-standard-4 за един емулатор. Всъщност по-гъвкав и икономичен начин е задаването на конкретни потребителски стойности за CPU/Памет, но в момента за сравнение със Sauce Labs това не е от съществено значение.
А ето тарифите за използване на Sauce Labs:
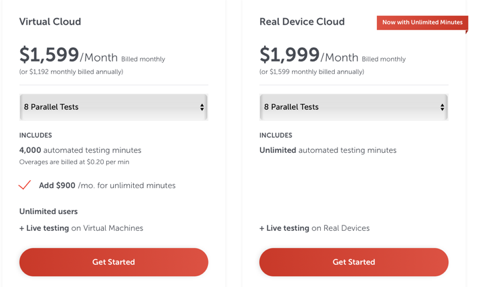
Предполагам, че вече сте забелязали разликата, но все пак ще предоставя таблица с изчисления за нашата задача:
Необходими ресурси
Месечно
Работни часове(8 ч. - 20 ч.)
Работни часове+ Предварително изчисление
GCP за уеб
n1-standard-1 x 8 = n1-standard-8
$194.18
23 дни * 12ч * 0.38 = 104.88$
23 дни * 12ч * 0.08 = 22.08$
Sauce Labs за уеб
Виртуален Cloud8 паралелни тестове
$1.559
—
—
GCP за Android
n1-standard-4 x 8: n1-standard-16
$776.72
23 дни * 12ч * 1.52 = 419.52$
23 дни * 12ч * 0.32 = 88.32$
Sauce Labs за Android
Cloud за реални устройства 8 паралелни тестове
$1.999
—
—
Както виждате, разликата в цената е колосална, особено ако стартирате тестове само в работния дванадесетчасов период. Но можете да намалите разходите дори повече, ако използвате preemptible машини. Какво представляват те?
Preemptible виртуалната машина е инстанция, която можете да създадете и стартирате на много по-ниска цена от нормалните инстанции. Въпреки това, Compute Engine може да прекрати (preempt) тези инстанции, ако трябва да получи достъп до тези ресурси за други задачи. Preemptible инстанциите са излишен капацитет на Compute Engine, така че тяхната наличност варира с употребата.
Ако вашите приложения са устойчиви на грешки и могат да понесат възможните прекъсвания на инстанции, тогава preemptible инстанциите могат значително да намалят разходите ви за Compute Engine. Например, партидни обработки могат да се извършват на preemptible инстанции. Ако някои от тези инстанции бъдат прекратени по време на обработката, работата забавя, но не спира напълно. Preemptible инстанциите завършват задачите за обработка на партиди без да поставят допълнителна натоварване върху вашите съществуващи инстанции и без да е необходимо да плащате пълна цена за допълнителни нормални инстанции.
И това все още не е всичко! Всъщност съм убеден, че никой не стартира тестове по 12 часа без прекъсване. И ако е така, можете автоматично да стартирате и спирате виртуалните машини, когато не са нужни. Реалното време на използване може да спадне до 6 часа на ден. Тогава разходите в контекста на нашата задача ще намалят до 11$ на месец за 8 браузъра. Не е ли прекрасно? Но с preemptible машините трябва да бъдем внимателни и готови за прекъсвания и нестабилна работа, макар че тези ситуации могат да бъдат предвидени и обработени програмистки. То определено си заслужава!
Но по никакъв начин не казвам ‘никога не използвайте облачни тестови ферми’. Те имат редица предимства. Първо, това не е просто виртуална машина, а цялостно решение за автоматизация на тестове с пакет от функционалности на разположение: отдалечен достъп, логове, скрийншоти, видеозаписи, различни браузъри и физически мобилни устройства. В много ситуации това може да бъде незаменима шикозна алтернатива. Особено тестовите платформи са полезни за автоматизация на IOS, когато публичните облаци предлагат само Linux/Windows системи. Но разговорът за IOS ще бъде в следващите статии. Препоръчвам винаги да гледате към ситуацията и да се ръководите от задачите: в някои е по-евтино и ефективно да се използват публични облаци, а в други тестовите платформи определено си заслужават вложените средства.
Илюстрация на настоящото състояние на инфраструктурата
Връзки за изучаване
Сходни инструменти:
6. Оркестрация
Кратко описание на технологията
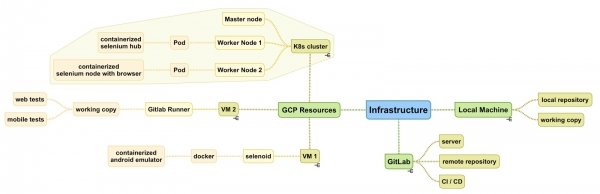
Имам добри новини – почти сме достигнали края на статията! В момента нашата автоматизационна инфраструктура се състои от уеб и Android тестове, които стартираме паралелно чрез GitLab CI, използвайки инструменти с поддръжка на Docker: Selenium grid и Selenoid. Освен това, използваме виртуални машини, създадени чрез GCP, за стартиране на контейнери с браузъри и емулатори. За да намалим разходите, стартираме тези виртуални машини само при необходимост и ги спираме, когато не се провеждат тестове. Има ли нещо друго, което може да подобри нашата инфраструктура? Отговорът е – да! Представяме Kubernetes (K8s)!
Първо, нека разгледаме как думите оркестрация, клъстер и Kubernetes са свързани помежду си. На високо ниво, оркестрацията е система, която разгръща и управлява приложения. За автоматизация на тестовете, контейнеризируемите приложения са Selenium grid и Selenoid. Docker и K8s се допълват взаимно. Първият се използва за разгръщане на приложения, вторият – за оркестрация. От своя страна, K8s е клъстер. Задачата на клъстера е да използва VMs като Nodes, което позволява инсталирането на различен функционал, програми и услуги в рамките на един сървър (клъстер). Ако някой от Node падне, другите Nodes поемат функциите, което осигурява безпрепятствена работа на нашето приложение. В допълнение, K8s има важна функционалност, свързана с мащабируемост (scaling), благодарение на която автоматично получаваме оптимално количество ресурси на база натоварване и зададени ограничения.
Честно казано, ръчно разгръщане на Kubernetes от нулата е доста сложна задача. Ще оставя линк към известното практическо ръководство „Kubernetes The Hard Way“, и ако ви интересува, можете да практикувате. Но за щастие, съществуват алтернативни методи и инструменти. Най-лесният от тях е да използвате Google Kubernetes Engine (GKE) в GCP, което ще ви позволи да получите готов клъстер след няколко клика. За начало на изучаването препоръчвам да използвате точно този подход, тъй като той ще ви позволи да се фокусирате върху изучаването на това как да използвате K8s за вашите задачи, вместо да изследвате как вътрешните компоненти трябва да бъдат интегрирани помежду си.
Стойност за инфраструктурата на автоматизацията
Нека разгледаме няколко значими функции, които предлага K8s:
- разгръщане на приложение: използване на multi-nodes клъстер вместо виртуални машини;
- динамично мащабиране: намалява разходите за ресурси, които се използват само при нужда;
- самовъзстановяване (Self-healing): автоматично възстановяване на pods (в резултат на което се възстановяват и контейнерите);
- изпълнение на актуализации и откат на промени без престой: актуализирането на инструменти, браузъри и емулатори не прекъсва работата на текущите потребители.
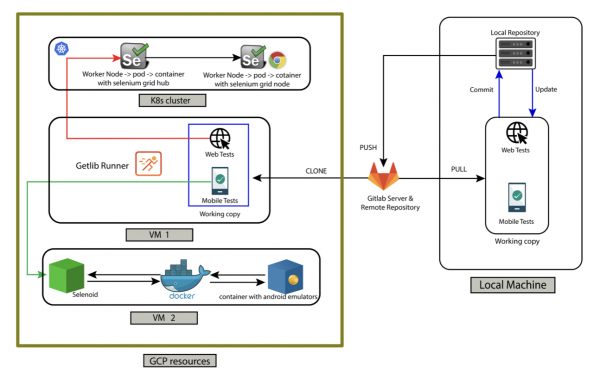
Но K8s все пак не е сребърно куршумче. За да разберем всички предимства и ограничения в контекста на разглежданите от нас инструменти (Selenium grid, Selenoid), накратко ще обсъдим структурата на K8s. Клъстерът съдържа два типа Nodes: Master Nodes и Workers Nodes. Master Nodes отговарят за управление, разгръщане и решения относно разпределението. Workers Nodes са местата, където приложенията са стартирани. Nodes също съдържат среда за стартиране на контейнери. В нашия случай това е Docker, който отговаря за операции, свързани с контейнери. Но съществуват и алтернативни решения, например. Важно е да разберете, че мащабирането или самовъзстановяването не се отнася директно до контейнерите. Това се реализира чрез добавяне/намаляване на броя на pods, които от своя страна съдържат контейнери (обикновено един контейнер на pod, но в зависимост от задачата може да бъде и повече). Високото ниво на йерархия представя worker nodes, в които се намират pods, вътре в които се стартират контейнерите.
Функцията за мащабиране е ключова и може да бъде приложена както към nodes в node-pool на клъстера, така и към pods в node. Има 2 типа мащабиране, които принадлежат към nodes и pods. Първият тип – хоризонтален – мащабирането се извършва чрез увеличаване на броя на nodes/pods. Този тип е по-предпочитан. Вторият тип, съответно, вертикален. Мащабирането се осъществява чрез увеличаване на размерите на nodes/pods, а не на тяхното количество.
Сега нека разгледаме нашите инструменти в контекста на по-горе споменатите термини.
Selenium grid
Както беше споменато по-рано, Selenium grid е много популярен инструмент и не е изненада, че е контейнеризиран. Следователно, не е учудващо, че Selenium grid може да бъде внедрена в K8s. Пример за това как да го направите можете да намерите в официалния репозиторий на K8s. Както обикновено, прилагам линкове в края на секцията. В допълнение, в практическото ръководство е показано как да направите това чрез Terraform. Има и инструкция как да се мащабира броят на pods, които съдържат контейнери с браузъри. Но функцията за автоматично мащабиране в контекста на K8s все още не е напълно очевидна задача. Когато започнах да уча, не намерих никакво практическо ръководство или препоръки. След няколко проучвания и експерименти, с подкрепата на DevOps екипа, ние избрахме подхода да стартираме контейнери с необходимите браузъри в един pod, който се намира в един worker node. Този подход ни позволява да приложим стратегия за хоризонтално мащабиране на nodes чрез увеличаване на техния брой. Надявам се, че в бъдеще ситуацията ще се промени и ще видим все повече и повече описания на най-добрите подходи и готови решения, особено след пускането на Selenium grid 4 с променена вътрешна архитектура.
Selenoid:
В момента внедряването на Selenoid в K8s е най-голямото разочарование. Те не са съвместими. Теоретично можем да стартираме Selenoid-контейнер в pod, но когато Selenoid започне да стартира контейнери с браузъри, те все още ще бъдат в същия pod. Това прави мащабирането невъзможно и, като резултат, работата на Selenoid в клъстера няма да се различава от работата в рамките на виртуална машина. Край на историята.
Moon:
Зная това тясно място при работа с Selenoid, разработчиците пуснаха по-мощен инструмент, който нарекоха Moon. Този инструмент първоначално беше замислен за работа с Kubernetes и, като резултат, може и трябва да се използва функция за автоматично мащабиране. Освен това, бих казал, че в настоящия момент това единственият инструмент в света на Selenium, който от кутията има native K8s cluster-поддръжка (вече не, виж следващия инструмент ). Ключовата характеристика на Moon, която осигурява тази поддръжка, е:
Напълно бездържавен. Selenoid съхранява в паметта информация за текущо работещите браузър сесии. Ако по някаква причина процесът му падне — всички работещи сесии се губят. Moon от своя страна няма вътрешно състояние и може да бъде репликиран в различни центрове за данни. Браузър сесиите остават активни дори ако едно или повече реплики се сринат.
И така, Moon е страхотно решение, но с един проблем, той не е безплатен. Цената зависи от броя сесии. Безплатно можете да стартирате само 0-4 сесии, което не е особено полезно. Но, започвайки от петата сесия, ще трябва да платите по 5$ за всяка. Ситуацията може да варира от компания до компания, но в нашия случай използването на Moon е безсмислено. Както описах по-горе, можем да пускаме VMs със Selenium Grid по желание или да увеличим броя Nodes в клъстера. Приблизително на един pipeline стартираме 500 браузъра и спираме всички ресурси след приключване на тестовете. Ако използвахме Moon, щяхме да платим допълнителни 500 x 5 = 2500 $ на месец, независимо колко често стартираме тестовете. И отново, не казвам „не използвайте Moon“. За вашите нужди тя може да бъде незаменимо решение, например, ако във вашата организация има много проекти/екипи и ви трябва огромен общ клъстер за всички. Както винаги, оставям линк в края и препоръчвам да направите всички необходими изчисления в контекста на вашата задача.
Callisto: (Внимание! Това не е в оригиналната статия и е съдържа само в българския превод)
Както каза, Selenium е много популярен инструмент, а ИТ сферата се развива много бързо. Докато работех по превода, в мрежата се появи нов, обещаващ инструмент Callisto (здравей, Cypress и други убийци на Selenium). Той работи нативно с K8s и позволява стартиране на Selenoid контейнери в pods, разпределени по Nodes. Всичко работи веднага от кутията, включително автоматично мащабиране. Фантастика, но трябва да се тестват. Успях да разположа този инструмент и да направя няколко експеримента. Но е рано да се изводят заключения, след получаване на резултатите на дълга дистанция, възможно е да направя преглед в следващите статии. Засега оставям само линкове за самостоятелно изследване.
Илюстрация на настоящото състояние на инфраструктурата
Връзки за изучаване
Връзки за изучаване
Аналогични инструменти
7. Инфраструктура като код (IaC)
Кратко описание на технологията
И ето, стигнахме до последната част. Обикновено тази технология и свързаните с нея задачи не попадат в обхвата на отговорностите на инженерите по автоматизация. И за това има свои причини. Първо, в много организации инфраструктурните въпроси са под контрола на отдела DevOps и екипите за разработка не се грижат особено за това, благодарение на което работи pipeline и как трябва да се поддържа всичко, свързано с него. На второ място, да бъдем честни, практиката "Инфраструктура като код (IaC)" все още не се прилага в много компании. Но определено това стана популярен тренд и е важно да се стремим да бъдем ангажирани в свързаните с това процеси, подходи и инструменти. Или поне да бъдем в течение на събитията.
Нека започнем с мотивацията за използването на този подход. Вече обсъдихме, че за стартиране на тестове в GitlabCI са ни необходими поне ресурси за стартиране на Gitlab Runner. А за стартиране на контейнери с браузъри/емулатори трябва да резервираме VM или кластер. Освен ресурсите за тестване, имаме нужда от значително количество капацитети за поддържане на среда за разработка, staging, production, което също включва бази данни, автоматични графици, конфигурации на мрежата, балансиращи товари, права на потребителите и т.н. Ключовият проблем се състои в необходимите усилия за поддръжка на всичко това. Има няколко начина, по които можем да внесем промени и да внедрим актуализации. Например, в контекста на GCP можем да използваме UI консолата в браузъра и да извършваме всички действия, кликвайки по бутони. Алтернативен метод може да бъде използването на API повиквания за взаимодействие с облачните единици или използването на комадна утилита gcloud за изпълнение на необходимите манипулации. Но при действително голямо количество различни единици и инфраструктурни елементи става трудно или дори невъзможно да се изпълняват всички операции ръчно. Освен това, всички тези ръчни действия не са контролируеми. Не можем да ги изпратим за преглед преди изпълнението, да използваме система за контрол на версиите и бързо да отменим промените, които са довели до инцидент. За решаване на такива проблеми, инженерите създавали и създават автоматични bash/shell скриптове, което не е много по-добро от предишните методи, тъй като не са толкова лесни за бързо прочитане, разбиране, поддържане и модифициране в процедурен стил.
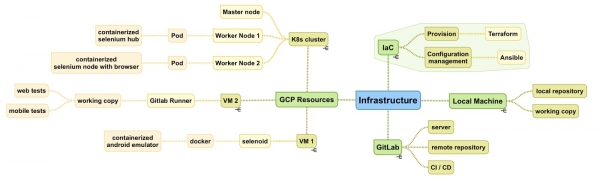
В тази статия и практическото ръководство използвам 2 инструмента, свързани с практиката IaC. Те са Terraform и Ansible. Някои смятат, че няма смисъл да ги използваме едновременно, тъй като функционалността им е сходна и те си взаимозаменяеми. Но става въпрос за това, че първоначално пред тях са поставени напълно различни задачи. Фактът, че тези инструменти трябва да се допълват, беше потвърден по време на съвместна презентация от разработчици, представляващи компаниите HashiCorp и RedHat. Концептуалната разлика е, че Terraform е инструмент за provisioning на управляващите сървъри. Докато Ansible е инструмент за управление на конфигурации с задача инсталиране, настройка и управление на софтуер на тези сървъри.
Още една ключова отличителна черта на тези инструменти е стилът на кодиране. За разлика от bash и Ansible, Terraform използва декларативен стил, основан на описание на желаното крайно състояние, което трябва да бъде постигнато след изпълнението. Например, ако планираме да създадем 10 VMs и приложим промените чрез Terraform, ще получим 10 VMs. Ако приложим скрипта отново, нищо няма да се случи, тъй като вече имаме 10 VMs и Terraform знае за това, тъй като съхранява текущото състояние на инфраструктурата в state файла. А Ansible използва процедурен подход и, ако го помолим да създаде 10 VMs, на първото стартиране ще получим 10 VMs, подобно на Terraform. Но след повторно стартиране ще имаме 20 VMs. В това е важната разлика. При процедурния стил не съхраняваме текущото състояние и просто описваме последователността на стъпките, които трябва да бъдат изпълнени. Разбира се, можем да обработим различни ситуации, да добавим няколко проверки за съществуването на ресурси и текущото състояние, но няма смисъл да губим времето си и да полагаме усилия за контролиране на тази логика. Освен това, това увеличава риска от грешки.
Обобщавайки всичко казано до тук, можем да заключим, че за provisioning на сървъри по-подходящ инструмент е Terraform и декларативната нотация. А работата по управление на конфигурации е по-добре да бъде делегирана на Ansible. Разбирайки това, нека видим примери за използване в контекста на автоматизация.
Стойност за инфраструктурата на автоматизацията
Тук е важно да се разбере, че инфратыркът за автоматизация на тестовете трябва да се разглежда като част от цялостната инфраструктура на компанията. А това означава, че всички IaC практики трябва да се прилагат глобално към ресурсите на цялата организация. Кой е отговорен за това зависи от вашите процеси. ДевОпс екипът е по-опитен в тези въпроси, те виждат цялата картинка. Въпреки това QA инженерите са по-силно ангажирани в процеса на изграждане на автоматизация и структурата на конвейера, което им позволява по-добре да виждат всички необходими промени и възможности за подобрение. Най-добрият вариант е да работят заедно, да обменят знания и идеи за постигане на очаквания резултат.
Ще дам няколко примера за използване на Terraform и Ansible в контекста на автоматизация на тестовете и инструментите, които обсъждахме до момента:
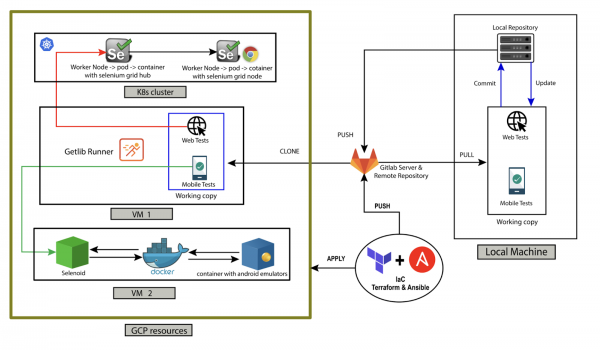
1. Да опишем чрез Terraform необходимите характеристики и параметри на VMs и клъстери.
2. Да инсталираме с помощта на Ansible необходимите за тестуване инструменти: docker, Selenoid, Selenium Grid и да заредим нужните версии на браузъри/емулатори.
3. Да опишем чрез Terraform характеристиките на VM, в която ще бъде стартиран GitLab Runner.
4. Да инсталираме с помощта на Ansible GitLab Runner и необходимите съпътстващи инструменти, да зададем настройки и конфигурации.
Илюстрация на настоящото състояние на инфраструктурата
Линкове за изучаване:
Аналогични инструменти
Нека обобщим!
Стъпка
Технология
Инструменти
Стойност за инфраструктурата на автоматизацията
1
Локално изпълнение
Node.js, Selenium, Appium
- Най-популярните инструменти за уеб и мобилни приложения
- Поддръжка на много езици и платформи (включително Node.js)
2
Системи за контрол на версиите
Git
- Аналогични предимства с разработвания код
3
Контейнеризация
Docker, Selenium grid, Selenoid (Web, Android)
- Паралелно изпълнение на тестове
- Изолирани среди
- Лесно, гъвкаво актуализиране на версиите
- Динамично спиране на неизползваните ресурси
- Лесно за настройка
4
CI / CD
GitLab CI
- Тестовете част от конвейера
- Бърза обратна връзка
- Видимост за цялата компания/екип
5
Облачни платформи
Google Cloud Platform
- Ресурси при поискване (плащаме само когато са нужни)
- Лесно управление и актуализиране
- Видимост и контрол на всички ресурси
6
Оркестрация
Kubernetes
В контекста на контейнери с браузъри/емулатори вътре в pods:
- Мащабиране/автомасштабиране
- Самовъзстановяване
- Актуализации и връщания без прекъсвания
7
Инфраструктура като код (IaC)
Terraform, Ansible
- Аналогични предимства с инфраструктурата за разработка
- Всички предимства на версионирането на кода
- Лесно извършване на промени и поддръжка
- Напълно автоматизирано
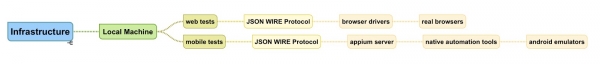
Диаграми на умствената карта: еволюция на инфраструктурата
стъпка1: Локално
стъпка2: VCS
стъпка3: Контейнеризация
стъпка4: CI/CD
стъпка5: Облачни платформи
стъпка6: Оркестрация
стъпка7: IaC
Какво следва?
И така, това е краят на статията. Но накрая бих искал да установя някои уговорки с вас.
От ваша страна
Както беше споменато в началото, бих искал статията да бъде от практическа полза и да ви помогне да приложите придобитите знания в реалната работа. Отново добавям.
Но дори и след това не спирайте, практикувайте, изучавайте съответните връзки и книги, научете как функционира всичко във вашата компания, намерете места, които могат да се подобрят, и участвайте в това. Успех!
От моя страна
От заглавието се вижда, че това беше само първата част. Въпреки че стана доста дълга, тук все още не са разгледани важни теми. Във втората част планирам да разгледам инфраструктурата за автоматизация в контекста на IOS. Поради ограниченията на Apple, свързани с пускането на симулатори на IOS само на системи с macOS, нашият набор от решения е стеснен. Например, сме лишени от възможността да използваме Docker за стартиране на симулатор или публични облаци за стартиране на виртуални машини. Но това не означава, че нямаме други алтернативи. Ще се постарая да ви държа в течение на новаторските решения и съвременните инструменти!
Също така не споменах доста големи теми, свързани с мониторинга. В част 3 планирам да разгледам най-популярните инструменти за мониторинг на инфраструктурата, както и какви данни и метрики следва да вземем предвид.
И накрая. В бъдеще планирам да издам видео курс по изграждане на тестова инфраструктура и популярни инструменти. В момента в интернет има доста курсове и лекции по DevOps, но всичките материали са представени в контекста на разработка, а не на автоматизация на тестовете. В този въпрос много ми трябва обратна връзка дали такъв курс би бил интересен и ценен за общността на тестерите и автоматизаторите. Благодаря предварително!
Източник: habr.com
