

Здравейте на всички! Аз съм Олег Сидоренков, работя в компанията ДомКлик като ръководител на екипа по инфраструктура. Използваме „Кубик“ в продукцията вече повече от три години и през това време сме преминали през много интересни моменти. Днес ще ви разкажа как с правилен подход можете да извлечете още повече производителност от „ваниловия“ Kubernetes за вашия клъстер. Готови, поставени, напред!
Всички вие отлично знаете, че Kubernetes е масштабируема система с отворен код за оркестрация на контейнери; или иначе казано, 5 бинара, които правят магия, управлявайки жизнения цикъл на вашите микросервизи в сървърна среда. Освен това, това е доста гъвкав инструмент, който можете да сглобявате като Lego конструктор, за максимално персонализиране според различни задачи.
И сякаш всичко е наред: пускайте сървърите в клъстера като дърва в печката и не се тревожете. Но ако сте загрижени за екологията, ще се замислите: „Как мога да поддържам огъня в печката, без да вредя на гората?“. С други думи, как да намерите начини за подобряване на инфраструктурата и намаляване на разходите.
1. Следете ресурсите на екипите и приложенията
Един от най-простите, но ефективни методи е въвеждането на requests/limits. Разделяйте приложенията по namespace-ове, а namespace-овете по екипи за разработка. Задавайте на приложението преди разполагането стойности за потреблението на CPU, памет и временна памет.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
По опитен път стигнахме до извода, че не трябва да раздувате requests спрямо limits повече от два пъти. Обемът на клъстера се изчислява въз основа на requests, а ако зададете на приложенията разлика в ресурсите, например, 5-10 пъти, представете си какво ще стане с вашия възел, когато той се запълни с поди и веднага получи натоварване. Нищо добро. Най-малкото, тротлинг, а в най-лошия случай, ще се сбогувате с работника и ще получите циклично натоварване на останалите възли, след като подите започнат да се преместват.
Освен това, с помощта на limitranges можете в началото да зададете стойности за ресурсите на контейнера — минимални, максимални и по подразбиране:
➜  ~ kubectl describe limitranges --namespace ops
Name:       limit-range
Namespace:  ops
Type        Resource           Min   Max   Default Request  Default Limit  Max Limit/Request Ratio
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
Не забравяйте да ограничите ресурсите на неймспейса, за да предотвратите едновременното изразходване на всички ресурси на кластера от един екип:
➜  ~ kubectl describe resourcequotas --namespace ops
Name:                   resource-quota
Namespace:              ops
Resource                Used          Hard
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Както се вижда от описанието resourcequotas, ако екипът ops се опита да разположи подове, които ще изразходват още 10 cpu, планировчикът няма да позволи това и ще върне грешка:
Error creating: pods "nginx-proxy-9967d8d78-nh4fs" is forbidden: exceeded quota: resource-quota, requested: limits.cpu=5,requests.cpu=5, used: limits.cpu=77250m,requests.cpu=53850m, limited: limits.cpu=10,requests.cpu=10За решаване на подобни ситуации може да се напише инструмент, например, който , способен да съхранява и комитва състоянието на ресурсите на екипите.
2. Избирайте оптимално файлово хранилище
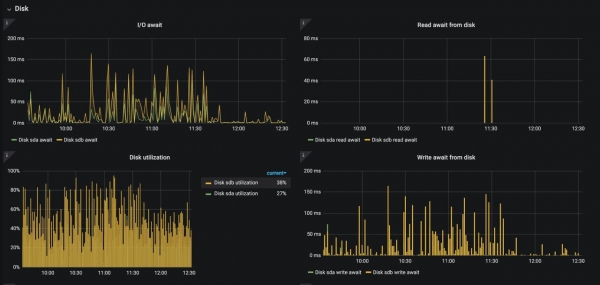
Тук бих искал да засегна темата на персистентните томове и дисковата подсистема на worker-нод Кubernetes. Надявам се никой да не използва "Куб" на HDD в продукция, но понякога и обикновен SSD вече не е достатъчен. Сблъсквали сме се с проблема, че журналите натоварват диска по операциите на вход-изход, и вариантите за решение не са много:
Използвайте високо производителни SSD или преминете на NVMe (ако сами управлявате хардуера си).
Намалете нивото на журнализиране.
Правете "умна" балансировка на подовете, които натоварват диска (
podAntiAffinity).
Скриншотът по-горе показва какво се случва с диска под nginx-ingress-controller, когато е включено журнализирането на access_logs (~12 хиляди журнала/сек.). Такова състояние, разбира се, може да доведе до деградация на всички приложения на тази нода.
Що се отнася до PV, за съжаление не съм изпробвал всички Постоянни томове. Използвайте най-добрия вариант, който подхожда на вас. Исторически имаме една малка част от услугите, които се нуждаят от RWX томове, и отдавна за тази задача използваме NFS хранилище. Евтино и... достатъчно. Разбира се, натрупахме доста опит — бъдете готови, но научихме как да го настройваме и вече нямаме главоболие. А ако е възможно, преминете към обектно хранилище S3.
3. Събирайте оптимизирани образи
Най-добре е да използвате оптимизирани за контейнери образи, така че Kubernetes да може да ги извлича по-бързо и да ги изпълнява по-ефективно.
Оптимизацията означава, че образите:
съдържат само едно приложение или изпълняват само една функция;
са малки по размер, защото големите образи преминават по-зле през мрежата;
имат крайни точки за проверка на състоянието и готовността, с помощта на които Kubernetes може да предприема действия в случай на прекъсвания;
използват операционни системи, дружелюбни към контейнери (като Alpine или CoreOS), които са по-устойчиви на конфигурационни грешки;
използват многоетапни сборки, така че да можете да разгръщате само компилирани приложения, а не съпътстващи изходни кодове.
Има много инструменти и услуги, които позволяват да проверите и оптимизирате образите на място. Важно е винаги да ги поддържате актуални и проверени за безопасност. В крайна сметка получавате:
Намаляване на мрежовото натоварване за целия кластер.
Намаляване на времето за стартиране на контейнера.
По-малък обем на вашия Docker registry.
4. Използвайте DNS кеш
Ако говорим за високи натоварвания, то без настройване на DNS системата на кластера животът е доста труден. Отдавна разработчиците на Kubernetes поддържаха своето решение kube-dns. То беше внедрено и при нас, но този софтуер не беше специално настроен и не предоставяше необходимата производителност, макар и задачата да изглежда проста. След това се появи coredns, на който преминахме и бяхме доволни, а след време то стана DNS услуга по подразбиране в K8s. В един момент достигнахме 40 000 rps към DNS системата и и това решение също стана недостатъчно. Но, за щастие, излезе Nodelocaldns, той също е node local cache, той също е .
Защо го използваме? Ядрото на Linux има бъг, който при множество заявки през conntrack NAT по UDP води до състезателно състояние за запис в conntrack таблиците и част от трафика през NAT се губи (всяка заявка през Service е NAT). Nodelocaldns решава този проблем, като се избавя от NAT и ъпгрейдва връзката до TCP към upstream DNS, както и локалното кеширане на DNS заявки към upstream (включително кратък 5-секунден негативен кеш).
5. Масштабирайте подовете автоматично хоризонтално и вертикално
Можете ли уверено да кажете, че всички ваши микросервизи са готови за двукратен до тройно увеличение на натоварването? Как правилно да разпределяте ресурсите на приложенията си? Дръжте активни няколко пода над работното натоварване може да се окаже излишно, а да се държите на ръба – рискувате да получите простои от внезапен ръст на трафика към услугата. Златната среда помагат да се постигне магията на умножението с такива услуги като и .
VPA позволява автоматично повишаване на requests/limits на контейнерите ви в пода в зависимост от фактическото използване. Как може да е полезен? Ако имате подове, които по някаква причина не могат да се скалират хоризонтално (което не е съвсем надеждно), можете да опитате да доверите изменението на ресурсите на VPA. Неговата функция се състои в система за препоръки, основана на исторически и текущи данни от metric-server, така че ако не искате автоматично да променяте requests/limits, можете просто да проследявате препоръчаните ресурси за вашите контейнери и да оптимизирате настройките за спестяване на CPU и памет в клъстера.
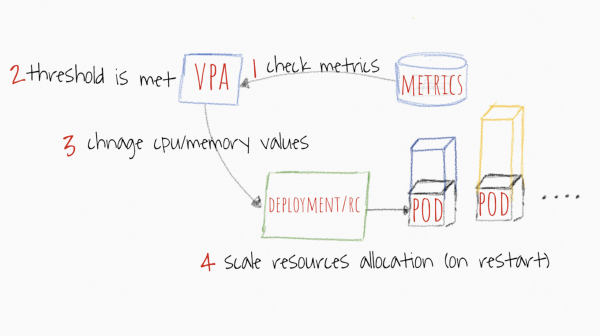 Изображението е взето от https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Планирайте в Kubernetes винаги се основава на requests. Каквото и да са стойностите, които зададете, планировчикът ще търси подходящ нод, базирайки се на тях. Стойностите limits са нужни на kubelet, за да разбере кога да тротлира или убива под. И тъй като единственият важен параметър е стойността requests, VPA ще работи с него. Всякога, когато задавате вертикално мащабиране на приложението, вие определяте какви трябва да бъдат requests. А какво ще стане с limits? Този параметър ще бъде пропорционално увеличен.
Например, ето обичайните настройки на пода:
ресурси:
   заявки:
     памет: 250Mi
     CPU: 200m
   лимити:
     памет: 500Mi
     CPU: 350m
Механизмът за препоръки определя, че на вашето приложение са му необходими 300m CPU и 500Mi, за да работи нормално. Ще получите следните настройки:
ресурси:
   заявки:
     памет: 500Mi
     CPU: 300m
   лимити:
     памет: 1000Mi
     CPU: 525m
Както беше споменато по-горе, това е пропорционално мащабиране на основата на съотношението заявки/лимити в манифеста:
CPU: 200m → 300m: съотношение 1:1.75;
Памет: 250Mi → 500Mi: съотношение 1:2.
Що се отнася до HPA, тук механизмът на работа е по-прозрачен. Задават се прагови стойности на метриките, например, на процесора и паметта, и ако средното значение на всички реплики надвиши прага, приложението се мащабира с +1 под, докато стойността не спадне под прага, или докато не бъде достигнат максималният брой реплики.
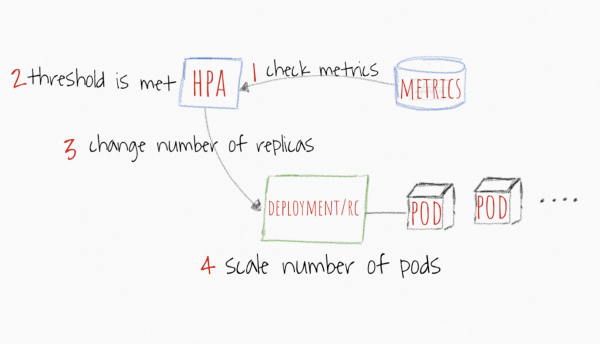 Изображението е взето от https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Освен стандартните метрики като процесора и паметта, можете да настроите прагове на вашите кастомни метрики от Prometheus и да работите с тях, ако считате, че това е най-точното определение, когато трябва да мащабирате вашето приложение. След като приложението се стабилизира под зададената граница на метриката, HPA ще започне да мащабира подовете надолу до минималния брой реплики или до състояние, в което натоварването ще отговаря на зададения праг.
6. Не забравяйте за Node Affinity и Pod Affinity
Не всички възли работят на еднакво оборудване, не на всички подове им е необходимо да изпълняват приложения, изискващи интензивни изчисления. Kubernetes позволява задаването на специализация на нодовете и подовете с помощта на Node Affinity и Pod Affinity.
Ако имате ноди, подходящи за операции с интензивни изчисления, за максимална ефективност е по-добре да свържете приложенията с съответните ноди. За целта използвайте nodeSelector с етикета на възела.
Да предположим, че имате две ноди: една с CPUType=HIGHFREQ и голямо количество бързи ядра, и друга с MemoryType=HIGHMEMORY голямо количество памет и по-висока производителност. Най-лесният начин да зададете разгръщането на пода на нода HIGHFREQ, добавяйки в раздела spec такъв селектор:
…
nodeSelector:
	CPUType: HIGHFREQ
По-скъп и специфичен начин да направите това е да използвате nodeAffinity в полето affinity раздела spec. Има два варианта:
requiredDuringSchedulingIgnoredDuringExecution: строга настройка (планировачът ще разгръща подовете само на конкретни ноди (и никъде другаде));preferredDuringSchedulingIgnoredDuringExecution: мека конфигурация (планиращият ще опита да разполага на конкретни възли, а ако не успее, ще се опита да разположи на следващия наличен възел).
Можете да зададете определен синтаксис за управление на етикетите на възлите, например, В, НеВ, Съществува, НеСъществува, По-Голямо или По-Малко. Въпреки това, имайте предвид, че сложните методи в дълги списъци с етикети ще забавят вземането на решения в критични ситуации. С други думи, не усложнявайте.
Както беше споменато по-горе, Kubernetes позволява да зададете свързване на текущите подове. Тоест, можете да направите така, че определени подове да работят заедно с други подове в същата зона на достъпност (актуално за облаци) или възли.
В podAffinity полета affinity раздела spec налични са същите полета, както в случая с nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution и preferredDuringSchedulingIgnoredDuringExecution. Единствената разлика е, че matchExpressions свързва подовете с възел, на който вече се изпълнява под с такъв етикет.
Също така Kubernetes предлага поле podAntiAffinity, което, от друга страна, не свързва пода с възел с определени подове.
По отношение на изразите nodeAffinity можете да дадете същия съвет: стремете се да запазите простота и логика в правилата, не се опитвайте да натоварите спецификацията на подовете със сложен набор от правила. Много лесно е да създадете правило, което няма да отговаря на условията на клъстера, генерирайки излишно натоварване на планиращия и намалявайки общата производителност.
7. Taints & Tolerations
Има още един начин за управление на планиращия. Ако имате голям клъстер с хиляди възли и хиляди микроуслуги, много е трудно да не позволявате определени подове да се разполагат на определени възли.
Тук помага механизмът taints — забраняващи правила. Например, в определени сценарии можете да забраните на определени възли да стартират подове. За да приложите taint на конкретен възел, трябва да използвате опцията taint в kubectl. Укажете ключ и стойност, а след това taint като NoSchedule или NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoScheduleСъщо така е важно да се отбележи, че механизмът taint поддържа три основни ефекта: NoSchedule, NoExecute и PreferNoSchedule.
NoScheduleозначава, че докато в спецификацията на пода няма съответстваща записtolerations, той няма да може да бъде разположен на възлите (в този примерnode10).PreferNoSchedule— опростена версияNoSchedule. В този случай планиращият ще се опита да не разпределя подове, които нямат съответстваща записtolerationsна възела, но това не е строго ограничение. Ако в клъстера няма ресурси, подовете ще започнат да се разполагат на този възел.NoExecute— този ефект задейства незабавна евакуация на подовете, които нямат съответстваща запискаtolerations.
Интересно е, че такова поведение може да бъде отменено чрез механизма tolerations. Това е удобно, когато има "забранено" нода и трябва да разположите на него само инфраструктурни услуги. Как да го постигнем? Да разрешите само тези подове, за които има подходящ toleration.
Ето как ще изглежда спецификацията на пода:
spec:
   tolerations:
     - key: "node-role.kubernetes.io\/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
Това не означава, че при следващото редеплойване подът ще попадне именно на този нода, това не е механизъм за Node Affinity и nodeSelector. Но комбинирайки няколко функции, можете да постигнете много гъвкава настройка на планировчика.
8. Настройте приоритета на разполагането на подовете
Това, че сте настроили привързаността на подовете към нодите, не означава, че всички подове трябва да се обработват с еднакъв приоритет. Например, може да искате да разположите някои подове по-рано от останалите.
Kubernetes предлага различни начини за настройка на приоритетността на подовете (Pod Priority and Preemption). Настройката се състои от няколко части: обектът PriorityClass и описанието на полето priorityClassName в спецификацията на пода. Нека да видим един пример:
apiVersion: scheduling.k8s.io\/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Този клас приоритет трябва да се използва само за много важни подове"
Създаваме PriorityClass, задаваме му име, описание и стойност. Колкото по-висок value, толкова по-висок е приоритетът. Стойността може да бъде всяко 32-битово цяло число, по-малко или равно на 1 000 000 000. По-високите стойности са резервирани за критично важни системни подове, които обикновено не могат да бъдат изместени. Изместването ще се случи само ако на високоприоритетния под няма къде да бъде разположен, тогава част от подовете на определен нод ще бъдат евакуирани. Ако за вас този механизъм е твърде строг, можете да добавите опцията preemptionPolicy: Never, и тогава измествания няма да има, подът ще заема първото място в опашката и ще чака, когато планировчикът намери свободни ресурси за него.
След това създаваме под, в който указваме името priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Можете да създавате неограничен брой класове на приоритета, въпреки че е препоръчително да не се прекалявате с това (например, да се ограничите до нисък, среден и висок приоритет).
Така в случай на необходимост ще можете да увеличите ефективността на разгръщането на критични услуги като nginx-ingress-controller, coredns и т.н.
9. Оптимизирайте ETCD клъстера
ETCD може да се нарече мозъкът на целия клъстер. Много важно е да поддържате работата на тази база данни на високо ниво, тъй като именно от нея зависи скоростта на операциите в „Куба“. Достатъчно стандартно, и в същото време добро решение би било да държите клъстера ETCD на мастер-нодовете, за да имате минимално забавяне до kube-apiserver. Ако не можете да направите това, разположете ETCD колкото се може по-близо, при добра пропускна способност между участниците. Също така обръщайте внимание на това колко ноди от ETCD могат да отпаднат без да навредят на клъстера.
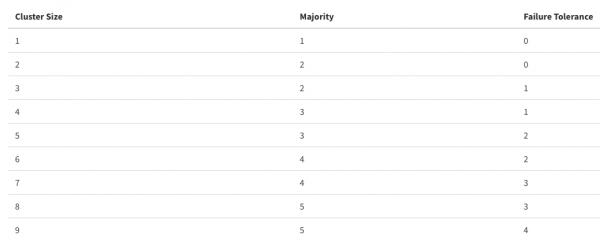
Имайте предвид, че прекомерното увеличаване на броя на участниците в клъстера може да повиши отказоустойчивостта за сметка на производителността, всичко трябва да бъде в границите.
Ако говорим за настройка на услугата, препоръките са малко:
Имайте добро оборудване, в зависимост от размера на клъстера (можете да прочетете ).
Настройте няколко параметъра, ако сте разпределили клъстера между няколко дата центъра или вашата мрежа и дискове не са на желания стандарт (можете да прочетете ).
Заключение
В тази статия са описани точки, които нашият екип се опитва да спазва. Това не е стъпка по стъпка описание на действия, а варианти, които могат да са полезни за оптимизация на разходите за клъстера. Ясно е, че всеки клъстер е уникален, и решенията за настройка могат да се различават значително, затова би било интересно да получим ваше мнение: как вие следите вашия Kubernetes клъстер, с какво подобрявате неговата работа. Споделяйте вашия опит в коментарите, ще е интересно да го узнаем.
Източник: habr.com
