

Здравейте всички! Имаме чудесни новини, през юни OTUS отново стартира курс , поради което традиционно споделяме с вас полезен материал.
Ако сте се сблъскали с цялата тази история за микросервизите без никакъв контекст, то е разбираемо да я смятате за малко странна. Разделянето на приложението на фрагменти, свързани помежду си чрез мрежа, непременно означава добавяне на сложни режими на отказоустойчивост в получената разпределена система.
Въпреки че такъв подход включва разделяне на множество независими услуги, крайната цел е много по-голяма от просто работата на тези услуги на различни машини. Тук става дума за взаимодействие с околния свят, който по своята същност също е разпределен. Не в техническия смисъл, а скорей в смисъл на екосистема, състояща се от мнозина хора, екипи, програми, и всяка от тези части така или иначе трябва да върши своята работа.
Компаниите, например, представляват набор от разпределени системи, които в съвкупност допринасят за постигането на някаква цел. Игнорирахме този факт в продължение на десетилетия, опитвайки се да постигнем обединение, прехвърляйки файлове по FTP или ползвайки инструменти за корпоративна интеграция, като същевременно се фокусирахме върху своите лични изолирани цели. Но с идването на услугите всичко се промени. Услугите ни помогнаха да надзърнем над хоризонта и да видим света на взаимозависими програми, които работят заедно. Въпреки това, за да работим успешно, е необходимо да осъзнаем и проектираме два принципиално различни свята: външния свят, където живеем в екосистема от множество други услуги, и нашия личен, вътрешен свят, където управляваме сами.
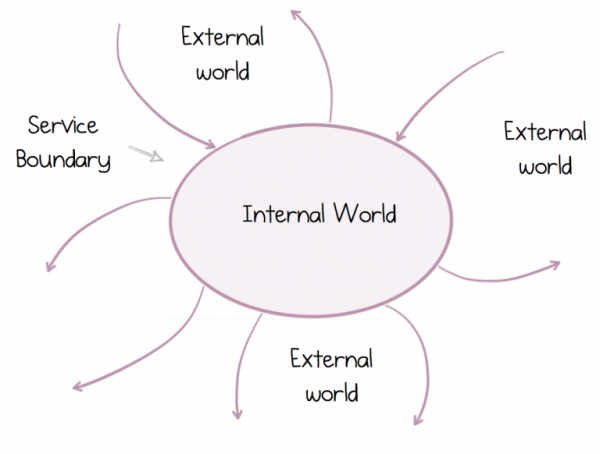
Такъв разпределен свят се различава от този, в който сме израснали и свикнали. Принципите на изграждане на традиционната монолитна архитектура не издържат на никаква критика. Следователно, правилното разбиране на такива системи е нещо повече от създаването на страхотна схема на бяла дъска или готино доказателство за концепция. Става дума за това, да работи успешно такава система дълго време. За щастие, услугите съществуват вече доста време, въпреки че изглеждат по различен начин. все още са актуални, дори подправени с Docker, Kubernetes и леко износени от хипстърските бради.
Така че днес ще разгледаме как се промениха правилата, защо трябва да преосмислим подхода си към услугите и данните, които те обменят помежду си, и защо за това ще ни е нужно съвсем различно оборудване.
Инкапсулацията не винаги ще е твой приятел.
Микросервисите могат да работят независимо един от друг. Именно това свойство им придава най-голяма стойност. То позволява на услугите да се мащабират и растат. Не толкова в смисъл на мащабиране до квадрилони потребители или петабайти данни (въпреки че и тук могат да помогнат), колкото в менталността на мащабирането, когато екипите и организациите непрекъснато растат.
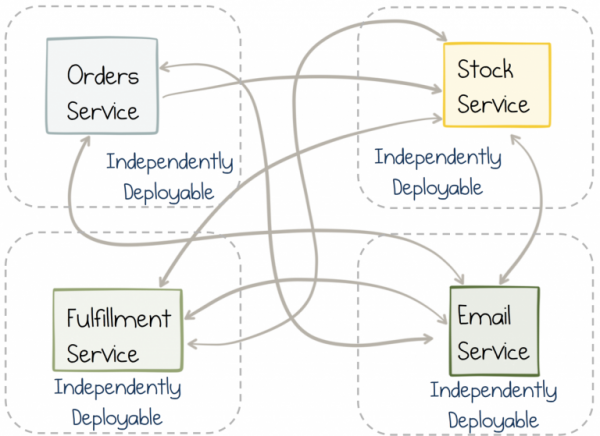
Но независимостта е двуостър меч. Тоест, самата услуга може да работи лесно и неусетно. Но ако вътре в услугата се реализира функция, която изисква взаимодействие с друга услуга, в крайна сметка трябва да внесем промени и в двете услуги почти едновременно. В монолит това е лесно, просто внасяш промяната и я пускаш в продукция, но в случай на синхронизация на независими услуги възникват много повече проблеми. Координацията между екипите и цикъла на доставка разрушава гъвкавостта.
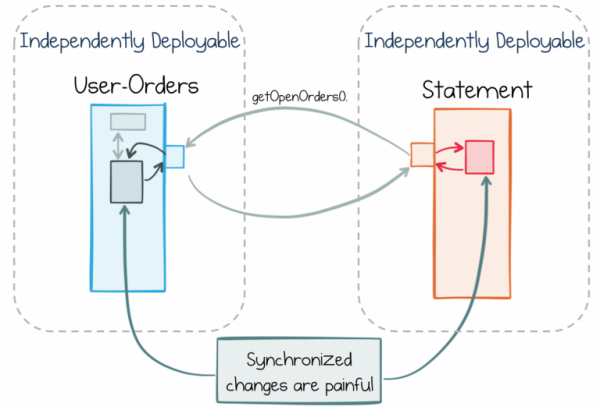
В рамките на стандартния подход нелицензранните промени се опитват да избегнат, ясно разделяйки функционалността между услугите. Услугата за единен вход в системата тук може да бъде добър пример. Тя има ясно определена роля, която я отличава от другите услуги. Това ясно разделяне означава, че в свят на бързо променящи се изисквания към околните услуги, услугата за единен вход в системата малко вероятно да се променя. Тя съществува в строго ограничен контекст.
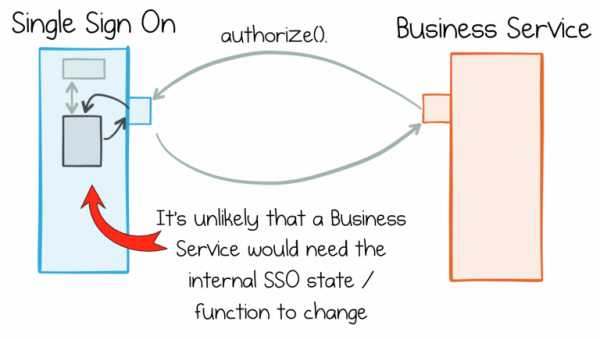
Проблемата е, че в реалния свят бизнес услугите не могат постоянно да поддържат същото чисто разделение на ролите. Например, същите тези бизнес услуги в значителна степен работят с данни, идващи от други подобни услуги. Ако се занимавате с онлайн търговия, обработката на потока поръчки, каталога на продуктите или информация за потребителите ще стане изискване за много от вашите услуги. На всяка от услугите ще е необходим достъп до тези данни, за да функционира правилно.
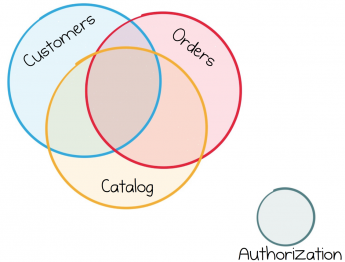
Повечето бизнес услуги използват един и същ поток данни, затова тяхната работа неизменно се преплита.
Така стигнахме до важен момент, за който си струва да говорим. Докато услугите работят добре за компоненти на инфраструктурата, които функционират в значителна степен независимо, повечето бизнес услуги се оказват свързани много по-тясно.
Дихотомия на данните
Подходите, ориентирани към услуги, може вече да съществуват, но има малко информация за това как да обменяте големи обеми данни между услугите.
Основната проблема е, че данните и услугите са неразривно свързани. От една страна, инкапсуляцията ни призовава да скрием данните, за да може услугите да бъдат отделени един от друг и да улесним тяхния растеж и бъдещи промени. От друга страна, трябва да имаме възможността свободно да споделяме и контролираме общите данни, както и всякакви други. Става въпрос за това да можем да започнем работа незабавно, също толкова свободно, колкото и в която и да е друга информационна система.
Но информационните системи имат малко общо с инкапсуляцията. Всъщност, дори напротив. Базите данни правят всичко възможно, за да предоставят достъп до съхраняваните в тях данни. Те идват с мощен декларативен интерфейс, който позволява изменение на данните по необходимост. Такава функционалност е важна на етапа на предварителните проучвания, но не и за управление на растящата сложност на постоянно развиващата се услуга.
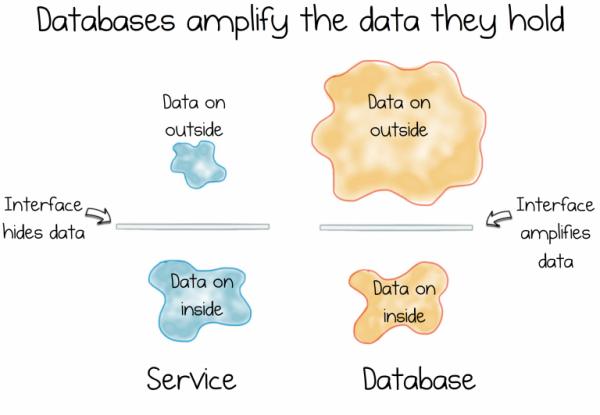
И тук възниква дилемата. Противоречието. Дихотомията. Защото информационните системи са свързани с предоставянето на данни, а услугите – със скриването им.
Тези две сили са фундаментални. Те лежат в основата на по-голяма част от нашата работа, постоянно борейки се за надмощие в системите, които създаваме.
Докато системите за услуги растат и еволюират, виждаме различни прояви на последиците от дихотомията на данните. Или интерфейсът на услугата ще расте, предоставяйки все по-широк набор от функции и ще започне да изглежда като много странна самодейна база данни, или ще срещнем разочарование и ще реализираме някакъв начин да извлечем или преместим масиви от данни от услуга в услуга.
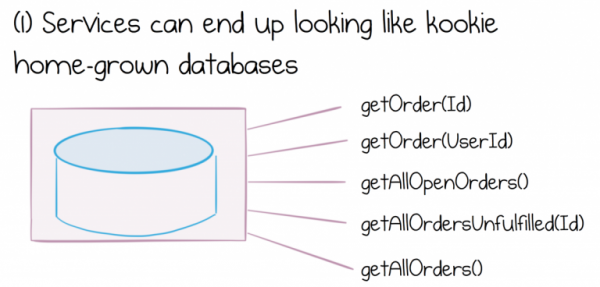
От своя страна, създаването на нещо, което изглежда като странна самодейна база данни, води до серия от проблеми. Няма да навлизаме в подробности какви опасности носи shared database, просто ще кажем, че представлява значителни скъпи инженерни и оперативни за компанията, която се опитва да я използва.
По-лошото е, че обемите данни усилват проблемите с границите на услугите. Колкото повече общи данни има в услугата, толкова по-сложен ще стане интерфейсът и толкова по-трудно ще бъде да се обединят наборите от данни, идващи от различни услуги.
Алтернативният подход с извличането и преместенето на цели набори от данни също има свои проблеми. Разпространеният подход към този въпрос изглежда като простото извличане и съхранение на набор от данни изцяло, а след това съхранението му локално във всяка услуга-потребител.
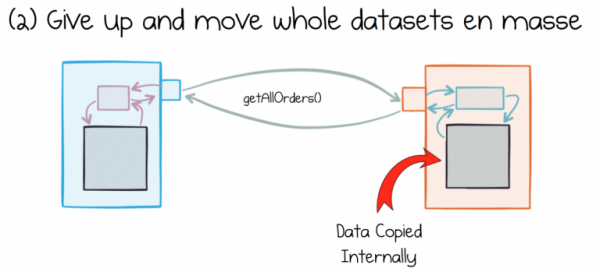
Проблемът е, че различните услуги интерпретират данните, които консумират, по различен начин. Тези данни винаги са ръка разстояние. Те се изменят и обработват локално. Доста бързо те престават да имат нещо общо с данните в източника.
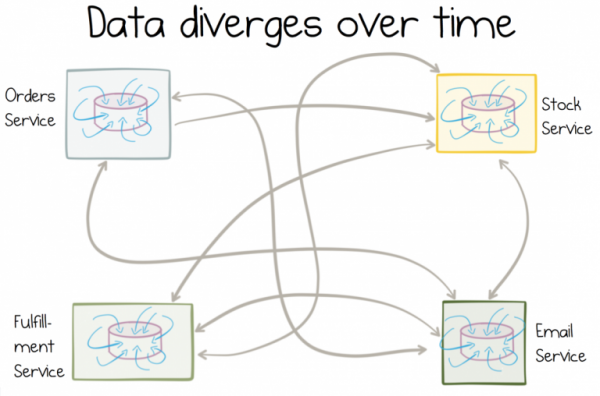
Колкото по-мутабилни са копията, толкова повече данните ще се различават с течение на времето.
Още по-лошо, тези данни е трудно да се поправят ретроспективно ( тук наистина може да дойде на помощ). Всъщност някои от трудноразрешимите технологични проблеми, с които бизнесът се сблъсква, произлизат от хетерогенни данни, които се множат от приложение на приложение.
За да намерим решение на този проблем с общите данни, трябва да мислим различно. Те трябва да станат обекти от първокласен клас в архитектурите, които изграждаме. таки данни се наричат "външни", и това е много важна особеност. Нуждаем се от инкапсулация, за да не разкриваме вътрешната структура на услугата, но трябва да улесним достъпа на услугите до споделените данни, за да могат те да изпълняват работата си правилно.
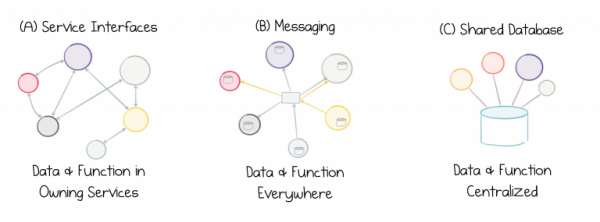
Проблемът е, че никой от подходите днес вече не е актуален, тъй като нито интерфейсите на услугата, нито обменът на съобщения, нито споделената база данни предлагат добро решение за работа с външни данни. Интерфейсите на услугата не са подходящи за обмен на данни в какъвто и да е мащаб. Обменът на съобщения пренася данни, но не съхранява тяхната история, затова с течение на времето данните се повреждат. Споделените бази данни твърде много се фокусират в една точка, което спира развитието на напредъка. Невъзможно е да избягаме от цикъла на несъстоятелност на данните:
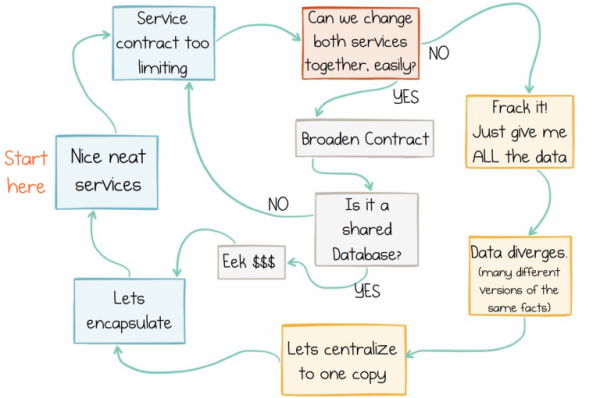
Цикъл на несъстоятелност на данните
Потокове: децентрализирания подход към данните и услугите
В идеалния случай трябва да променим подхода, по който услугите работят с общи данни. В момента всеки подход среща споменатата по-горе дихотомия, тъй като не съществува магическа пудра, с която да я посипем щедро и тя да изчезне. Обаче можем да преосмислим проблема и да достигнем до компромис.
Този компромис предполага определена степен на централизация. Можем да се възползваме от механизма на разпределените логове, тъй като той осигурява надеждни скалируеми потоци. Сега е нужно услугите да могат да се присъединяват и работят с тези общи потоци, но искаме да избегнем сложни централизирани God Services, които извършват такава обработка. Затова най-добрият вариант е да вградим потокова обработка във всяка услуга-потребител. Така услугите могат да комбинират набори от данни от различни източници и да работят с тях така, както им е необходимо.
Един от начините да постигнем такъв подход е чрез използването на стрийминг платформа. Има много опции, но днес ще разгледаме точно Kafka, тъй като използването на нейното Stateful Stream Processing позволява ефективно решаване на представената проблема.
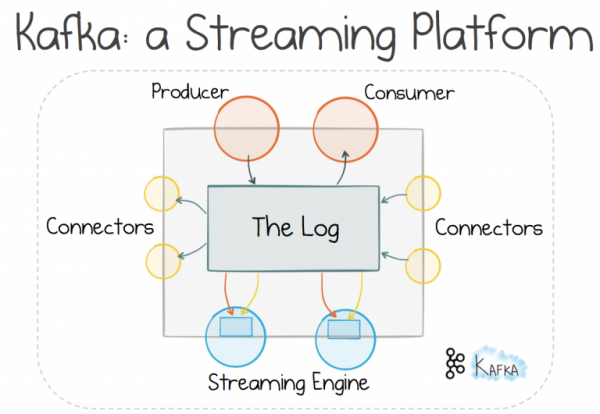
Използването на механизма за разпределено логиране ни позволява да поемем по утъпкания път и да използваме обмен на съобщения, за да работим с . Смята се, че този подход осигурява по-добро мащабиране и разделение от механизма „запитване-отговор“, тъй като предава контрола на потока на получателя, а не на изпращача. Въпреки това, за всичко в този живот трябва да се плати, и тук ще ви трябва брокер. Но за големи системи тази компромисна точка си заслужава (както не може да се каже за вашите средностатистически уеб приложения).
Ако за разпределеното логване отговаря брокер, а не традиционната система за обмен на съобщения, можете да се възползвате от допълнителни функции. Транспортът може да се мащабира линейно почти толкова добре, колкото разпределената файловата система. Данните могат да се съхраняват в логовете достатъчно дълго, така че получаваме не само обмен на съобщения, но и хранилище на информация. Мащабируемо хранилище без страх от получаване на изменяемо общо състояние.
След това можете да използвате механизма stateful stream processing (обработка на потока със запазване на състоянието) за добавяне на декларативни инструменти за база данни в потребителските услуги. Това е много важна идея. Докато данните са съхранени в общи потоци, до които всички услуги могат да получат достъп, обединението и обработката, които услуга извършва, са частни. Те остават изолирани в строго ограничен контекст.
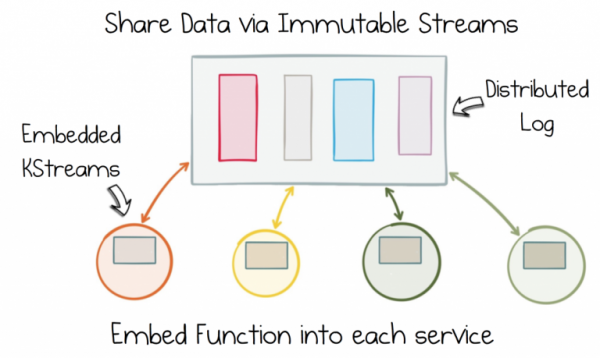
Освободете се от дихотомията на данните, разделяйки имутируемия поток на състояния. След това добавете тази функция във всяка услуга с помощта на Stateful Stream Processing.
По този начин, ако вашата услуга трябва да работи с поръчки, каталог на продукти, склад, тя ще има пълен достъп: само вие ще решавате какви данни да обедините, къде да ги обработвате и как те трябва да се променят с течение на времето. Въпреки че данните са общи, работата с тях е напълно децентрализирана. Тя се извършва вътре в всяка услуга, в свят, в който всичко е по вашите правила.
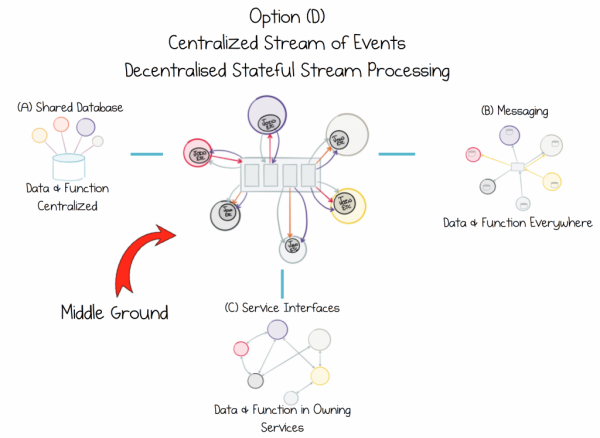
Споделяйте данни, така че да не се нарушава тяхната цялост. Инкапсулирайте функцията, а не източника, във всяка услуга, на която е нужна.
Понякога данните трябва да бъдат пренесени масово. Понякога на услугата ѝ е необходим локален исторически набор от данни в избраната база данни. Важното е, че можем да гарантираме, че при необходимост копията може да бъде възстановена от източника чрез механизма за разпределено логиране. Конекторите в Kafka отлично изпълняват тази задача.
Така че разгледаният днес подход има няколко предимства:
- Данните се използват като общи потоци, които могат да се съхраняват дълго в логовете, а самият механизъм за работа с общи данни е вграден във всеки отделен контекст, което позволява на услугите да работят лесно и бързо. По този начин можем да балансираме дихотомията на данните.
- Данните, постъпващи от различни услуги, могат лесно да бъдат обединявани в набори. Така се опростява взаимодействието с общите данни и изчезва необходимостта от поддържане на локални набори от данни в базата данни.
- Stateful Stream Processing само кешира данните, а източникът на истина остават общите логове, така че проблемът с повреждането на данните с времето не е толкова остър.
- По същество, услугите се управляват от данните, тоест въпреки постоянния растеж на обемите данни, услугите все още могат бързо да реагират на бизнес събития.
- Проблемите с мащабируемостта лежат върху брокера, а не върху услугите. Така значително се намалява сложността на писането на услуги, тъй като няма нужда да се замисляме за мащабируемост.
- Добавянето на нови услуги не изисква промяна на старите, така че свързването на нови услуги става по-лесно.
Както виждате, това е повече от просто REST. Получихме набор от инструменти, който позволява работа с общите данни в децентрализирана форма.
В днешната статия не бяха разгледани всички аспекти. Все още трябва да решим как да балансираме между парадигмата 'заявка-отговор' и събитийно ориентираната парадигма. Но с това ще се справим следващия път. Има теми, които трябва да се опознаят по-добре, например какво прави Stateful Stream Processing толкова добър. За това ще говорим в третата статия. Има и други мощни конструкции, които можем да използваме, когато прибегнем до тях, например, . С нея се променят правилата на играта за разпределените бизнес системи, тъй като тази конструкция осигурява транзакционни гаранции за в мащабируем вид. За това ще говорим в четвъртата статия. И накрая, ще трябва да преминем през детайлите на реализирането на тези принципи.
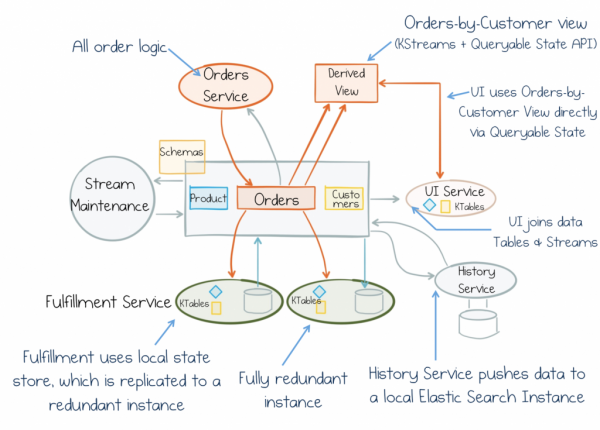
Но засега просто запомнете следното: дихотомията на данните е силата, с която се сблъскваме при създаването на бизнес услуги. И трябва да имаме това предвид. Фокусът е да обърнем всичко наопаки и да започнем да считаме общите данни за обекти от първи клас. Stateful Stream Processing предлага уникален компромис за това. Той избягва централизирани “God Components”, които спират напредъка. Освен това осигурява оперативност, мащабируемост и отказоустойчивост на потоковите данни и ги интегрира във всяка услуга. Така можем да се фокусираме върху общия поток на съзнанието, към който всяка услуга може да се свърже и да работи с нейните данни. Така услугите стават по-мащабируеми, взаимозаменяеми и автономни. Затова те не само ще изглеждат добре на дъските с бележки и по време на проверките на хипотези, но и ще работят и се развиват в продължение на десетилетия.
Източник: habr.com
