

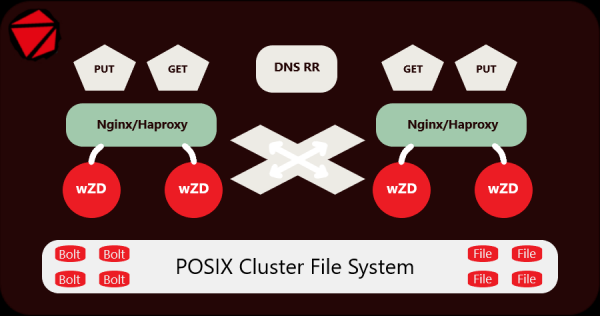
Уважаемо общество, тази статия ще бъде посветена на ефективното съхранение и предоставяне на стотици милиони малки файлове. На този етап предлага окончателно решение за файлови системи, съвместими с POSIX, с пълна поддръжка на заключвания, включително кластерни, и изглежда дори без крак на помощ.
Затова за тази цел написах собствен специализиран сървър.
По време на реализацията на задачата успях да реша основния проблем, като в същото време постигнах икономия на дисково пространство и оперативна памет, които безмилостно поглъщаше нашата кластерна файловата система. Такова количество файлове е вредно за всяка кластерна файлова система.
Идеята е следната:
Простичко казано, чрез сървъра се качват малки файлове, те се съхраняват директно в архив и така също се четат от него, а големите файлове се поставят наблизо. Схемата е: 1 папка = 1 архив, следователно имаме няколко милиона архива с малки файлове, а не няколко стотин милиона файлове. И всичко това е реализирано напълно, без всякакви скриптове и разпиляване на файлове в tar/zip архива.
Ще се постарая да изложа покороче, предварително се извинявам ако постът стане дълъг.
Всичко започна с това, че не можах да намеря подходящ сървър в света, който да може да съхранява данни, получени чрез HTTP протокол директно в архиви, така че да не имат недостатъците, присъщи за обикновените архиви и обектни хранилища. Причината за търсенето стана разширилият се до големи мащаби Origin кластер от 10 сървъра, в който се натрупаха вече 250,000,000 малки файла, а тенденцията за растеж не се предвиждаше да спира.
На тези, които не обичат да четат статии и предпочитат да имат по-кратка документация:
и .
И docker заедно, в момента има вариант само заедно с nginx вътре за всеки случай:
docker run -d --restart=always -e host=localhost -e root=\/var\/storage -v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzdСлед това:
Ако файловете са много, са необходими значителни ресурси, и най-обидното е, че част от тях се губят напразно. Например, при използване на клъстерна файлова система (в разглеждания случай — MooseFS) файлът, независимо от фактическия си размер, заема винаги минимум 64 KB. Тоест за файлове с размер 3, 10 или 30 KB на диска се изискват по 64 KB. Ако файловете са четвърт милиард, губим от 2 до 10 терабайта. До безкрайност не можем да създаваме нови файлове, тъй като в същата MooseFS има ограничение: не повече от 1 милиард с една реплика на всеки файл.
С увеличаването на броя на файловете, е необходима голяма оперативна памет за метаданните. Също така, честите големи дампове на метаданни водят до износване на SSD-накопителите.
Сървър wZD. Подреждаме дисковете.
Сървърът е написан на езика Go. Първо, трябваше да намаля броя на файловете. Как да направя това? Чрез архивиране, но в този случай без компресия, тъй като моите файлове са само компресирани изображения. На помощ дойде BoltDB, от която се наложи да отстраня недостатъците, отразени в документацията.
Вместо четвърт милиард файлове, в моя случай останаха само 10 милиона архиви Bolt. Ако имам възможност да променя текущата структура на запълване на директориите с файлове, би било възможно да намаля около до 1 милион файлове.
Всички малки файлове се опаковат в архиви Bolt, автоматично получаващи имената на директорите, в които се намират, а всички големи файлове остават до архивите, няма смисъл да ги опаковаме, това е конфигурируемо. Малките — архивираме, големите — оставяме без промяна. Сървърът работи прозрачно и с едните, и с другите.
Архитектурата и особеностите на сървъра wZD.
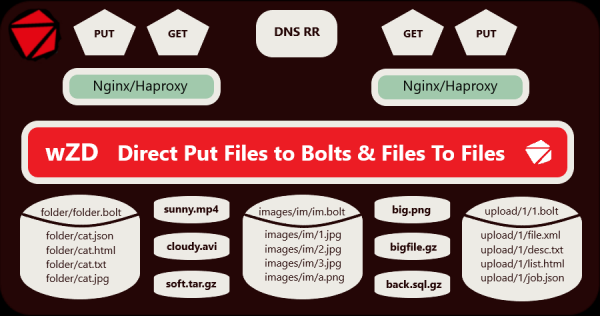
Сървърът функционира под управлението на операционни системи Linux, BSD, Solaris и OSX. Тествах само за архитектура AMD64 под Linux, но той трябва да подхожда и за ARM64, PPC64, MIPS64.
Основни характеристики:
- Многопоточност;
- Мултисерверност, осигуряваща отказоустойчивост и балансиране на натоварването;
- Максимална прозрачност за потребителя или разработчика;
- Поддържани HTTP методи: GET, HEAD, PUT и DELETE;
- Управление на поведението при четене и запис чрез клиентски заглавия;
- Поддръжка на гъвкаво конфигурируеми виртуални хостове;
- Поддръжка на CRC за целостта на данните при запис/четене;
- Полудинамични буфери за минимално потребление на памет и оптимална настройка на мрежовата производителност;
- Отложена компакция на данните;
- В допълнение се предлага многопоточен архиватор wZA за миграция на файлове без спиране на услугата.
Реален опит:
Разработвал и тестирах сървър и архиватор на живи данни доста дълго време, сега той успешно функционира в клъстер, включващ 250,000,000 малки файла (снимки), разположени в 15,000,000 директории на отделни SATA-дискове. Клъстерът от 10 сървъра представлява Origin-сървър, инсталиран зад CDN-мрежата. За обслужването му се използват 2 сървъра Nginx + 2 сървъра wZD.
На тези, които решат да използват този сървър, има смисъл да планират структурата на директорите преди използването, ако това е приложимо. Веднага уточнявам, че сървърът не е предназначен да натъпка всичко в 1 Bolt архив.
Тестиране на производителността:
Колкото по-малък е размерът на архивирания файл, толкова по-бързо се изпълняват операциите GET и PUT с него. Сравняваме общото време за запис от HTTP клиента в обикновени файлове и в Bolt архиви, както и четене. Сравнява се работата с файлове с размер 32 KB, 256 KB, 1024 KB, 4096 KB и 32768 KB.
При работа с Bolt архиви се проверява целостта на данните на всеки файл (използва се CRC), преди запис и също след запис става четене на етап и преизчисляване, което естествено внася закъснения, но основното — безопасност на данните.
Тестовете за производителност провеждах на SSD-дискове, тъй като на SATA-дискове тестовете не показват ясна разлика.
Графики от резултатите от тестовете:
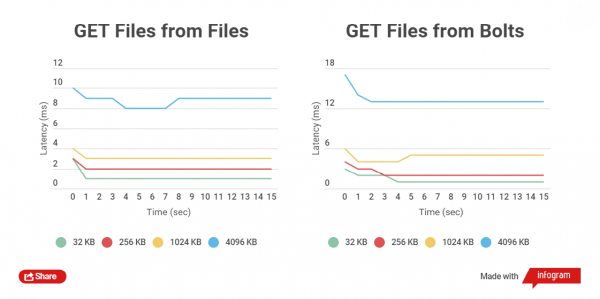
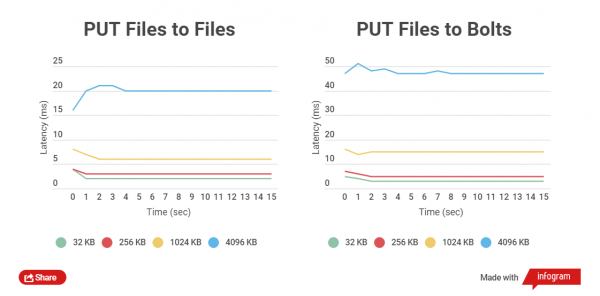
Както се вижда, за малките файлове разликата във времето за четене и запис между архивираните и не архивираните файлове е незначителна.
Съвсем различна картина получаваме при теста за четене и запис на файлове с размер 32 MB:
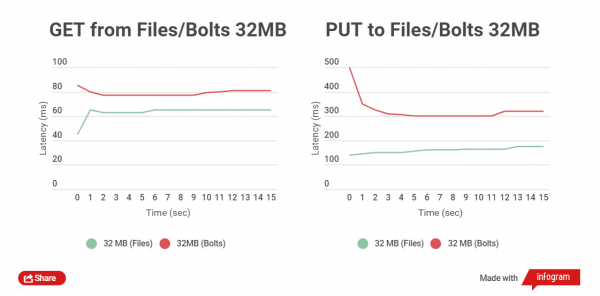
Разликата във времето между четенето на файловете е в рамките на 5-25 мс. С записването нещата стоят по-зле, разликата е около 150 мс. Но в този случай не е необходимо да се качват големи файлове, в това просто няма смисъл, те могат да съществуват отделно от архивите.
*Технически е възможно да се използва този сървър и за задачи, изискващи NoSQL.
Основни методи за работа с wZD сървъра:
Качване на обикновен файл:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgКачване на файл в Bolt архив (ако не е надвишен параметърът на сървъра fmaxsize, определящ максималния размер на файла, който може да бъде включен в архива, ако е надвишен, файлът ще се качи нормално до архива):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgСваляне на файла (ако на диска и в архива има файлове с еднакви имена, по време на свалянето се отдава предимство на неархивирания файл):
curl -o test.jpg http://localhost/test/test.jpgСваляне на файл от Bolt архив (принудително):
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgОписание на други методи има в документацията.
Сървърът засега поддържа само протокола HTTP, с HTTPS все още не работи. Също така не се поддържа метод POST (още не е решено дали е необходим или не).
Който се задълбочи в изходния код, ще открие там ириска, не всички я харесват, но не свързах основния код с функциите на уеб фреймворка, освен обработчика на прекъсвания, така че в бъдеще мога бързо да пренапиша почти на всеки движок.
ToDo:
- Разработка на собствен репликатор и дистрибутор + гео за възможността да се използва в големи системи без клъстерни ФС (Всичко по възрастен начин)
- Възможност за пълно обратно възстановяване на метаданни при тяхна пълна загуба (в случай на използване на дистрибутор)
- Нативен протокол за възможността за използване на постоянни мрежови връзки и драйвери за различни програмни езици
- Разширени възможности за използване на NoSQL компонент
- Компресия на различни типове (gzip, zstd, snappy) за файлове или стойности вътре в Bolt архиви и за обикновени файлове
- Шифроване на различни типове за файлове или стойности вътре в Bolt архиви и за обикновени файлове
- Отложена сървърна видео конверсия, включително и на GPU
От мен е всичко, надявам се този сървър да е полезен на някого, лицензия BSD-3, авторските права са двойни, тъй като ако не беше компанията, в която работя, нямаше да пиша и сървъра. Разработчик съм в единствено число. Ще бъда благодарен за откритите бъгове и искания за нови функции.
Източник: habr.com
