

Тъй като ClickHouse е специализирана система, при използването му е важно да се вземат предвид особеностите на архитектурата му. В тази презентация Алексей ще разкаже за примери на типични грешки при използването на ClickHouse, които могат да доведат до неефективна работа. На примери от практиката ще бъде показано как изборът на определена схема за обработка на данни може да промени производителността с порядъци.
Здравейте на всички! Аз съм Алексей, аз правя ClickHouse.
Първо, бързам да ви зарадвам, днес няма да ви разказвам какво е ClickHouse. Честно казано, актът ми е омръзнал. Всеки път разказвам какво е то. И вероятно всички вече знаете.
Вместо това ще говоря за възможните капани, т.е. как може неправилно да се използва ClickHouse. Всъщност, не е нужно да се страхувате, защото ние разработваме ClickHouse като система, която е проста, удобна и работи веднага. Инсталирате и всичко, никакви проблеми.
Но все пак е необходимо да се вземе под внимание, че тази система е специализирана и лесно може да се натъкнете на необичаен сценарий на използване, който ще изкара системата извън зоната на комфорт.
И така, какви са капаните? Основно ще говоря за очевидни неща. Всички знаят всичко очевидно, всеки разбира и може да се зарадва, че е толкова умен, а който не разбира, ще научи нещо ново.
Първият, най-прост пример, който, за съжаление, често се среща, е голямо количество insert-и с малки партиди, т.е. голямо количество малки insert-и.
Ако разгледате как ClickHouse изпълнява inserts, можете с една заявка да изпратите поток от данни натерабайт. Това не е проблем.
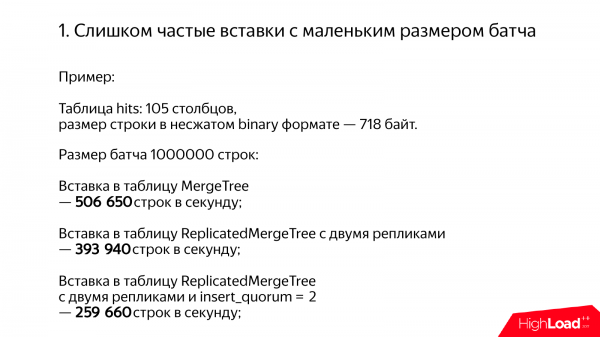
И да видим каква типична ще бъде производителността. Например, имаме таблица с данни от Яндекс.Метрика. Хитовете. 105 някакви колони. 700 байта в некомпресиран вид. И ще вмъкваме по-добре батчове от по един милион реда.
Вмъкваме в таблица MergeTree, получаваме половин милион реда в секунда. Отлично. В реплицирана таблица – ще е малко по-малко, приблизително 400 000 реда в секунда.
И ако включим кворумно вмъкване, получаваме малко по-малко, но все пак прилична производителност, 250 000 реда в секунда. Кворумното вмъкване е недокументируема възможност в ClickHouse*.
* към състоянието през 2020 година, .
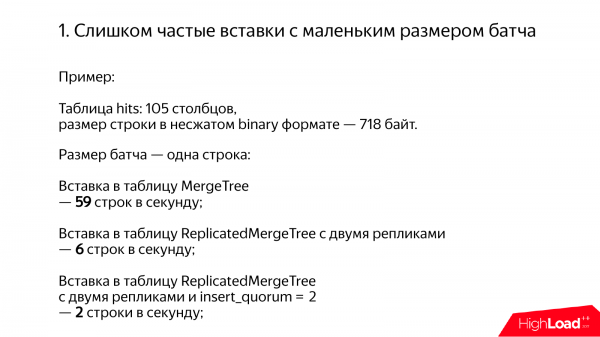
Какво ще се случи, ако вършим нещата лошо? Вмъкваме по един ред в таблицата MergeTree и получаваме 59 реда в секунда. Това е 10 000 пъти по-бавно. В ReplicatedMergeTree – 6 реда в секунда. А ако се включи и кворумът, резултатът е 2 реда в секунда. Според мен, това е истинска катастрофа. Как може да се работи така бавно? Дори на тениската ми пише, че ClickHouse не трябва да забавя. И въпреки това, понякога се случва.
Всъщност – това е нашият недостатък. Можехме напълно да направим така, че всичко да работи нормално, но не го направихме. И не го направихме, защото за нашия сценарий – това не беше нужно. Имахме си и батчове. Просто получавахме батчове на входа, и нямаше проблеми. Вмъкваме и всичко работи нормално. Но разбира се, възможни са всякакви сценарии. Например, когато имате куп сървъри, на които се генерират данни. Те вмъкват данни не толкова често, но все пак получавате чести вмъквания. И трябва да избягвате това по някакъв начин.
От техническа гледна точка, същността е, че когато правите insert в ClickHouse, данните не попадат в никаква memtable. Нямаме даже истински лог структура MergeTree, а просто MergeTree, защото нямаме нито лог, нито memTable. Просто записваме данните направо в файловата система, вече разпределени по колони. И ако имате 100 колони, ще трябва да запишете повече от 200 файла в отделна директория. Всичко това е доста обемисто.
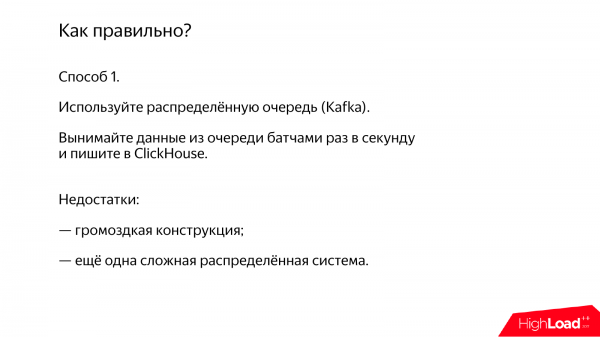
И възниква въпросът: „Как да направим правилно?“, ако ситуацията е такава, че все пак трябва по някакъв начин да записваме данни в ClickHouse.
Метод 1. Това е най-простият метод. Да използвате някаква разпределена опашка. Например, Kafka. Просто извличате данните от Kafka, правите батч на всека секунда. И всичко ще бъде наред, записвате, всичко работи нормално.
Недостатъците са, че Kafka – това е още една обемиста разпределена система. Още разбирам, ако във фирмата ви вече има Kafka. Това е добре, удобно е. Но ако няма, трябва да помислите три пъти преди да въвеждате още една разпределена система в проекта си. И затова трябва да разгледате алтернативи.
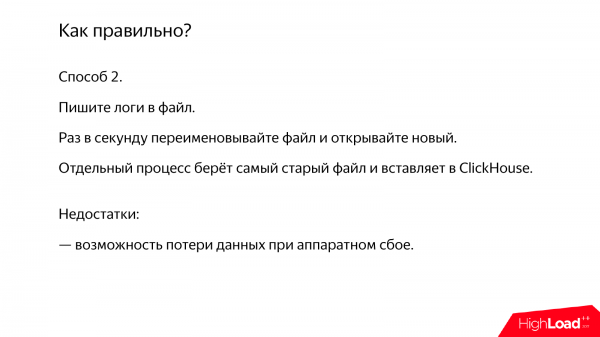
Метод 2. Това е стара, но много проста алтернатива. Имате сервер, който генерира вашите логове. Той просто записва логовете в файл. И на всеки секунда, например, този файл се преименува и се отваря нов. Отделен скрипт, или по cron, или някакъв демон взема най-старата версия и записва в ClickHouse. Ако записвате логовете всяка секунда, всичко ще бъде отлично.
Но недостатък на този метод е, че ако вашият сървър, генериращ логовете, изчезне, данните също ще изчезнат.
Метод 3. Има и друг интересен метод, който въобще не използва временни файлове. Например, имате някаква рекламна въртележка или друг интересен демон, който генерира данни. Можете да съхранявате пакет данни директно в оперативната памет, в буфера. И когато изминe достатъчно време, можете да отложите този буфер, да създадете нов и в отделен поток да записвате събраните данни в ClickHouse.
От друга страна, данните също изчезват при kill -9. Ако вашият сървър падне, ще загубите тези данни. Друг проблем е, че ако не успеете да запишете в базата, данните ще се натрупват в оперативната памет. И или оперативната памет ще свърши, или просто ще загубите данни.
Метод 4. Ето още един интересен метод. Имате сървърен процес. И той може да изпраща данни в ClickHouse веднага, но да го прави в едно единствено свързване. Например, изпратил http-запитване с transfer-encoding: chunked с insert. И генерира чанкове не твърде рядко, можете да изпращате всяка редица, но ще има overhead при фрейминг на тези данни.
Но в този случай данните ще бъдат изпратени в ClickHouse веднага. И ClickHouse сам ще ги буферира.
Но също така възникват проблеми. Сега ще загубите данни, особено когато вашият процес бъде убит и, ако процесът ClickHouse бъде убит, защото това ще бъде незавършен insert. А в ClickHouse insert-ите са атомарни до определен праг от редове. В принципе, това е интересен метод. Може да се използва.
Метод 5. Ето и един интересен метод. Това е някакъв разработен от общността – сървър за пакетно обработване на данни. Аз самият не съм го разглеждал, така че не мога да гарантирам нищо. Въпреки това, и самият ClickHouse не предоставя garanties. Той също е с отворен код, но от друга страна, може да сте свикнали с определен стандарт на качество, който се стремим да осигурим. А за тази система – не знам, влезте в GitHub, разгледайте кода. Може би е написано нещо нормално.
* към 2020 година, следва да добавите и за разглеждане .
Метод 6. Още един метод – това е използването на Buffer таблици. Предимствата на този метод са, че е много просто да започнете да го използвате. Създавате Buffer таблица и вмъквате в нея.
Недостатъкът е, че проблемът не се решава напълно. Ако при вмъкване от типа MergeTree трябва да групирате данни по един пакет в секунда, то при вмъкване в Buffer таблица, трябва да групирате поне до няколко хиляди в секунда. Ако бъдат над 10 000 в секунда, пак ще е лошо. А когато вмъквате на пакети, виждате, че излизат стотици хиляди редове в секунда. И това е при доста тежки данни.
Също така, Buffer таблиците нямат лог. И ако нещо е наред с вашия сървър, данните ще се загубят.
Като бонус, наскоро в ClickHouse се появи възможност да вземате данни от Kafka. Съществува табличен двигател – Kafka. Просто го създавате. И към него може да прикрепите материализирани представления. В този случай той сам ще извлича данни от Kafka и ще ги вмъква в необходимите таблици.
Особено радващ е фактът, че тази възможност не е направена от нас. Това е функция на общността. И когато говоря за "функция на общността", не го казвам с презрение. Четохме кода, правихме преглед, трябва да работи нормално.
* към 2020 година, се появи аналогична поддръжка за .
Какво друго може да е неудобно или неочаквано при вмъкване на данни? Ако правите заявка insert values и в values пишете някакви изчисляеми изрази. Например, now() – това също е изчисляем израз. В този случай ClickHouse е принуден да стартира интерпретатора на тези изрази за всяка редица, а производителността ще спадне драстично. По-добре е да избегнете това.
* в момента проблемата е напълно решена, регресии в производителността при използването на изрази в VALUES вече няма.
Друг пример, при който могат да възникнат проблеми, е когато в един батч данните принадлежат на множество партиции. По подразбиране в ClickHouse партициите са по месеци. И ако вмъкнете батч от милион реда, а данните са за няколко години, ще имате няколко десетки партиции. И това е еквивалентно на батчове, които са няколко десетки пъти по-малки, тъй като вътре те винаги първо се разпределят по партиции.
* наскоро в ClickHouse в експериментален режим бе добавена поддръжка на компактния формат на парчета и парчета в оперативната памет с запис предварително, което почти напълно решава проблема.
Сега нека разгледаме втория вид проблем – това е типизация на данни.
Типизацията на данни може да бъде строга или низова. Низовата – е, когато просто сте обявили, че всичките Ви полета са от тип string. Това е лошо. Не трябва да се прави така.
Нека да разгледаме как да се направи правилно в случаите, когато искаме да кажем, че някое поле е низ и нека ClickHouse сам да се справи, а аз да не се безпокоя. Но все пак си струва да положим някои усилия.
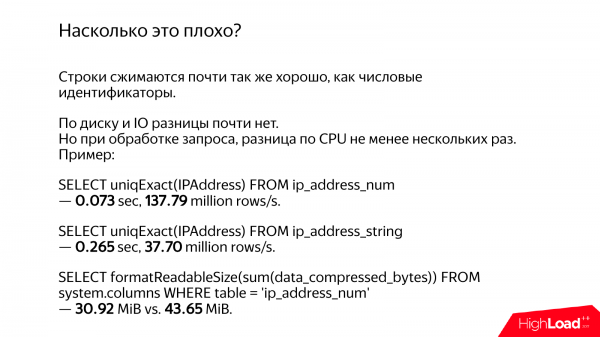
Например, имаме IP адрес. В един случай сме го съхранили като низ. Например, 192.168.1.1. А в другия случай – това ще бъде число от тип UInt32*. 32 бита е достатъчно за IPv4 адрес.
На първо място, колкото и странно да звучи, данните ще се компресират почти по същия начин. Разликата ще бъде, разбира се, но не толкова голяма. Така че по дисковото вход/изход не съществуват сериозни проблеми.
Но има сериозна разлика в процесорното време и времето за изпълнение на заявката.
Да изчислим броя на уникалните IP адреси, ако те се съ хранят под форма на числа. Получава се 137 милиона реда в секунда. Ако същото е под форма на низове, тогава 37 милиона реда в секунда. Не знам защо такава съвпадение се получи. Аз самият изпълнявах тези заявки. Но все пак е около 4 пъти по-бавно.
Ако изчислим разликата в мястото на диска, разликата също съществува. И разликата е около една четвърт, защото уникалните IP адреси са доста много. И ако тук имаше редове с малко различни стойности, те биха се компресирали по речника до приблизително един и същ обем.
И четирикратната разлика във времето на пътя не е без значение. Може би, на вас, разбира се, не ви пука, но когато виждам такава разлика, ми става тъжно.
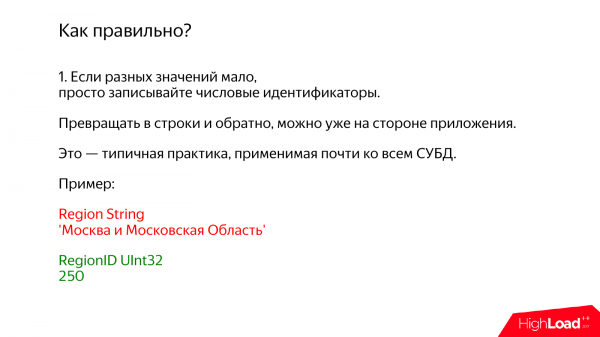
Нека разгледаме различни случаи.
1. Един случай, когато имате малко различни уникални стойности. В този случай използваме простата практика, която вероятно познавате и можете да използвате за всяка СУБД. Това е валидно не само за ClickHouse. Просто записвате числовите идентификатори в базата. А конвертирането в низове и обратно може да се направи на нивото на вашето приложение.
Ето, например, имате регион. И се опитвате да го запазите като низ. И там ще пише: Москва и МО. И когато виждам, че пише „Москва“, това все още е нещо, а когато и МО, става доста тъжно. Толкова байта.
Вместо това просто записваме числото Ulnt32 и 250. Имаме 250 в Яндекс, а при вас може да е различно. За всяка страна мога да кажа, че в ClickHouse има вградена функционалност за работа с геобаза. Просто записвате справочник с регионите, включително иерархичен, т.е. там ще има и Москва, и МО, и всичко, което ви е нужно. И може да се конвертира на ниво запитване.
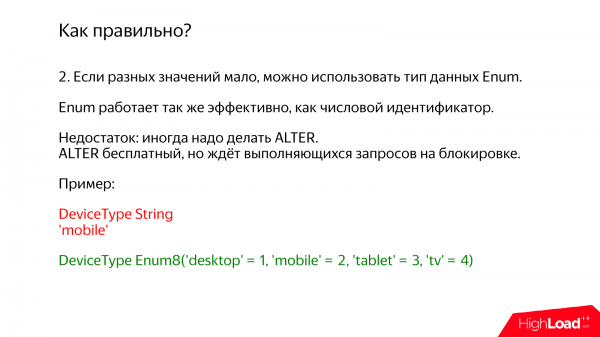
Вторият вариант е почти същият, но вече с поддръжка вътре в ClickHouse. Това е тип данни Enum. Вие просто в Enum описвате всичките нужни ви стойности. Например, тип устройство и там пишете: десктоп, мобилен, таблет, телевизор. Общо 4 варианта.
Недостатъкът е, че трябва периодично да правите алтериране. Добавили сте само една стойност. Правите alter table. Всъщност alter table в ClickHouse е безплатен. Особено безплатен за Enum, защото данните на диска не се променят. Но въпреки това alter блокира таблицата и трябва да чака, докато се извършат всички selects. И чак след това alter ще се изпълни, т.е. все пак има някои неудобства.
* В новите версии на ClickHouse ALTER е направен напълно неблокиращ.
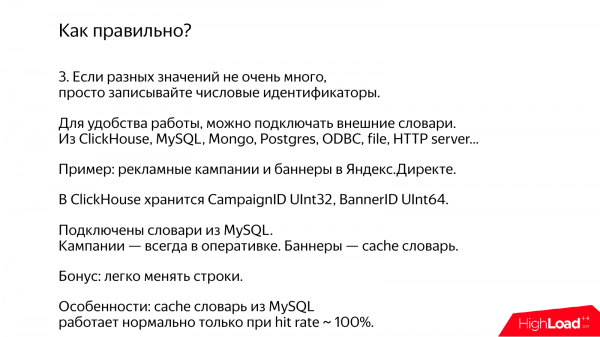
Още един вариант, доста уникален за ClickHouse – това е свързването на външни речници. Можете да пишете в ClickHouse числа, а вашите справочници да ги държите в която и да е удобна система за вас. Например, можете да използвате: MySQL, Mongo, Postgres. Можете дори да създадете свой микросервис, който да отдава тези данни по http. И на ниво ClickHouse пишете функция, която ще преобразува тези данни от числа в низове.
Това е специализиран, но много ефективен начин за изпълнение на join с външна таблица. Има два варианта. В един вариант тези данни ще бъдат напълно кеширани, напълно налични в оперативната памет и ще се актуализират с определена периодичност. А в другия вариант, ако тези данни не се побират в оперативната памет, може да се кешират частично.
Ето един пример. Има Яндекс.Директ. И там има рекламна кампания и банери. Вероятно има около десет милиона рекламни кампании. И те се побират в оперативната памет. А банерите – милиарди, те не се побират. И ние използваме кешируем речник от MySQL.
Единствената проблем е, че кешируемият речник ще работи нормално, ако hit rate е близо до 100%. Ако е по-малко, при обработка на заявките за всяка партида данни действително ще трябва да вземете липсващите ключове и да вземете данни от MySQL. За ClickHouse мога да потвърдя, че – да, не забавя, за другите системи няма да говоря.
А като бонус, това, че речниците са много прост начин да обновите данните в ClickHouse ретроактивно. Тоест, имахте отчет за рекламни кампании, потребителят просто е сменил рекламната кампания и във всички стари данни, във всички отчети тези данни също са се променили. Ако пишете редове директно в таблицата, обновяването им ще бъде невъзможно.
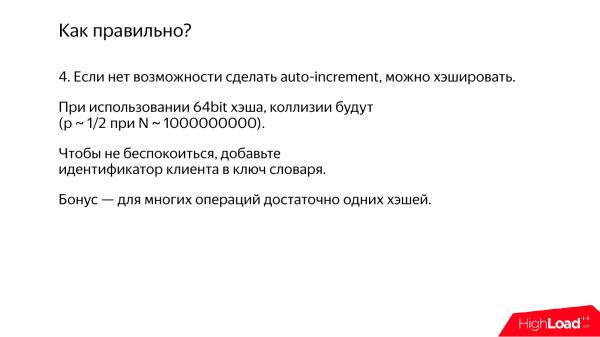
Още един начин, когато не знаете откъде да получите идентификаторите за вашите редове. Можете просто да хеширате. Най-простият вариант е да вземете 64-битов хеш.
Единствената проблем е, че ако хешът е 64-битов, колизии почти със сигурност ще имате. Защото, ако там има милиард реда, вероятността вече става значима.
И не би било много добре да хеширате имената на рекламните кампании по този начин. Ако рекламните кампании на различни компании се сбъркат, ще стане нещо неясно.
Има прост трик. Вярно, че не е много подходящ за сериозни данни, но ако не става въпрос за нещо много важно, просто добавете идентификатора на клиента в ключа на речника. Тогава ще имате колизии, но само в рамките на един клиент. Такъв метод използваме за картата на линковете в Яндекс.Метрика. Имаме урли, съхраняваме хешове. Знаем, че колизиите, разбира се, съществуват. Но когато страницата се показва, вероятността точно на една страница за един потребител някакви урли да се слеят и това да се заб注意, може да се пренебрегне.
Като бонус – за много операции са достатъчни само хешове и самите стрингове не е нужно да се съхраняват никъде.
Друг пример, ако стринговете са кратки, например, домейни на сайтове. Може да ги съхранявате така, както са. Или, например, език на браузъра ru – 2 байта. Разбира се, много ми е мъчно за байтовете, но не се притеснявайте, 2 байта не са проблем. Моля, съхранявайте така, както са, не се тревожете.
Друг случай, когато, обратно, има много стрингове и в тях има много уникални, а освен това броят им е практически неограничен. Типичен пример – търсени фрази или урли. Търсени фрази, включително заради печатни грешки. Нека видим колко уникални търсени фрази за един ден. Оказва се, че почти половината от всички събития са такива. И в този случай може да помислите, че трябва да нормализирате данните, да броите идентификатори, да ги складирате в отделна таблица. Но не е нужно да правите така. Проста съхранявайте тези стрингове каквито са.
По-добре – не изобретявайте нищо, защото ако съхранявате отделно, ще трябва да направите join. А този join – в най-добрия случай е произволен достъп до паметта, ако изобщо влезе в паметта. Ако не влезе, ще имате проблеми.
Ако данните се съхраняват в in place, те просто се четат в необходимия ред от файловата система и всичко е наред.
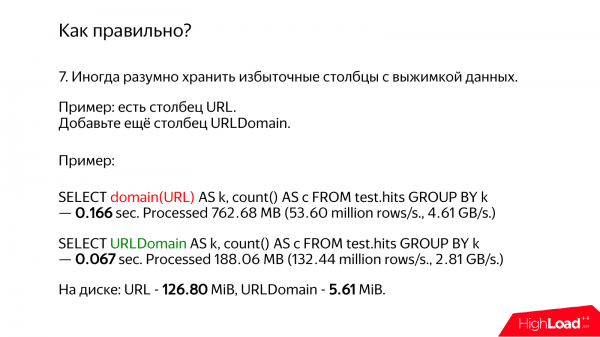
Ако имате урли или друга сложна дълга стринг, струва си да помислите за изчисляване на някакъв хеш предварително и записването му в отделна колона.
За урлите, например, можете да съхранявате домейна отделно. И ако наистина ви трябва домейнът, просто използвайте тази колона, а урлите ще остават без да ги докосвате.
Нека видим каква е разликата. В ClickHouse има специализирана функция, която изчислява домейна. Тя е много бърза, ние я оптимизирахме. И, честно казано, дори не отговаря на RFC, но въпреки това изчислява всичко, което ни трябва.
В един случай просто ще извлечем URL адресите и ще изчислим домейна. Получава се 166 милисекунди. А ако вземем готов домейн, то резултатът е само 67 милисекунди, т.е. почти три пъти по-бързо. И то не заради изчисленията, а защото четем по-малко данни.
Защо при един запит, който е по-бавен, се получава по-голяма скорост на гигабайти в секунда? Защото чете повече гигабайти. Това са напълно излишни данни. Запитването работи по-бързо, но отнема повече време.
Ако погледнем обема на данните на диска, URL адресът е 126 мегабайта, а домейнът само 5 мегабайта. Получава се 25 пъти по-малко. Но запитването изпълнява се само 4 пъти по-бързо. Причината е, че данните са горещи. Ако бяха студени, вероятно щеше да е 25 пъти по-бързо заради дисковия вход-изход.
Между другото, ако оценим колко по-малък е домейнът в сравнение с URL адреса, се получава около 4 пъти. Но защо данните на диска заемат 25 пъти по-малко? Заради компресията. И URL се компресира, и домейнът се компресира. Но често URL адресите съдържат много ненужни данни.
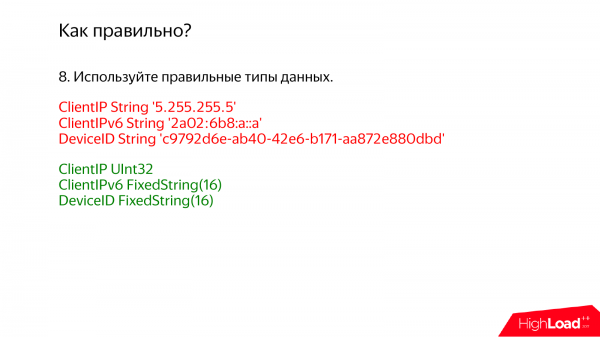
Разбира се, важно е да се използват правилните типове данни, предназначени специално за нужните стойности. Ако имате IPv4, съхранявайте в UInt32*. Ако е IPv6, то FixedString(16), защото IPv6 адресът е 128 бита, т.е. съхранявайте го направо в бинарен формат.
А какво да правим, ако понякога имате IPv4 адреси, а понякога IPv6? Да, можете да съхранявате и двете. Един стълб за IPv4, друг за IPv6. Разбира се, има вариант IPv4 да се представя в IPv6. Това също ще работи, но ако често се нуждаете именно от IPv4 адреса в запитванията, добре е да го поставите в отделен стълб.
* вече в ClickHouse има отделни типове данни за IPv4 и IPv6, които съхраняват данните толкова ефективно, колкото числа, но ги представят удобно, като низове.
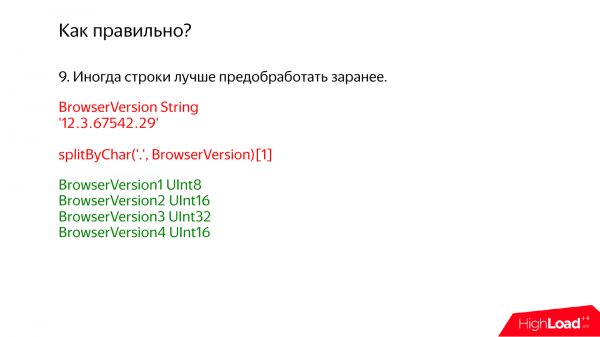
Важно също да се отбележи, че данните трябва да бъдат предварително обработени. Например, ако получите някакви сурови логове, може би е по-добре да не ги вкарвате веднага в ClickHouse, докато няма изкушение просто да не правите нищо и всичко да работи. Но все пак е добре да се проведат изчисленията, които са възможни.
Например, версията на браузъра. В съседния отдел, който не искам да посочвам с пръст, те съхраняват версията на браузъра така, т. е. като низ: 12.3. А после, за да направят отчет, вземат този низ, разделят го на масив и след това на първия елемент от масива. Естествено, всичко се забавя. Попитах ги защо го правят така. Те ми отговориха, че не обичат преждевременна оптимизация. Аз пък не харесвам преждевременна песимизация.
Така че в този случай е по-правилно да се раздели на 4 колони. Не се страхувайте, защото това е ClickHouse. ClickHouse е колонообразна база данни. И колкото повече аккуратни малки колони, толкова по-добре. Имате 5 BrowserVersion, направете 5 колони. Това е нормално.
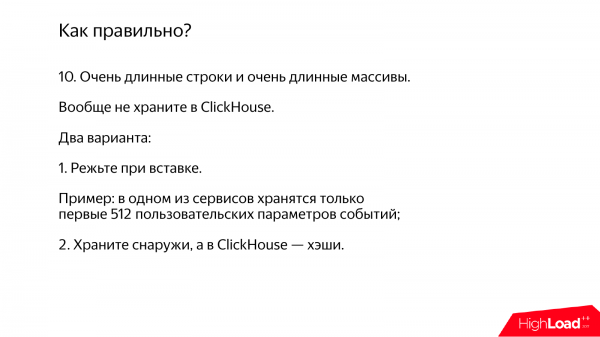
Сега да разгледаме какво да правите, ако имате много много дълги низове и масиви. Не е нужно да ги съхранявате в ClickHouse изобщо. Вместо това можете да запазите само някакъв идентификатор в ClickHouse. А дългите низове изпратете в друга система.
Например, в една от нашите аналитични услуги има определени параметри на събития. И ако за събитията идват много параметри, ние просто съхраняваме първите 512, които се появят. Защото 512 — не е жалко.
Ако не можете да определите типовете данни, можете също да запишете данните в ClickHouse, но в временна таблица от тип Log, специална за временни данни. След това можете да анализирате какво разпределение на стойностите имате там, какво всъщност съществува и да съставите правилни типове.
* в момента в ClickHouse има тип данни който позволява ефективно съхранение на низове с по-малко разходи на ресурси.
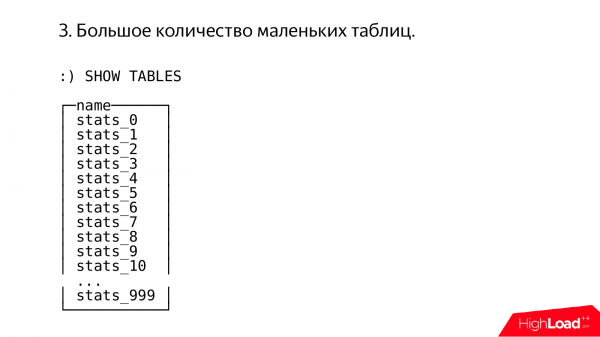
Сега да разгледаме един интересен случай. Понякога при хората всичко работи по странен начин. Влизам и виждам такова нещо. И веднага ми изглежда, че е направено от някакъв много опитен, умен администратор, който има голям опит с настройка на MySQL версия 3.23.
Тук виждаме хиляди таблици, в които е записан остатъка от делението на неясно какво на хиляда.
В принципе, уважавам чуждия опит, включително разбирам какви страдания биха могли да бъдат натрупани с този опит.
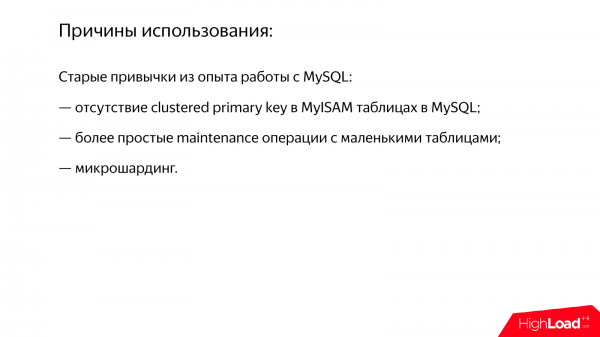
Причините са повече-мене разбираеми. Това са стари стереотипи, които могат да са се натрупали при работа с други системи. Например, в MyISAM таблиците няма клъстерен първичен ключ. Такъв начин на разделение на данни може да бъде отчаяна опитност да се получи същата функционалност.
Друга причина е, че операции като alter върху големи таблици е трудно да се изпълнят. Всичко ще бъде блокирано. Въпреки че в съвременните версии на MySQL този проблем вече не е толкова сериозен.
Или, например, микрошардирование, но за това по-късно.
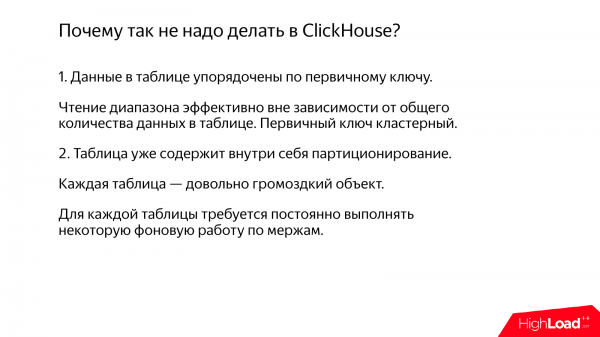
В ClickHouse това не е необходимо, защото, от една страна, първичният ключ е клъстерен, а данните са подредени по първичния ключ.
И понякога ме питат: "Как се променя производителността на диапазонните запитвания в ClickHouse в зависимост от размера на таблицата?". Отговарям, че тя не се променя. Например, имате таблица с милиард реда и четете диапазон от един милион реда. Всичко е наред. Ако в таблицата има трилион реда и четете един милион реда, почти ще бъде същото.
И, от второ, не са необходими неща като ръчно партициониране. Ако погледнете какво има във файловата система, ще видите, че таблицата е доста сериозно нещо. И там вътре има нещо като партиции. Т.е. ClickHouse прави всичко вместо вас и не е нужно да страдате.
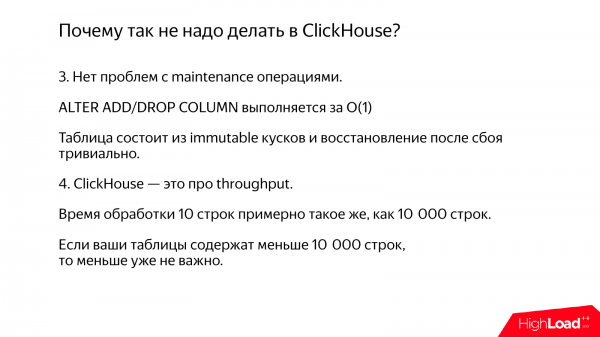
Alter в ClickHouse е безплатен, ако alter add/drop column.
И не е нужно да правите малки таблици, защото ако имате 10 реда или 10 000 реда в таблицата, това е абсолютно неважно. ClickHouse е система, която оптимизира throughput, а не latency, така че обработката на 10 реда няма смисъл.
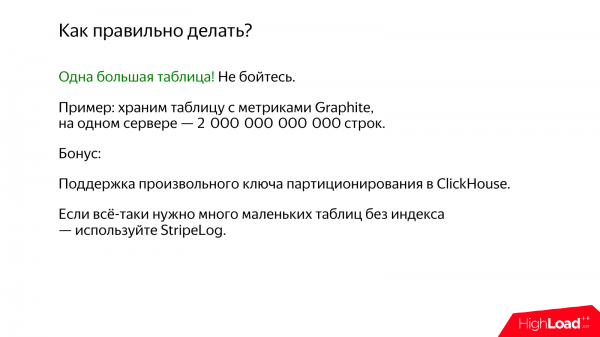
Правилно е да използвате една голяма таблица. Освободете се от старите стереотипи, всичко ще бъде наред.
А като бонус в последната версия се появи възможността да правите произволен ключ за партициониране, за да извършвате всякакви операции за поддръжка над отделни партиции.
Например, ако имате нужда от много малки таблици, например, когато се нуждаете от обработка на определени междинни данни, получавате чанкове и трябва да извършвате преобразувания върху тях, преди да ги запишете в окончателната таблица. За този случай има чудесен механизъм за таблица – StripeLog. Това е нещо подобно на TinyLog, но по-добро.
* в момента в ClickHouse има и .
Друг антипаттерн е микрошардингът. Например, трябва да шардвате данните си и имате 5 сървъра, а утре ще имате 6 сървъра. И си мислите как да преразпределите тези данни. Вместо това, вие ги разделяте не на 5 шарда, а на 1 000 шарда. И след това всеки от тези микрошарди се свързва с отделен сървър. И ще получите например 200 ClickHouse на един сървър. Отделни инстанции на отделни портове или отделни бази данни.
Но в ClickHouse това не е много добре. Защото дори една инстанция на ClickHouse се опитва да използва всички налични ресурси на сървера за обработка на една заявка. Тоест, имате някакъв сървър и там, например, 56 процесорни ядра. Изпълнявате заявка, която трае една секунда, и тя ще използва 56 ядра. А ако сте разположили 200 ClickHouse на един сървър, то ще стартира 10 000 потока. В общи линии, всичко ще бъде много лошо.
Друга причина е, че разпределението на работата между тези инстанции ще бъде неравномерно. Някои ще приключат по-рано, а други – по-късно. Ако всичко това се случваше в една инстанция, ClickHouse сам щеше да се справи с разпределението на данните между потоковете.
И още една причина е, че ще имате междупроцесорна комуникация по TCP. Данните ще трябва да се сериализират, десериализират и това е огромно количество микрошарди. Просто няма да работи ефективно.
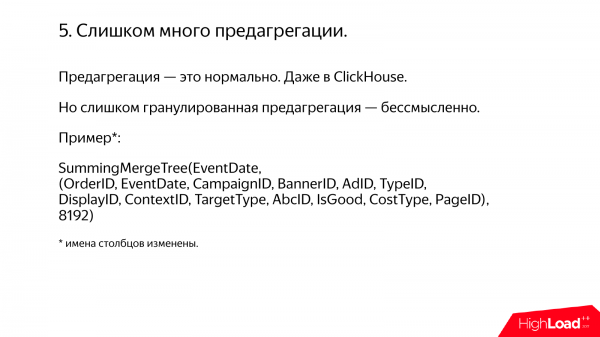
Още един антипаттерн, макар че е трудно да го наречем такъв, е голямо количество предагрегиране.
Всъщност, предагрегирането е положително. Имахте милиард реда, агрегирахте ги и станаха 1 000 реда, а сега заявката се изпълнява мигновено. Всичко е чудесно. Това е напълно възможно. И за това дори в ClickHouse има специален тип таблица AggregatingMergeTree, който извършва инкрементална агрегация при вмъкване на данни.
Но има случаи, в които си мислите, че ще агрегирате данни по този начин и още така ще агрегирате данни. И в съседния отдел, за който не искам да говоря, използват таблици SummingMergeTree за суммиране по първичния ключ, използвайки около 20 различни колонки като първичен ключ. За сигурност промених имената на някои колонки за конспирация, но горе-долу така и е.
И възникват такива проблеми. Първо, обемът на данните ви не намалява особено много. Например, намалява три пъти. Три пъти – това би било добра цена, за да си позволите неограничени възможности за аналитика, които идват, ако данните ви не са агрегирани. Ако данните са агрегирани, то вместо аналитика получавате само жалка статистика.
И какво особено дразни? Това, че хората от съседния отдел идват и понякога искат да добавят още една колона в първичния ключ. Т.е. ние така агрегираме данните, а сега искаме малко повече. Но в ClickHouse няма алтериране на първичен ключ. Затова трябва да пишете някакви скриптове на C++. А аз не харесвам скриптове, дори и да са на C++.
И ако погледнете за какво е създаден ClickHouse, то неагрегирани данни – това е точно сценарият, за който той е роден. Ако използвате ClickHouse за неагрегирани данни, то вие правите всичко правилно. Ако агрегирате, то понякога е простително.
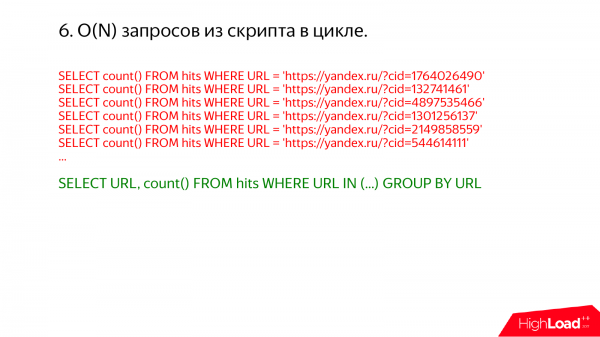
Още един интересен случай – това са заявките в безкраен цикъл. Понякога влизам на някой production сървър и гледам show processlist. И всеки път откривам, че се случва нещо ужасно.
Например, така. Тук веднага е ясно, че всичко е могло да се изпълни в една заявка. Просто пишете там url in и списък.
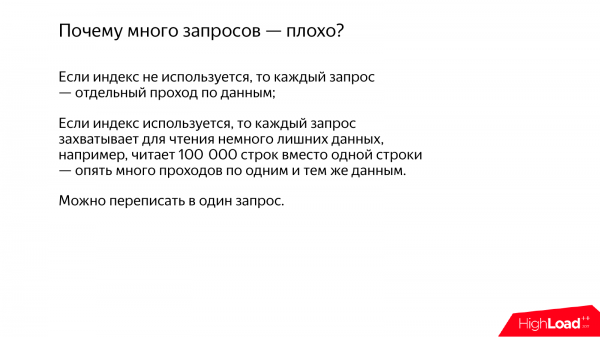
Защо много от такива заявки в безкраен цикъл – това е лошо? Ако индексът не се използва, ще имате много преминавания през едни и същи данни. Но ако индексът се използва, например имате първичен ключ по ru и пишете url = нещо там. И вие мислите, че ще се чете точно от таблицата един url, ще е всичко нормално. Но всъщност не е. Защото ClickHouse всичко прави на пачки.
Когато трябва да прочете определен диапазон от данни, той чете малко повече, защото индексът в ClickHouse е разреден. Този индекс не позволява да се намери в таблицата единствен ред, само определен диапазон. Данните се компресират на блокове. За да прочетете един ред, трябва да вземете целия блок и да го разпаковите. И ако извършвате много заявки, ще имате много припокривания и голямо количество работа, която ще бъде изпълнявана отново и отново.
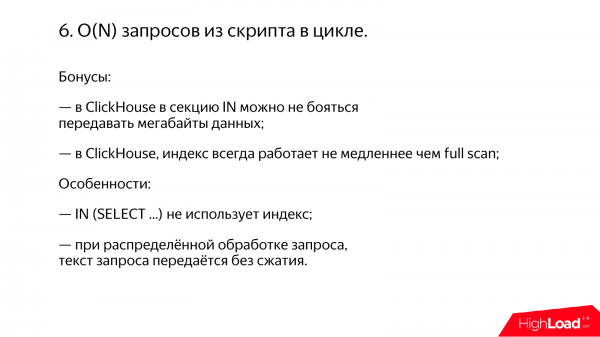
И като бонус може да се забележи, че в ClickHouse не е нужно да се страхувате да подавате дори мегабайти и дори стотици мегабайти в секцията IN. Помня от нашата практика, че ако в MySQL подадем куп стойности в секцията IN, например, 100 мегабайта от числа, то MySQL яде 10 гигабайта памет и повече с това нищо не се случва, всичко работи зле.
А второто е, че в ClickHouse, ако вашите заявки използват индекс, то това винаги не е по-бавно от пълно сканиране, т.е. ако трябва почти да прочетете цялата таблица, той ще върви последователно и ще прочита цялата таблица. В общи линии, той сам ще се справи.
Но все пак има някои трудности. Например, IN с подзаявка не използва индекс. Но това е наш проблем и ние трябва да го поправим. Няма нищо фундаментално тук. Ще го оправим*.
И още нещо интересно – ако имате много дълга заявка и разпределена обработка на заявките, то тази много дълга заявка ще бъде изпратена на всеки сървър без компресия. Например, 100 мегабайта и 500 сървъра. И, съответно, по мрежата ще бъде предадено 50 гигабайта. Ще бъде предадено и след това всичко успешно ще бъде изпълнено.
* вече използва; всичко е оправено, както е обещано.
И доста често срещан случай е, ако заявките идват от API. Например, направили сте свой собствен сервиз. И ако вашият сервиз е необходим на някого, то сте отворили API и буквално след два дни виждате, че се случва нещо неразбираемо. Всичко е пренатоварено и идват ужасни заявки, които никога не трябваше да бъдат.
И решението тук е едно. Ако сте отворили API, ще трябва да го нарежете. Например, да въведете квоти. Няма други нормални варианти. В противен случай веднага ще напишат скрипт и ще имате проблеми.
В ClickHouse съществува специална възможност – това е броенето на квоти. Можете да предавате своя ключ за квота, например, вътрешен идентификатор на потребителя. Квотите ще се броят независимо за всеки от тях.
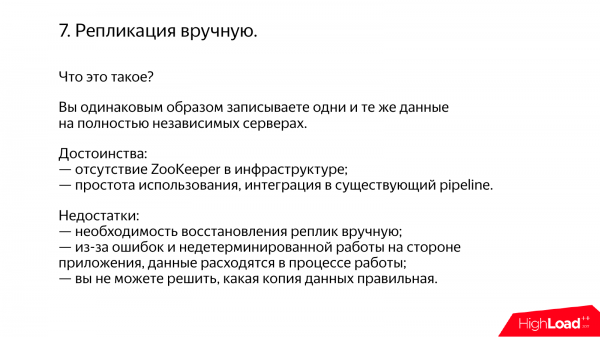
Сега и още нещо интересно. Това е репликацията с ръчно управление.
Знам много случаи, когато, въпреки че ClickHouse предлага вградена поддръжка за репликация, хората репликират ClickHouse ръчно.
Какъв е принципът? Имате pipeline за обработка на данни. И той работи независимо, например, в различни дата центрове. Записвате едни и същи данни по един и същи начин в ClickHouse. Въпреки това, практиката показва, че данните все пак ще се различават поради някои особености във вашия код. Надявам се, че е така и при вас.
И периодично ще трябва ръчно да синхронизирате. Например, веднъж в месеца администраторите правят rsync.
Наистина е много по-лесно да се използва вградената репликация в ClickHouse. Но тук могат да има някои противопоказания, защото за това е необходимо да използвате ZooKeeper. Няма да кажа нищо лошо за ZooKeeper, принципно, системата е работеща, но понякога хората не я използват заради java-фобия, защото ClickHouse е такава добра система, написана на C++, която може да се ползва и всичко да е отлично. А ZooKeeper е на java. И даже не искате да погледнете, но можете да използвате репликацията с ръчно управление.
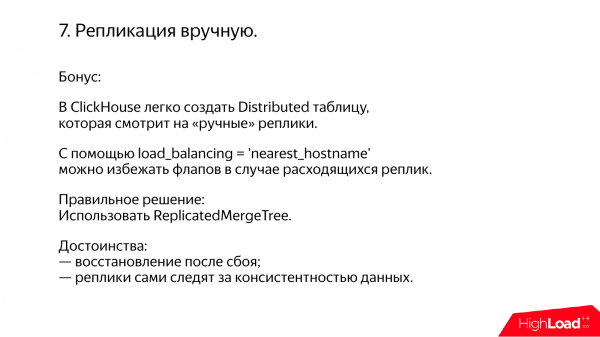
ClickHouse е практична система. Тя взема под внимание вашите нужди. Ако имате репликация с ръчно управление, можете да създадете Distributed таблица, която да гледа на вашите ръчни реплики и сама да прави failover между тях. И дори има специална опция, която позволява да се избегнат флаповете, дори ако вашите реплики систематично се различават.
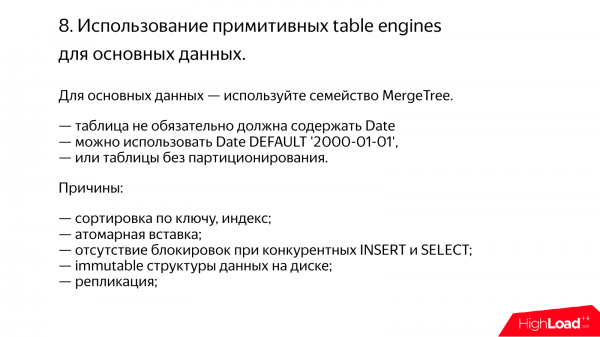
След това могат да възникнат проблеми, ако използвате примитивни table engines. ClickHouse е такъв конструктор, в който има множество различни таблични двигатели. За всички сериозни случаи, както е написано в документацията, използвайте таблици от семейството MergeTree. А всички останали – те са просто за конкретни случаи или за тестове.
В таблицата MergeTree не е задължително да имате дата и час. Все пак можете да използвате. Ако няма дата и час, укажите, че по подразбиране е 2000 година. Това ще работи и няма да изисква ресурси.
И в новата версия на сървъра можете дори да зададете, че искате персонализирано разпределение без ключ за разпределение. Това ще бъде същото.
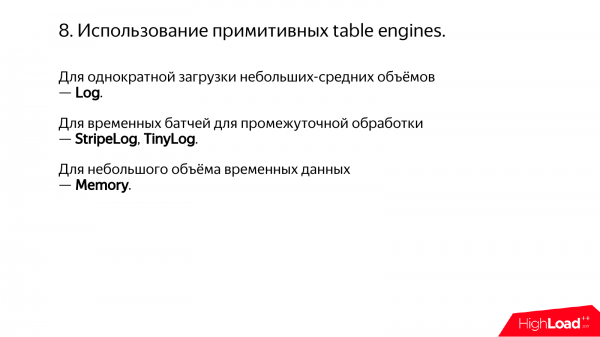
От друга страна, можете да използвате примитивни таблични двигатели. Например, да заредите данни веднъж и да видите, да ги обработите и изтриете. Можете да използвате Log.
Или да съхранявате малки обеми за междинна обработка – това е StripeLog или TinyLog.
Memory може да се използва, ако имате малък обем данни и просто искате да обработите нещо в оперативната памет.
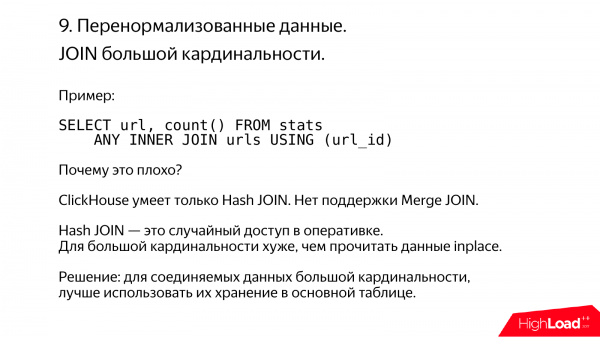
ClickHouse не обича много нормализирани данни.
Ето един типичен пример. Това е огромно количество URL адреси. Вие ги поставихте в съседна таблица. А след това решихте да правите JOIN с тях, но това не работи обикновено, защото ClickHouse поддържа само Hash JOIN. Ако оперативната памет не е достатъчна за множеството данни, с които трябва да се свържете, JOIN не може да бъде извършен.
Ако данните са с голяма кардиналност, тогава не се притеснявайте, съхранявайте ги в денормализиран вид, URL адресите директно в основната таблица.
* а сега в ClickHouse вече има и merge join и той работи в условия, при които междинните данни не се побират в оперативната памет. Но това не е ефективно и препоръката остава в сила.
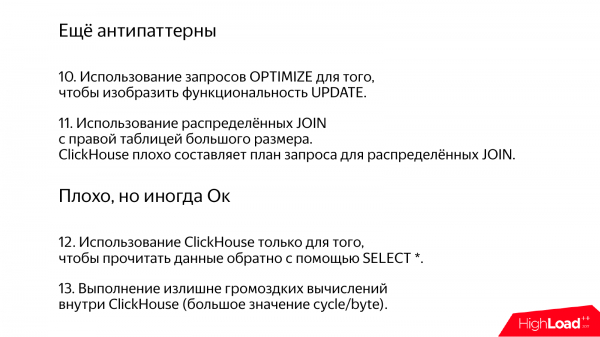
Още няколко примера, но вече се съмнявам дали са антипатерни или не.
В ClickHouse има един известен недостатък. Той не поддържа актуализации*. В известен смисъл това е дори добре. Ако имате важни данни, например, счетоводство, никой не може да ги изпрати, защото актуализации няма.
* поддръжката за актуализации и изтривания в режим на партиди е добавена отдавна.
Но има някои специални методи, които позволяват актуализации в определен смисъл на фона. Например, таблици от тип ReplaceMergeTree. Те правят актуализации по време на фонови обединения. Можете да го принудите с командата optimize table. Но не го правете твърде често, защото това ще доведе до пълно перезаписване на партицията.
Разпределените JOIN в ClickHouse също не се обработват добре от планировчика на запитвания.
Лошо е, но понякога е Oк.
Използването на ClickHouse само за да прочетете данни обратно с помощта на select*.
Не бих препоръчал да се използва ClickHouse за обемни изчисления. Но не е съвсем така, защото вече се отказваме от тази препоръка. Също така наскоро добавихме възможността да прилагаме модели на машинно обучение в ClickHouse – Catboost. И това ме притеснява, защото си мисля: „Какъв ужас. Колко тактове на байт излиза!“. Много ми е жал за тактовете, които се превръщат в байтове.
Но не се страхувайте, инсталирайте ClickHouse, всичко ще бъде наред. Ако имате проблеми, можете поне да се присъедините към нашия чат и се надявам, че ще ви помогнат.
Въпроси
Благодаря за доклада! Къде да се оплача от паднал ClickHouse?
Можете да се оплаквате лично на мен точно сега.
Наскоро започнах да използвам ClickHouse. Веднага падна cli интерфейсът.
Имаш късмет.
По-късно паднах и сървъра с малък select.
Имаш талант.
Създадох бъг в GitHub, но го игнорираха.
Да видим.
Алексей ме привлече на доклада с измама, обещавайки да обясни как компресирате данните вътре.
Много просто.
Това осъзнах вчера. Повече конкретика.
Няма никакви ужасни трикове. Просто има компресия по блокове. По подразбиране се използва LZ4, може да се активира ZSTD*. Блоковете са от 64 килобайта до 1 мегабайт.
* Има и поддръжка на специализирани кодеци за компресия, които могат да се използват в комбинация с други алгоритми.
В блоковете просто сурови данни ли са?
Не съвсем сурови. Има масиви. Ако колоната е числова, числата са подредени последователно в масив.
Разбираемо.
Алексей, примерът с uniqExact над айпишките, т. е. че uniqExact за редовете се изчислява по-дълго от числата и така нататък. А ако приложим финт и кастим в момента на прочита? Т. е. вие, както казахте, че на диска не се различава съществено. Ако четем от диска редове и кастим, тогава по-бързо ли ще имаме агрегати или не? Или все пак няма да спечелим съществено тук? Мисля, че сте тествали, но по някаква причина не го споменахте в бенчмарка.
Мисля, че ще бъде по-бавно, отколкото без каст. В такъв случай IP адресът трябва да бъде парснат от реда. При нас, разбира се, парсирането на IP адреси в ClickHouse също е оптимизирано. Наистина се постарахме, но там имате числа записани в десетично разширение. Много неудобно. От друга страна, функцията uniqExact ще работи по-бавно със строки не само защото са строки, но и защото се избира друга специализация на алгоритъма. Строките просто се обработват по различен начин.
А ако вземем по-примитивен тип данни? Например, записали user id, който пуснахме, записахме го в ред, а след това го кастнахме, ще бъде по-забавно или не?
Съмнявам се. Мисля, че ще бъде дори по-тъжно, тъй като парсирането на числа е сериозен проблем. Мисля, че този колега е имал дори доклад на тема как е трудно да се парсират числа в десетично разширение, а може би не.
Алексей, благодаря много за доклада! И също така, благодаря за ClickHouse! Имам въпрос относно плановете. Има ли планове за функция за частичен ъпдейт на речниците?
Т.е. частично презареждане?
Да-да. Нещо като възможност да зададете поле MySQL, т.е. да ъпдейтвате след, така че да се зареждат само тези данни, ако речникът е много голям.
Много интересна функция. И, мисля, някой човек я предложи в нашия чат. Може би дори бяхте вие.
Не мисля, че аз.
Отлично, сега имаме два запитвания. И можете да започнете да работите спокойно. Но веднага искам да ви предупредя, че тази функция е относително проста за реализация. Т.е. по идея просто трябва да напишете номер на версия в таблицата и след това да пишете: версията е по-малко от такава. А това означава, че най-вероятно ще предложим да го направим на ентусиастите. Вие ентусиаст ли сте?
Да, но, за съжаление, не в C++.
Вашите колеги умеят ли да пишат на C++?
Ще намеря някого.
Отлично*.
* възможността беше добавена два месеца след доклада – разработена е от автора на въпроса и той я е изпратил. .
Благодаря!
Здравейте! Благодаря за доклада! Споменахте, че ClickHouse много добре използва всички налични ресурси. А лекторът, който беше до вас, разказваше за решението си за Пощата на Русия. Той каза, че много са харесали ClickHouse, но не са го използвали вместо основния си конкурент точно поради факта, че е изяждал целия процесор. И не са успели да го впишат в архитектурата си, в своя ZooKeeper с докери. Има ли начин да се ограничи ClickHouse, за да не изразходва всичко, което му става налично?
Да, може и много лесно. Ако искате да използва по-малко ядра, просто напишете set max_threads = 1. И всичко, ще изпълнява запитването на едно ядро. Можете също така да зададете различна настройка за различни потребители. Така че няма проблеми. И предайте на колегите от Люксофт, че не е хубаво, че не са намерили тази настройка в документацията.
Алексей, здравейте! Искам да задам един въпрос. Вече не за първи път чувам, че много хора започват да използват ClickHouse като хранилище за логове. На доклада говорихте, че това не трябва да се прави, т.е. не е нужно да се съхраняват дълги редове. Какво мислите за това?
На първо място, логовете обикновено не са дълги редове. Разбира се, има изключения. Например, някакъв сервис, написан на java, извършва exception, той се лога. И така в безкраен цикъл, и свършва мястото на твърдия диск. Решението е много просто. Ако редовете са много дълги, просто ги реже. А какво означава дълги? Десетки килобайта – това е лошо.
* В новите версии на ClickHouse е включена "адаптивната гранулираност на индекса", което в значителна степен решава проблема с съхранението на дълги редове.
А килобайт – нормално ли е?
Нормално е.
Здравейте! Благодаря за доклада! Вече питах за това в чата, но не помня дали получих отговор. Планира ли се разширяване на секцията WITH по подобие на CTE?
Засега не. Секцията WITH за нас е малко несериозна. Тя е като малка функция.
Разбрах. Благодаря!
Благодаря за доклада! Много интересно! Глобален въпрос. Планира ли се да се направи, може би, в вид на някакви заместващи операции за изтриване на данни?
Задължително. Това е първата ни задача в нашия списък. Сега активно обмисляме как да направим всичко правилно. И е време да започнем да натискаме клавиатурата.
* натискаха бутоните на клавиатурата и всичко направиха.
Ще повлияе ли това по някакъв начин на производителността на системата или не? Вмъкването ще бъде толкова бързо, колкото е и в момента?
Възможно е самите изтривания и актуализации да бъдат много тежки, но затова това нито по какъв начин не повлиява на производителността на изборите и производителността на вмъкванията.
И още един малък въпрос. На презентацията говорихте за първичен ключ. Съответно, ние имаме партициониране, което по подразбиране е месечно, нали? И когато задаваме диапазон от дати, който попада в месеца, съответно четем само тази партиция, така ли?
Да.
Такъв въпрос. Ако не можем да посочим някакъв първичен ключ, правилно ли е да го правим точно по полето 'Дата', за да намалим по-благоприятно пренареждането на тези данни, за да бъдат по-подредени? Ако нямате диапазонни заявки и дори не можете да изберете никакъв първичен ключ, струва ли си да добавите датата в първичния ключ?
Да.
Може би има смисъл да поставим в първичния ключ такова поле, по което данните ще се компресират по-добре, ако са сортирани по това поле. Например, идентификатор на потребителя. Потребителят, например, посещава един и същ сайт. В този случай добавяте идентификатора на потребителя и времето. И така данните ви ще се компресират по-добре. Що се отнася до датата, ако наистина нямате и никога не имате диапазонни заявки по дати, няма нужда от добавяне на датата в първичния ключ.
Добре, много благодаря!
Източник: habr.com
