

Търсенето на функционални зависимости в данни се прилага в различни направления на анализа на данни: управление на бази данни, почистване на данни, реверс инжинеринг на бази данни и експлорация на данни. Вече публикувахме на Анастасия Бирилло и Никита Бобров. Този път Анастасия — завършила Computer Science Center тази година — споделя развитието на тази работа в рамките на НИР, която защити в центъра.
Избор на задача
По време на обучението си в CS центъра започнах да изучавам задълбочено бази данни, а именно, търсене на функционални и разностни зависимости. Темата беше свързана с темата на моята курсова работа в университета, така че по време на работата над курсовата започнах да чета статии за различни зависимости в бази данни. Написах обзор на тази област — една от първите ми на английски език и я подадох на конференция SEIM-2017. Бях много радостна, когато разбрах, че я приеха, и реших да задълбоча темата. Самата концепция не е нова — започнаха да я прилагат още през 90-те години, но и сега намира приложение в много области.
През втория семестър на обучението в центъра започнах научноизследователски проект за подобряване на алгоритмите за търсене на функционални зависимости. Работих над него заедно с аспиранта от СПбГУ Никита Бобров на базата на JetBrains Research.
Изчислителна трудоемкост на търсене на функционални зависимости
Основният проблем — изчислителната трудоемкост. Броят на възможните минимални и нетривиални зависимости е ограничен отгоре с максималната стойност  , където
 — броят на атрибутите на таблицата. Времето за работа на алгоритмите зависи не само от броя атрибути, но и от броя редове. През 90-те години алгоритмите за търсене на ФЗ на обикновен настолен ПК можеха да обработват набори от данни, съдържащи до 20 атрибута и десетки хиляди редове, за няколко часа. Съвременните алгоритми, работещи на многоядрени процесори, откриват зависимости за набори от данни, състоящи се от стотици атрибути (до 200) и стотици хиляди редове, горе-долу за същото време. Въпреки това, това не е достатъчно: такова време е неприемливо за повечето реални приложения. Затова разработвахме подходи за ускоряване на съществуващите алгоритми.
Схеми за кеширане при пресичане на партиции
В първата част на работата разработихме схеми за кеширане за клас алгоритми, използващи метода на пресичане на партиции. Партицията за атрибут представлява набор от списъци, където всеки списък съдържа номера на редове с еднакви стойности за дадения атрибут. Всеки такъв списък се нарича кластер. Много съвременни алгоритми използват партиции за определяне на това дали зависимостта се запазва или не, а именно се придържат към лемата: Зависимостта  се запазва, ако
 . Тук
 се обозначава партицията и се използва понятието размер на партицията — брой на кластерите в нея. Алгоритмите, използващи партиции, при нарушаване на зависимостта добавят допълнителни атрибути в лявата част на зависимостта, след което я преизчисляват, извършвайки операция по пресичане на партиции. Тази операция в статии се нарича специализация. Но забелязахме, че партициите за зависимостите, които ще се запазят само след няколко кръга специализация, могат да бъдат активно повторно използвани, което може значително да съкрати времето за работа на алгоритмите, тъй като операцията по пресичане е скъпа.
Поради това предложихме хевристика, базирана на ентропията на Шенън и несигурността на Джини, както и на нашата метрика, която нарекохме Обратна Ентропия. Тя е незначителна модификация на ентропията на Шенън и расте с увеличаването на уникалността на набора от данни. Предложената хевристика изглежда по следния начин:

Тук  — степен на уникалност на наскоро изчислената партиция
 , а
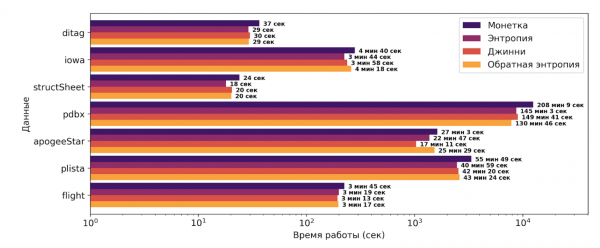
 е медианна степен на уникалност за отделни атрибути. Изпробвани са всичките три метрики, описани по-горе, като метрика за уникалност. Може да се отбележи, че в хевристиката присъстват два модификатора. Първият указва колко близка е текущата партиция до основния ключ и позволява в по-голяма степен кеширането на тези партиции, които са далеч от потенциалния ключ. Вторият модификатор позволява проследяване на заетостта на кеша и по този начин стимулира добавянето на повече партиции в кеша при наличие на свободно място. Успешното решаване на тази задача позволи ускоряване на алгоритъма PYRO с 10-40%, в зависимост от набора данни. Струва си да се отбележи, че алгоритъмът PYRO е най-успешен в тази област.
На изображението по-долу могат да се видят резултатите от прилагането на предложената хевристика в сравнение с основния подход за кеширане, основан на хвърляне на монета. Оста X е логаритмична.
Алтернативен метод за съхранение на партиции
След това предложихме алтернативен метод за съхранение на партиции. Партициите представляват набор от клъстери, в които се съхраняват номера на кортежи със същите стойности за определени атрибути. Тези клъстери могат да съдържат дълги последователности от номера на кортежи, например, когато данните в таблицата са подредени. Затова предложихме схема за компресиране за съхранение на партиции, а именно интервално съхранение на стойности в клъстерите на партициите:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Първи~интервал}, underbrace{7, 8}_{Втори~интервал}, 10}}\ downarrow{Компресия}\ pi(X) = {{underbrace{$, 1, 5}_{Първи~интервал}, underbrace{7, 8}_{Втори~интервал}, 10}}$$display$$
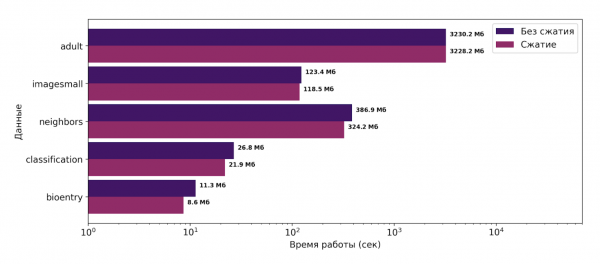
Този метод успя да намали потреблението на памет по време на работа на алгоритъма TANE с 1 до 25%. Алгоритъмът TANE е класически алгоритъм за откриване на функционални зависимости, който използва партиции в хода на своята работа. В рамките на практиката беше избран именно алгоритъмът TANE, тъй като внедряването на интервално съхранение в него беше значително по-лесно, отколкото например в PYRO, за да се оцени дали предложеното решение работи. Получените резултати са представени на изображението по-долу. Оста X е логаритмична.
Конференция ADBIS-2019
На основата на изследване през септември 2019 г. представих статия на конференция 23-то Европейско конференция по напредъци в базите данни и информационните системи (ADBIS-2019). По време на изказването работата подчерта Bernhard Thalheim, значима личност в областта на базите данни. Резултатите от изследванията легнаха в основата на моята дисертация в магистратурата по математическа механика в СПбГУ, в хода на която двата предложени подхода (кеширане и компресия) бяха внедрени в двата алгоритъма: TANE и PYRO. При това резултатите показаха, че предложените подходи са универсални, тъй като при двата алгоритъма и двата подхода се наблюдава значително намаляване на потреблението на памет, както и значително намаляване на времето за работа на алгоритмите.
Източник: habr.com
