

Здравейте на всички. Разработваме продукт за анализ на офлайн трафик. В проекта има задача, свързана със статистически анализ на пътищата на движение на посетителите през различните области.
В рамките на тази задача потребителите могат да задават системата запитвания от следния вид:
- колко посетители преминаха от област "A" в област "B";
- колко посетители преминаха от област "A" в област "B" през област "C" и след това през област "D";
- колко време е отнело преминаването на определен тип посетител от област "A" в област "B."
и още редица подобни аналитични запитвания.
Движението на посетителите през областите представлява насочена графа. След като прочетох в интернет, установих, че графовите СУБД се използват и за аналитични отчети. Исках да видя как графовите СУБД ще се справят с подобни запитвания (TL;DR; лошо).
Избрах за използване СУБД , като изключителен представител на графовите open-source СУБД, която се основава на стек от зрели технологии, които (по мое мнение) би трябвало да осигурят прилични оперативни характеристики:
- бекенд хранилище BerkeleyDB, Apache Cassandra, Scylla;
- сложни индекси могат да се съхраняват в Lucene, Elasticsearch, Solr.
Авторите на JanusGraph пишат, че тя е подходяща както за OLTP, така и за OLAP.
Работил съм с BerkeleyDB, Apache Cassandra, Scylla и ES, освен това тези продукти често се използват в нашите системи, затова с оптимизъм гледах на тестването на тази графова СУБД. Странен ми се стори изборът на BerkeleyDB, а не на RocksDB, но вероятно това е свързано с изискванията за транзакции. Във всеки случай, за мащабируемо, продуктовото използване се предлага бекенд на Cassandra или Scylla.
Не разглеждах Neo4j, тъй като кластеризацията изисква комерсиална версия, тоест продуктът не е отворен.
Графовите СУБД казват: "Ако нещо изглежда като граф — обработвайте го като граф!" — красота!
Първо нарисувах граф, който е точно по каноните на графовите СУБД:
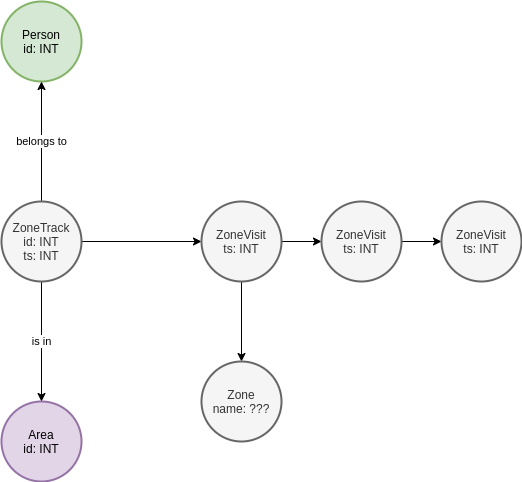
Има сущност Zone, отговаряща за областта. Ако ZoneStep принадлежи на тази Zone, то той й прави референция. На сущностите Area, ZoneTrack, Person не обръщайте внимание, те принадлежат на домейна и не се разглеждат в рамките на теста. В крайна сметка, за такава графова структура запитването за търсене на вериги би изглеждало така:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
На български това звучи така: намери Zone с ID=0, вземи всички върхове, от които излиза ребро (ZoneStep), продължи без да се връщаш обратно, докато не намериш такива ZoneStep, от които излиза ребро в Zone с ID=19, брои броя на такива вериги.
Не претендирам да знам всички тънкости на търсенето в графи, но този запитване бе генерирано на основата на тази книга ().
Качих 50 хиляди трака с дължина от 3 до 20 точки в графовата база JanusGraph, използваща бекенд BerkeleyDB, създадох индекси според .
Скрипт за натоварване на Python:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
Използваше се VM с 4 ядра и 16 GB RAM на SSD. JanusGraph беше разположен с командата:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestВ този случай данните и индексите, които се използват за търсене по точно съвпадение, се съхраняват в BerkeleyDB. След изпълнение на запитването, посочено по-горе, получих време равно на няколко десетки секунди.
Пуснатите 4 гореспоменати скрипта паралелно, успях да превърна СУБД в тиква с весел поток от стек трайсове на Java (а ние всички обичаме да четем стек трайсове на Java) в логовете на Docker.
Размишлявайки, реших да опростя схемата на графа до следното:
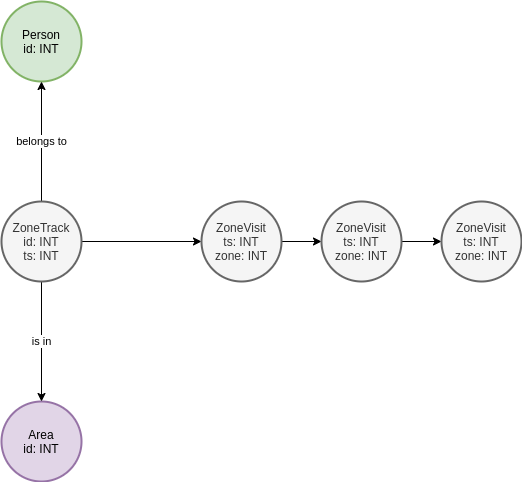
Реших, че търсенето по атрибутите на ентитета ще бъде по-бързо от търсенето по ребрата. В крайна сметка моето запитване стана следното:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()На български това звучи така: намери ZoneStep с ID=0, продължи без да се връщаш обратно, докато не намериш ZoneStep с ID=19, брои броя на такива вериги.
Скриптът за натоварване, посочен по-горе, също опростих, за да не създавам излишни връзки, ограничавайки се до атрибутите.
Запитът все още се извършваше няколко секунди, което беше напълно неприемливо за задачата ни, тъй като за целите на AdHoc запитванията с произволен тип това съвсем не беше подходящо.
Опитах се да стартирам JanusGraph, използвайки Scylla, като най-бързата реализация на Cassandra, но това също не доведе до съществени промени в производителността.
Така че, въпреки че "изглежда като граф", не успях да накарам графовата СУБД да обработи това бързо. Напълно предполагам, че не знам нещо и може да се накара JanusGraph да извършва това търсене за части от секундата, но аз не успях.
Тъй като задачата все пак трябваше да бъде решена, започнах да мисля за JOIN-ове и Pivot таблици, което не вдъхновяваше оптимизъм от гледна точка на елегантност, но можеше да бъде напълно работещ вариант в практиката.
В нашия проект вече се използва Apache ClickHouse, затова реших да проверя моите изследвания на тази аналитична СУБД.
Стартирах ClickHouse с простата рецепта:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Създадох база данни и таблица от вида:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
Запълних я с данни с този скрипт:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Тъй като вставките се извършват на партиди, запълването беше много по-бързо, отколкото за JanusGraph.
Съставих два запитвания с JOIN. За преминаване от точка A до точка Б:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
За преминаване през 3 точки:
ИЗБЕРЕТЕ s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
ИЗ
  (ИЗБРАТЬ s1.person КАТО person,
          s1.zone КАТО s1z,
          s1.when КАТО s1w,
          s2.zone КАТО s2z,
          s2.when КАТО s2w
   ИЗ
     (ИЗБРАТЬ *
      ИЗ steps
      КЪДЕ (area = 0)
        И (zone = 0)) КАТО s1 ПО ВСИЧКИ ВНУШЕНИЯ
     (ИЗБРАТЬ *
      ИЗ steps КАТО s2
      КЪДЕ (area = 0)
        И (zone = 3)) КАТО s2 ИЗПОЛЗВАЙКИ person
   КЪДЕ s1.when <= s2.when) p ПО ВСИЧКИ ВНУШЕНИЯ
  (ИЗБРАТЬ *
   ИЗ steps
   КЪДЕ (area = 0)
     И (zone = 19)) КАТО s3 ИЗПОЛЗВАЙКИ person
КЪДЕ p.s2w <= s3.when
Запитванията, разбира се, изглеждат доста страшно, за реално използване е необходимо да се направи програмна обвързваща генерация. Въпреки това, те работят и работят бързо. И двете запитвания се изпълняват за по-малко от 0.1 сек. Ето пример за времето на изпълнение на запитването за count(*) върху 3 точки:
ИЗБРАТЕ count(*)
ОТ
(
    ИЗБРАТЕ
        s1.person КАТО person,
        s1.zone КАТО s1z,
        s1.when КАТО s1w,
        s2.zone КАТО s2z,
        s2.when КАТО s2w
    ИЗ
    (
        ИЗБРАТЕ *
        ИЗ steps
        КЪДЕ (area = 0) И (zone = 0)
    ) КАТО s1
    ПО ВСИЧКИ ВНУШЕНИЯ
    (
        ИЗБРАТЕ *
        ИЗ steps КАТО s2
        КЪДЕ (area = 0) И (zone = 3)
    ) КАТО s2 ИЗПОЛЗВАЙКИ (person)
    КЪДЕ s1.when <= s2.when
) КАТО p
ПО ВСИЧКИ ВНУШЕНИЯ
(
    ИЗБРАТЕ *
    ИЗ steps
    КЪДЕ (area = 0) И (zone = 19)
) КАТО s3 ИЗПОЛЗВАЙКИ (person)
КЪДЕ p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 реда в набора. Изминало време: 0.068 сек. Обработени 250.03 хиляди реда, 8.00 MB (3.69 милиона реда/с., 117.98 MB/с.)Забележка относно IOPS. При запълване на данни, JanusGraph генерираше доста високо количество IOPS (1000-1300 за четири потока запълване на данни), а IOWAIT беше доста висок. В същото време, ClickHouse генерираше минимално натоварване на дисковата подсистема.
Заключение
Решихме да използваме ClickHouse за обслужване на запитвания от този тип. Винаги можем да оптимизираме запитванията още повече, като използваме материализирани изгледи и паралелизация, изпълнявайки предварителна обработка на потока от събития с Apache Flink преди да ги заредим в ClickHouse.
Производителността е толкова добра, че вероятно дори няма да се наложи да мислим за програмни средства за пивотиране на таблиците. По-рано, се налагаше да правим пивот на данните, извлечени от Vertica, чрез експортиране в Apache Parquet.
За съжаление, поредният опит за използване на графова СУБД не бе успешен. Не намерих, че JanusGraph има приятелска екосистема, която да позволява бързо усвояване на продукта. В същото време, за конфигуриране на сървъра се използва традиционният Java начин, който ще накара хора, непознати с Java, да плачат от страх:
хост: 0.0.0.0
порт: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary е тук, за да замести Gryo и Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo и Graphson, последни версии
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # По-стари версии за сериализация за обратна съвместимост:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Успях случайно да "положа" BerkeleyDB версия JanusGraph.
Документацията е доста неясна по отношение на индексите, тъй като управлението на индексите изисква доста странни практики в Groovy. Например, създаването на индекс трябва да се извърши чрез написването на код в конзолата на Gremlin (което, между другото, не работи по подразбиране). От официалната документация на JanusGraph:
graph.tx().rollback() \/\/ Никога не създавайте нови индекси, докато активна транзакция
mgmt = graph.openManagement()
name = mgmt.getPropertyKey('name')
age = mgmt.getPropertyKey('age')
mgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()
mgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()
mgmt.commit()

\/\/ Изчакайте индексът да стане наличен
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()
\/\/ Преиндикиране на съществуващите данни
mgmt = graph.openManagement()
mgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()
mgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()
mgmt.commit()
Следсловие
В известен смисъл експериментът по-горе е сравнение на невъзможното. Ако се замислите, графовата СУБД извършва различни операции, за да постигне същите резултати. Въпреки това, в рамките на тестовете проведох и експеримент с заявка от тип:
g.V().hasLabel('ZoneStep').has('id',0)
    .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()
което отразява стъпковата наличност. Въпреки това, дори и с такива данни, графовата СУБД показваше резултати, които надхвърляха няколко секунди... Това, разбира се, е свързано с факта, че имаше пътища от вида 0 -> X -> Y ... -> 1, които графовият двигател също проверяваше.
Дори за заявка от вида:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()не успях да получа отговор с време на обработка под секунда.
Моралът на баснята е, че красивата идея и парадигматичното моделиране не водят до желан резултат, който с значително по-висока ефективност се демонстрира на примера на ClickHouse. Примерът в тази статия е явен антипатърн за графови СУБД, въпреки че изглежда подходящ за моделиране в тяхната парадигма.
Източник: habr.com
