

Както е известно, компания SAP предлага оптимален набор софтуер както за обработка на транзакционни данни, така и за тяхната анализа и отчитане. По-специално, платформата SAP Business Warehouse (SAP BW) е инструментариум за съхранение и анализ на данни, предлагащ широки технически възможности. Въпреки своите очевидни предимства, системата SAP BW притежава един значителен недостатък. Това е високата цена за съхранение и обработка на данни, особено забележима при използване на облачната версия SAP BW on Hana.
А какво ако вместо това хранилище използваме някакъв non-SAP и предпочително OpenSource продукт? Ние в Х5 Retail Group избрахме GreenPlum. Това разбира се решава проблема с цената, но веднага възникват въпроси, които при използването на SAP BW практически са решени по подразбиране.
По-специално, как да извлечем данни от източниците, които в повечето случаи са решения на SAP?
Проектът „HR-метрики“ стана първият, в който беше необходимо да решим този проблем. Нашата цел беше създаването на хранилище за HR-данни и изграждането на аналитична отчетност в областта на работата с служителите. Основният източник на данни е транзакционната система SAP HCM, в която се водят всички кадрови, организационни и заплати мероприятия.
Извличане на данни
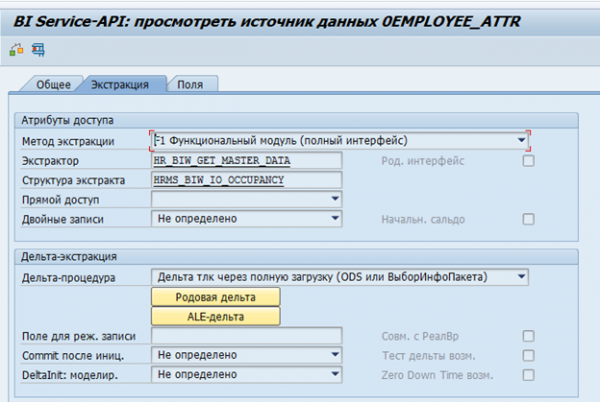
В SAP BW за SAP-системи съществуват стандартни екстрактори за данни. Тези екстрактори могат автоматично да събират необходимите данни, да наблюдават тяхната цялост и да определят дельту на промените. Например, стандартният източник на данни по атрибути на служителя 0EMPLOYEE_ATTR:
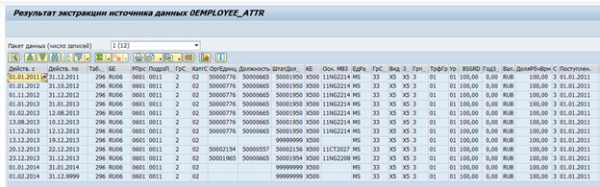
Резултатът от извличането на данни от него за един служител:
При необходимост такъв екстрактор може да бъде модифициран в съответствие със собствени изисквания или може да бъде създаден собствен екстрактор.
Първата идея за възможността за повторно използване на екстракторите. За съжаление, това се оказа неосъществима задача. По-голямата част от логиката е реализирана на страната на SAP BW и безболезнено отделяне на екстрактора на източника от SAP BW не се постигна.
Станало е очевидно, че ще е необходима разработка на собствен механизъм за извличане на данни от SAP системи.
Структура на съхранение на данни в SAP HCM
За да разберем изискванията за такъв механизъм, първо трябва да определим какви данни точно ще ни трябват.
Повечето данни в SAP HCM се съхраняват в плоски SQL таблици. На базата на тези данни приложенията SAP визуализират на потребителите организационни структури, служители и друга HR информация. Например, ето как изглежда организационната структура в SAP HCM:
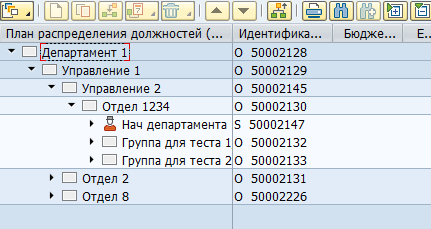
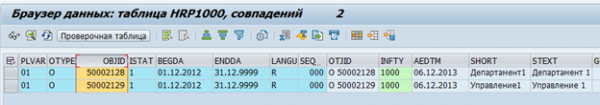
Физически това дърво се съхранява в две таблици — в hrp1000 обекти и в hrp1001 връзки между тези обекти.
Обекти «Департамент 1» и «Управление 1»:
Връзка между обектите:
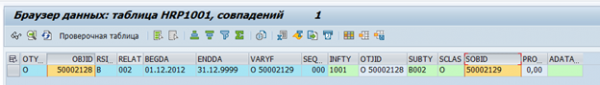
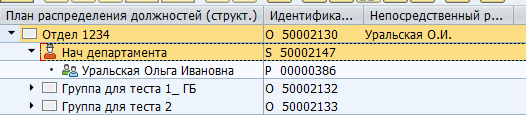
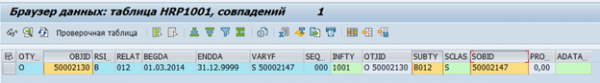
Както типовете обекти, така и типовете връзки между тях могат да бъдат огромно количество. Съществуват както стандартни връзки между обекти, така и персонализирани за специфични нужди. Например, стандартната връзка B012 между организационната единица и щатната позиция указва на ръководителя на подразделение.
Отображение на ръководителя в SAP:
Съхранение в таблицата на БД:
Данните за служителите се съхраняват в таблиците pa*. Например, данните за кадровите мероприятия по служителя се съхраняват в таблицата pa0000.
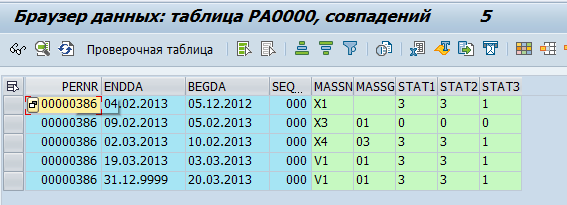
Приехме решение, че GreenPlum ще извлече "сурови" данни, т.е. просто ще ги копира от SAP таблиците. И директно в GreenPlum те ще бъдат обработвани и преобразувани в физически обекти (например, Отдел или Служител) и метрики (например, среднесписъчна численост).
Определени са около 70 таблици, данните от които трябва да бъдат предавани в GreenPlum. След което започнахме работа по метода за предаване на тези данни.
SAP предлага доста голямо количество интеграционни механизми. Но най-простият начин — директния достъп до базата данни е забранен поради лицензионни ограничения. Следователно, всички интеграционни потоци трябва да бъдат реализирани на ниво сървър приложения.
Следващият проблем беше липсата на данни за изтритите записи в БД SAP. При изтриване на ред в БД, той се изтрива физически. Т.е. формирането на делтата на измененията по време на изменение не беше възможно.
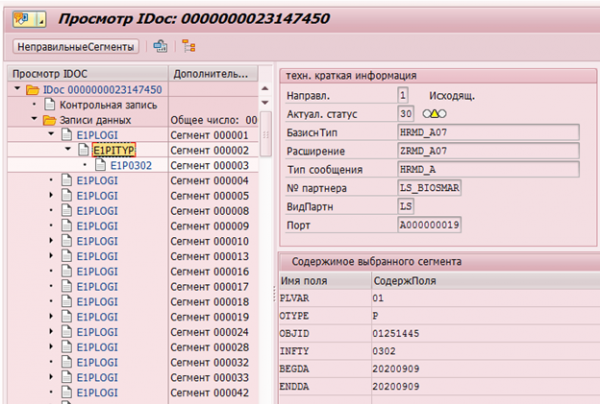
Разбира се, в SAP HCM има механизми за фиксиране на измененията в данните. Например, за последваща предаване в системи получатели съществуват указатели за изменения (change pointer), които фиксират всякакви промени и на базата на които се формирт Idoc (обект за предаване във външни системи).
Пример IDoc изменение на инфотип 0302 за служител с табелен номер 1251445:
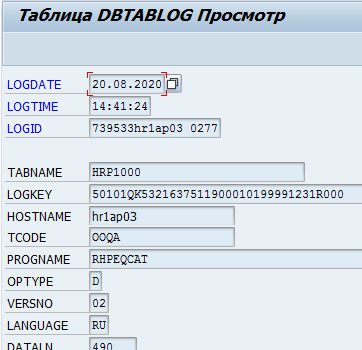
Или водене на логове за изменения в данните в таблицата DBTABLOG.
Пример на лог за изтриване на запис с ключ QK53216375 от таблицата hrp1000:
Но тези механизми не са достъпни за всички необходими данни и тяхната обработка на ниво приложен сървър може да изисква доста много ресурси. Следователно, масовото активиране на логиране за всички необходими таблици може да доведе до забележимо влошаване на производителността на системата.
Следващият сериозен проблем бяха кластерните таблици. Данните за оценка на времето и изчисляването на заплатите в версията RDBMS на SAP HCM се съхраняват под формата на набор от логически таблици за всеки служител за всяко изчисление. Тези логически таблици, представляващи бинарни данни, се съхраняват в таблицата pcl2.
Кластер за изчисляване на заплатата:
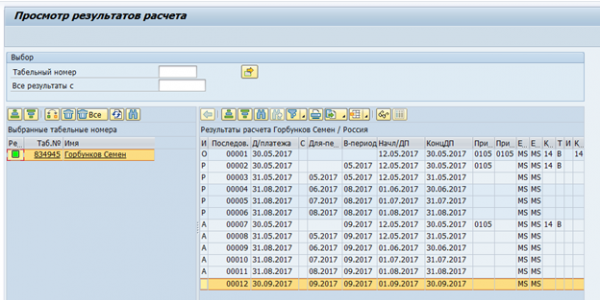
Данните от кластерните таблици не могат да се четат с SQL команда и изискват използването на макрокоманди SAP HCM или специализирани функционални модули. Съответно, скоростта на четене на такива таблици ще бъде доста ниска. От друга страна, в тези клъстери се съхраняват данни, които са необходими само веднъж месечно – окончателното изчисление на заплатата и оценка на времето. Така че скоростта в този случай не е толкова критична.
Оценявайки вариантите за формиране на делта изменения в данните, решихме също да разгледаме варианта с пълно извеждане. Вариантът всеки ден да се предават гигабайти неизменни данни между системите не може да изглежда красиво. Въпреки това има и редица предимства – няма необходимост от реализиране на делтата на страната на источника, както и реализиране на интегрирането на тази делта на страната на получателя. Съответно, намалява се разходите и сроковете за реализиране, и се повишава надеждността на интеграцията. При това бе определено, че практически всички изменения в SAP HR настъпват в диапазона от три месеца преди текущата дата. Следователно, бе взето решение да се спре на ежедневно пълно извеждане на данни от SAP HR за N месеца назад до текущата дата и на ежемесечно пълно извеждане. Параметър N зависи от конкретната таблица
и варира от 1 до 15.
За екстракция на данни бе предложена следната схема:
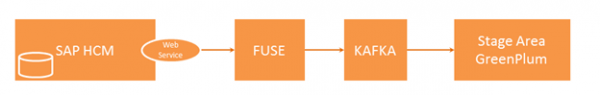
Външната система генерира заявка и я изпраща в SAP HCM, където тази заявка се проверява за пълнота на данните и разрешения за достъп до таблиците. В случай на успешна проверка, в SAP HCM работи програма, която събира необходимите данни и ги предава на интеграционното решение Fuse. Fuse определя необходимата тема в Kafka и предава данните там. След това данните от Kafka се предават в Stage Area GP.
В тази верига ни интересува въпросът за извличането на данни от SAP HCM. Нека се спрем на него по-подробно.
Схема на взаимодействие между SAP HCM и FUSE.
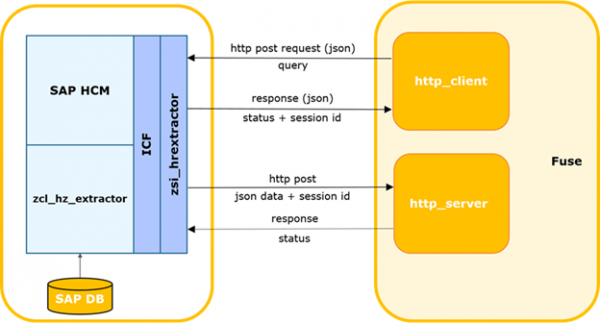
Външната система определя времето на последната успешна заявка към SAP.
Процесът може да бъде стартиран по таймер или друго събитие, включително може да бъде зададен таймаут за изчакване на отговор с данни от SAP и иницииране на повторна заявка. След това се генерира заявка за разлики и тя се изпраща до SAP.
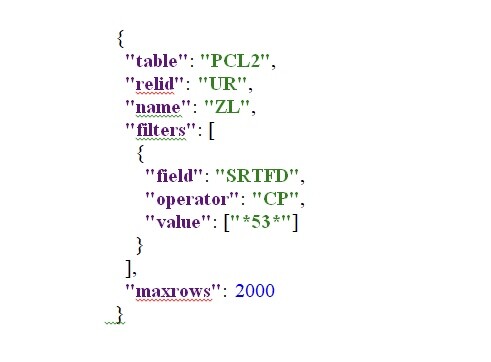
Данните на заявката се предават в body в json формат.
Метод http: POST.
Пример за заявка:
Сервисът SAP извършва контрол на заявката за пълнота, съответствие с текущата структура на SAP и наличие на разрешение за достъп до поисканата таблица.
В случай на грешки, сервисът връща отговор с подходящ код и описание. В случай на успешен контрол, той създава фонов процес за генериране на извлечение, генерира и синхронно връща уникален ID на сесията.
Външната система в случай на грешка я регистрира в журнала. В случай на успешен отговор предава ID на сесията и името на таблицата, по която е направена заявката.
Външната система регистрира текущата сесия като отворена. Ако има други сесии за тази таблица, те се затварят с регистриране на предупреждение в журнала.
Фоновото задание SAP генерира курсор по зададените параметри и пакет данни с определен размер. Размерът на пакета е максималният брой записи, които процесът чете от БД. По подразбиране той е равен на 2000. Ако в избраната БД има повече записи от използвания размер на пакета, след предаването на първия пакет се генерира следващ блок с подходящ offset и увеличен номер на пакета. Номерата се увеличават с 1 и се изпращат строго последователно.
След това SAP изпраща пакета на входа на уеб-сервиса на външната система. А тя изпълнява контролите на входящия пакет. В системата трябва да бъде регистрирана сесия с получения id и тя трябва да е в статус на отворен. Ако номерът на пакета > 1, в системата трябва да бъде регистрирано успешно получаване на предходния пакет (package_id-1).
В случай на успешен контрол външната система парсва и съхранява данните от таблицата.
Допълнително, ако в пакета присъства флаг final и сериализацията е преминала успешно, се изпраща уведомление до модула за интеграция за успешно завършване на обработката на сесията и модулът обновява статуса на сесията.
В случай на грешка при контролите/парсинга, грешката се записва в логовете и пакетите по тази сесия ще бъдат отхвърляни от външната система.
Също така и в обратния случай, когато външната система връща грешка, тя се записва и предаването на пакетите се прекратява.
За заявка на данни от страна на SAP HСM е реализиран интеграционен сервис. Сервисът е реализиран на фреймворка ICF (SAP Internet Communication Framework — ). Той позволява извършване на заявки за данни от системата SAP HCM по определени таблици. При формата на заявката има възможност да се зададат конкретни полета и параметри за филтриране с цел получаване на необходимите данни. При това реализирането на сервиса не предвижда никаква бизнес-логика. Алгоритмите за изчисляване на делтата, параметрите на заявката, контрола на целостта и др. също се реализират на страната на външната система.
Този механизъм позволява събиране и предаване на всички необходими данни за няколко часа. Тази скорост е на границата на приемливото, затова това решение се разглежда от нас като временно, което е закрило нуждата от инструмент за извличане в проекта.
В целевата картина за решаване на задачата за извлечение на данни се проучват вариантите за използване на CDC системи като Oracle Golden Gate или ETL инструменти като SAP DS.
Източник: habr.com
