

В днешно време е невъзможно да си представим проект на базата на Kubernetes без ELK стек, който съхранява логовете както на приложенията, така и на системните компоненти на клъстера. В практиката си използваме EFK стек с Fluentd вместо Logstash.
Fluentd е съвременен универсален колектор на логове, който набира все по-голяма популярност и е част от Cloud Native Computing Foundation, което насочва развитието му към съвместна работа с Kubernetes.
Фактът, че използваме Fluentd вместо Logstash, не променя основната същност на софтуерния комплекс. Въпреки това, Fluentd притежава свои специфични нюанси, произтичащи от многофункционалността си.
Например, започвайки да използваме EFK в натоварен проект с висока интензивност на запис на логове, се сблъскахме с проблема, че в Kibana някои съобщения се показват повторно няколко пъти. В тази статия ще ви разкажем за причините за това явление и как да решим проблема.
Проблема с дублирането на документи
В нашите проекти Fluentd е разположен като DaemonSet (автоматично стартира се в един екземпляр на всеки възел на клъстера Kubernetes) и наблюдава stdout логовете на контейнерите в /var/log/containers. След събиране и обработка логовете в JSON-формат постъпват в ElasticSearch, инсталиран в клъстерен или standalone режим, в зависимост от мащаба на проекта и изискванията за производителност и отказоустойчивост. За графичен интерфейс се използва Kibana.
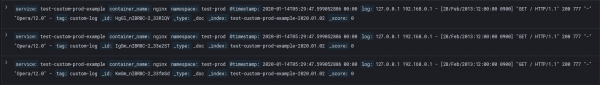
При използването на Fluentd с буферизиращ плъгин на изхода се сблъскахме със ситуация, при която някои документи в ElasticSearch имат напълно идентично съдържание и се различават само по идентификатор. Може да се уверим, че това е повторение на съобщението на примера на лог от Nginx. В лог файла това съобщение съществува в единствен екземпляр:
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Обаче в ElasticSearch съществуват няколко документа, съдържащи това съобщение:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] \"GET \/ HTTP\/1.1\" 200 777 \"-\" \"Opera\/12.0\" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00  0900] \"GET \/ HTTP\/1.1\" 200 777 \"-\" \"Opera\/12.0\" -",
    "tag": "custom-log"
  }
}
Въпреки това, повторенията могат да бъдат повече от две.
По време на диагностицирането на този проблем в логовете на Fluentd може да се наблюдава голям брой предупреждения с следното съдържание:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] не успя да изпрати буфера. retry_time=4 next_retry_seconds=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="не може да изпрати логовете до Elasticsearch клъстер ({:host=>\"elasticsearch\", :port=>9200, :scheme=>\"http\", :user=>\"elastic\", :password=>\"obfuscated\"}): времето за четене е достигнато"Тези предупреждения възникват, когато ElasticSearch не може да върне отговор на заявка в зададения параметър request_timeout, поради което изпратеният фрагмент от буфера не може да бъде изчистен. След това Fluentd опитва да изпрати фрагмента от буфера в ElasticSearch повторно и след произволен брой опити операцията завършва успешно:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] повторението е успешно. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] повторението е успешно. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] повторението е успешно. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] повторението е успешно. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] повторението е успешно. chunk_id="59c37f63a9046e6dff7e9987729be66f"
Въпреки това, ElasticSearch възприема всеки от повторно изпратените фрагменти от буфера като уникален и им присвоява уникални стойности на полета _id при индексиране. Така се появяват дубликати на съобщения.
В Kibana това изглежда така:
Решение на проблема
Съществуват няколко варианта за решаване на този проблем. Един от тях е вградената в плъгина fluent-plugin-elasticsearch механика за генериране на уникален хеш за всеки документ. Ако се използва тази механика, ElasticSearch ще разпознава дубликатите на етапа на предаване и няма да допуска дублиране на документи. Но не може да се пренебрегне, че този начин на решаване на проблема се бори със следствията и не отстранява грешката със забавянето при таймаут, затова решихме да се откажем от него.
Използваме буфериращ плъгин на изхода Fluentd, за да избегнем загубата на логове в случай на краткотрайни мрежови проблеми или увеличаване на интензивността на запис на логове. Ако по някаква причина ElasticSearch не може мигновено да запише документ в индекса, документът попада в опашка, която се съхранява на диска. Следователно, в нашия случай, за да отстраним източника на проблема, който води до възникването на описаната по-горе грешка, е необходимо да зададем правилните стойности на параметрите за буфериране, така че изходният буфер на Fluentd да бъде с достатъчен обем и в същото време да успява да се почиства в зададеното време.
Струва си да се отбележи, че стойностите на параметрите, за които става въпрос по-долу, са индивидуални за всеки конкретен случай на използване на буфериране в изходящите плъгини, тъй като зависят от многобройни фактори: интензивността на записване на лог съобщения от сервисите, производителността на дисковата система, натоварването на мрежовия канал и неговата пропускателна способност. Следователно, за да получим подходящи за всеки отделен случай, но не излишни настройки на буфера, избягвайки дългото пробване на сляпо, можем да се възползваме от отладъчната информация, която Fluentd записва в своя лог по време на работа и сравнително бързо да получим коректни стойности.
В момента на фиксиране на проблема конфигурацията изглеждаше по следния начин:
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
При решаването на проблема ръчно бяха подбрани стойности на следните параметри:
chunk_limit_size — размерът на чанк, на който се разбиват съобщенията в буфера.
- flush_interval — интервал, през който се извършва почистването на буфера.
- queue_limit_length — максималният брой чанков в опашката.
- request_timeout — времето, за което се установява връзка между Fluentd и ElasticSearch.
Общият размер на буфера може да се изчисли чрез умножаване на параметрите queue_limit_length и chunk_limit_size, което може да се тълкува като «максималният брой чанкове в опашката, всеки от които има зададен обем». При недостатъчен размер на буфера в логовете ще се появят следните предупреждения:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] не успя да запише данни в буфера поради препълване на буфера action=:blockТова означава, че буферът не успява да се почисти в зададеното време и данните, които постъпват в запълнения буфер, се блокират, което ще доведе до загуба на част от логовете.
Може да увеличите буфера по два начина: като увеличите размера на всеки чанк в опашката или броя на.chunk, които могат да бъдат в опашката.
Ако зададете размер на чанка chunk_limit_size над 32 мегабайта, ElasticSearch няма да го приеме, тъй като входящият пакет ще бъде твърде голям. Следователно, ако е необходимо да увеличите буфера допълнително, е по-добре да увеличите максималната дължина на опашката queue_limit_length.
Когато буферът спре да се препълва и остане само съобщение за липса на тайм-аут, можете да започнете да увеличавате параметъра request_timeout. Въпреки това, при задаване на стойност над 20 секунди, в логовете на Fluentd ще започнат да се появяват следните предупреждения:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] почистването на буфера отне повече време от slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Това съобщение по никакъв начин не влияе на работата на системата и означава, че времето за почистване на буфера е отнело повече, отколкото е зададено от параметъра slow_flush_log_threshold. Това е отладъчна информация и използваме я, когато подбираме стойността на параметъра request_timeout.
Обобщен алгоритъм за подбора изглежда по следния начин:
- Задайте стойността на request_timeout, гарантирано по-голяма от необходимата (стотици секунди). По време на настройката основният критерий за правилността на задаването на този параметър ще бъде изчезването на предупрежденията за липса на тайм-аут.
- Изчакайте съобщения за превишаване на прага slow_flush_log_threshold. В текста на предупреждението в полето elapsed_time ще бъде написано реалното време за почистване на буфера.
- Задайте стойността request_timeout да е по-голяма от максималната стойност elapsed_time, получена за период на наблюдение. Изчисляваме стойността на request_timeout като elapsed_time + 50%.
- За да премахнете предупрежденията за бавно почистване на буфера от лог файла, можете да увеличите стойността на slow_flush_log_threshold. Изчисляваме тази стойност като elapsed_time + 25%.
Крайният резултат от тези параметри, както бе споменато по-рано, е индивидуален за всеки случай. Следвайки горепосочения алгоритъм, ние гарантирано отстраняваме грешката, водеща до дублиране на съобщения.
В таблицата по-долу е показано как се променя броят на грешките за 24 часа, водещи до дублиране на съобщенията, по време на подбора на стойностите на гореспоменатите параметри:
node-1
node-2
node-3
node-4
Преди/След
Преди/След
Преди/След
Преди/След
неуспешно почистване на буфера
1749/2
694/2
47/0
1121/2
ново опитване успешно
410/2
205/1
24/0
241/2
Важно е да се отбележи, че получените настройки могат да загубят своята валидност по време на растежа на проекта и, съответно, увеличаването на броя на логовете. Първоначален признак за недостатъчно зададен тайм-аут е появата в логовете на Fluentd на съобщения за бавно почистване на буфера, т.е. надвишаване на прага slow_flush_log_threshold. От този момент има още малък резерв преди превишаване на параметъра request_timeout, затова е важно да реагирате своевременно на тези съобщения и повторно да стартирате процеса на подбор на оптимални настройки, описан по-горе.
Заключение
Финото настройване на изходния буфер на Fluentd е един от основните етапи при конфигуриране на EFK стека, определящ стабилността му в работа и коректността на поставянето на документите в индексите. Спазвайки описания алгоритъм за настройка, можете да бъдете уверени, че всички логове ще бъдат записани в индекс ElasticSearch в правилния ред, без дублирания и загуби.
Също така прочетете и други статии в нашия блог:
Източник: habr.com
