

3. Варианти на структури при използване на глобали
Такива структури като подредено дърво имат различни частни случаи. Нека разгледаме тези, които имат практическа стойност при работа с глобалите.
3.1 Частен случай 1. Един възел без клони
 Глобалите могат да се използват не само подобно на масив, но и като обикновени променливи. Например като брояч:
Set ^counter = 0  ; задаване на брояча
Set id=$Increment(^counter) ;  атомарно инкрементиране
При това глобалът, освен стойността, може да има и клони. Едно не изключва второто.
3.2 Частен случай 2. Едно върхове и множество клони
Общо взето — това е класическа база на ключ-стойност. А ако като стойност запазим кортеж от стойности, ще получим обикновена таблица с първичен ключ.
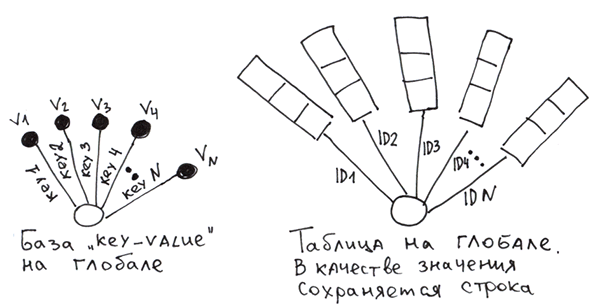
За реализация на таблицата на глобалите, ще трябва сами да формираме редове от стойностите на колоните и след това да ги запазим в глобал по първичния ключ. За да може при четене да разделим отново реда на колони, можем да използваме:
- символи-разделители.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - строга схема, при която всяко поле заема предварително определен брой байтове. Както става в релационните БД.
- специална функция $LB (нали е в Cache), която съставя ред от стойности.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Интересното е, че на глобалите не представлява трудност да се направи нещо подобно на вторични индекси в релационните БД. Нека наречем тези структури индексни глобали. Индексният глобал е спомагателно дърво за бързо търсене по полета, които не са част от първичния ключ на основния глобал. За неговото попълване и използване е нужно да се напише допълнителен код.
Нека създадем индексен глобал по първата колона.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Сега за бързо търсене на информация по първата колона, предстои да погледнем в глобал ^i и да намерим първичните ключове (id), съответстващи на нужната стойност на първата колона.
При вмъкване на стойност можем веднага да създадем както стойността, така и индексните глобали по нужните полета. А за надеждност ще обвием всичко това в транзакция.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Подробности как да направим на M , .
Таблиците ще работят също толкова бързо, колкото и в традиционните бази данни (или дори по-бързо), ако функциите за вмъкване/обновяване/изтриване на редове бъдат написани на COS/M и компилирани.Твърдението съм проверявал с тестове на масови INSERT и SELECT в една двуколонна таблица, включително с използване на командите TSTART и TCOMMIT (транзакции).
Не съм тествал по-сложни сценарии с конкурентен достъп и паралелни транзакции.
Без използване на транзакции, скоростта на вмъкванията беше 778 361 вмъквания/секунда за един милион стойности.
При 300 милиона стойности — 422 141 вмъквания/секунда.
При използване на транзакции — 572 082 вмъквания/секунда за 50М вмъквания. Всички операции бяха извършени от компилиран M-код.
Хардиските са обикновени, не SSD. RAID5 с Write-back. Процесор Phenom II 1100T.
За аналогично тестване на SQL-база е необходимо да напиша съхранена процедура, която в цикъл да извършва вмъквания. При тестване на MySQL 5.5 (хранилище InnoDB) по този метод не получавах цифри над 11К вмъквания в секунда.
Да, реализацията на таблиците на глобалите изглежда по-сложна, отколкото в релационните бази данни. Затова промишлените бази данни на глобалите имат SQL-достъп за опростяване на работата с таблични данни.
 Всъщност, ако схемата на данните не се променя често, скоростта на вмъкване не е критична и цялата база може лесно да бъде представена под формата на нормализирани таблици, то по-лесно е да се работи именно с SQL, тъй като той осигурява по-високо ниво на абстракция.
 В този конкретен случай исках да покажа, че глобалите могат да служат като конструктор за създаване на други бази данни. Като асемблер, на който могат да се пишат други езици. А ето примери как могат да се създадат на глобалите аналози
Ако е нужно да създадете някаква нестандартна база данни с минимални усилия, то струва си да се погледне в посоката на глобалите.
3.3 Специфичен случай 3. Двустепенно дърво, при което всеки възел от второ ниво има фиксиран брой клонове
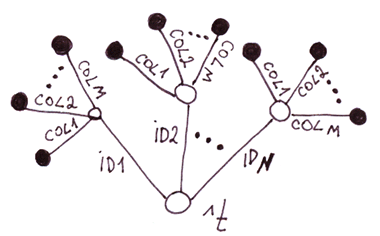 Вероятно сте се досетили: това е алтернативна реализация на таблиците на глобалите. Нека сравним тази реализация с предишната.
Таблици на двустепенно дърво спрямо едностепенно дърво.
Недостатъци
Плюсове
- По-бавни при вмъкване, тъй като е необходимо да се зададе броят на възлите, равен на броя на колоните.
- По-голямо заето дисково пространство. Тъй като глобалните индекси (в смисъла на индекси в масиви) с имена на колони заемат място на диска и се дублират за всеки ред.
- По-бърз достъп до стойностите на отделни колони, тъй като не е нужно да парсите реда. Според моите тестове е по-бързо с 11,5% при 2 колони и още по-бързо с повече колони.
- По-лесно е да променяте схемата на данните.
- По-прозрачен код.
Извод: за ценители. Понеже скоростта е едно от най-ключовите предимства на глобалите, почти няма смисъл да се използва тази реализация, тъй като вероятно ще работи по-бавно от таблиците в релационните бази данни.
3.4 Обща ситуация. Дървета и подредени дървета.
Всяка структура от данни, която може да бъде представена под формата на дърво, се вписва отлично в глобалите.
3.4.1 Обекти с подобекти.
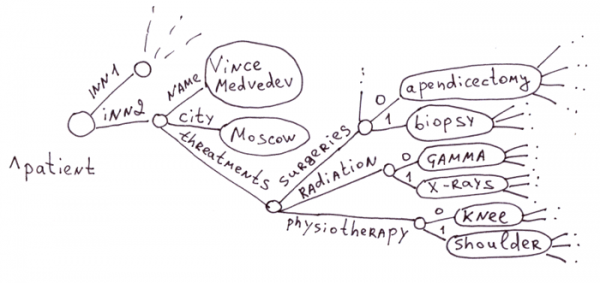
Това е областта на традиционното приложение на глобалите. В медицината съществува огромен брой болести, лекарства, симптоми и методи на лечение. Създаването на таблица с милион полета за всеки пациент не е рационално. Още повече, че 99% от полетата ще бъдат празни.
Представете си SQL БД от таблици: „пациент“ ~ 100 000 полета, „Лекарство“ — 100 000 полета, „Терапия“ — 100 000 полета, „Осложнения“ — 100 000 полета и т.н. Може да създадете БД от многобройни таблици, всяка предназначена за определен тип пациент (а те могат да се припокриват!), лечение, лекарство и още хиляди таблици за връзките между тези таблици.
Глобалите са идеални за медицината, тъй като позволяват да се създаде за всеки пациент точно описание на неговата病史, различни терапии, действия на лекарствата, под формата на дърво, без да се харчи излишно дисково пространство за празни колони, както би било в релационния случай.
 На глобалите е удобно да се прави БД с данни за хора., когато е важно да се натрупа и систематизира максимално разнообразна информация за клиента. Това е търсено в медицината, банковия сектор, маркетинга, архивната работа и други области.
.
Безспорно, на SQL също може да се емулира дърво с няколко таблици (, ,,,,,,,,,), но това е значително по-сложно и ще работи по-бавно. Всъщност би трябвало да напишем глобал, работещ на таблици, и да скрием цялата работа с таблици зад слой абстракция. Неправилно е да емулираме по-нискостояща технология (глобали) с помощта на по-високостояща (SQL). Нецелесъобразно е.
Не е тайна, че променянето на схемата на данни в гигантски таблици (ALTER TABLE) може да отнеме значително време. MySQL, например, прави ALTER TABLE ADD|DROP COLUMN с пълно копиране на информацията от старата в новата таблица (тествах двигателите MyISAM, InnoDB). Това може да блокира работната база с милиарди записи за дни, ако не и седмици.
 Промяната на структурата на данните, ако използваме глобали, не ни струва нищо. Във всеки момент можем да добавим нови нужни свойства към всеки обект, на всяко ниво на йерархията. Промените, свързани с преименуването на клонове, могат да се стартират във фонов режим на работеща БД.
Затова, когато става въпрос за съхранение на обекти с огромно количество опционални свойства, глобалите са отличен избор.
И да припомня, достъпът до кое да е от свойствата е мигновен, тъй като в глобала всички пътища представляват B-tree.
Базите данни на глобали, в общи линии, са вид документно-ориентирани БД, с възможност за съхранение на йерархична информация. Следователно в сферата на съхранение на медицински карти с глобали могат да конкурират документно-ориентирани БД. Но все пак, това не е съвсем така.Нека сравним, например, MongoDB. В тази сфера тя губи спрямо глобалите поради следните причини:
- Размер на документа. Единицата за съхранение е текст във формат JSON (по-точно BSON) с максимален обем около 16MB. Ограничението е специално зададено, за да не се забавя JSON-базата при парсинг, ако тя съхранява огромен JSON-документ и после се обръща към него по полета. В този документ трябва да бъде концентрирана всяка информация за пациента. Всички знаем колко обемисти могат да бъдат картите на пациентите. Максималният размер на картата от 16MB веднага поставя край на пациентите, чиито карти за заболявания включват файлове от MRI, рентгенови снимки и други изследвания. В един клон на глобала обаче може да имате информация с гигабайти и терабайти. В принципе, на това може да се сложи край, но ще продължа.
- Време за осъзнаване/промяна/изтриване на нови свойства в картата на пациента. Тази база данни трябва да зареди цялата карта в паметта (това е голям обем!), да разпарсва BSON, да добави/промени/изтрие нов възел, да обнови индексите, да опакова в BSON и да запази на диска. На глобала му е достатъчно само да се обърне към конкретно свойство и да извърши манипулации с него.
- Бързината на достъпа до отделните свойства. При множество свойства в документа и многопластовата му структура, достъпът до отделни свойства ще бъде по-бърз, защото всеки път в глобала е B-дерево. В BSON обаче ще трябва линейно да се разпарсва документът, за да се намери нужното свойство.
3.3.2 Ассоциативни масиви
Ассоциативните масиви (дори с вложени масиви) прекрасно се вписват в глобалите. Например, такъв масив от PHP ще се визуализира в първото изображение 3.3.1.
$a = array(
  "name" => "Винс Медведев",
  "city" => "Москва",
  "threatments" => array(
    "surgeries" => array("апедектомия", "биопсия"),
    "radiation" => array("гама", "рентгени"),
    "physiotherapy" => array("коляно", "рамо")
  )
);
3.3.3 Йерархични документи: XML, JSON
Също така лесно се съхраняват в глобалите. За съхранение могат да се разпределят по различни начини.
XML
Най-простият начин за разпределяне на XML в глобали е, когато в възлите съхраняваме атрибутите на таговете. А ако е необходим бърз достъп до атрибутите на таговете, можем да ги изнесем в отделни клони.
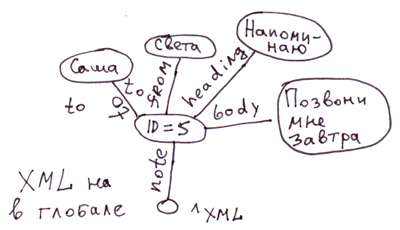
<note id="5">
<to>Вася</to>
<from>Света</from>
<heading>Напомняне</heading>
<body>Обади ми се утре!</body>
</note>
На COS това ще се отразява с кода:
Set ^xml("note")="id=5"
Set ^xml("note","to")="Саша"
Set ^xml("note","from")="Света"
Set ^xml("note","heading")="Напомняне"
Set ^xml("note","body")="Обади ми се утре!"
Забележка: За XML, JSON, ассоциативни масиви могат да се измислят много различни начини за отразяване в глобалите. В случая не отразихме реда на вложените тагове в тага note. В глобала ^xml вложените тагове ще се отразяват в азбучен ред. За строго отразяване на реда може да се използва например такова отразяване:
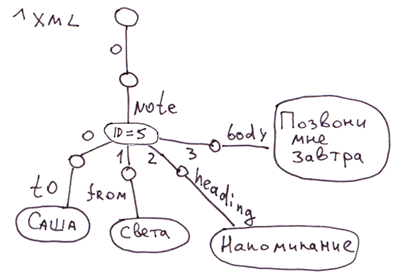
JSON.
В първото изображение от раздел 3.3.1 е показано отразяването на този JSON-документ:
var document = {
  "name": "Винс Медведев",
  "city": "Москва",
  "treatments": {
    "surgeries": ["апедектомия", "биопсия"],
    "radiation": ["гама", "рентгени"],
    "physiotherapy": ["коляно", "рамо"]
  },
};
3.3.4 Идентични структури, свързани йерархични отношения
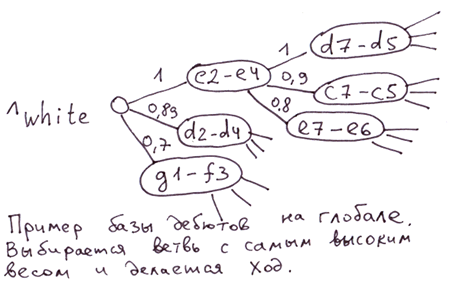
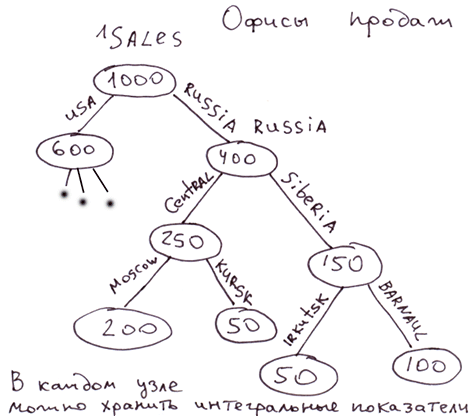
Примери: структура на офисите за продажби, разположение на хората в MLM структура, база данни за дебюти в шахматите.
База данни за дебюти. Може да използвате оценката на силата на хода като стойност на индекса на глобалния възел. Така, за да изберете най-силния ход, просто трябва да изберете клона с най-високото тегло. В глобала всички клонове на всеки ниво ще бъдат подредени по сила на хода.
Структура на офисите за продажби, структура на хората в MLM. В възлите могат да се съхраняват определени кеширани стойности, отразяващи характеристиките на цялото подпозначение. Например, обемът на продажбите на това подпозначение. Във всеки момент можем да получим числото, отразяващо постиженията на всеки клон.
4. В кои случаи е най-изгодно да се използват глобали
В първата колона са представени случаите, когато ще получите съществена печалба в скорост при използването на глобали, а във втората, когато ще се опрости разработването или моделът на данни.
Скорост
Удобство при обработката/представянето на данни
- Вмъкване [с автоматично сортиране на всеки ниво], [индексиране по основен ключ]
- Изтриване на подпозначения
- Обекти с множество вложени свойства, към които е нужен индивидуален достъп
- Йерархична структура с възможност за обход на детските клонове от всякакъв, дори несъществуващ
- Обход на подпозначения в дълбочина
- Обекти/субстанции с огромно количество незадължителни [и/или вложени] свойства/субстанции
- Безсхемни данни (schema-less). Когато често могат да се появяват нови свойства и да изчезват стари.
- Трябва да се създаде нестандартна база данни.
- Бази на пътища и дървета на решение. Когато пътищата удобно се представят под формата на дърво.
- Изтриване на йерархични структури без използване на рекурсия
Продължение .
Отказ от отговорност: Тази статия и моите коментари към нея представляват моето мнение и нямат отношение към официалната позиция на корпорацията InterSystems.
Източник: habr.com
