

Следващата конференция HighLoad++ ще се проведе на 6 и 7 април 2020 година в Санкт Петербург.
Детайли и билети . HighLoad++ Сибир 2019. Зала «Красноярск». 25 юни, 12:00. Тезиси и .
Понякога практическите изисквания конфликтуват с теорията, в която не са взети предвид важни аспекти за търговски продукт. В тази докладка е представен процесът на избор и комбиниране на различни подходи за създаване на компоненти за причинна съгласуваност на базата на академични изследвания, в зависимост от изискванията на търговския продукт. Слушателите ще научат за съществуващите теоретични подходи към логически часовници, проследяване на зависимости, сигурност на системата, синхронизация на часовниците и защо MongoDB спря на определени решения.
Михаил Тюленев (по-нататък – МТ): – Ще разкажа за причинната съгласуваност – това е функция, върху която работихме в MongoDB. Работя в екипа за разпределени системи, реализирахме я преди около две години.
В процеса трябваше да се запозная с голямо количество академично изследване, защото тази функция е доста добре проучена. Оказа се, че нито една статия не отговаря на нуждите в продукцията, на базата на доста специфичните изисквания, които вероятно съществуват във всяко приложение за продукция.
Ще разкажа как, като потребители на академични изследвания, подготвяме от него нещо, което можем после да представим на нашите потребители като готово ястие, с което е удобно и безопасно да се ползва.
Причинна съгласуваност (Causal consistency). Определяме понятията
Първо искам в общи линии да кажа какво е причинна съгласуваност. Има два персонажа – Леонард и Пенни (сериал „Теория на голямото вибрация“):
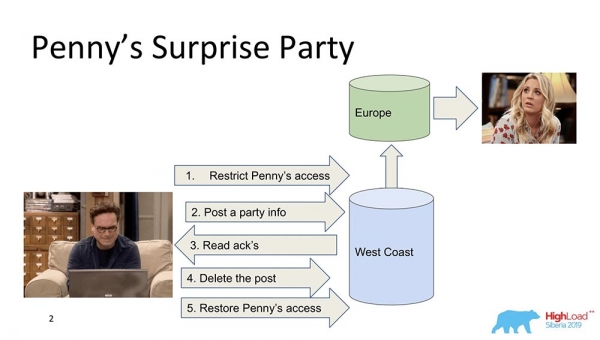
Да предположим, че Пенни е в Европа, а Леонард иска да направи изненада за нея, купон. И той не успява да измисли нищо по-добро от това да я изтрие от списъка с приятели, да изпрати на всички свои приятели актуализация на фийда: „Нека зарадваме Пенни!“ (тя е в Европа, спи в момента, не вижда всичко това и не може да го види, защото не е там). В крайния момент той изтрива този пост, премахва от „Фийда“ и възстановява достъпа, така че тя да не забележи нищо и да не възникне скандал.
Всичко това е прекрасно, но нека предположим, че системата е разпределена и събитията не са се развили точно така. Може да се случи, например, че ограничението на достъпа на Пенни е настъпило след публикуването на този пост, ако събитията не са свързани помежду си по причинно-следствени връзки. Всъщност, това е пример за необходимостта от причинна консистентност за изпълнение на бизнес функция (в този случай).
Всъщност, това са доста нетривиални свойства на базата данни – много малко от тях ги поддържат. Нека преминем към моделите.
Модели на консистентност (Consistency Models)
Какво е изобщо модел на консистентност в базите данни? Това са определени гаранции, които разпределената система дава относно кои данни и в каква последователност клиентът може да получи.
Всъщност, всички модели на консистентност се свеждат до това, колко разпределената система прилича на система, която работи, например, на един нод на лаптоп. И колко разпределената система, работеща на хиляди географски разпределени ноди, прилича на лаптопа, в който всички тези свойства се изпълняват автоматично.
Затова моделите на консистентност се прилагат само за разпределени системи. Всички системи, които по-рано съществуваха и работеха на едно вертикално мащабиране, не срещаха такива проблеми. Имаше един Buffer Cache, и от него всичко се извличаше винаги.
Модел Strong
Всъщност, най-първият модел е Strong (или линия rise ability, както често я наричат). Това е модел на консистентност, който гарантира, че всяка промяна, веднага след получаването на потвърждение за настъпването ѝ, става видима за всички потребители на системата.
Това създава глобален ред на всички събития в БД. Това е много силно свойство на консистентността и е доста скъпо. Въпреки това, то е много добре поддържано. Просто е много скъпо и бавно – рядко се използва. Това се нарича rise ability.
Има още едно, по-силно свойство, което се поддържа в "Спаннер" – нарича се Външна консистентност. За него ще говорим малко по-късно.
Причинна
Следващото е Causal, точно това, за което говорех. Между Strong и Causal съществуват още няколко подуровня, за които няма да говоря, но те всички се свеждат до Causal. Това е важен модел, защото е най-силният от всички модели, с най-силна консистенция при наличието на мрежа или разделяне.
Causals е в действителност ситуацията, при която събитията са свързани с причинно-следствена връзка. Често ги възприемат като Read your on rights от гледна точка на клиента. Ако клиентът е наблюдавал някакви стойности, той не може да види стойностите, които са били в миналото. Той вече започва да вижда префиксни четения. Всичко това се свежда до едно и също.
Causals като модел на консистентност – частично подреждане на събитията на сървъра, при което събитията от всички клиенти се наблюдават в една и съща последователност. В този случай – Леонард и Пенни.
Eventual
Третият модел е Eventual Consistency. Това е нещо, което поддържат абсолютно всички разпределени системи, минималният модел, който изобщо има смисъл. Той означава следното: когато настъпят определени промени в данните, те в някакъв момент стават консистентни.
В такъв момент той не казва нищо, иначе би се превърнал в External Consistency – това би била съвсем различна история. Въпреки това, това е много популярен модел, най-разпространеният. По подразбиране всички потребители на разпределени системи именно използват Eventual Consistency.
Искам да дам някои сравнителни примери:
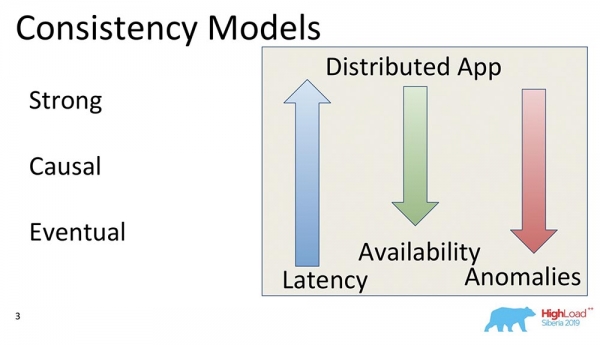
Какво означават тези стрелки?
- Latency. При увеличаване на силата на консистентността тя става по-голяма по разбираеми причини: необходимо е да се направят повече записи, да се получи потвърждение от всички хостове и нодовете, които участват в клъстера, че данните вече са там. Следователно в Eventual Consistency най-бързият отговор, защото там, по правило, може дори да запишете в паметта и това ще бъде в принципе достатъчно.
- Availability. Ако това се разбира като възможност на системата да отговори при наличие на прекъсвания в мрежата, разпадения или някакви откази – отказоустойчивостта нараства при намаляване на модела на консистентност, тъй като е достатъчно един хост да работи и да предоставя някакви данни. Eventual Consistency всъщност не гарантира нищо относно данните – това може да бъде всичко.
- Anomalies. Разбирайки с това, естествено, нараства броят на аномалиите. При Strong Consistency те почти не трябва да съществуват, докато при Eventual Consistency могат да бъдат всякакви. Възниква въпросът: защо хората избират Eventual Consistency, когато тя съдържа аномалии? Отговорът е, че моделите на Eventual Consistency са приложими и аномалиите съществуват, например, за кратки периоди от време; има възможност да се използва основен възел за четене и дори да се четат относително последователни данни; често има възможност да се използват силни модели на последователност. Практически това работи и често броят на аномалиите е ограничен във времето.
Теорема CAP
Когато видите думите последователност, наличност – какво ви идва на ум? Правилно – теоремата CAP! Искам сега да развея мита… Не съм аз – това е Мартин Клеппман, който е написал страхотна статия и чудесна книга.
Теорема CAP е принцип, формулиран в 2000-те години, относно това, че Последователност, Наличност, Партиции: вземете две от тях, и не можете да изберете трета. Това беше определен принцип. Той беше доказан като теорема няколко години по-късно, това направиха Джилберт и Линч. След това започна да се използва като мантра – системите започнаха да се разделят на CA, CP, AP и така нататък.
Наистина, теоремата е доказана за следните случаи… Първо, Наличността не е разглеждана като непрекъсната стойност от нула до сто (0 – системата е „мертва“, 100 – отговаря бързо; ние я разглеждаме по този начин), а по-скоро като свойство на алгоритъм, който гарантира, че при всички негови изпълнения той връща данни.
Няма и следа за време за отговор! Има алгоритъм, който връща данни след 100 години – напълно прекрасен наличен алгоритъм, който е част от теоремата CAP.
Второ: теоремата е била доказана за промени в стойностите на един и същи ключ, при условие че тези промени са линия, която може да се променя по размер. Това означава, че всъщност те практически не се използват, защото моделите са различни – Eventual Consistency, Strong Consistency (може би).
За какво всъщност става дума? Става въпрос за това, че теоремата CAP в формата, в която е доказана, практически не е приложима, рядко се използва. В теоретична форма тя по някакъв начин ограничава всичко. Получава се един принцип, който интуитивно е верен, но не е доказан.
Causal consistency е най-силният модел.
Това, което в момента се случва – можете да получите всичките три неща: Съгласуваност, Наличност чрез Разделения. По-специално, причинно-следствената съгласуваност е най-силният модел на съгласуваност, който все пак работи при наличие на Разделения (прекъсвания в мрежата). Затова представлява такъв голям интерес и затова се заехме с нея.
На първо място, тя улеснява работата на разработчиците на приложения. По-специално, наличието на голяма поддръжка от страна на сървъра: когато всички записи, които се случват вътре при един клиент, гарантирано ще стигнат в такава последователност до друг клиент. На второ място, тя издържа на разделения.
Вътрешната кухня на MongoDB
Помнейки, че е обяд, се прехвърляме в кухнята. Ще ви разкажа за моделa на системата, а именно – какво представлява MongoDB за тези, които за пръв път чуват за такава база данни.
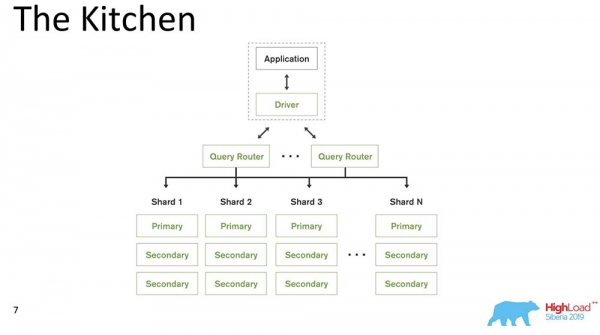
MongoDB (по-нататък – «МонгоБД») е разпределена система, която поддържа хоризонтално мащабиране, тоест шардване; и вътре в всеки шард също поддържа излишък от данни, тоест репликация.
Шардването в «МонгоБД» (не релационна БД) извършва автоматично балансиране, тоест всяка колекция документи (или «таблица» в термини на релационни данни) се разпределя на парчета, и вече сървърът автоматично ги мести между шардовете.
Query Router, който разпределя заявките, за клиента е известен клиент, през който той работи. Той вече знае къде и какви данни се намират, насочва всички заявки към правилния шард.
Още един важен момент: MongoDB е single master. Има един Primary – той може да взема записи, поддържащи ключовете, които притежава. Не може да се направи Multi-master write.
Пуснахме релийз 4.2 – там се появиха нови интересни неща. По-специално, вкараха Lucene – търсене – именно executable java директно в «Монго», и стана възможно да се извършва търсене чрез Lucene, точно както в «Еластик».
И направихме нов продукт – Charts, който също е достъпен на «Атласа» (основния Cloud на «Монго»). Те имат Free Tier – можете да се поиграете с него. Charts ми хареса много – визуализация на данни, много интуитивно.
Съставки на причинно-следствената съгласуваност
Насчетох около 230 статии, които са публикувани по тази тема – от Лесли Ламперта. Сега ще споделя с вас някои части от тези материали от паметта си.
Всичко започна с статията на Лесли Ламперта, написана през 70-те години. Както виждате, все още се провеждат изследвания по тази тема. В момента каузалната последователност преживява интерес във връзка с развитието именно на разпределените системи.
Ограничения
Какви ограничения съществуват? Това наистина е един от основните моменти, защото ограниченията, които налагат производствените системи, значително се различават от ограниченията, съществуващи в академичните статии. Често те са доста изкуствени.
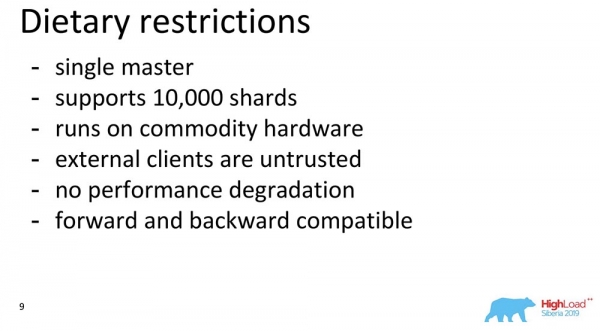
- На първо място, „MongoDB“ е със структура single master, както вече споменах (което значително опростява нещата).
- Смятаме, че системата трябва да поддържа около 10 хиляди шарда. Не можем да взимаме архитектурни решения, които явно ограничават това количество.
- Имаме облак, но предполагаме, че потребителят трябва да има възможност, когато изтегли бинарния файл, да го стартира на лаптопа си и всичко да работи перфектно.
- Предполагаме, че в изследванията рядко се използва: външните клиенти могат да правят каквото си искат. „MongoDB“ е с отворен код. Следователно, клиентите могат да бъдат умни и зли – могат да искат да разрушат всичко. Предполагаме, че византийските неуспехи могат да се проявяват.
- За външните клиенти, които са извън периметъра – важно ограничение: ако тази функция е изключена, не трябва да се наблюдават никакви ухудшения в производителността.
- Още един момент – изцяло антиакадемичен: съвместимостта на предишните версии с бъдещите. Старите драйвери трябва да поддържат новите актуализации, а базата данни трябва да поддържа старите драйвери.
В общи линии, всичко това налага ограничения.
Компоненти на каузалната последователност
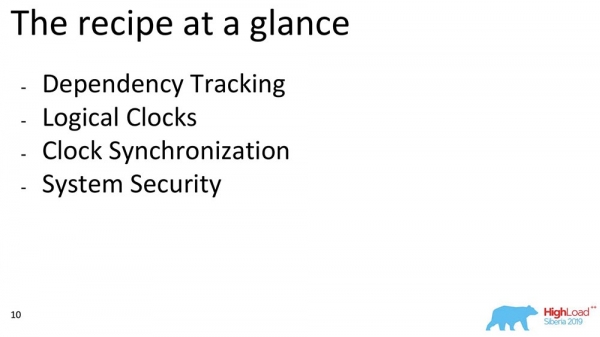
Сега ще говоря за някои компоненти. Ако разгледаме каузалната последователност общо, можем да выделим блокове. Избирахме от работи, свързани с някакъв блок: проследяване на зависимости, избор на часовници, как могат да се синхронизират и как осигуряваме сигурност – това е примерен план на темата, за която ще говоря:
Пълно проследяване на зависимости (Full Dependency Tracking)
Защо е необходимо? За да се уверим, че когато данните се репликират, всяка запис, всяка промяна на данните съдържа информация за това, от какви промени зависи. Най-простата и наивна промяна е, когато всяко съобщение, което съдържа запис, предоставя информация за предишните съобщения:
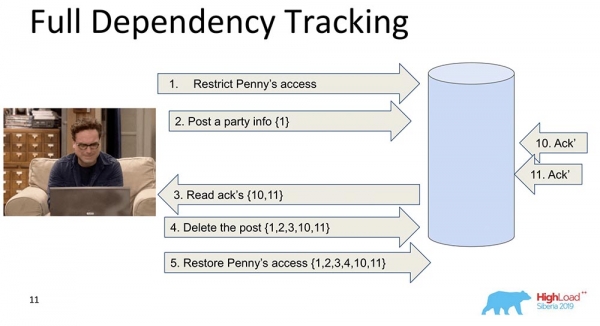
В този пример номерът в фигурните скобки представлява номера на записите. Понякога тези записи със стойности се предават изцяло, понякога се предават някакви версии. Същността е в това, че всяка промяна съдържа информация за предишната (явно носи всичко това в себе си).
Защо решихме да не използваме такъв подход (пълен проследяващ)? Очевидно, защото този подход е непрактичен: всяка промяна в социалната мрежа зависи от всички предишни промени в тази социална мрежа, предаваща, да кажем, "Фейсбук" или "Вконтакте" във всяко обновление. Въпреки това има много изследвания на именно Full Dependency Tracking – това са преди социалните мрежи, за някои ситуации това наистина работи.
Явно проследяване на зависимости (Explicit Dependency Tracking)
Следващият – по-ограничен. Тук също се разглежда предаването на информация, но само тази, която явно зависи. Какво от какво зависи, обикновено определя вече приложението. Когато данните се репликират, при заявка се предоставят само отговори, когато предишните зависимости са били удовлетворени, т.е. показани. В това е същността на това как работи Causal consistency.
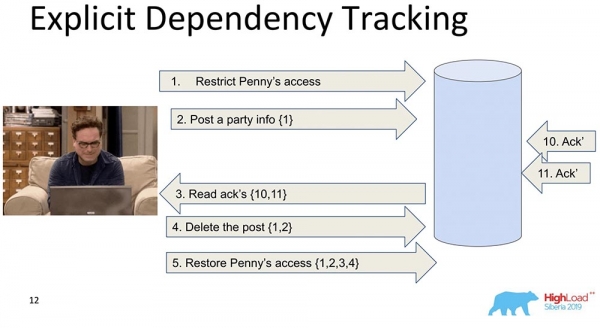
Тя вижда, че запис 5 зависи от записите 1, 2, 3, 4 – съответно, тя чака, преди клиентът да получи достъп до промените, извършени с разрешението на Пенни, когато всички предишни промени вече са преминали в базата данни.
Това също не ни удовлетворява, защото информацията пак е твърде много и това ще забави процеса. Има и друг подход…
Часовник на Лампорта (Lamport Clock)
Те са много стари. Lamport Clock предпоставя, че тези зависимости се свиват в скаларна функция, която се нарича Lamport Clock.
Скалярната функция е абстрактно число. Често я наричат логическо време. При всяко събитие този счетчик се увеличава. Счетчикът, който в момента е известен на процеса, изпраща всяко съобщение. Ясно е, че процесите могат да бъдат несинхронизирани и да имат напълно различно време. Въпреки това, посредством този обмен на съобщения системата по някакъв начин балансира часовниците. Какво се случва в този случай?
Разделих този голям шард на две, за да стане ясно: Friends могат да живеят в един нод, който съдържа част от колекцията, а Feed – изобщо в друг нод, в който се съдържа част от тази колекция. Ясно е как могат да излязат извън реда? Първо Feed ще каже: „Репликиран“, а след това – Friends. Ако системата не осигурява никакви гаранции, че Feed няма да бъде показан, докато зависимостите на Friends в колекцията Friends не бъдат доставени, тогава точно ще възникне ситуацията, за която споменах.
Виждате как логическият времеви счетчик на Feed-а се увеличава:
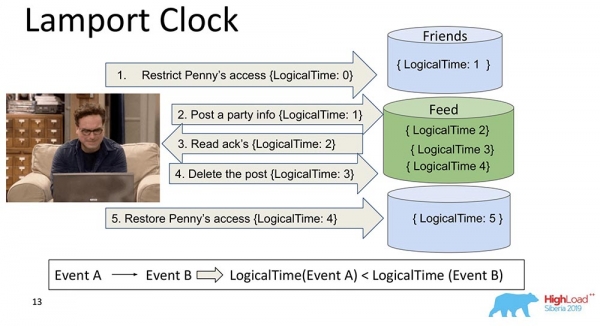
По този начин основното свойство на Lamport Clock и причинната последователност (обяснена чрез Lamport Clock) е следното: ако имаме събития A и B, и събитие B зависи от събитие A *, то следва, че LogicalTime от Събитие A е по-малко от LogicalTime от Събитие B.
* Често се казва, че A се е случило преди B, т.е. A се е случило преди B – това е вид отношение, което частично подрежда всичките събития, които са се случили.
Обратно, това не е вярно. Всъщност това е един от основните недостатъци на Lamport Clock – частичен ред. Има понятие за едновременни събития, т.е. събития, при които нито (A се е случило преди B), нито (A се е случило след B). Пример за това е паралелното добавяне на Леонардо в приятели на някой друг (дори не на Леонардо, а на Шелдън, например).
Това е свойството, което често се използва при работа с Lamport часовници: гледа се именно на функцията и от това се прави извод – може би тези събития са зависими. Защото в едната посока е вярно: ако LogicalTime A е по-малко от LogicalTime B, тогава B не може да се е случило преди A; а ако е по-голям, тогава може.
Векторни часовници (Vector Clock)
Логичното развитие на часовниците на Лампорта са Векторните часовници. Те се различават с това, че всеки нод, който тук има, съдържа свои, отделни часовници, и те се предават като вектор.
В този случай виждате, че нулевият индекс на вектора отговаря за Feed, а първият индекс – за Friends (всеки от тези възли). И сега те ще се увеличават: нулевият индекс на „Фида“ се увеличава при запис – 1, 2, 3:
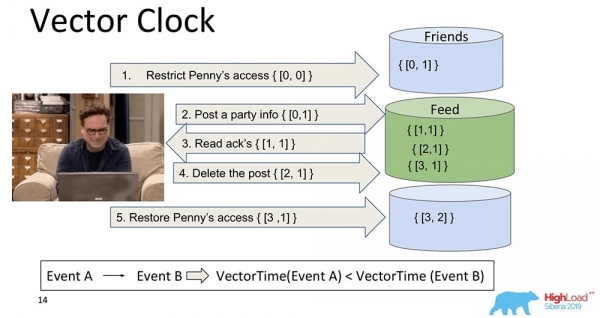
Какво прави Векторните часовници по-добри? Те позволяват да разберем, кои събития са едновременни и кога се случват на различни възли. Това е много важно за системата за шардирване, като „MongoDB“. Въпреки това, не избрахме това, макар че е великолепно нещо и работи прекрасно, би ни подхождало, вероятно…
Ако имаме 10 хиляди шарда, не можем да предаваме 10 хиляди компонента, дори ако ги компресираме или измислим нещо друго – все пак полезната нагрузка ще бъде многократно по-малка от обема на целия този вектор. Затова, скърцайки със зъби, се отказахме от този подход и преминахме към друг.
Spanner TrueTime. Атомни часовници
Говорих, че ще има разказ за „Спаннер“. Това е страхотно нещо, направо XXI век: атомни часовници, GPS-синхронизация.
Каква е идеята? „Спаннер“ е системата на Google, която наскоро стана достъпна за хората (добавиха SQL). Всяка транзакция там има определен времеви маркер. Поскольку времето е синхронизирано*, на всяко събитие може да се назначи определено време – атомните часовници имат време за изчакване, след което гарантирано „съществува“ друго време.
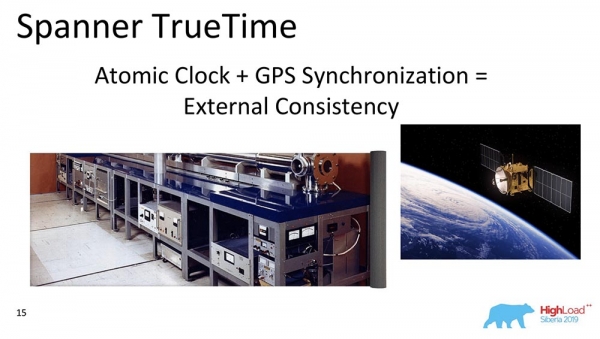
Така, просто записвайки в БД и очаквайки определен период от време, автоматично се гарантира сериализируемост на събитието. Те имат най-силната модел на последователност, която изобщо може да бъде представена – тя е Външна последователност.
* Това е основният проблем с часовниците на Лемпарт – те никога не са синхронизирани в разпределени системи. Те могат да се разминават, дори с наличието на NTP все още не работят много добре. „Спаннер“ има атомни часовници и синхронизация, изглежда на микросекунди.
Защо не избрахме? Не предполагаме, че нашите потребители разполагат с вградени атомни часовници. Когато те се появят, вграден в всеки лаптоп, ще има супер страхотна GPS-синхронизация – тогава да… А за сега, най-доброто, което е възможно – това са „Amazon“, базови станции – за фанатици… Затова използвахме други часовници.
Хибридни часовници (Hybrid Clock)
Това всъщност е това, което работи в „MongoDB“ при осигуряване на Causal consistency. Хибридни са в какво? Хибрид – това е скаларна стойност, но тя се състои от два компонента:
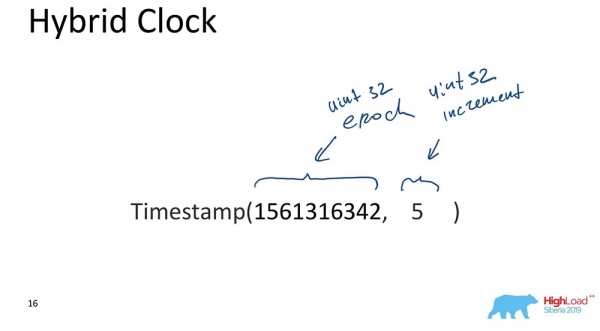
- Първото е unix епохата (колко секунди са минали от „началото на компютърния свят“).
- Второто е някакъв инкремент, също 32-битен unsigned int.
Това всъщност е всичко. Има такъв подход: частта, която отговаря за времето, постоянно се синхронизира с часовниците; всеки път, когато се извършва обновление, тази част се синхронизира с часовниците и се получава, че времето винаги е повече-мене коректно, а инкрементът позволява да се различават събития, които са се случили в един и същи момент.
Защо това е важно за „MongoDB“? Защото позволява да се извършват бекъп-възстановявания на определен момент, тоест събитието се индексира по време. Това е важно, когато са необходими определени събития; за БД събитията – това са промените в БД, които са настъпили в определени времеви интервали.
Най-важната причина ще ви я кажа само на вас (моля, само не го казвайте на никого)! Направихме го, защото така изглеждат подредените, индексирани данни в MongoDB OpLog. OpLog – това е структура от данни, която съдържа абсолютно всички промени в базата: те първо попадането в OpLog, а след това вече се прилагат на самото Storage, в случай, че става въпрос за реплицирана дата или shard.
Това беше основната причина. Все пак съществуват и практическите изисквания за разработката на базата, а това означава, че трябва да бъде просто – малко код, колкото се може по-малко повредени неща, които трябва да бъдат преписвани и тествани. Фактът, че нашите оплогове се оказаха индексирани от хибридни часове, много помогна и позволи изборът да бъде направен правилно. Това наистина се оправда и по някакъв магически начин проработи на първия прототип. Беше много яко!
Синхронизация на часовете
Съществуват няколко начина за синхронизация, описани в научната литература. Говоря за синхронизация, когато имаме два различни шарда. Ако имаме реплика-сет, синхронизация не е необходима: това е 'сингл-мастър'; имаме OpLog, в който всички промени попадат - в този случай всичко вече е последователно подредено в самия 'Оплог'. Но ако имаме два различни шарда, тук синхронизацията на времето е важна. Ето тук векторните часовници помогнаха повече! Но нямаме такива.
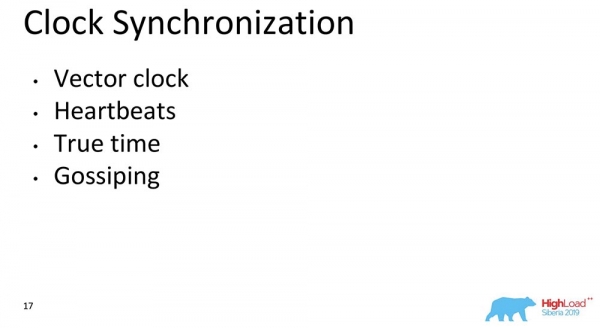
Вторият подход е 'Хартбити' (Heartbeats). Можем да обменяме определени сигнали, които се случват на всяка единица време. Но 'Хартбитите' са твърде бавни, не можем да осигурим латентност на нашия клиент.
Истинското време - разбира се, е чудесна идея. Но отново, това вероятно е бъдещето… Въпреки че в 'Атласа' вече можем да извършваме, вече има бързи 'амазоновски' синхронизатори на времето. Но това няма да бъде достъпно за всички.
Госипинг – това е когато всички съобщения включват време. Това е приблизително това, което използваме. Всяко съобщение между възлите, драйвера, маршрутизатора на данни, абсолютно всичко за 'МонгоДБ' – тези елементи, компоненти на базата данни, които съдържат часовници, които текат. Навсякъде имат стойност на хибридно време, тя се предава. 64 бита? Това позволява, това е възможно.
Как работят всички тези неща заедно?
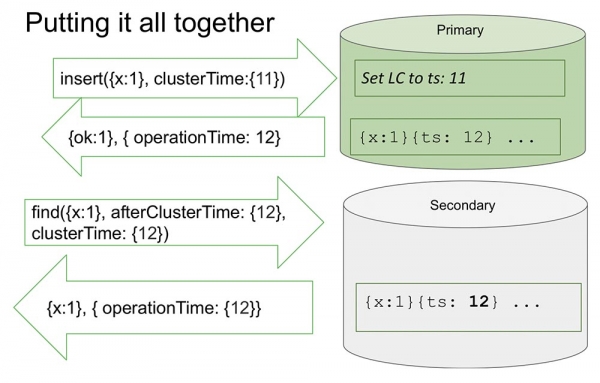
Тук разглеждам един реплика-сет, за да бъде малко по-просто. Има Primary и Secondary. Secondary извършва репликация и не винаги е напълно синхронизиран с Primary.
Съществува вставка (insert) в 'Праймери' с някаква стойност на времето. Тази вставка увеличава вътрешния брояч с 11, ако това е максималното. Или проверява стойностите на часовниците и се синхронизира по тях, ако стойностите на часовниците са по-големи. Това позволява подредба по време.
След като той направи запис, настъпва важен момент. Часовниците в 'МонгоДБ' и инкрементират само в случай на запис в 'Оплог'. Това е събитието, което променя състоянието на системата. В абсолютно всички класически статии събитието се счита за попадането на съобщение в възела: съобщението е пристигнало - значи, системата е променила своето състояние.
Това е свързано с факта, че при изследването не е напълно ясно как ще бъде интерпретирано това съобщение. Знаем, че ако не е отразено в „Оплога“, то няма да бъде интерпретирано по никакъв начин, а промяната в състоянието на системата е само запис в „Оплог“. Това ни опростява ситуацията: моделът се опростява, позволява организиране в рамките на един реплика-набор и много други полезни неща.
Върна се стойността, която вече е записана в „Оплог“ – знаем, че в „Оплога“ вече е тази стойност, а нейното време е 12. Сега, да предположим, че започва четене от друг нод (Secondary), и той предава вече afterClusterTime в самото съобщение. Той казва: „Имам нужда от всичко, което се е случило поне след 12 или по време на дванадесет“ (вж. рис. по-горе).
Това, което се нарича Causal a consistent (CAT). Има такова понятие в теорията, че това е някакъв отрязък от време, който е последователен сам по себе си. В този случай може да се каже, че това е състояние на системата, наблюдавано в момент на време 12.
Сега тук няма нищо, защото това почва да имитира ситуация, когато е нужно Secondary да репликира данни от Primary. Той чака... И ето, данните пристигат – връща назад тези стойности.
Ето така всичко работи. Почти.
Какво означава „почти“? Нека предположим, че има някакъв човек, който е прочел и разбрал как всичко това работи. Разбрал е, че всеки път се случва ClusterTime, той обновява вътрешните логически часовници, и след това следващият запис увеличава с единица. Тази функция заема 20 реда. Да кажем, че този човек предава максимално голямо 64-битно число, минус единица.
Защо „минус единица“? Защото вътрешните часовници ще се поставят в тази стойност (очевидно, това е най-голямото възможно и повече от текущото време), след това ще се извърши запис в „Оплог“, и часовниците ще се увеличат с още една единица – и вече ще бъде абсолютно максимална стойност (там просто са всички единици, повече не може, unsaint int’ите).
Ясно е, че след това системата става абсолютно недостъпна за нищо. Може да се извеже, да се почисти – много ръчна работа. Пълен availability:
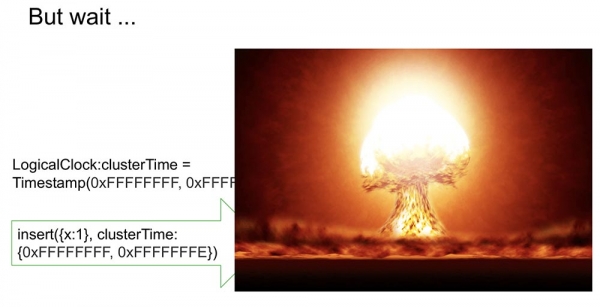
Всъщност, ако това бъде репликирано някъде другаде, целият клъстер просто се срива. Абсолютно неприемлива ситуация, която всеки човек може да организира много бързо и лесно! Затова разглеждахме този момент като един от най-важните. Как да го предотвратим?
Нашият подход е да подписваме clusterTime
Той се предава в съобщението (преди синята част на текста). Но ние започнахме и да генерираме подписи (синия текст):
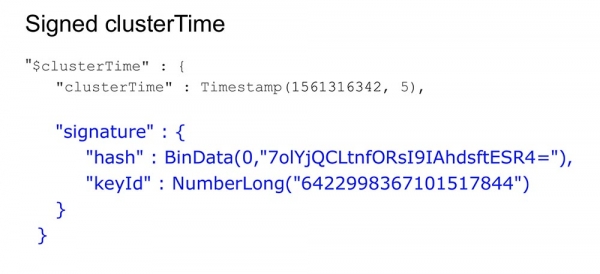
Подписът се генерира с ключ, който се съхранява в базата данни, вътре в защитен периметър; самият той се генерира и обновява (потребителите не виждат това). Генерира се хеш, и всяко съобщение при създаването се подписва, а при получаването – валидира.
Вероятно у хората възниква въпросът: «Насколько это всё замедляет?» Аз вече казах, че трябва да работи бързо, особено при отсъствие на тази функция.
Какво означава да се ползва Causal consistency в този случай? Това е да се показва параметърът afterClusterTime. А без него той просто ще предава стойности във всеки случай. Gossiping, от версия 3.6, работи винаги.
Ако оставим постоянното генериране на подписи, то ще забавя системата дори при отсъствие на функцията, което не отговаря на нашите подходи и изисквания. И какво направихме?
Прави го бързо!
Доста проста идея, но интересен трик – ще го споделя, може би на някого ще му е интересно.
Имаме хеш, в който се съхраняват подписаните данни. Всички данни преминават през кеша. Кешът не подписва конкретно време, а диапазон. Когато постъпи определена стойност, генерираме диапазон, маскираме последните 16 бита и тази стойност подписваме:
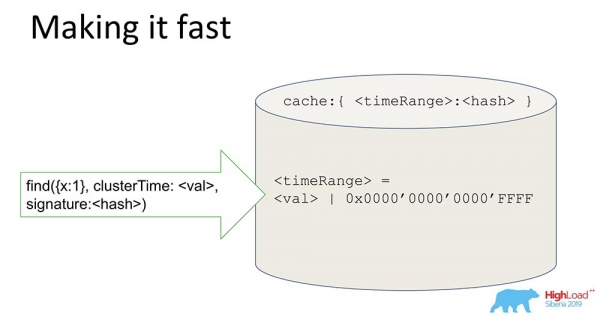
Получавайки такава подписка, ускоряваме системата (условно) 65000 пъти. То работи прекрасно: когато направихме експерименти – там времето реално беше намалено 10000 пъти, когато имаме последователно обновяване. Ясно е, че когато са неупорядъчени, това не се получава. Но в повечето практически случаи работи. Комбинацията от подписа на диапазона с подписа реши проблема със сигурността.
Какво научихме?
Уроки, которые мы из этого извлекли:
- Трябва да четем материали, истории, статии, защото имаме много интересни неща. Когато работим по някаква функция (особено сега, когато правихме транзакции и т.н.), трябва да четем, да разбираме. Това отнема време, но наистина е много полезно, защото става ясно къде се намираме. Нямаме нищо ново, просто взехме съставките.
Всъщност, наблюдава се определена разлика в мисленето, когато се провежда академична конференция (например „Сигмон“) – тук всички се фокусират върху новите идеи. В какво е новостта на нашия алгоритъм? Няма особена новост. Новостта по-скоро се състои в начина, по който сме смесили съществуващите подходи. Затова първото е, че трябва да четем класиката, започвайки от Лемпорт.
- В продукцията изискванията са съвсем различни. Сигурен съм, че много от вас не се сблъскват с „сферични“ бази данни в абстрактен вакуум, а с нормални, реални неща, които имат проблеми със наличността, латентността и устойчивостта на отказ.
- Последното е, че трябваше да разгледаме различни идеи и да комбинираме няколко напълно различни статии в един подход, заедно. Идеята за подписването, например, дойде от статия, която разглеждаше протокола Paxos, който е за невизантийските неуспехи вътре в авторизационния протокол, а за византийските – извън авторизационния протокол… В крайна сметка, точно това и направихме.
Няма нищо ново тук! Но щом всичко това го смесим заедно… Все едно да кажеш, че рецептата за салат Оливие е безинтересна, защото яйцата, майонеза и краставици вече са измислени… Това е горе-долу същата история.
На това ще приключа. Благодаря!
Въпроси
Въпрос от залата (по-нататък – В): – Благодаря, Михаил, за доклада! Темата за времето е интересна. Вие използвате Gossiping. Казахте, че всеки има своето време, всички знаят своето локално време. Разбрах, че имаме драйвер – клиентите с драйвери могат да бъдат много, query-planner-и също, шардовете също са много… Къде ще стигне системата, ако изведнъж възникне разминаване: някой решава, че е с минута напред, а друг – с минута назад? Къде ще се окажем?
МТ: – Отличен въпрос наистина! Аз точно исках да спомена за шардовете. Ако правилно разбирам въпроса, при нас е такава ситуация: има шард 1 и шард 2, четенето става от тези два шарда – между тях има разминаване, те не взаимодействат помежду си, защото времето, което знаят – е различно, особено времето, което съществува в оплогите им.
Да кажем, че шард 1 е направил милион записа, шард 2 – изобщо нищо, а заявката е дошла и до двата шарда. И при първия има afterClusterTime над милион. В такава ситуация, както и обясних, шард 2 изобщо никога няма да отговори.
В: – Исках да разбера как се синхронизират и ще изберат едно логическо време?
МТ: – Много просто се синхронизират. Шардът, когато получи afterClusterTime и не намира време в „Оплога“ – инициира no approved. Тоест, той ръчно повишава времето си до това значение. Това означава, че няма събития, отговарящи на тази заявка. Той създава това събитие изкуствено и по този начин става Causal Consistent.
В: – А ако след това му дойдат някакви събития, които някъде в мрежата са се загубили?
МТ: – Шардът е устроен така, че те вече няма да дойдат, тъй като това е single master. Ако вече е записал, те вече не могат да дойдат, а ще бъдат след това. Не може да се получи така, че нещо да е застряло някъде, после той да направи no write, а после тези събития да дойдат – и да нарушат Causal consistency. Когато направи no write, всичките трябва да дойдат след това (той ще ги изчака).
В: – Имам няколко въпроса относно опашките. Causal consistency предполага, че има определена опашка от действия, които трябва да се изпълнят. Какво ще се случи, ако един пакет изчезне? Ето, 10-тият, 11… 12-тият е изчезнал, а всички останали чакат, когато той бъде изпълнен. И изведнъж нашата машина е умряла, ние нищо не можем да направим. Има ли максимална дължина на опашката, която се натрупва, преди да се изпълни? Какъв фатален провал настъпва при загубата на някое единично състояние? Тем повече, ако записваме, че има някакво предходно състояние, от него ние трябва да се опрем? А от него не сме се опрели!
МТ: – Също прекрасен въпрос! Какво правим? В MongoDB има понятие за кворумни записи, кворумно четене. В какви случаи съобщението може да изчезне? Когато записът е некворумен или когато четенето не е кворумно (също може да се появи някакъв garbage).
Относно на Causal consistency проведохме обширни експериментални проверки, резултатът от които показа, че в случай, че записите и четенето са некворумни, възникват нарушения на Causal consistency. Точно това, което казвате!
Нашият съвет: използвайте поне кворумно четене при използване на Causal consistency. В този случай нищо няма да пропадне, дори ако кворумната запись изчезне… Това е ортогонална ситуация: ако потребителят не иска данни да изчезнат, трябва да се използва кворумна запись. Causal consistency не дава гаранция за издръжливост. Гаранцията за издръжливост се осигурява от репликацията и механизма, свързан с нея.
В: – Когато създаваме инстанция, която при нас изпълнява шардинг (не master, а slave съответно), тя разчита на unix-времето на собствената машина или на времето на «мастера»; синхронизира ли се за първи път или периодично?
МТ: – Сега ще изясня. Шард (т. е. хоризонтална партиция) – там винаги има Primary. А в шард може да има «мастер» и реплики. Но шардът винаги поддържа запис, защото трябва да поддържа определен домейн (в шард е поставен Primary).
В: – Тоест, всичко зависи изцяло от «мастера»? Винаги се използва времето на «мастера»?
МТ: – Да. Може да се каже образно: часовниците тикат, когато се извършва запис в «мастера», в «Оплог».
В: – Имаме клиент, който се свързва и той не трябва да знае нищо за времето?
МТ: – Вообще нищо не трябва да знае! Ако говорим за това как работи на клиента: клиентът, когато иска да ползва Causal consistency, трябва да отвори сесия. В момента там е всичко: и транзакциите в сесията, и retrieve a rights… Сесията е подредба на логическите събития, които се случват с клиента.
Ако той отвори тази сесия и там казва, че иска Causal consistency (ако по подразбиране сесията поддържа Causal consistency), всичко автоматично работи. Драйверът запомня това време и го увеличава, когато получава ново съобщение. Той помни какъв отговор е върнал предишният сервер, който е върнал данни. Следващият запит ще съдържа afterCluster («време по-голямо от това»).
Клиентът не трябва да знае абсолютно нищо! Това е напълно непрозрачно за него. Ако хората използват тези функции, какво може да се направи? Първо, може безопасно да се четат вторични данни: може да се пише на основния (Primary), а да се чете от географски реплицирани вторични (secondaries) и да се бъде сигурен, че това работи. При това сесиите, записани на основния, могат да се предават дори на вторични, т.е. може да се използват не една, а няколко сесии.
В: – С темата за последователност на събитията (Eventual consistency) е свързана новата област на компютърните науки – типовете данни CRDT (Conflict-free Replicated Data Types). Разглеждали ли сте интеграцията на тези типове данни в базата и какво можете да кажете по този въпрос?
МТ: – Добър въпрос! CRDT има смисъл за конфликти при запис: в MongoDB – единствена инстанция (single master).
В: – Имам въпрос от девопсите. В настоящия свят се срещат такива иезуитски ситуации, когато възниква византийски провал и злонамерени хора вътре в защитената периметър започват да се намесват в протокола, изпращайки специално изработени пакети?
МТ: – Злонамерените хора вътре в периметъра – това е все едно да имаш троянски кон! Злонамерените хора в периметъра могат да направят много лоши неща.
В: – Ясно е, че оставянето на дупка в сървъра, грубо казано, през която може да премине зоопарк от слонове и да събори целия кластер завинаги… Ще е нужно време за ръчно възстановяване… Това е, меко казано, неправилно. От друга страна, интересно е да се отбележи: в реалния живот, в практиката, срещат ли се подобни ситуации, когато наистина се случват такива вътрешни атаки?
МТ: – Тъй като не срещам често нарушения на сигурността в реалния живот, не мога да кажа – може би те се случват. Но ако говорим за философията на разработчиците, то ние смятаме следното: имаме периметър, който осигурява на момчетата, които правят сигурност – това е ключалка, стена; а вътре в периметъра може да се прави всичко, което пожелаеш. Ясно е, че има потребители с възможности само за преглед, а има и потребители с възможности за изтриване на каталози.
В зависимост от правата, щетите, които потребителите могат да нанесат, могат да бъдат с мишка или със слон. Ясно е, че потребител с пълни права може да направи абсолютно всичко. Потребител с ограничени права може да направи значително по-малко вреди. В частност, той не може да счупи системата.
В: – В защитен периметър някой се опитва да формира неочаквани протоколи за сървъра, за да го постави на ръка, а ако има късмет, и целия кластер… Има ли нещо толкова "добро"?
МТ: – Никога не съм чувал за подобни неща. Че по този начин може да се завали сървър – не е тайна. Да завали отвътре, бивайки с протокол, като авторизиран потребител, който може да запише в съобщение нещо такова… Всъщност не може, защото все пак ще бъде проверяван. Има възможност да се деактивира тази автентикация за потребителите, които не я искат – но това е техен проблем; грубо казано, сами разрушават стените и може да се напъха слон, който да стъпче… А всъщност, може да се облечеш като техник, да дойдеш и да извадиш!
В: – Благодаря за доклада. Сергей ("Яндекс"). В "Monge" има константа, която лимитира броя на гласуващите членове в Replica Set и тази константа е равна на 7 (седем). Защо е константа? Защо не е някакъв параметър?
МТ: – В Replica Set имаме и 40 нода. Там винаги има мнозинство. Не знам коя версия…
В: – В Replica Set може да се пускат и не гласуващи членове, но гласуващите – максимум 7. Как в такъв случай да се справим с изключването, ако нашият Replica Set е обединен на 3 дата центъра? Един дата център може просто да се изключи, а още една машинка да отпадне.
МТ: – Това вече е малко извън рамките на доклада. Това е общ въпрос. Може би по-късно ще мога да го разкажа.
Малко реклама 🙂
Благодаря, че оставате с нас. Харесвате ли нашите статии? Искате ли да видите повече интересни материали? Подкрепете ни, като направите поръчка или я препоръчате на познати, , уникален аналог на entry-level сървъри, създаден от нас за Вас: (налични опции с RAID1 и RAID10, до 24 ядра и до 40GB DDR4).
Dell R730xd два пъти по-евтин в дата-центъра Equinix Tier IV в Амстердам? Само при нас в Нидерландия! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — от $99! Четете за това
Източник: habr.com
