

На 26 февруари проведохме митап на Apache Ignite GreenSource, където участваха контрибутори на проекта с отворен код. . Важен момент в живота на това общество беше преработката на компонента , който позволява разполагане на потребителски микросервиси направо в кластера Ignite. За този сложен процес на митапа разказа , софтуерен инженер и контрибутор на Apache Ignite вече повече от две години.
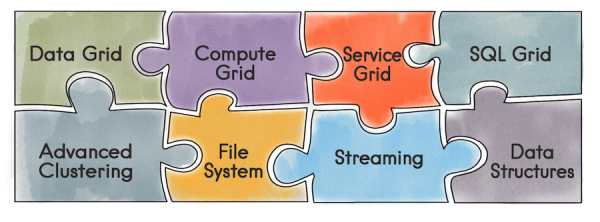
Нека започнем с това какво представлява Apache Ignite. Това е база данни, която представлява разпределено хранилище на ключ/стойност с поддръжка на SQL, транзакционност и кеширане. Освен това, Ignite позволява разполагане на потребителски услуги направо в кластера Ignite. На разположение на разработчика са всички инструменти, предоставени от Ignite — разпределени структури от данни, Messaging, Streaming, Compute и Data Grid. Например, при използване на Data Grid, проблемът с администрирането на отделна инфраструктура за хранилище на данни отпада и следователно разходите, свързани с това.
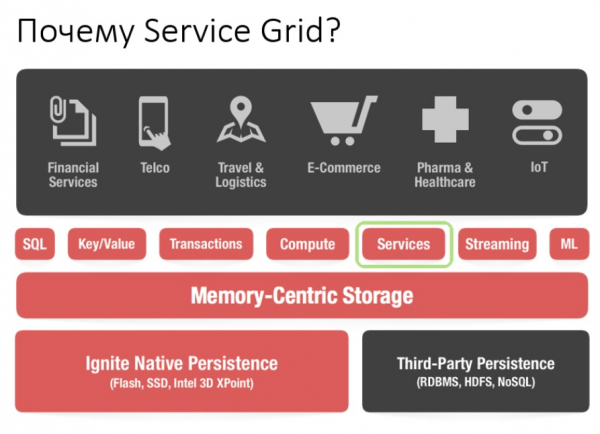
Използвайки API Service Grid, може да се разположи услуга, като просто посочите в конфигурацията схемата за разполагане и съответно самата услуга.
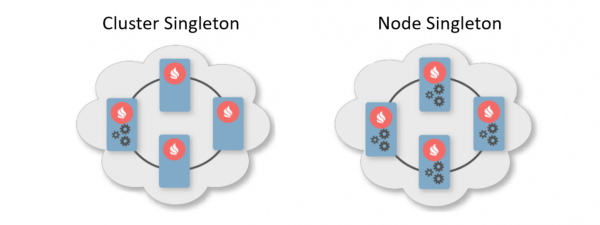
Обикновено схемата за разполагане включва указание за броя на инстанциите, които трябва да бъдат разположени на възлите в кластера. Има две типични схеми на разполагане. Първата е Cluster Singleton: по всяко време в кластера гарантирано ще бъде наличен един екземпляр на потребителската услуга. Втората е Node Singleton: на всеки възел в кластера е разположен по един екземпляр на услугата.
Също така потребителят може да посочи броя на инстанциите на услугата в целия кластер и да определи предикат за филтриране на подходящите възли. При такъв сценарий Service Grid сам ще изчисли оптималното разпределение за разполагане на услугите.
Освен това, съществува такава функция като Affinity Service. Affinity е функция, която определя връзката на ключовете с партициите и връзката на партициите с възлите в топологията. По ключ може да се определи primary-възел, на който се съхраняват данните. По този начин можете да асоциирате собствения си сервис с ключа и кеша на affinity-функцията. При промяна на affinity-функцията ще се извърши автоматичен повторен деплой. Така сервисът винаги ще бъде разположен близо до данните, с които трябва да манипулира, и съответно ще намали накладните разходи за достъп до информацията. Тази схема може да се нарече нещо като колокализирани изчисления.
Сега, когато разгледахме какво е прекрасното в Service Grid, ще разкажем за историята му на развитие.
Какво беше преди
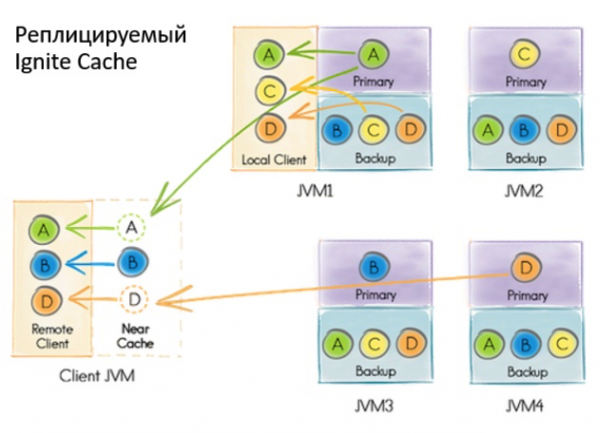
Предишната реализация на Service Grid бе на базата на транзакционен реплициран системен кеш Ignite. Под думата „кеш“ в Ignite се разбира хранилище. Тоест, това не е нещо временно, както може да се помисли. Въпреки че кешът е реплициран и всеки възел съдържа целия набор от данни, вътрешно кешът има партиционирано представяне. Това е свързано с оптимизация на хранилищата.
Какво се случваше, когато потребителят искаше да деплойне сервис?
- Всички възли в клъстера подписваха за обновление на данните в хранилището чрез вградения механизъм Continuous Query.
- Възел-инициатор под read-committed транзакция записваше в базата данни, която съдържаше конфигурацията на сервиза, включително сериализирания инстанс.
- При получаване на уведомление за нов запис, координаторът изчисляваше разпределението на базата на конфигурацията. Полученият обект се записваше обратно в базата.
- Ако възелът входеше в разпределението, координаторът трябваше да го деплойне.
Какво не ни удовлетворяваше
В един момент стигнахме до извода: така работа със сервисите не може да продължи. Причините бяха няколко.
Ако по време на деплоя възникнеше някаква грешка, можеше да се узнава само от логовете на възела, където всичко се е случило. Съществуваше само асинхронен деплой, така че след връщането на управлението на потребителя от метода на деплоя беше необходимо известно допълнително време за стартиране на сервиза — и през това време потребителят не можеше да управлява нищо. За да развием Service Grid по-натам, да се изградят нови функции, да привлечем нови потребители и да улесним живота на всички, трябваше нещо да се промени.
При проектирането на новия Service Grid, ние на първо място искахме да предоставим гаранция за синхронно разгръщане: веднага след като потребителят получи контрол от API, той може незабавно да използва услугите. Освен това, искахме да дадем възможност на инициатора да обработва грешките при разгръщането.
Освен това, искахме да улесним реализацията, а именно да се откажем от транзакции и ребалансировки. Въпреки че кешът е реплициран и няма балансировки, по време на голямо разгръщане с много възли възникваха проблеми. При промяна на топологията, възлите трябва да обменят информация, а при голямо разгръщане, тези данни могат да тежат много.
Когато топологията беше нестабилна, координацията изискваше преразпределение на услугите. Всъщност, когато се работи с транзакции на нестабилна топология, това може да доведе до трудно предвидими грешки.
Проблеми
Кои глобални промени идват без съпътстващи проблеми? Първият от тях е промяната в топологията. Трябва да разберем, че във всеки момент, дори в момента на разгръщането на услугата, възел може да влезе или излезе от клъстера. По-важното е, ако в момента на разгръщането възел влезе в клъстера, ще е необходимо последователно да се предаде цялата информация за услугите на новия възел. И става въпрос не само за това, което вече е било разположено, но и за текущите и бъдещите разгръщания.
Това е само един от проблемите, които можем да съберем в отделен списък:
- Как да разположим статично конфигурирани услуги при стартиране на възела?
- Изход на възела от клъстера – какво да правим, ако възелът е хостил услуги?
- Какво да правим, ако координаторът се е сменил?
- Какво да правим, ако клиентът се е повторно свързал с клъстера?
- Трябва ли да обработим заявките за активиране / деактивиране и как?
- А какво, ако е извикан дестрой на кеша, а ние имаме свързани с него аффинити-услуги?
И това далеч не е всичко.
Решение
Като целеви подход избрахме Event Driven с реализация на комуникацията между процесите с помощта на съобщения. В Ignite вече са реализирани два компонента, които позволяват на възлите да изпращат съобщения помежду си — communication-spi и discovery-spi.
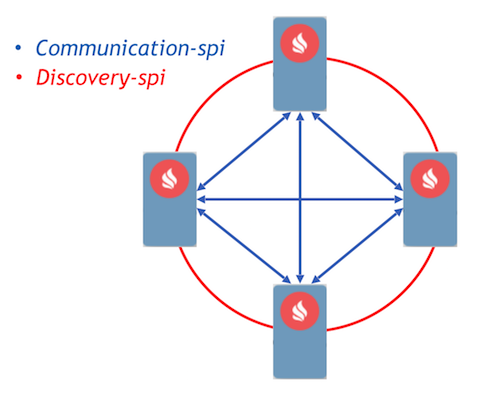
Communication-spi позволява на възлите да комуникират директно и да изпращат съобщения. Той е подходящ за прехвърляне на големи обеми данни. Discovery-spi позволява да се изпрати съобщение на всички възли в клъстера. В стандартната реализация това се прави по топологията "пръстен". Има и интеграция с Zookeeper, в този случай се използва топология "звезда". Също така е важно да се отбележи, че discovery-spi предоставя гаранции, че съобщението ще бъде доставено в правилния ред на всички възли.
Нека разгледаме протокола за деплой. Всички потребителски заявки за деплой и раздеплой се изпращат по discovery-spi. Това предоставя следните гаранции:
- Заявката ще бъде получена от всички възли в клъстера. Това позволява продължаване на обработката на заявката при смяна на координатора. Също така това означава, че за едно съобщение всеки възел ще има всички необходими метаданни, като конфигурацията на услугата и нейния сериализиран инстанс.
- Строгият ред на доставка на съобщенията позволява разрешаването на конфликти в конфигурацията и конкуриращи се заявки.
- Тъй като входът на възела в топологията също се обработва по discovery-spi, новият възел ще получи всички данни, необходими за работа с услугите.
При получаване на заявка възлите в клъстера я валидират и формулират задачи за обработка. Тези задачи се събират в опашка и след това се обработват в друг поток от отделен работник. Това е реализирано по този начин, защото деплой може да отнеме значително време и да забави ценния discovery-поток не е допустимо.
Всички заявки от опашката се обработват от мениджъра на деплоймента. Той разполага с особен работник, който извлича задача от тази опашка и я инициализира, за да започне разгръщането. След това се извършват следните действия:
- Всеки възел самостоятелно изчислява разпределението благодарение на новата детерминирана функция за разпределение.
- Възлите формулират съобщение с резултатите от деплоя и го изпращат на координатора.
- Координаторът агрегира всички съобщения и формулира резултата от целия процес на деплой, който се изпраща по discovery-spi на всички възли в клъстера.
- При получаване на резултата процесът на деплой завършва, след което задачата се изтрива от опашката.
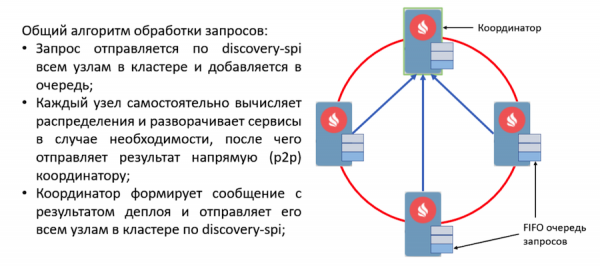
Нов дизайн с на събития: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Ако по време на разгръщането е възникнала грешка, узелят незабавно включва тази грешка в съобщението, което изпраща до координатора. След агрегирането на съобщенията, координаторът ще има информация за всички грешки по време на деплоя и ще изпрати това съобщение чрез discovery-spi. Информацията за грешките ще бъде налична на всеки узел в клъстера.
Според този алгоритъм на работа се обработват всички важни събития в Service Grid. Например, смяната на топологията също е съобщение по discovery-spi. И като цяло, сравнено с предишното, протоколът се оказа достатъчно лек и надежден. Достатъчно, за да се справи с всяка ситуация по време на деплоя.
Какво следва
Сега за плановете. Всяко голямо подобрение в проекта Ignite се извършва като инициатива за подобрение на Ignite, т.нар. IEP. Редизайнът на Service Grid също има IEP — с въображаемо заглавие „Смяна на масло в Service Grid“. Но всъщност сменихме не маслото в двигателя, а самия двигател.
Задачите в IEP сме разделили на 2 фази. Първата е голяма фаза, която включва преработката на протокола за деплой. Тя вече е влита в майстора, можете да опитате новия Service Grid, който ще се появи в версия 2.8. Втората фаза включва множество други задачи:
- Горещ редеплой
- Версиониране на услугите
- Увеличаване на отказоустойчивостта
- Тъмен клиент
- Инструменти за мониторинг и показатели на различни метрики
Накрая можем да ви препоръчаме Service Grid за изграждане на отказоустойчиви системи с висока наличност. Също така ви каним в и да споделите опита си. Вашият опит е наистина важен за общността, той ще помогне да разберем накъде да продължим, как да развиваме компонента в бъдеще.
Източник: habr.com
