

Както и в , се появи проблем с разпределената услуга, да наречем тази услуга Елвин. Този път не открих проблема сам, а ми съобщиха колегите от клиентската част.
Един ден се събудих от недоволно писмо поради големи забавяния с Елвин, който планирахме да пуснем в близко бъдеще. По-специално, клиентът се сблъскал с 99-ия процентил на забавяне около 50 ms, значително над нашия бюджет за забавяне. Това беше изненадващо, тъй като бях тествал услугата внимателно, особено за забавяния, поради което получавах чести оплаквания.
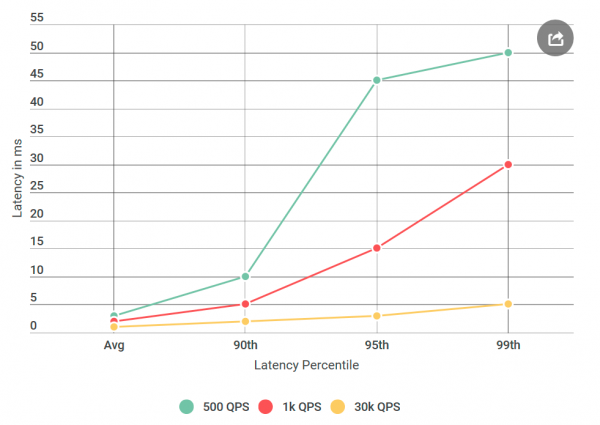
Преди да предам Елвин за тестване, проведох много експерименти с 40 000 заявки в секунда (QPS), всички показваха забавяне под 10 ms. Бях готов да заявя, че не съм съгласен с техните резултати. Но отново преглеждайки писмото, забелязах нещо ново: определено не бях тествал условията, които те споменаха, техният QPS беше много по-нисък от моя. Аз тествал при 40k QPS, а те само при 1k. Проведох още един експеримент, този път с по-нисък QPS, само за да ги успокоя.
Тъй като пиша за това в блога – вероятно вече сте разбрали: техните цифри се оказаха верни. Проверих своя виртуален клиент отново и отново, всичко с един и същ резултат: ниският брой заявки не само увеличава забавянето, но и увеличава броя на заявките със забавяне над 10 ms. С други думи, ако при 40k QPS около 50 заявки в секунда надвишават 50 ms, то при 1k QPS всяка секунда имаше 100 заявки над 50 ms. Паракдокс!
Сужаваме кръга на търсене.
Справяйки се с проблема със забавянето в разпределена система с много компоненти, първо трябва да съставим кратък списък с подозрителни елементи. Нека копаем малко по-дълбоко в архитектурата на Елвин:
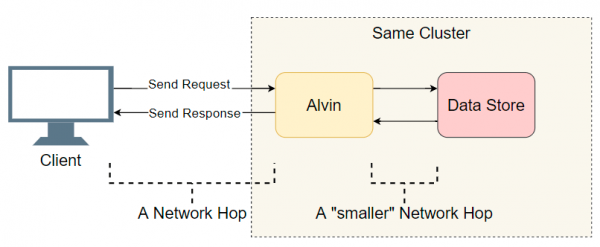
Добра отправна точка е списъкът на направените входно-изходни преходи (мрежови повиквания/търсене по диск и т.н.). Нека се опитаме да разберем къде е забавянето. Освен очевидния входно-изходен обмен с клиента, Елвин прави допълнителна стъпка: той се свързва със системата за управление на данни. Въпреки това, това хранилище работи в един клъстер с Елвин, следователно забавянето там трябва да бъде по-малко, отколкото с клиента. И така, списъкът на подозрителните елементи:
- Мрежово повикване от клиента до Елвин.
- Мрежовото повикване от Елвин към хранилището за данни.
- Търсене на диска в хранилището за данни.
- Мрежовото повикване от хранилището за данни към Елвин.
- Мрежовото повикване от Елвин към клиента.
Да опитаме да премахнем някои точки.
Хранилището за данни не е замесено.
Първо преобразувах Елвин в pинг-пинг сървър, който не обработва заявки. При получаване на заявка, той връща пуст отговор. Ако закъснението намалее, то грешката е в реализацията на Елвин или хранилището за данни – нищо необичайно. В първия експеримент получаваме такава графика:
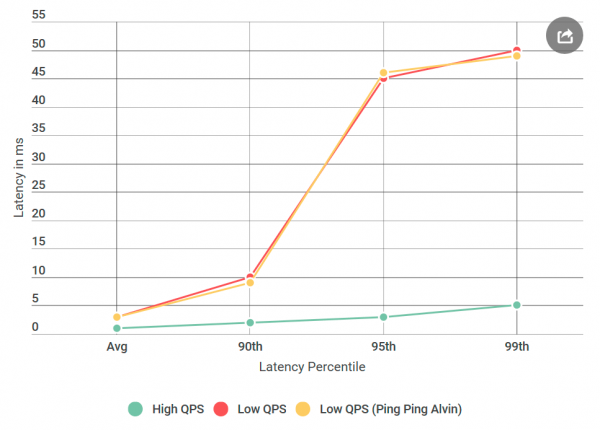
Както виждаме, при използване на pинг-пинг сървър не се наблюдават подобрения. Това означава, че хранилището за данни не увеличава закъснението, а списъкът на заподозрените се съкращава на половина:
- Мрежово повикване от клиента до Елвин.
- Мрежовото повикване от Елвин към клиента.
Страхотно! Списъкът бързо се съкращава. Мислех, че почти съм установил причината.
gRPC
Сега е време да ви представя новия играч: . Това е библиотека с отворен код от Google за междупроцесно свързване. . Въпреки че gRPC е добре оптимизирана и широко използвана, аз за първи път я използвам в система с такъв мащаб и очаквах, че моята реализация ще бъде неефективна – да кажем меко.
Наличието на gRPC в стека породи нов въпрос: може би моята реализация или самият gRPC предизвиква проблема със закъснението? Добавяме нов заподозрян в списъка:
- Клиентът извиква библиотеката
gRPC - Библиотека
gRPCна клиента извършва мрежово повикване към библиотекатаgRPCна сървера - Библиотека
gRPCсе обръща към Елвин (операцията не съществува в случая на pинг-понг сървър)
За да разберете как изглежда кодът, моята реализация на клиента/Елвин не се различава много от клиент-серверни .
Забележка: горният списък е малко опростен, тъй като
gRPCпозволява използването на собствена (шаблонна?) потокова модел, в който се преплитат стекът на изпълнениеgRPCи реализацията на потребителя. За простота ще се придържаме към този модел.
Профилирането ще реши всичко.
След като изключих хранилищата за данни, помислих, че почти съм приключил: „Сега е лесно! Ще приложим профил и ще разберем къде възниква закъснението“. Аз , защото CPU-то е много бързо и най-често не е ограничението. Повечето закъснения се случват, когато процесорът трябва да спре обработката, за да направи нещо друго. Точното профилиране на CPU е създадено точно за това: то точно записва всичко. и показва, къде възникват забавянията.
Взех четири профила: за висок QPS (малко забавяне) и с ping-pong сървър на нисък QPS (голямо забавяне), както на страна на клиента, така и на страна на сървъра. И просто за всеки случай взех и проба на профила на процесора. При сравнението на профилите обикновено търся аномална стек на повикванията. Например, при лошата страна с високо забавяне има много повече превключвания на контекста (10 и повече пъти). Но в моя случай броят на превключванията на контекста практически съвпадаше. За мое ужас, нямаше нищо съществено.
Допълнителна отладка
Бях в отчаяние. Не знаех какви още инструменти мога да използвам, а следващият ми план всъщност беше да повторя експериментите с различни вариации, а не да диагностицирам проблема ясно.
Какво ако
От самото начало ме безпокоеше конкретно време за забавяне от 50 ms. Това е много голямо време. Реших, че ще изрязвам части от кода, докато не успея да разбера точно коя част предизвиква тази грешка. След това последва експеримент, който сработи.
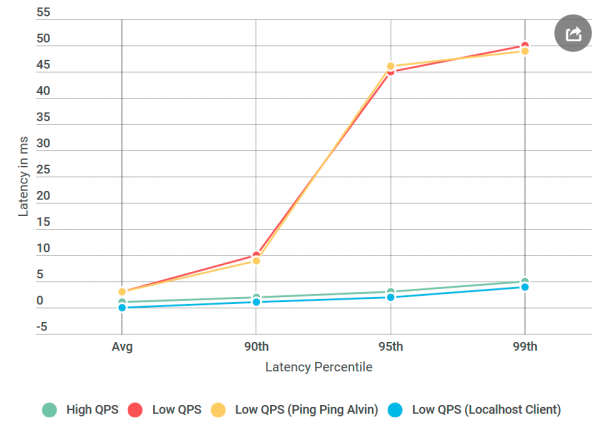
Както обикновено, след като погледнах назад, всичко изглежда очевидно. Поставих клиента на една машина с Елвин и изпратих заявка в localhost. И увеличението на забавянето изчезна!
Нещо не беше наред със мрежата.
Овладяваме уменията на мрежов инженер
Трябва да призная: моите познания за мрежови технологии са ужасни, особено предвид факта, че работя с тях ежедневно. Но мрежата беше главният заподозрян и трябваше да науча как да я отлаждам.
За щастие, интернет обича тези, които искат да учат. Комбинацията от ping и tracert изглеждаше достатъчно добро начало за отстраняване на проблеми с транспортната мрежа.
Първо, стартирах на TCP порта на Елвин. Използвах параметрите по подразбиране – нищо особено. От повече от хиляда пинга нито един не надхвърли 10 ms, с изключение на първия за загряване. Това противоречи на наблюдаваното увеличение на забавянето от 50 ms в 99-ия процентил: там за всяки 100 заявки трябваше да видим около една заявка със забавяне от 50 ms.
След това опитах : може би проблемът е на един от възлите по маршрута между Елвин и клиента. Но и трасерът се върна с празни ръце.
Така причината за забавянето не беше моят код, нито реализирането на gRPC, нито мрежата. Вече започнах да се притеснявам, че никога няма да го разбера.
Сега, на коя ОС сме?
gRPC широко се използва в Linux, но за Windows е екзотика. Реших да проведа експеримент, който проработи: създадох виртуална машина с Linux, компилирах Елвин за Linux и го разгрнах.
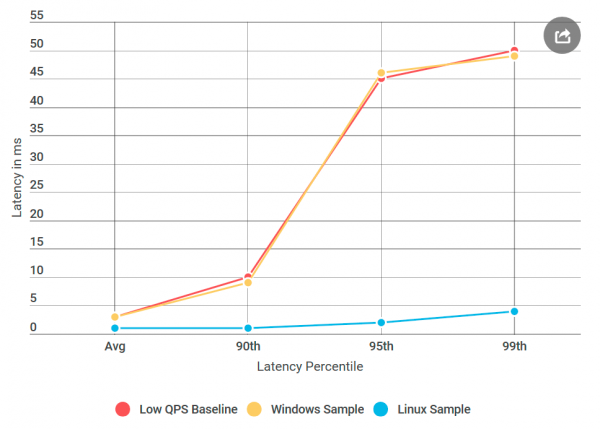
И ето какво се получи: в ping-pong сървъра на Linux нямаше такива забавяния, каквито имаше в аналогичния възел на Windows, въпреки че източникът на данни не се различаваше. Оказва се, че проблемът е в реализирането на gRPC за Windows.
Алгоритъмът на Нейгъл
Цялото това време мислех, че ми липсва флаг gRPC. Сега разбрах, че всъщност не ми стигаше gRPC флаг за Windows. Намерих вътрешна библиотека RPC, за която бях сигурен, че работи добре за всички инсталирани флагове . След това добавих всички тези флагове в gRPC и разгрнах Елвин на Windows, в поправения ping-pong сървър за Windows!
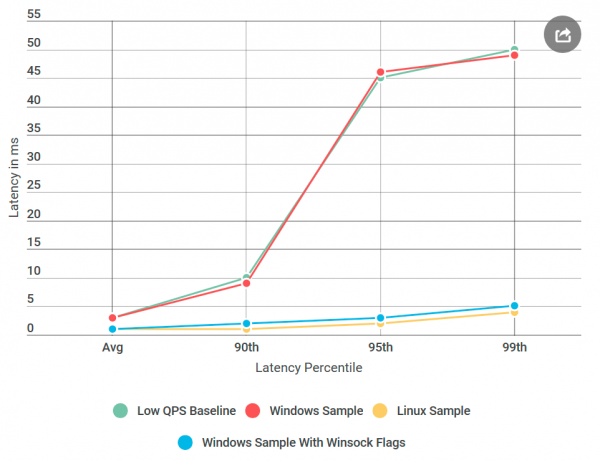
Почти готово: започнах да премахвам добавените флагове един по един, докато не се върна регресията, така че успях точно да определи причината. Това беше зловещият , превключвател на алгоритъма на Нейгъл.
опитва се да намали броя на пакетите, изпратени по мрежата, като забавя предаването на съобщения, докато размерът на пакета не надвиши определен брой байтове. Въпреки че това може да бъде приятно за средния потребител, то е разрушително за сървъри в реално време, тъй като ОС ще забави някои съобщения, причинявайки забавяния при нисък QPS. В gRPC беше зададен този флаг в реализирането на Linux за TCP сокети, но не и за Windows. Аз го .
Заключение
Голямата забавяне при нисък QPS беше причинена от оптимизацията на ОС. В ретроспекция профилирането не откри забавяне, защото беше проведено в режим на ядро, а не в . Не знам дали може да се наблюдава алгоритъмът на Нейгъл чрез ETW захвати, но това би било интересно.
Що се отнася до експеримента localhost, той вероятно не се отнасяше до действителния мрежови код и алгоритъмът на Нейгъл не беше активиран, така че проблемите със забавянето изчезнаха, когато клиентът се свърза с Елвин чрез localhost.
Следващия път, когато видите увеличаване на забавянето при намаляване на броя на заявките в секунда, алгоритъмът на Нейгъл трябва да бъде в списъка с подозрителни!
Източник: habr.com
